Nota
O acesso a esta página requer autorização. Pode tentar iniciar sessão ou alterar os diretórios.
O acesso a esta página requer autorização. Pode tentar alterar os diretórios.
O conceito de multilocação no Azure Data Explorer refere-se a servir diferentes locatários e armazenar seus dados em um único cluster.
Importante
Uma solução multitenant também pode ser arquitetada na carga de trabalho Real-Time Intelligence da Microsoft Fabric, usando bases de dados KQL dentro de um Eventhouse.
Um inquilino pode representar um cliente, um grupo de utilizadores ou quaisquer classificações de utilizadores onde os dados precisam de ser segregados ao longo dos limites do inquilino. Também pode existir um cenário de multitenência multinível, como várias aplicações com múltiplos inquilinos. Este artigo não aborda este cenário, mas princípios semelhantes aplicam-se.
Um fator importante é a forma como os utilizadores finais acedem aos seus dados de inquilino. Quando os utilizadores finais acedem ao Azure Data Explorer diretamente, o controlo de acesso deve ser configurado no Azure Data Explorer para isolar a visualização do utilizador apenas aos seus próprios dados. Quando um aplicativo proxy acessa seus dados no Azure Data Explorer, o aplicativo pode fazer o isolamento.
Este artigo descreve algumas arquiteturas de implantação e fornece características para cada uma. Você pode usar as características para ajudá-lo a decidir qual arquitetura funciona melhor para sua solução.
Vizinho barulhento
Em geral, compartilhar um cluster entre muitos locatários, independentemente da arquitetura usada, significa que diferentes locatários compartilham os recursos do cluster. Isso pode levar ao antipadrão vizinho barulhento .
Por exemplo, se um locatário executar muitas consultas ou ingestões de computação intensiva, outros locatários provavelmente serão afetados pela escassez de recursos. Isso pode ser atenuado usando grupos de carga de trabalho. Você também pode usar políticas para controlar o cache e o armazenamento geral.
Visão geral das arquiteturas
As próximas seções exploram as arquiteturas de implantação em detalhes. Esta seção contrasta as arquiteturas para facilitar a tomada de decisões.
| Architecture | Strengths |
|---|---|
| Um locatário por banco de dados | - Isolamento dos inquilinos: sem necessidade de procuração - Pode ter políticas diferentes, como políticas de retenção, por locatário - Flexibilidade na evolução do esquema por locatário - Remoção fácil e rápida dos dados do inquilino |
| Uma mesa para muitos inquilinos | - Consolidação eficiente de dados e gestão de alcance - Evolução simplificada do esquema - Mais adequado para vistas materializadas - Ideal para particionamento |
| Um cliente por tabela numa base de dados única | Não recomendado |
Arquitetura: Um locatário por banco de dados
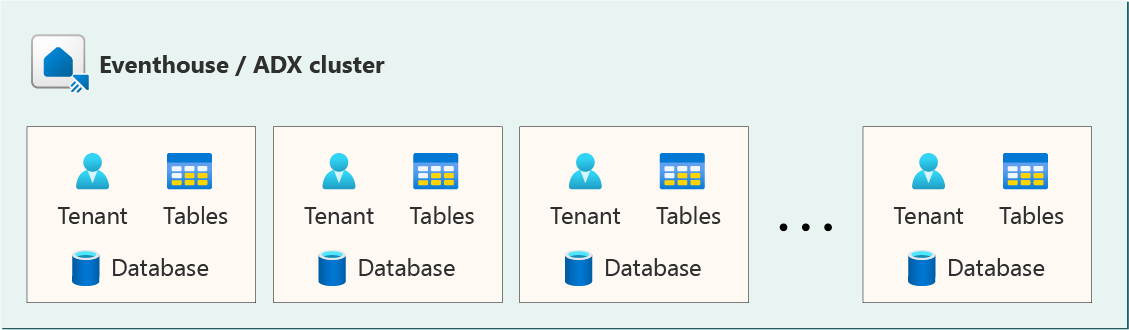
Esta é uma arquitetura popular e simples. Cada locatário obtém seu próprio banco de dados. Cada banco de dados tem o mesmo esquema.
As características desta arquitetura são:
Provisionamento de um novo locatário: requer a criação de um novo banco de dados e a implantação de entidades de esquema nele.
Remoção de um locatário: requer a exclusão do banco de dados. A exclusão de um banco de dados pode ser feita em poucos segundos. Consome poucos e constantes recursos que não são lineares com o volume de dados do locatário.
Atualizações de esquemas de base de dados: cada inquilino pode ser atualizado de forma independente em momentos diferentes. Os aplicativos que acessam os bancos de dados devem estar cientes da versão de cada banco de dados com o qual interagem.
Políticas de retenção e cache: cada locatário pode ter suas próprias políticas exclusivas, que permitem fornecer políticas personalizadas de retenção e cache para seus clientes.
Limite de segurança por inquilino:
- Para aplicação multitenant (proxy): Configure a sua aplicação para direcionar a base de dados relevante. Use a restrição de acesso em consultas para proibir consultas entre bancos de dados.
- Para usuários com acesso direto: os usuários podem receber acesso no nível do banco de dados. Dar aos usuários acesso direto ao banco de dados cria uma dependência para os detalhes da implementação, dificultando a alteração da implementação. Portanto, é altamente recomendável usar a abordagem proxy para acessar o banco de dados.
Agrupando dados de vários clientes em larga escala: use o operador de união para agregar dados entre bases de dados. No entanto, este método pode tornar-se complicado à medida que o número de inquilinos aumenta. Embora a agregação de dados de vários locatários possa ser uma meta de design da perspetiva do locatário, pode ser interessante para o proprietário da solução agregar dados de todos os locatários para coletar estatísticas.
Fragmentação de extensões: Cada locatário ingerindo alguns registros por tabela de banco de dados leva à criação de pequenas extensões que posteriormente precisam ser mescladas. Isto resulta num custo mais elevado para a gestão da extensão. Portanto, recomendamos fortemente o uso de captura de dados em streaming, como em Hubs de Eventos ou Event Grid. Para usar a ingestão de streaming, você deve certificar-se de que ela esteja habilitada no cluster e na tabela.
Visões materializadas e política de particionamento. À medida que o número de locatários aumenta, é importante lembrar que há limites para o número de exibições materializadas e políticas de partição que um cluster pode executar de forma eficiente.
Conexões de dados da Grade de Eventos e Hubs de Eventos: essas conexões de dados são criadas por banco de dados. Portanto, esta arquitetura requer uma conexão de dados e uma instância de Event Grid ou Event Hubs por inquilino, o que adiciona complexidade de gestão. Considere o uso do roteamento de eventos para Hubs de Eventos e Grade de Eventos.
Arquitetura: Uma mesa para muitos inquilinos
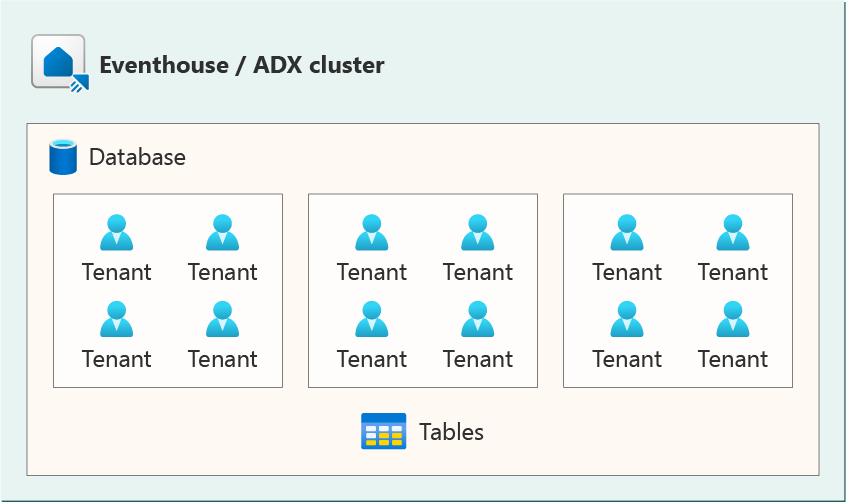
Essa arquitetura é mais agressiva em sua consolidação, usando um único banco de dados para todos os locatários. Cada tabela no banco de dados tem uma coluna ID do Locatário ou equivalente, que permite filtrar os dados de um único locatário. Você pode particionar tabelas por locatário para melhorar o desempenho da consulta, já que a maioria das consultas provavelmente filtrará por locatário. Sempre que possível, deve-se considerar particionar com outra coluna usando uma chave de partição composta. Por exemplo, você pode criar uma chave de partição composta concatenando o ID do locatário e os valores de outras colunas.
As características desta arquitetura são:
Provisionamento de um novo locatário: o provisionamento de um novo locatário não requer nenhuma criação de banco de dados ou ajuste de esquema. O novo ID do locatário é usado em novos registros.
Remoção de um locatário: requer uma exclusão suave ou limpeza dos dados do locatário. Você pode agrupar vários expurgos em lote, por exemplo, no final da semana para limitar o impacto no consumo de recursos.
Atualizações de esquemas de banco de dados: Todos os esquemas dos locatários são atualizados ao mesmo tempo. Como todos os clientes compartilham a tabela, alterar os esquemas de tabela afeta todos os clientes simultaneamente.
Políticas de retenção e cache: as políticas são as mesmas para todos os locatários, pois todos compartilham a mesma tabela.
Limite de segurança por inquilino:
- Para uma aplicação multitenant (proxy): Use instrução Restrict
- Para usuários com acesso direto: use a Política de Segurança em Nível de Linha e familiarize-se com suas limitações. Dar aos usuários acesso direto ao banco de dados cria uma dependência para os detalhes da implementação, dificultando a alteração da implementação. Portanto, é altamente recomendável usar a abordagem proxy para acessar o banco de dados.
Agregando dados de vários locatários em escala: os usuários com permissões de acesso suficientes podem executar uma consulta de agregação padrão nos dados de vários locatários.
Fragmentação de extensões: Como todos os inquilinos ingerem dados na mesma tabela, os dados geralmente podem ser consolidados e ingeridos de forma eficiente em uma ou poucas extensões.
Visões materializadas e política de particionamento: Estas podem ser usadas em tabelas multitenant. Você pode melhorar o desempenho particionando na coluna ID de Tenente ou uma coluna equivalente. Para obter mais informações, consulte Cenários para políticas de partição.
Conexões de dados do Event Grid e Event Hubs: Consolidaram-se as conexões de dados, dado que os dados de todos os inquilinos acabam numa única tabela.
Arquitetura de sistema: um inquilino por cada tabela em um único banco de dados
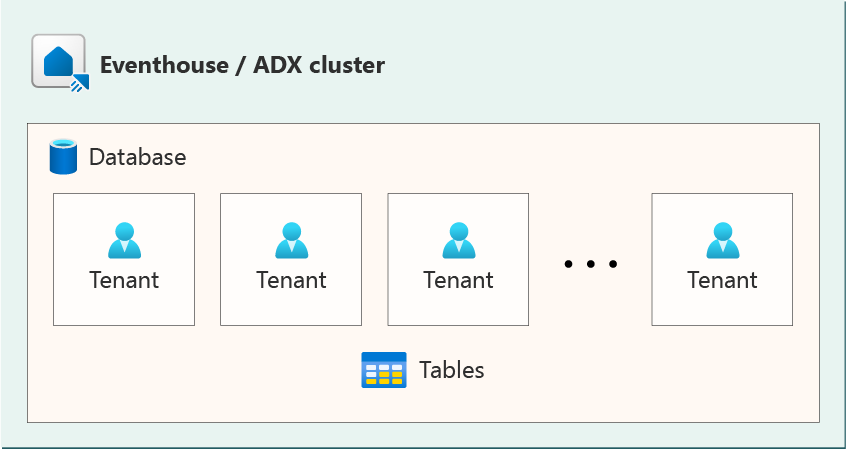
Essa arquitetura é uma combinação das arquiteturas anteriores em que os dados de todos os locatários terminam em um único banco de dados, mas tabelas separadas. Esta arquitetura não consegue capturar todas as vantagens das outras arquiteturas.
Embora os dados de cada locatário sejam segregados, todos eles residem no mesmo contexto de segurança do mesmo banco de dados. Como a arquitetura de vários bancos de dados, esta arquitetura pode levar à fragmentação. O nome da tabela é diferente para cada locatário e, portanto, as consultas devem ser personalizadas para cada locatário.