Nota
O acesso a esta página requer autorização. Pode tentar iniciar sessão ou alterar os diretórios.
O acesso a esta página requer autorização. Pode tentar alterar os diretórios.
O Azure Data Explorer (ADX) é uma plataforma de análise totalmente gerenciada para análise em tempo real de dados de telemetria e log em grande escala. Este artigo explica como o custo por GB ingerido é calculado no Azure Data Explorer, quais fatores o impulsionam e como você pode otimizar seu cluster para eficiência de custos. As plataformas de análise de Big Data utilizam diferentes modelos de preços. Muitas plataformas baseiam o preço em fatores como volume de consulta, ingestão de dados, duração do armazenamento e recursos de computação. Essa complexidade dificulta a comparação de preços entre produtos.
Para ajudar a entender o custo de usar o Azure Data Explorer, este artigo usa o custo métrico por GB ingerido. Essa métrica é o custo total do cluster (computação, armazenamento, rede e marcação de serviço) dividido pelo total de dados de tamanho original ingeridos durante esse período.
Um instantâneo representativo dos clusters ADX em junho de 2025 é usado para fundamentar a análise ilustrativa. As seções a seguir mostram os principais resultados da análise, explicam o que impulsiona as variações de custo e como os usuários podem otimizar o custo por GB ingerido sem comprometer o desempenho.
Observação
- Todos os valores de custo neste artigo mostram preços de tabela e não incluem descontos ou economias baseadas em compromisso.
- Para efeitos desta análise de exemplo, o custo por GB é expresso em Unidades de Custo de Amostra (SCUs), em que cada SCU representa uma unidade de custo genérica, por exemplo, um cêntimo dos EUA.
- Para obter preços de tabela e como calculá-los, consulte Calculadora de preços do Azure Data Explorer.
Custo por GB ingerido
O gráfico abaixo mostra a mediana diária de GB ingerida no tamanho original (eixo Y) versus o custo mediano por GB ingerido (eixo X) para cada grupo de custos. O tamanho da bolha representa a parcela do grupo no total de dados ingeridos no serviço.
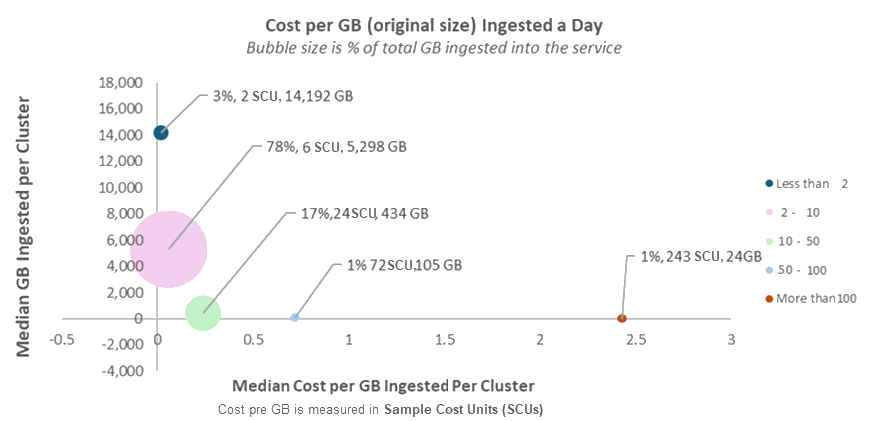
O custo por GB ingerido varia entre clusters, mas vários padrões se destacam:
A maioria dos dados (>75%) é ingerida a um custo entre 2 e 10 SCUs por GB (antes dos descontos).
Menos de 5% dos dados são ingeridos a menos de 2 SCUs por GB.
Mesmo dentro da mesma categoria de uso (ou "bolha"), você vê uma variação significativa. Por exemplo, na maior bolha, um cluster ingere 2 SCUs por GB, enquanto outro atinge 10 SCUs por GB. Essa é uma diferença de 5 vezes. As próximas seções explicam as principais razões para essa variação.
Clusters com maior custo por GB são menos comuns e geralmente têm volumes de ingestão mais baixos. Em geral, volumes de dados menores significam maior custo por GB.
Importante
O gráfico de bolhas mostra que o custo por GB ingerido varia entre clusters. Esta variação não indica boas ou más práticas. Ele reflete diferentes cenários, configurações e padrões de uso para o serviço.
Por exemplo, um cluster pode reter dados por mais tempo para fins de conformidade, o que aumenta os custos de armazenamento. Outro pode usar políticas de atualização que processam dados durante a ingestão, o que aumenta o uso de computação. Esses cenários são escolhas de design intencionais alinhadas com objetivos específicos e naturalmente afetam o custo por GB.
O que determina o custo por GB ingerido
Esses fatores-chave estão por trás das variações no custo por GB ingerido por cluster:
Duração do armazenamento: quanto mais tempo você armazenar dados, maior será o custo. Consulte a política de retenção.
Alto uso da CPU: Ações como consultas pesadas, processamento de dados ou transformações causam alto uso da CPU.
Configurações de cache: armazenar mais dados em cache aumenta o desempenho, mas pode aumentar os custos. Consulte a política de cache.
Uso de dados frios: consultas que acessam dados frios acionam transações de leitura e aumentam o custo. Veja cache quente e frio.
Transformação e otimização de dados: recursos como políticas de atualização, exibições materializadas e particionamento consomem recursos da CPU e podem aumentar os custos. Consulte Políticas de atualização, Vistas materializadas e partições.
Volume de ingestão: Os clusters operam de forma mais econômica em volumes de ingestão mais altos.
** Streaming vs. ingestão em filas: Cada um tem um perfil de custo diferente, dependendo do caso de uso. Consulte transmissão ao vivo e Fila.
Design de esquema: tabelas amplas com muitas colunas precisam de mais recursos de computação e armazenamento, o que aumenta os custos.
Recursos avançados: opções como seguidores, endpoints privados e sandboxes Python consomem mais recursos e podem aumentar o custo.
Escolha do pipeline de dados: Algumas vias de ingestão de dados custam menos. Por exemplo, a ingestão de Event Grid geralmente é mais barata do que Event Hubs.
Dimensionamento automático: os clusters sem dimensionamento automático geralmente custam mais porque não ajustam seu tamanho com base na demanda.
Você pode configurar a maioria desses fatores para otimizar o desempenho e o custo.
Um olhar mais atento sobre os principais fatores de custo
Esta seção explora os principais fatores que influenciam o custo por GB ingerido no Azure Data Explorer, fornecendo informações sobre como você pode gerenciar e otimizar esses custos.
Impacto da retenção de dados no custo
No ADX, todos os dados ingeridos são armazenados em armazenamento persistente. Cada tabela e exibição materializada tem uma política de retenção que define por quanto tempo os dados são mantidos. Quanto mais tempo os dados forem retidos, maior será o custo, com base nos preços do Armazenamento do Azure. Quando você precisa de armazenamento de longo prazo, como para fins de conformidade, o custo por GB ingerido aumenta porque inclui despesas contínuas de armazenamento.
Além do tamanho da extensão relatado pelo cluster, há dois fatores de custo adicionais:
- Buffer de retenção: 7 dias extras de dados são armazenados por padrão para proteger contra perda acidental de dados.
- Sobrecarga de capacidade de recuperação: para tabelas em que a configuração de capacidade de recuperação está habilitada (padrão), os dados são retidos por mais 14 dias. Isso inclui blobs intermediários gerados durante operações de mesclagem e reconstrução.
Tamanho do cluster
O tamanho do cluster é o número de máquinas (nós) no cluster. Cada máquina adiciona custo, dependendo do seu tipo (SKU). O dimensionamento automático ajusta o tamanho do cluster com base no uso da CPU, para que o sistema possa otimizar o custo e o desempenho, evitando recursos ociosos ou redundantes.
O dimensionamento automático ajusta o tamanho do cluster para garantir que os dados armazenados em cache se encaixem no espaço SSD disponível. Como resultado, um cache grande pode aumentar o tamanho do cluster e, se o uso da CPU for baixo, isso pode levar a um custo mais alto por GB. Consulte a guia CacheClusters Insight tool para obter mais informações sobre como otimizar o tamanho do cache.
Os clusters que executam muitas consultas ou realizam tarefas pesadas da CPU, como Exibições Materializadas, Políticas de Atualização ou Particionamento, podem dimensionar o cluster, aumentando o custo por GB. Observe que esses recursos podem aumentar significativamente o desempenho da consulta e reduzir o uso da CPU de consulta e, assim, melhorar a eficiência geral.
Volume de dados ingeridos
À medida que um cluster cresce, mais nós são adicionados, aumentando o custo total. Esse custo é distribuído por todos os dados ingeridos, portanto, quanto mais dados você ingerir, menor será o custo por GB.
Uso de dados frios
Quando as consultas acessam frequentemente dados frios armazenados no disco, elas causam transações de leitura que usam mais recursos e podem aumentar o custo geral do cluster.
Streaming vs. ingestão em fila
Cada método de ingestão tem características diferentes de custo, latência e funcionalidade, portanto, cada um é melhor para diferentes cenários. Por custo, a ingestão de streaming é mais barata quando se ingere muitas tabelas pequenas com dados em fluxo contínuo, enquanto a ingestão em fila é mais econômica para tabelas grandes.
Sugestão
Otimize o custo por GB ingerido
Verifique as configurações dos principais fatores de custo para garantir que eles atendam às necessidades do cluster e aos requisitos de serviço para eficiência. Em especial:
- Minimize as consultas sobre dados frios para reduzir as transações de leitura.
- Habilite o dimensionamento automático para corresponder dinamicamente o tamanho do cluster à demanda.