Nota
O acesso a esta página requer autorização. Pode tentar iniciar sessão ou alterar os diretórios.
O acesso a esta página requer autorização. Pode tentar alterar os diretórios.
O sdp-meta projeto da Databricks Labs fornece ferramentas para gerar pipelines a partir dos metadados que mantém.
Note
O projeto open source sdp-meta, tal como todos os projetos na conta GitHub do databrickslabs, existe apenas para fins de exploração. O Azure Databricks não oferece suporte a ele nem fornece contratos de nível de serviço (SLAs) para ele. Não submeta pedidos de suporte do Azure Databricks para problemas relacionados com este projeto. Em vez disso, abre uma issue no GitHub, que será analisada à medida que houver disponibilidade.
O que é sdp-meta?
Os pipelines do Lakeflow permitem-lhe especificar declarativamente uma tabela e gerar um fluxo no pipeline que tanto cria a tabela como a mantém atualizada à medida que os dados de origem mudam. No entanto, se sua organização tiver centenas de tabelas, gerar e gerenciar esses pipelines é demorado e pode levar a práticas inconsistentes.
O projeto sdp-meta é um framework de metaprogramação orientado por metadados, concebido para funcionar com pipelines Lakeflow. Essa estrutura permite a automação de pipelines de dados bronze e silver aproveitando metadados registrados em um conjunto de arquivos JSON e YAML. Em tempo de execução, processos genéricos leem metadados e criam dinamicamente os fluxos neles descritos. O processamento de bronze e prata pode funcionar em pipelines separados ou em conjunto num pipeline combinado. Geras os metadados dos teus pipelines, e o sdp-meta gera os teus pipelines.
Com sua lógica centralizada em um só lugar (os metadados), seu sistema é mais rápido, reutilizável e fácil de manter.
Note
O projeto sdp-meta foi anteriormente chamado dlt-meta, em homenagem à antiga funcionalidade Delta Live Tables no Azure Databricks.
Delta Live Tables foi substituído por Lakeflow Pipelines, e o sdp-meta funciona com o Lakeflow Pipelines. Se estiver a atualizar uma instalação existente dlt-meta , consulte o guia de migração na documentação sdp-meta.
Benefícios do sdp-meta
Existem dois principais casos de uso para o sdp-meta:
- Ingerir e limpar um grande número de mesas de forma simples.
- Aplique padrões de engenharia de dados em vários pipelines e usuários.
Os benefícios do uso de uma abordagem orientada por metadados incluem:
- A manutenção de metadados pode ser feita sem conhecimento de código Python ou SQL.
- A manutenção de metadados, em vez do código, requer menos sobrecarga e reduz erros.
- O código é gerado por sdp-meta, por isso mantém-se consistente e tem menos código personalizado entre pipelines e tabelas publicadas.
- Você pode facilmente agrupar tabelas em pipelines dentro dos metadados, gerando o número de pipelines necessários para atualizar seus dados de forma mais eficiente.
Como funciona o sdp-meta
A imagem seguinte mostra uma visão geral do sistema sdp-meta:
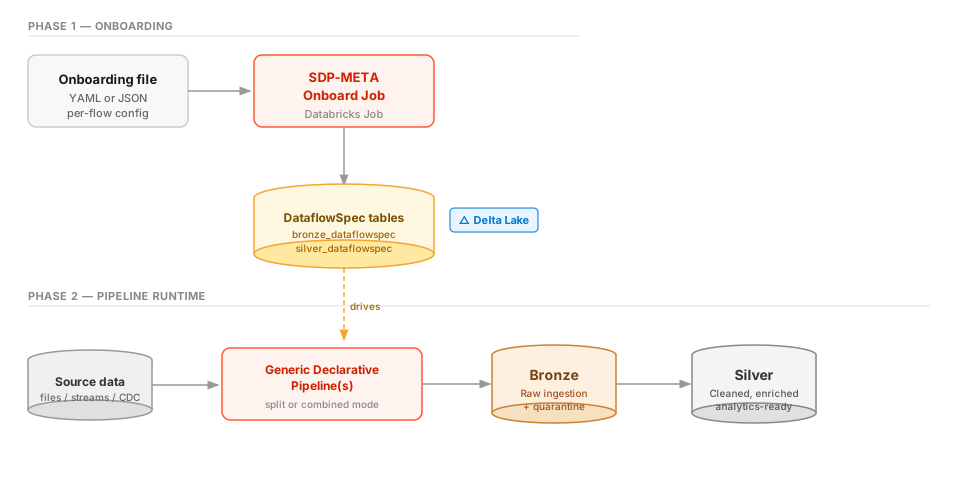
- Crias os ficheiros de metadados como entrada para o sdp-meta, para especificar os ficheiros de origem e saídas, regras de qualidade e processamento necessário. Estes ficheiros de integração podem ser escritos em JSON ou YAML.
- Tu geres o trabalho de integração sdp-meta. O motor compila os ficheiros de onboarding numa especificação de fluxo de dados, chamada DataflowSpec, e armazena-os em tabelas Delta (
bronze_dataflowspecesilver_dataflowspec) para uso posterior. - Em tempo de execução, um pipeline genérico lê o DataflowSpec e constrói dinamicamente o grafo de processamento da camada bronze. Lê os seus dados de origem (ficheiros, fluxos ou CDC) e aplica as validações de dados adequadas, de acordo com as suas regras de qualidade, gerando as suas tabelas bronze e colocando em quarentena os registos que não cumprem essas regras.
- O processamento de prata pode correr num pipeline genérico separado, que é o padrão para os Declarative Automation Bundles, ou no mesmo pipeline quando se usa o modo combinado. O pipeline utiliza o DataflowSpec para aplicar as transformações apropriadas e outros processamentos, gerando tabelas de prata que são limpas, enriquecidas e prontas para análise.
Executa os fluxos de processamento gerados pelo sdp-meta para manter os resultados atualizados à medida que os dados de origem são atualizados.
Introdução
Para usar o sdp-meta, deves:
- Implementar e configurar a solução sdp-meta.
- Prepare os metadados para as suas tabelas das camadas de bronze e de prata.
- Crie um trabalho para integrar os metadados.
- Utilize os metadados para criar pipelines para as suas tabelas.
O projeto sdp-meta suporta várias interfaces de implementação: bundles (recomendado), uma CLI interativa, uma aplicação Databricks com interface gráfica baseada em browser, um servidor MCP para configuração assistida por IA e um Agent Skill portátil para agentes de IA conscientes da competência.
A documentação sdp-meta no GitHub tem um tutorial para te ajudar a começar este processo. Para mais informações, consulte como começar com o sdp-meta no GitHub.