Nota
O acesso a esta página requer autorização. Pode tentar iniciar sessão ou alterar os diretórios.
O acesso a esta página requer autorização. Pode tentar alterar os diretórios.
O AI Runtime integra-se com o MLflow para fornecer ferramentas de rastreio de experiências, observabilidade e depuração. O MLflow fornece um único local para os parâmetros de uma execução, métricas, métricas do sistema GPU, logs e artefactos, quer desenvolva num notebook, submeta uma carga de trabalho com a databricks air CLI ou agende um trabalho.
O que o MLflow oferece
Uma experiência do MLflow agrupa as execuções de treino relacionadas, e cada execução fornece um registo persistente da configuração e dos resultados do treino.
- Métricas e parâmetros: Registar a perda de treino, métricas de avaliação, taxas de aprendizagem e hiperparâmetros, e depois compare-os entre as execuções.
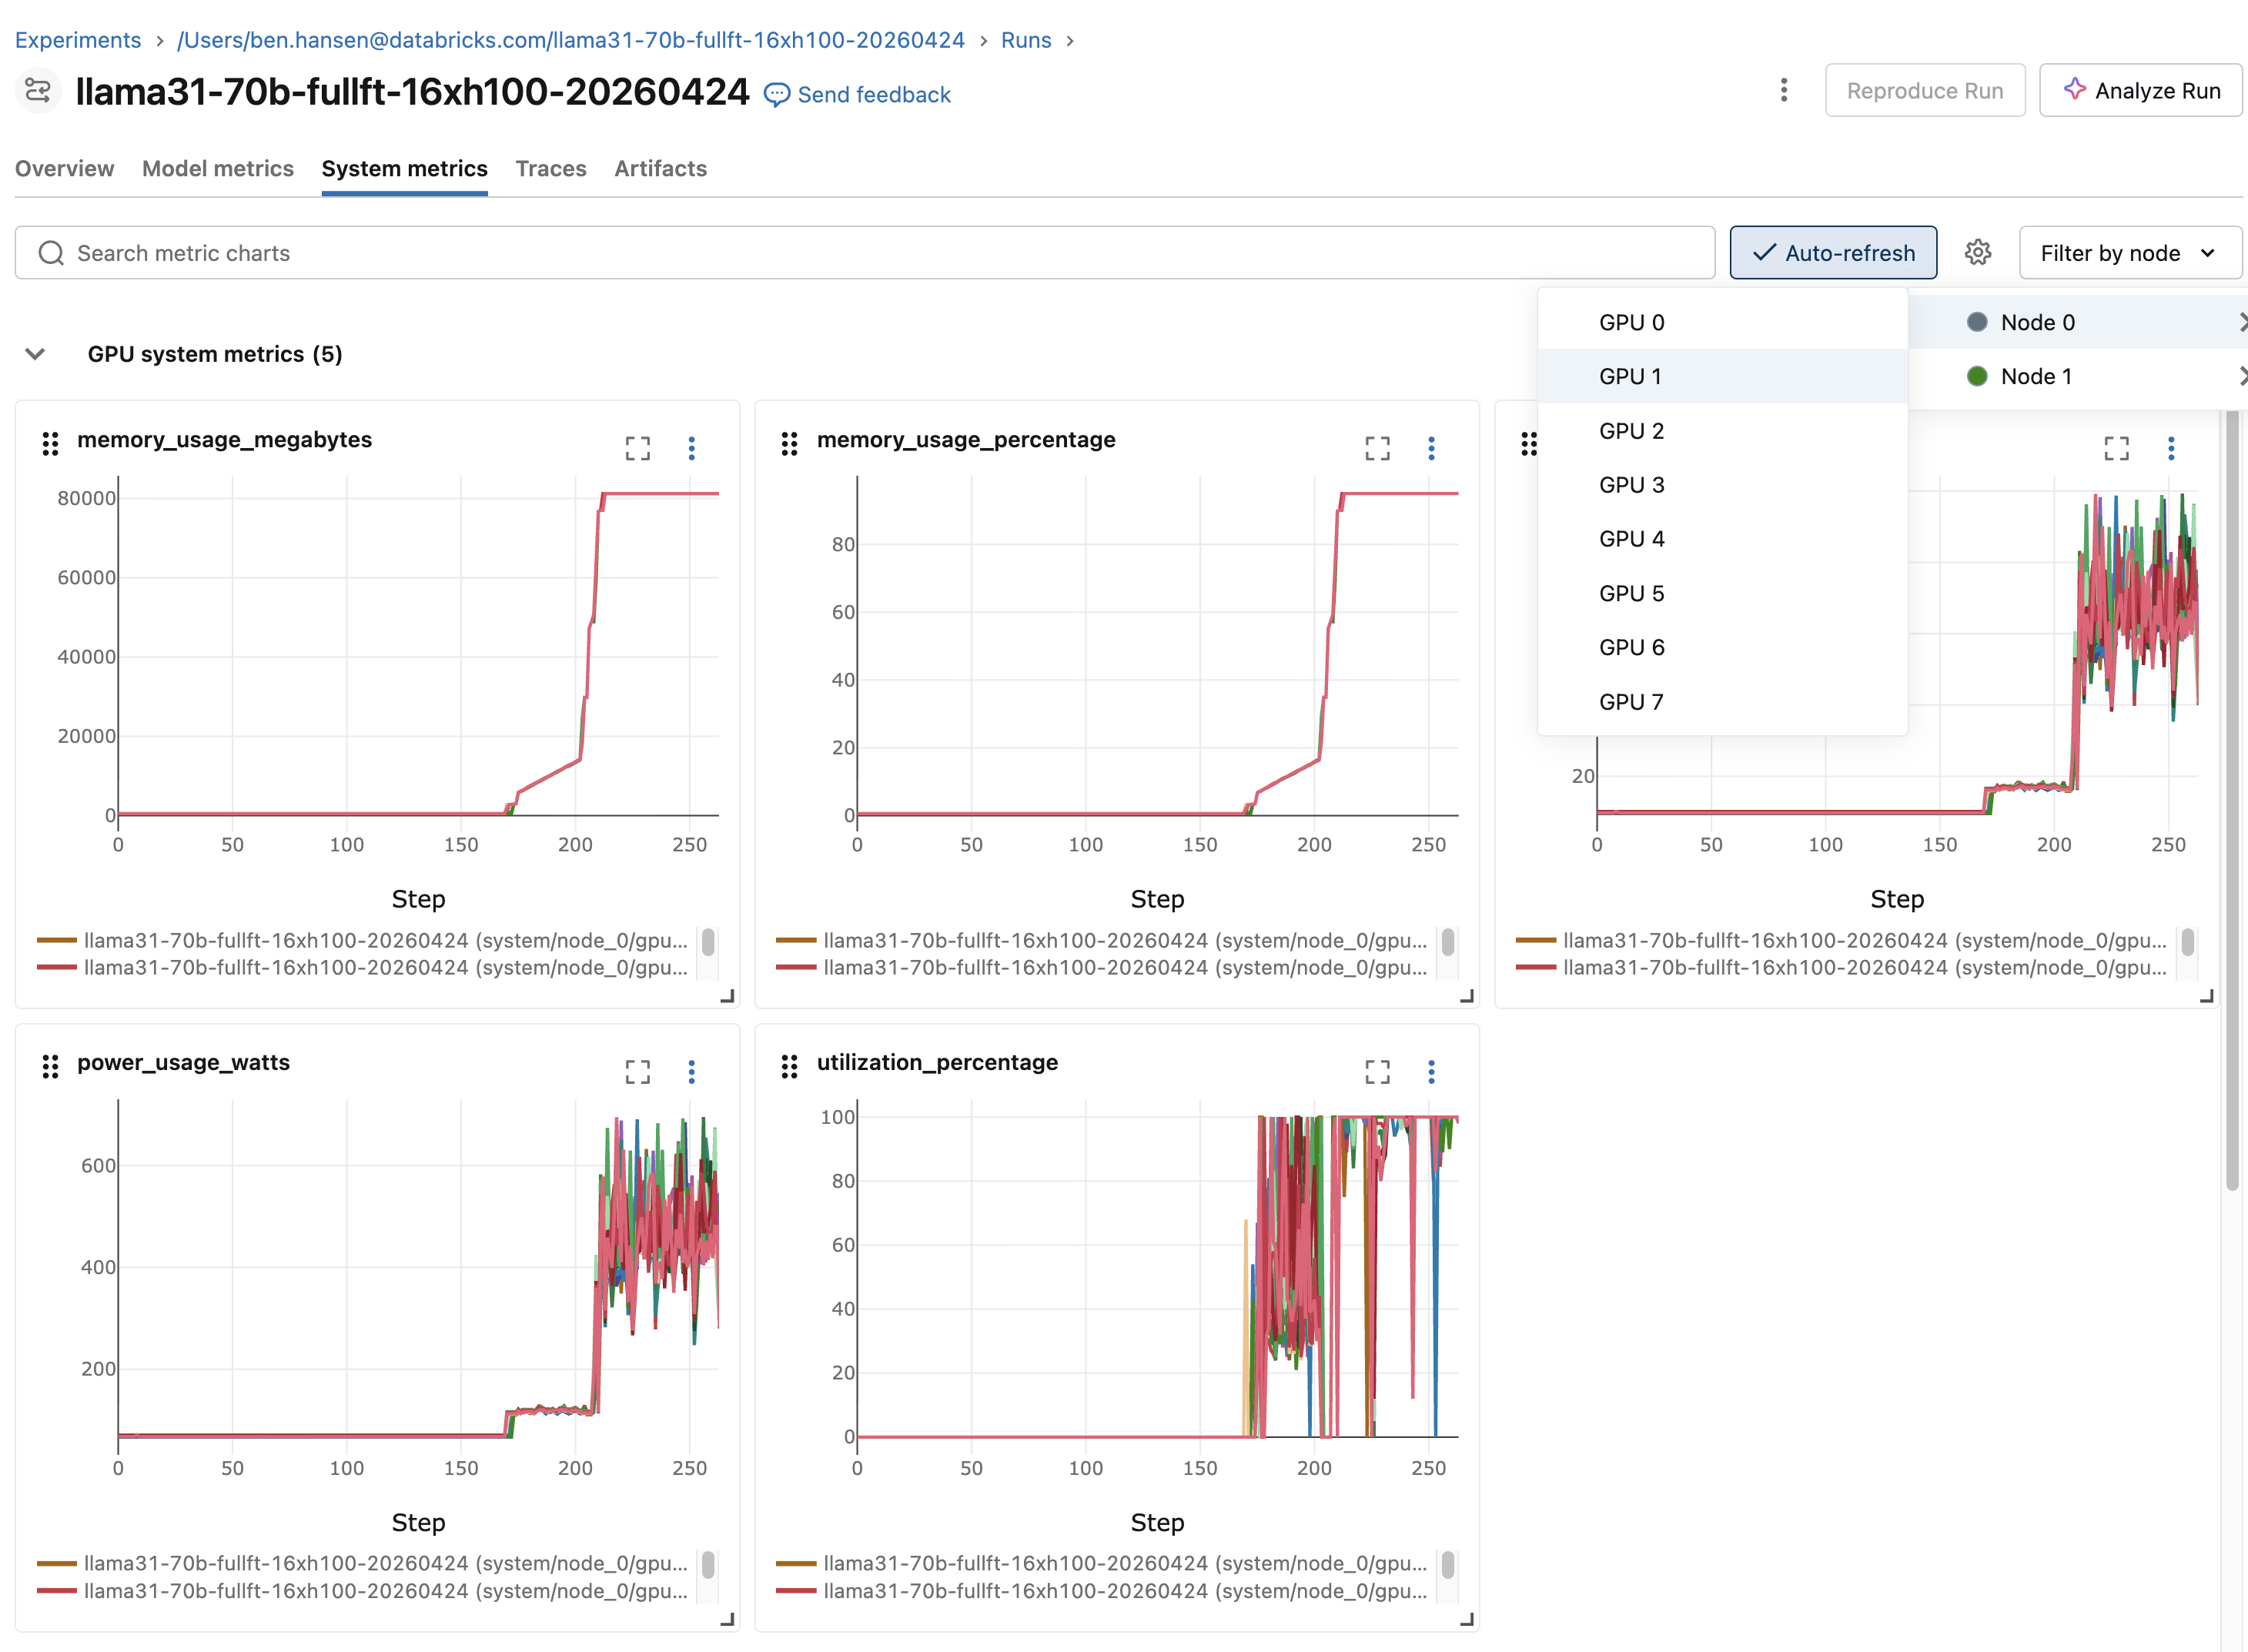
- Métricas do sistema: Veja a utilização da GPU, CPU e memória para execuções geridas no separador de métricas do sistema .
- Visualização de logs: Visualize a saída do controlador para uma carga de trabalho associada a uma tarefa no separador Logs da execução. Consulte Ver logs no separador MLflow Logs.
- Artefactos e modelos: Armazenar ficheiros de modelo, configurações e outras saídas com a execução. Utilize um volume do Unity Catalog para artefactos grandes ou duráveis.
- Partilha e colaboração: Conceda acesso a um experimento para que outros utilizadores do espaço de trabalho possam visualizar e comparar as suas execuções. Consulte Organize treinos com experimentos do MLflow.
- Integrações com frameworks: Use integrações MLflow com Hugging Face Transformers, PyTorch Lightning e outras bibliotecas suportadas.
Para cargas de trabalho apoiadas por tarefas, como cargas submetidas com databricks air run, a execução da tarefa no Azure Databricks complementa o MLflow ao registar o estado de execução, computação, tentativas e saída do controlador.
Como são criadas as execuções do MLflow
A forma como inicias ou participas numa run do MLflow depende de como inicias o workload:
| Como executa a carga de trabalho | Como começa a execução do MLflow | Como selecionar o experimento |
|---|---|---|
Databricks CLI (databricks air run) |
Cada tentativa cria automaticamente uma execução. | Defina experiment_name no YAML da carga de trabalho. |
Notebook com o Databricks AI Runtime SDK (.distributed()) |
Cada chamada cria automaticamente uma execução. | Ligue para mlflow.set_experiment() antes de .distributed(), ou defina MLFLOW_EXPERIMENT_NAME. |
| Código executado diretamente num notebook anexado | Nenhum run é criado automaticamente. Usar mlflow.start_run() ou autologging. |
Chama mlflow.set_experiment() no notebook. |
Agendado ai_runtime_task |
A tarefa cria automaticamente uma execução. | Defina experiment na configuração da tarefa. Veja a tarefa de execução de IA. |
Depois de o seu código iniciar ou se juntar à execução correta, use a API de rastreamento MLflow para registar dados de treino personalizados. Para frameworks suportados, pode usar o autologging em vez de adicionar chamadas de registo individuais. Para padrões de deep learning, veja o fluxo de trabalho de deep learning do MLflow 3.
Utilize as seguintes práticas ao configurar o rastreamento MLflow:
- Defina
steppara um valor significativo, como o lote global ou época. Registo a intervalos em vez de a cada lote. O MLflow limita o número de passos de métricas por execução. Consulte Limites de recursos. - Para treino distribuído, regista uma métrica apenas a partir do rank 0 para que cada valor seja registado uma vez.
- Para fluxos de trabalho de notebook, use caminhos absolutos do experimento, como
/Users/<username>/my-experimentou/Workspace/Shared/<team>/my-experiment. Coloca os experimentos que queres partilhar numa pasta de espaço de trabalho partilhada. - Armazene pontos de verificação grandes e duráveis num volume do Unity Catalog. Para padrões de checkpointing, veja Melhorar o desempenho do treino e a resiliência no AI Runtime.
Note
Utilize o MLflow 3.7 ou superior para os exemplos desta página.
Monitorizar cargas de trabalho da CLI do Databricks
Quando submetes uma carga de trabalho com databricks air run, o AI Runtime cria uma execução de um trabalho do Azure Databricks para obter os detalhes da execução e uma execução do MLflow para dados da experiência. A submissão original e as suas tentativas partilham uma execução de tarefa, enquanto cada tentativa cria uma execução separada do MLflow no mesmo experimento para que possas comparar tentativas.
As métricas do sistema de GPU, CPU e memória são capturadas automaticamente para cada execução gerida e aparecem no separador de métricas do Sistema MLflow.
Configurar e iniciar sessão no run
Use o YAML da carga de trabalho para selecionar o experimento e, opcionalmente, configurar o nome da execução e a localização do artefacto. O exemplo seguinte mostra os campos MLflow necessários:
experiment_name: my-training
mlflow_run_name: baseline-lr3e5
mlflow_artifact_location: /Volumes/main/default/mlflow-artifacts/my-training
Para requisitos de campo, predefinições e valores suportados, consulte referência do YAML de Workload.
O AI Runtime expõe o ID da execução gerida através de MLFLOW_RUN_ID. Para registares os teus próprios parâmetros, métricas e artefactos nessa execução, reabre-a com a API de rastreamento do MLflow:
import os

import mlflow

# Log from rank 0 only because all nodes share the same MLFLOW_RUN_ID.
if os.environ.get("RANK", "0") == "0":
    with mlflow.start_run(run_id=os.environ["MLFLOW_RUN_ID"]):
        mlflow.log_param("learning_rate", 3e-4)
        for step, loss in enumerate(training_losses):
            mlflow.log_metric("train_loss", loss, step=step)
Encontre execuções e registos
Os registos estão disponíveis tanto através da CLI Databricks como da página de execução do MLflow. Utilize os seguintes comandos para encontrar cargas de trabalho, inspecionar uma carga de trabalho e transmitir ou descarregar registos:
databricks air list --all-status
databricks air get <job-run-id>
databricks air logs <job-run-id>
databricks air logs <job-run-id> --node 2
databricks air logs <job-run-id> --download-to ./logs/
Monitorizar as cargas de trabalho dos notebooks
A partir de um notebook, pode executar código diretamente na sessão anexada ou executar treino distribuído através do decorador @distributed do Databricks AI Runtime SDK.
Executar código diretamente num notebook
O código executado diretamente num caderno associado não cria automaticamente um MLflow run. Selecione um experimento, depois inicie uma execução ou ative o autologging:
import mlflow

mlflow.set_experiment("/Users/<username>/my-experiment")

with mlflow.start_run(run_name="baseline"):
    train()
Para ativar o autoregisto do PyTorch Lightning, use o seguinte padrão:
mlflow.pytorch.autolog()

with mlflow.start_run(run_name="lightning-baseline"):
    trainer.fit(model, datamodule=datamodule)
Para Hugging Face Transformers, configure TrainingArguments da seguinte forma:
from transformers import TrainingArguments

args = TrainingArguments(
    output_dir="/Volumes/<catalog>/<schema>/<volume>/checkpoints",
    report_to="mlflow",
    run_name="llama7b-sft-lr3e5",
    logging_steps=50,
)
Utilize o SDK de Runtime de IA Databricks
Para treino distribuído a partir de um notebook, use o decorador @distributed do Databricks AI Runtime SDK (databricks-sdk-air). O SDK está disponível no databricks.air namespace no ambiente GPU versão 6 e superior, ou como serverless_gpu no ambiente GPU versão 5 e inferior.
from databricks.air import distributed

@distributed()
def train():
    # Training code
    ...

train.distributed()
Cada chamada a .distributed() cria automaticamente uma execução do MLflow. O experimento padrão é /Users/{WORKSPACE_USER}/{notebook-name}. Para selecionar outro experimento, defina-o antes de chamar .distributed():
mlflow.set_experiment("/Users/<username>/my-experiment")
train.distributed()
Quando chama .distributed() dentro de uma execução ativa, o Runtime da IA cria uma execução filha aninhada:
with mlflow.start_run() as parent_run:
    train.distributed()
Para retomar uma execução anterior, defina MLFLOW_RUN_ID antes de .distributed():
import os

os.environ["MLFLOW_RUN_ID"] = "<previous-run-id>"
train.distributed()
Utilize o link da run na saída da célula ou o painel Experiment do notebook para abrir a run do MLflow.
Ver registos
- Saída do notebook: A saída padrão e os erros do código de treinamento aparecem na saída da célula do notebook.
-
MLflow logs: Para cargas de trabalho de notebook suportadas por job, como chamadas
.distributed(remote=True), o separador MLflow Logs mostra a saída da execução do job associado.
Monitorizar os recursos da GPU em tempo real
O painel de recursos da GPU do portátil mostra a utilização em tempo real da GPU, memória e temperatura para cargas de trabalho de nó único e de vários nós. Utilize o separador Métricas do sistema do MLflow quando precisar de um registo persistente associado a uma execução.
Para abrir o painel, ligue o notebook ao AI Runtime, depois clique no  Recursos da GPU no painel lateral direito.
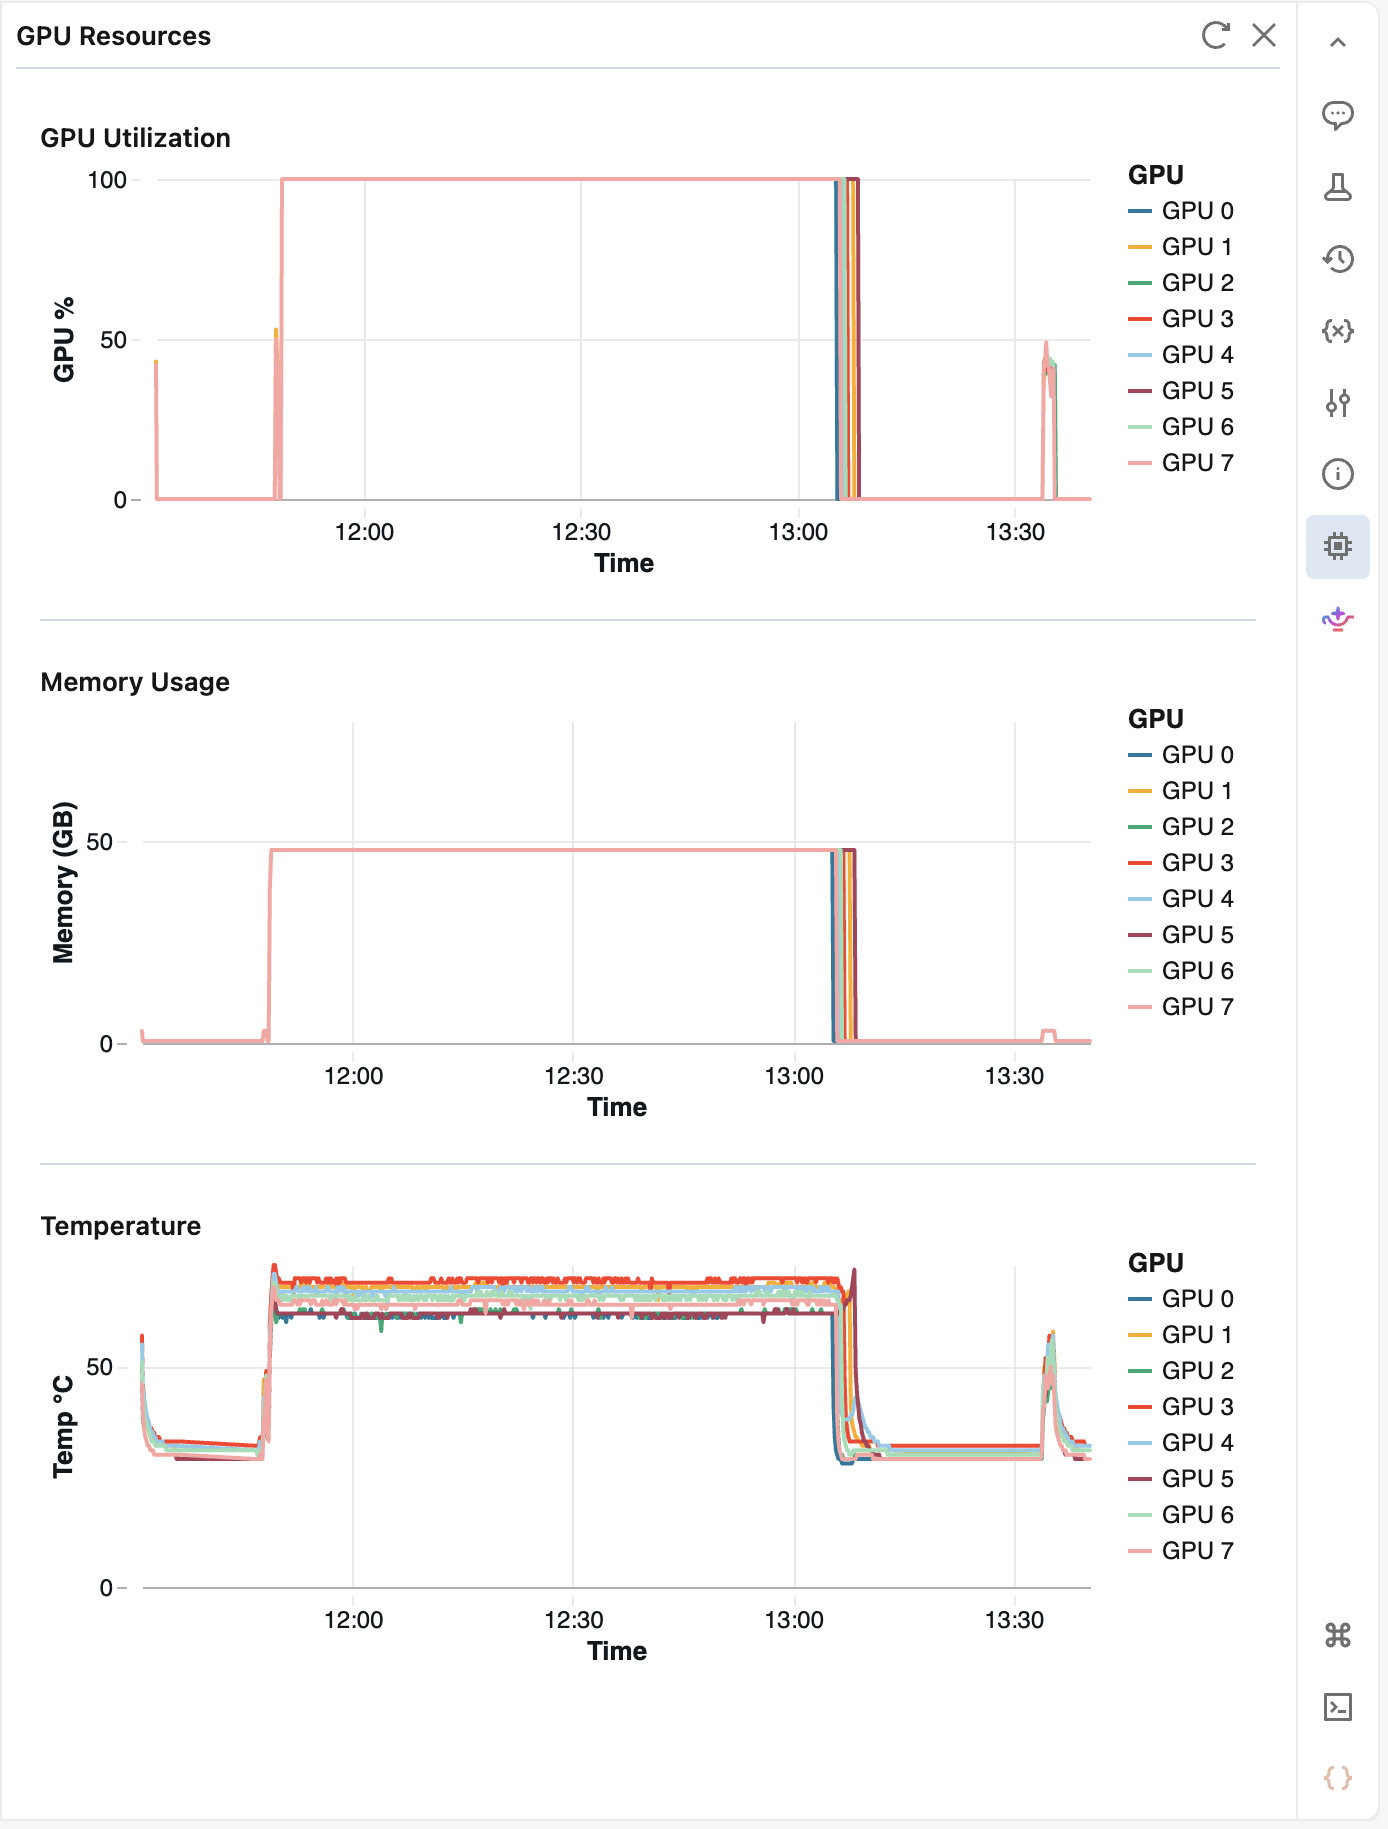
O painel consulta as métricas a cada 10 segundos e mantém até 2 horas de histórico. Clique  Atualize para obter os valores mais recentes. Após 5 minutos de inatividade, o painel pára. Reabra para retomar a monitorização.
Ver registos no separador MLflow Logs
O separador Logs numa página de execução do MLflow mostra a saída de uma carga de trabalho do AI Runtime suportada por tarefas. Para o abrir, vá à página de execução e clique em Registos.
Para novas execuções, o separador Registos substitui os ficheiros de registo anteriormente armazenados no separador de Artefactos da execução, que estão descontinuados. As execuções criadas anteriormente mantêm os ficheiros de registo no separador Artefactos .
No separador Logs, pode:
- Pesquisa: Mostrar apenas as linhas que contêm um termo de pesquisa.
- Filtrar por nó, nível e intervalo temporal: Selecione um único nó de uma carga de trabalho multi-nós, mostre apenas linhas de informação, aviso ou erro, ou reduza a vista a um intervalo temporal.
- Seguir uma carga de trabalho em curso: Enquanto a execução está ativa, a nova saída aparece à medida que chega. Role para cima para pausar o acompanhamento.
- Copiar e descarregar: Copiar as linhas carregadas, ou descarregar todas as linhas que correspondam aos filtros atuais.
Retenção de registos
Os registos estão disponíveis no separador Logs durante 60 dias.
Resolução de problemas do acesso aos registos
O separador Logs numa página de execução do MLflow mostra em fluxo a saída da execução do job associada do Azure Databricks. O acesso ao experimento MLflow não implica acesso à tarefa.
Se o separador mostrar que não tens acesso a esses logs, pede a um utilizador com permissão Pode gerir ou a um administrador do espaço de trabalho para te conceder pelo menos Pode ver na tarefa. Consulte Controlar o acesso a um trabalho.
Limites globais no Azure Databricks
Consulte Limites de recursos.