Nota
O acesso a esta página requer autorização. Pode tentar iniciar sessão ou alterar os diretórios.
O acesso a esta página requer autorização. Pode tentar alterar os diretórios.
Importante
Os itens marcados como pré-visualização neste artigo estão atualmente em pré-visualização. Esta pré-visualização é fornecida sem um acordo de nível de serviço, e a Microsoft não a recomenda para cargas de trabalho de produção. Certas funcionalidades podem não ser suportadas ou podem ter capacidades limitadas. Para mais informações, consulte Termos Suplementares de Utilização para Microsoft Azure Previews.
Importante
Programmed Training requer aprovação explícita de acesso. Solicite acesso através do formulário de inscrição para pré-visualização e aguarde aprovação antes de criar uma sessão de formação.
O Treino Programado (pré-visualização) é uma API para construir o seu próprio ciclo pós-treino sobre modelos de peso aberto no Microsoft Foundry. Controlas o experimento em Python. A Foundry executa amostragem de modelos e atualizações de adaptação de baixa classificação (LoRA) em GPUs serverless.
Para aprendizagem por reforço (RL), o seu código controla a recolha de trajetórias, recompensas, vantagens e agendamento de atualizações. As mesmas primitivas suportam aprendizagem supervisionada, aprendizagem por preferências, destilação e fluxos de trabalho de perda personalizada.
Quando utilizá-lo
Utilize Programmed Training quando o próprio ciclo de treino faz parte da sua investigação:
- Precisas de um sinal de aprendizagem personalizado. Forneça demonstrações, calcule recompensas e vantagens, ou formule uma função de perda local para aprendizagem de preferências ou outros objetivos.
- O seu modelo interage com um ambiente. Coordena respostas de modelos, chamadas de ferramentas, observações e recompensas no teu driver.
- Precisa de ter controlo sobre as atualizações individuais. Selecione lotes, máscaras de token, definições de perda e parâmetros do otimizador. Decida quando acumular gradientes e aplique uma atualização.
- Queres inspecionar e adaptar um experimento. Amostre do adaptador atual, avalie os prompts reservados para avaliação e escolha os próximos prompts com base nos resultados observados.
- Precisas de preservar e continuar a progredir. Guardar o estado do adaptador e do otimizador, depois retomar numa sessão compatível. Mantém a posição do conjunto de dados e outros estados do experimento no teu controlador.
Managed Training também suporta classificadores para afinação fina por reforço. Escolhe Treino Programado quando precisares de controlo sobre o ciclo, não só sobre o classificador ou as definições da tarefa. Veja Escolha a sua abordagem de treino.
Quem faz o quê
O teu programa de Python é o controlador do treino. Prepara os inputs e coordena o experimento. A Foundry mantém o estado do modelo e do adaptador e executa as operações solicitadas.
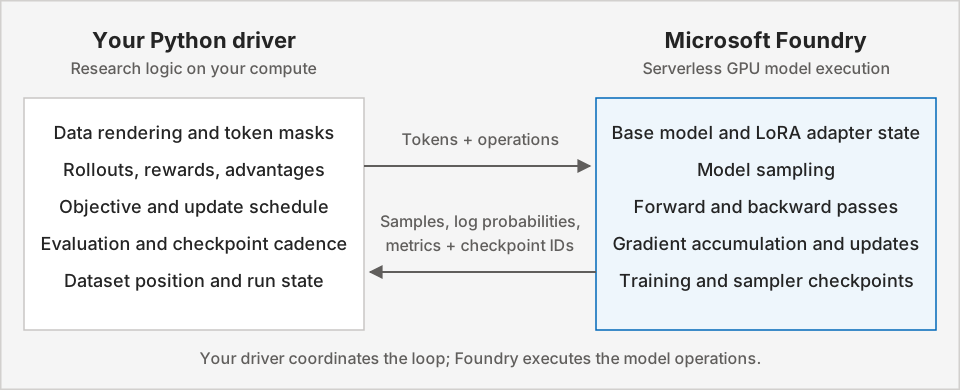
O seu driver pode correr num computador, incluindo a sua própria máquina ou num ambiente de computação. Um modelo de recompensa ou ambiente que adicionas pode ter os seus próprios requisitos de computação. Mantém o driver a funcionar enquanto gere o loop.
Conceitos centrais e primitivos
Uma sessão mantém estado: cálculo de gradiente, atualizações de otimizadores e amostragem são operações separadas sobre o modelo e adaptador selecionados. Esta separação permite-lhe escolher quando recolher dados, acumular gradientes, atualizar e avaliar.
| Bloco de construção | O que faz |
|---|---|
| Sessão de treino e adaptador LoRA |
FineTuningSession.create Inicializa um modelo base suportado com a configuração do teu adaptador. A sessão contém o estado utilizado pelas operações subsequentes. |
| Lote tokenizado e máscaras |
Datum contém entradas de modelo e entradas da função de perda. As máscaras selecionam quais os tokens que contribuem para a aprendizagem, como tokens do assistente em vez de prompts ou observações de ferramentas. |
| Amostragem |
sample Gera respostas a partir de um checkpoint selecionado do sampler. As entradas de RL emparelham tokens amostrados com as suas log‑probabilidades de rollout e vantagens derivadas da recompensa. |
| Passos para a frente e para trás |
forward devolve as saídas da função de perda para cada exemplo sem acumular gradientes.
forward_backward calcula o objetivo selecionado e acumula gradientes. Não aplica uma atualização do otimizador. |
| Atualização do otimizador |
optim_step aplica gradientes acumulados com os teus parâmetros de Adam. Escolhes quando atualizar e qual a taxa de aprendizagem a usar. |
| Ponto de controlo do amostrador |
save_weights_for_sampler Prepara os pesos dos adaptadores para geração. Atualize novamente estes pesos após uma atualização antes de amostrar a partir do adaptador atualizado. |
| Ponto de verificação do treino |
save_weights persiste os pesos dos adaptadores e o estado do otimizador.
FineTuningSession.create_from_checkpoint Retoma o treino numa sessão compatível. |
O SDK inclui cross_entropy para atualizações supervisionadas e perdas de RL como importance_sampling e ppo. Estas perdas são primitivas de perda, não algoritmos de ponta a ponta pré-definidos. Para contratos de input e composição de perdas personalizadas, veja Conceitos-chave.
Como funciona um loop RL
Considere um experimento de raciocínio matemático: o seu modelo gera várias respostas para cada problema e o seu programa avalia a sua correção. Para um exemplo prático, siga Introdução.
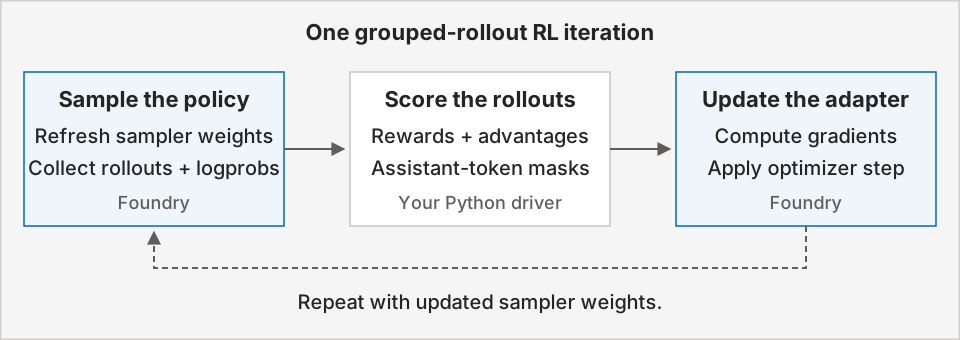
Estabeleça uma baseline de validação e teste a sua função de recompensa antes da primeira atualização. Depois repita:
- Prepare a política atual para amostragem. Guarde os pesos do sampler do adaptador de treino e depois recolha várias respostas, ou rollouts, para cada prompt.
- Pontuar e comparar respostas. A tua função de recompensa atribui uma pontuação a cada rollout. Subtraia a recompensa média do grupo de prompts para obter a vantagem de cada rollout.
- Preparar o sinal de aprendizagem. Alinhe os tokens do assistente amostrados com as probabilidades log do rollout e vantagens. Exclua os prompts e as observações do ambiente do sinal de aprendizagem.
- Calcular gradientes. Submeter o lote para
forward_backwardcomimportance_sampling. Complete o cálculo do gradiente antes da atualização que o consome. - Atualize o adaptador. Ligue para
optim_step, depois atualize os pesos do sampler antes de recolher respostas da política atualizada. - Avalie e preserve o progresso. Compare a correção no conjunto de validação com a referência e guarde os pontos de controlo de treino na cadência escolhida.
Introdução
Escolha o ponto de partida que se adequa à sua tarefa:
- Início rápido: Siga o exemplo de início rápido para clonar o repositório e execute uma receita curta de aprendizagem por reforço.
- Experimente outras receitas: Explore o repositório de amostras de ajuste fino para mais exemplos de treino.
- Procura uma operação: Usa a folha de dicas do SDK (pré-visualização) para funções e parâmetros-chave.
- Compreenda o ciclo de treino: Leia conceitos-chave para recompensas, vantagens, máscaras de tokens e pontos de controlo.
Modelos e regiões suportados
Consulte a visão geral de ajuste fino para modelos suportados e regiões suportadas.