Nota
O acesso a esta página requer autorização. Pode tentar iniciar sessão ou alterar os diretórios.
O acesso a esta página requer autorização. Pode tentar alterar os diretórios.
Este artigo descreve um processo em seis fases para migrar uma carga de trabalho alimentada por LLM de um modelo base para outro: o que considerar em cada fase, quais as funcionalidades do Microsoft Foundry aplicáveis e como o trabalho muda para diferentes tipos de equipas.
O que significa migração de modelos
Cada modelo que executa em produção tem uma data de descontinuação. Quando um modelo do qual depende é substituído, ou quando um modelo mais recente se adequar melhor à sua carga de trabalho, faz a migração. Trocar um modelo não é uma alteração de uma linha: um modelo diferente pode alterar silenciosamente o tom, a formatação, a forma JSON, a latência, o custo ou o comportamento de chamada de ferramenta, e quebrar código a jusante que depende do comportamento antigo.
Uma migração bem-sucedida preserva o comportamento da aplicação ou melhora-o de formas mensuráveis. O sucesso requer um processo repetível para detetar deriva, adaptar-se em segurança e provar qualidade antes da implementação em larga escala.
Quando migrar
Uma migração geralmente começa por uma de quatro razões:
- Um modelo está a ser descontinuado. Na Foundry, todos os modelos de disponibilidade geral têm uma data de descontinuação, e as famílias mais antigas são substituídas ao longo do tempo. Para a política e as datas de descontinuação, consulte o ciclo de vida e a política de suporte dos Foundry Models e o calendário de descontinuação dos modelos.
- Existe um modelo melhor disponível. Um modelo mais recente oferece maior qualidade, menor custo, melhor latência ou uma capacidade (como saída estruturada ou melhoria na chamada de ferramentas) que a sua carga de trabalho precisa.
- Um problema de custo ou latência obriga uma alteração. A latência ou custo unitário do modelo atual já não corresponde às suas necessidades.
- Uma lacuna de capacidade bloqueia o produto. O modelo atual não consegue fazer algo que o seu produto agora exige.
O que acontece na data da reforma
O que o Azure faz quando um modelo se aposenta depende de como compra capacidade, e o Foundry usa terminologia diferente para cada caminho:
- As implementações Standard, Global Standard e Data Zone Standard (pay-as-you-go) são automaticamente atualizadas num calendário contínuo, região a região. Controla o momento com
versionUpgradeOptiondefinido como um de:OnceNewDefaultVersionAvailable,OnceCurrentVersionExpiredouNoAutoUpgrade(o que significa que a implementação deixa de funcionar na descontinuação). O Processamento de Prioridades segue o mesmo caminho. - As implementações provisionadas (PTU)não são atualizadas automaticamente. Migra-as tu próprio, seja no local (o tráfego move-se numa janela de 20–30 minutos sem tempo de inatividade) ou lado a lado (ativar a nova implementação, testar, alterar o tráfego, eliminar a antiga).
- As implementações por lotes seguem uma abordagem paralela: implementar o novo modelo, reenviar trabalhos e descontinuar a implementação anterior.
Independentemente do caminho que se aplique, o desafio do programador é o mesmo: numa data definida, o seu tráfego começa a atingir um modelo diferente. Um endpoint que ainda responde não significa que a sua aplicação continue a comportar-se corretamente, por isso tanto as cargas de trabalho atualizadas automaticamente como as migradas manualmente beneficiam da avaliação e validação que este artigo descreve.
Migre antes da data de reforma
A atualização automática é apenas uma rede de segurança para implementações pay-as-you-go, não um plano de migração. As implantações provisionadas não têm rede de segurança. De qualquer forma, não substitui um plano de migração. Dois compromissos de política dão-lhe flexibilidade para migrar ao seu próprio ritmo, em vez de esperar pelo prazo:
- O modelo de substituição fica disponível cerca de 90 dias antes da reforma na Global Standard, e cerca de 30 dias antes da reforma nas regiões provisionadas onde o antecessor está a reformar-se. Use esta janela para avaliar o novo modelo e migrar manualmente.
- As datas de reforma não são prorrogáveis. Não há processo de exceção, por isso uma data que não planeaste ainda se aplica a ti.
Não precisas de um aviso de desautorização para começar. Se um modelo mais recente for mais barato, mais rápido ou mais capaz, passa-o pelo processo agora. Migrar transforma deliberadamente a data de reforma numa formalidade. Como as migrações são repetidas, vale a pena tornar o processo repetível.
Quem deve usar o processo de migração
O processo de migração encaixa melhor quando a sua equipa constrói uma funcionalidade alimentada por LLM dentro de um produto ou plataforma maior, migra numa cadência aproximadamente trimestral e tem um proprietário claro (como uma equipa central da plataforma ou a equipa da app) a gerir cada migração de forma deliberada.
Este processo também se adequa às equipas nativas de IA, onde o modelo é o produto. As fases são as mesmas, mas decorrem mais rapidamente e muitas vezes em paralelo, em vez de em sequência rígida.
O processo assume que estás a mover-te entre modelos base, ou seja, modelos que implementas conforme publicado no catálogo de modelos, sem personalização ao nível de peso. Cargas de trabalho afinadas estão fora do âmbito. Não podem ser atualizados automaticamente, pois têm o seu próprio prazo para o treino e o fim de vida da implementação. Adaptar cargas de trabalho finamente ajustadas significa destilação ou re-treino, em vez de alterações rápidas e de esquema. Se utilizar implementações com ajuste fino, planeie repetir o ajuste fino com base no modelo de base de substituição o quanto antes.
Fases de migração
Uma migração passa por seis fases. Cada fase produz uma saída que a fase seguinte utiliza. As fases de migração são:
Descubra → Avalie → Adapte → Valide → Implemente → Descontinue
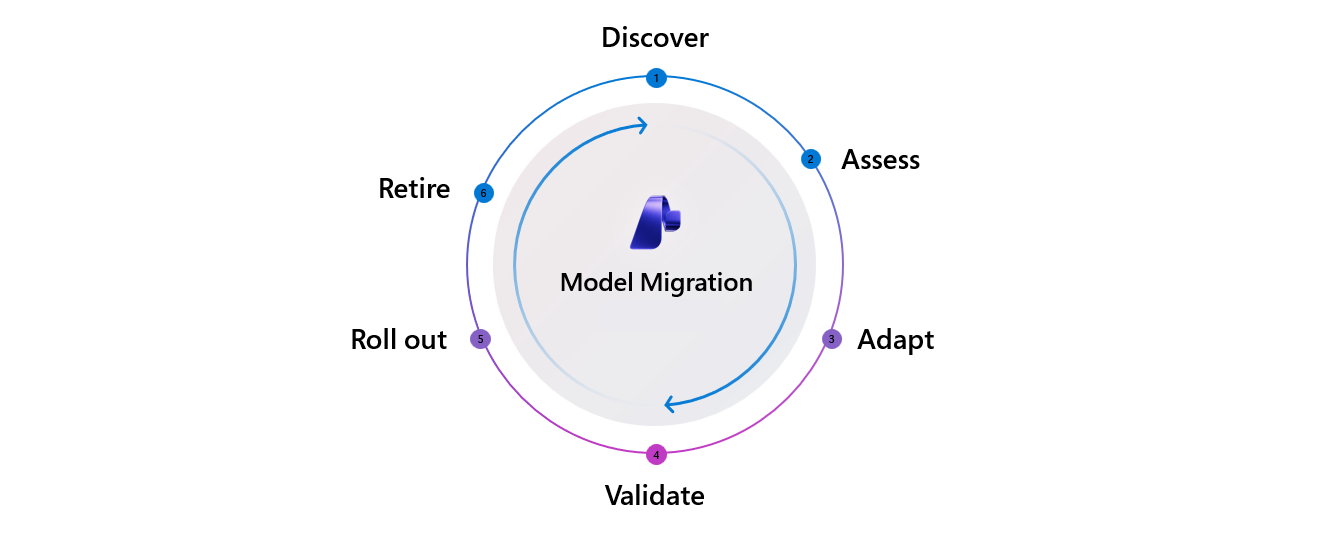
A tabela seguinte descreve cada fase e as funcionalidades e ferramentas da Foundry que a suportam. As funcionalidades estão disponíveis tanto no Microsoft Foundry como no Azure OpenAI, a menos que estejam marcadas apenas como Foundry, o que significa que o Azure OpenAI não tem equivalente.
As secções por fase mais adiante neste artigo explicam porque cada fase existe, como é um resultado bem-sucedido, o que considerar, quando usar cada funcionalidade e onde a fase costuma quebrar.
| Fase | Description | Funcionalidades e ferramentas |
|---|---|---|
| Descubra | Aprende que uma mudança de modelo está a chegar ou é necessária, e decide se deves agir. |
|
| Avaliar | Escolha o modelo alvo e confirme que está operacionalmente disponível. |
|
| Adaptar-se | Executar novamente a carga de trabalho atual no novo modelo, diagnosticar alterações comportamentais e reformular prompts, parâmetros, definições de ferramentas, esquemas de saída e o código que as invoca. |
|
| Validação | Avalie a carga de trabalho adaptada com uma rubrica de qualidade para decidir se é seguro enviar. |
|
| Implementar | Promove para a produção através de exposição faseada, monitoriza o comportamento ao vivo e compromete ou recua. |
|
| Retire | Desativar a implementação antiga, libertar capacidade, arquivar avaliações e atualizar a documentação subsequente. |
|
Antes de migrar: Prepare um conjunto de dados de teste
Esta etapa de preparação reúne um conjunto de inputs representativos, resultados esperados e critérios de sucesso acordados antes de qualquer trabalho de migração começar. Este conjunto é uma dependência de bloqueio para o meio do processo: não podes repetir na fase de Adaptar sem entradas, e não podes pontuar na fase de Validar sem a verdade e critérios fundamentais.
O que considerar
- Constrói o conjunto de dados antes de escolheres um alvo. O conjunto de dados descreve a sua carga de trabalho, não o modelo candidato, por isso pode montá-lo em paralelo com o Discover.
- Recolha informações de fontes reais ou sintéticas. Use tráfego de produção capturado ou exemplos de domínios curados como CSV ou JSONL. Quando ainda não tiveres dados representativos, gera entradas sintéticas e adversariais com o Simulador.
- Capture instrumentos antes de precisar deles. A captura de conteúdo de produção é de adesão voluntária e nunca é retroativa, pelo que não é possível avaliar o tráfego que não foi registado. Comece já a registar pedidos, respostas, latência e contagem de tokens.
- Congela o conjunto de dados. Mantenha as entradas, os valores de referência e os critérios de sucesso fixos ao longo de toda a migração. Se algum deles mudar, já não pode comparar resultados de origem e alvo.
Também precisa de um inventário das implementações de modelos que a sua carga de trabalho utiliza, incluindo os seus tipos de implementação (Standard, Provisioned ou Batch). Para cada modelo de origem, indique a sua data de aposentação e a substituição sugerida do calendário de retirada do modelo.
Fase 1: Descobrir
O objetivo da fase de Descoberta é reconhecer que uma mudança de modelo se aproxima ou vale a pena e decidir se se deve agir. O resultado é uma decisão de avançar ou não, e manter o modelo atual é uma escolha válida. Um resultado bem-sucedido é um sinal precoce e estruturado que indica a data de desuso, modelo de substituição e janela de migração, ou uma decisão deliberada de permanecer no modelo atual.
O que considerar
- Qual é a data de aposentação e de quanta margem dispõe realmente? Considere a data de descontinuação menos o tempo necessário para a validação e a implementação como o verdadeiro prazo.
- Existe algum substituto sugerido nomeado, ou é preciso selecionar candidatos por si próprio?
- A alteração implica restrições de conformidade ou regionais (para cargas de trabalho reguladas, a disponibilidade e a certificação muitas vezes importam antes da qualidade)?
Onde normalmente avaria
As equipas ficam a saber sobre as aposentações de forma inconsistente, através de um email, de um banner de portal ou de uma mensagem interna, e percebem o sinal tardio. Esse atraso encurta uma janela já apertada. Desenvolvedores individuais e pequenas equipas frequentemente descobrem a descontinuação através de um erro em produção, em vez de através de um anúncio.
O que trouxeste
O calendário de aposentação e a API Models expõem os dados num contrato estável. As organizações maduras adicionam uma fina camada interna de notificação por cima para encaminhá-la aos proprietários certos.
Fase 2: Avaliar
O objetivo da fase de Avaliação é escolher o modelo-alvo candidato e confirmar que pode executá-lo: a região certa, o tipo de implementação correto, quota suficiente e disponibilidade juntamente com o modelo atual para que o rollback continue possível. Um resultado bem-sucedido é uma escolha clara entre modelos candidatos, com a região, SKU, quota e custo confirmados antes do início da afinação.
O que considerar
- Qualidade e posicionamento entre candidatos. Quando vários modelos estiverem em funcionamento, decida qual se adequa à sua carga de trabalho em termos de qualidade, e não apenas qual pontua mais alta num benchmark público.
- Custo do seu próprio tráfego. A estrutura de preços muda entre gerações de modelos. Os tokens de raciocínio, as entradas em cache e a sobrecarga da saída estruturada podem fazer variar os custos unitários em 2x ou mais, por isso projete o custo mensal com base no histórico de tráfego, em vez de se basear só no preço de tabela.
- Disponibilidade operacional. Confirme a região, o SKU e a quota, e que o sistema de destino pode funcionar em paralelo com o sistema de origem para manter uma via de reversão.
- Controlo de conformidade. Para cargas de trabalho reguladas, a certificação e a disponibilidade regional podem filtrar a lista de candidatos antes de a qualidade entrar na conversa.
Onde normalmente avaria
A paralisia da escolha instala-se quando vários candidatos têm posições incertas. As equipas só descobrem a meio do plano que o modelo escolhido não está disponível na sua região ou SKU. Ou uma projeção de custos revela que o novo modelo é substancialmente mais caro no tráfego real.
O que trouxeste
Os benchmarks são calculados em conjuntos de dados públicos , por isso trate o ranking como um filtro em vez da linha de chegada e confirme a lista curta com base na sua própria carga de trabalho. A projeção de custos segue a mesma lógica: a perspetiva mensal resulta dos seus próprios registos de tokens, o que é simples quando já se dispõe dos dados de tráfego.
Fase 3: Adaptar-se
O objetivo da fase Adapt é fazer com que a carga de trabalho funcione bem no novo modelo. Reproduza primeiro a carga de trabalho existente inalterada (para isolar alterações de comportamento orientadas pelo modelo), diagnostice o que mudou e depois reengenheira iterativamente. Um resultado bem-sucedido é uma comparação de comportamentos lado a lado com o tráfego real ou representativo, com cada alteração a ser acompanhada.
Adapt é mais do que edição de prompts
Os prompts são o elemento mais visível, mas uma migração normalmente afeta outras quatro áreas:
-
Parâmetros.
temperature,top_p,max_tokens, e os controlos do esforço de raciocínio não têm uma correspondência direta entre gerações, e as famílias de modelos mais recentes podem não suportar alguns parâmetros. - Definições de ferramentas. Pode ser necessário reformular ou ajustar nomes de argumentos, descrições e campos obrigatórios que guiassem o modelo antigo de forma fiável.
- Esquemas de saída. Os modelos diferem na forma como aderem à saída estruturada. Podes precisar de adicionar restrições explícitas a um esquema que o modelo antigo cumpria de forma vaga, ou podes finalmente conseguir impor um esquema.
- Indicativo de chamada. Diferenças na superfície da API e no SDK (Chat Completions versus Respostas, forma de streaming e campos de pedido novos ou renomeados). Também poderá ser necessário atualizar o processamento a jusante que assumia a estrutura anterior da resposta.
Para cargas de trabalho agênticas e de fluxos de trabalho, o trabalho com esquemas e chamadas a ferramentas frequentemente ultrapassa o trabalho com prompts.
O que considerar
- Reproduza sem alterações antes de afinar. Executa a tua configuração atual no modelo alvo sem quaisquer alterações. Esta abordagem ajuda-te a separar o comportamento que o modelo alterou das mudanças que introduziste, e dá-te uma referência.
- Vê o que realmente muda. O nível de verbosidade, a profundidade do raciocínio, a conformidade com formatos de saída estruturados, o formato das chamadas de ferramentas, o comportamento de recusa e a variância da latência também variam com frequência.
- Reproduza traços reais para detetar regressões por chamadas de ferramenta. Campos extra, argumentos renomeados e superfície de sequenciação alterada apenas em trilhas reais, não em benchmarks de turno único.
- Acompanha as tuas mudanças. A reengenharia rápida é fácil de fazer e fácil de perder. Guarda o original e regista o que mudou e porquê.
Características da fundição
Três funcionalidades da Foundry suportam esta fase:
- Prompt Optimizer é o botão Otimizar diretamente abaixo do campo de instruções do sistema no playground do Agente. Reestrutura as tuas instruções usando as melhores práticas de engenharia de prompts, mostra raciocínio por parágrafo para cada alteração e suporta um ciclo de iteração: adiciona uma sugestão como "mantém o esquema JSON exatamente" e re-otimiza. Disponível apenas no Foundry, não no Azure OpenAI.
- A otimização de agentes ajusta instruções, ferramentas e seleção de modelos em conjunto para as cargas de trabalho dos agentes. Disponível apenas no Foundry, não no Azure OpenAI.
- Simulator gera entradas sintéticas e adversariais quando não existem dados de produção para reproduzir.
Onde normalmente avaria
Para cargas de trabalho embutidas e orientadas para o produto, esta fase normalmente demora mais tempo porque o ciclo de diagnóstico é manual: as equipas repetem prompts, comparam as diferenças e raramente registam o que mudaram ou porquê.
O que trouxeste
- Começa pelos otimizadores e depois verifica. Aplicam boas práticas gerais numa única passagem em vez de se ajustarem ao seu conjunto de dados, e ajustam o texto de instruções em vez de definições de ferramentas ou esquemas de saída. Trate o resultado como uma versão preliminar sólida: copie primeiro o seu prompt original (não existe histórico de versões) e, depois, reavalie-o com base no seu conjunto de dados congelado antes de confiar nessa alteração.
- Planeie trabalho prático extra para mudanças entre famílias. Não existe um processo de "otimização para o modelo de destino X", pelo que a transição entre famílias de modelos implica uma tradução deliberada de prompts e esquemas.
- Regista o tráfego antes de precisares dele. A reprodução só é tão boa quanto a captura efetuada, e a captura de conteúdo é de adesão voluntária e nunca é retroativa.
Fase 4: Validar
O objetivo da fase de Validar é decidir se a carga de trabalho adaptada é segura para enviar, pontuando-a contra uma rubrica de qualidade num conjunto de dados selecionado. A grelha de avaliação pode ser baseada em regras, baseada em referências, um LLM como avaliador, uma revisão humana ou uma estrutura específica do domínio. Um resultado bem-sucedido é entregar uma suíte de avaliação de confiança, executada num conjunto de dados congelado, que tanto a equipa da aplicação como quaisquer revisores acreditem.
Validar é uma fase, mas tem dois pontos de contacto, por isso não o trate como um único evento de fim de linha:
- Prepare-se com antecedência. Congele o conjunto de dados e os critérios de sucesso em Antes de migrar, antes de se adaptar. No momento em que essas mudanças mudam, a sua origem e alvo deixam de ser comparáveis.
- Entrada atrasada, em duas passagens. Executa primeiro o modelo atual no conjunto congelado para estabelecer uma referência de origem, o valor que tens de superar. Em seguida, atribui uma pontuação ao alvo usando o mesmo conjunto e decide.
O que considerar
- Mantenha o conjunto de dados e os critérios congelados. Esta é a disciplina mais importante no processo para manter os resultados comparáveis.
- Meça as três dimensões que correspondem à aprovação: qualidade (pontuações do avaliador ou revisor), latência (tempo até ao primeiro token e throughput, isolado à chamada que está a migrar) e custo (custo do token de entrada e saída por pedido).
- Ajusta a rubrica à carga de trabalho. Uma rubrica de sumarização clínica, uma validação da sequenciação de chamadas de ferramentas para agentes, ou sinais pré-existentes de feedback dos utilizadores podem ser mais relevantes do que uma pontuação genérica.
- Trate o portal como um sinal para equipas nativas de IA. Em vez de uma aprovação ou reprovação única, a avaliação decorre continuamente, em cada commit, e integra-se no Roll out.
Características da fundição
Duas funcionalidades da Foundry suportam esta fase:
- Azure AI Evaluation SDK inclui mais de 30 avaliadores integrados, abrangendo fundamentação, relevância, recuperação, coerência, fluência, métricas baseadas em referências (F1, BLEU e ROUGE), segurança, agentes e avaliadores do Azure OpenAI. Inclui também um LLM-as-judge personalizado para rubricas específicas de tarefa.
- A avaliação do portal executa os mesmos avaliadores sobre modelo, agente, conjunto de dados e alvos de rastreamento.
Execute o mesmo conjunto de avaliadores contra a origem e o alvo no conjunto de dados congelado para que os números sejam comparáveis.
| Dimensão | O que medir | Onde |
|---|---|---|
| Quality | Pontuações dos avaliadores em origem vs. alvo | Azure AI Evaluation SDK, avaliação no portal |
| Latency | Tempo até ao primeiro token e throughput | Tabela de classificação de benchmarks, métricas operacionais |
| Custo | Custo dos tokens de entrada e saída por pedido | Resultados da avaliação, preços do modelo |
Onde normalmente avaria
A maioria das equipas não tem uma suíte de avaliação, e as que têm, muitas vezes construíam-na eles próprios. Para cargas de trabalho reguladas, uma revisão obrigatória humana ou de gestão da qualidade sobrepõe-se e torna-se o gargalo. Estas migrações ficam bloqueadas na fase Validar, não na fase Adaptar.
O que trouxeste
Os avaliadores estão prontos a ser executados, mas criar e selecionar um conjunto de testes adequado ao domínio com base no seu próprio tráfego de produção é um trabalho manual para cargas de trabalho de modelos (não de agentes). Esta necessidade é a razão pela qual a etapa de preparação se compensa.
Fase 5: Lançamento
O objetivo desta fase é promover a configuração validada para a produção em etapas: primeiro não produção, depois uma percentagem de canário ou ponderada, e depois uma exposição mais ampla. Ao longo de todo o processo, monitorize a latência em tempo real, os erros e, idealmente, a qualidade face ao valor de referência pré-migração. Em seguida, confirme ou reverta. Um resultado bem-sucedido é uma exposição gradual através de tráfego canário, ponderado ou sombra, um sinal de qualidade em tempo real para além da latência e erros, e um caminho de rollback preservado.
O que considerar
- Conhece o teu tipo de destacamento. O seu tipo de implementação determina o mecanismo: as implementações da família Standard podem ser atualizadas automaticamente de acordo com uma calendarização definida por si. Implementações provisionadas, em lote e ajustadas finamente são migradas manualmente. A tabela seguinte mostra a mecânica por tipo.
- Preservar uma via de reversão. Mantém a implementação antiga acessível até teres confiança. Decisões de reversão forçadas por um prazo-limite de descontinuação, em vez de evidências, são um sinal de alerta de que começaste demasiado tarde.
- Quando não puderes usar a estratégia canary, usa o modo shadow ou mirror. Fluxos regulados (PHI, transações financeiras) muitas vezes não conseguem expor um novo modelo ao tráfego real dos clientes. O equivalente é executar o novo modelo em entradas de produção offline e comparar as saídas com o modelo antigo sem afetar os utilizadores.
- Esteja atento a regressões que a avaliação offline não detetou. A latência real do utilizador e o comportamento em casos marginais só podem surgir sob carga de produção.
Mecânica de migração por tipo de implantação
| Tipo de implantação | Abordagem da migração | Quota |
|---|---|---|
| Padrão, Padrão Global, Padrão de Zonas de Dados | Atualização automática de forma faseada. Controla o tempo com versionUpgradeOption (OnceNewDefaultVersionAvailable, OnceCurrentVersionExpired, ou NoAutoUpgrade). O Processamento de Prioridades segue o mesmo caminho. |
Transfere automaticamente |
| Aprovisionado | Manual: no local (tráfego move-se numa janela de 20–30 minutos) ou lado a lado (nova implementação, mudança de tráfego, eliminação da antiga). | Garantir primeiro a quota do modelo-alvo |
| Batch | Em paralelo: implementar o novo modelo, reenviar os trabalhos e, em seguida, desativar a implementação antiga. | Garantir a quota do modelo-alvo |
| Ajustado (fora do âmbito deste artigo) | Não é atualizado automaticamente; prazo de descontinuação da formação e da implementação separado. Reajuste ou destile no modelo base de substituição. | Garantir a quota do modelo-alvo |
Após a mudança do tráfego, configure a avaliação contínua para avaliar uma percentagem por amostragem do tráfego de produção no painel do Foundry Observability, ligada aos rastreios para análise de causa raiz, além de alertas do Azure Monitor quando a qualidade baixar.
Onde normalmente avaria
Regressões de qualidade que a avaliação offline não detetou só se manifestam sob carga de produção. As decisões de reversão são frequentemente impostas por um prazo-limite de descontinuação, em vez de por factos, o que indica que a migração começou demasiado tarde.
O que trouxeste
O encaminhamento ponderado entre duas implementações é implementado no seu próprio gateway ou camada de aplicação, e o corredor de rollback é uma escolha deliberada para manter a antiga implementação quente durante uma janela (as equipas embutidas normalmente querem cerca de 30 dias). Vale a pena conceber ambos uma vez e reutilizá-los em cada migração.
Fase 6: Desativação
O objetivo da fase de Desativação é desativar a implementação antiga, libertar capacidade, arquivar artefactos de avaliação e comunicar a alteração às equipas responsáveis pela documentação destinada ao cliente, páginas de marketing, procedimentos operacionais de suporte e registos de auditoria, nos casos em que a retenção é obrigatória. No fim, a implementação antiga deixa de existir, o número de implementações segue uma tendência descendente e as lições aprendidas são levadas para o ciclo seguinte.
O que considerar
- Encare a desativação como governação, não apenas como simples limpeza. Para cargas de trabalho reguladas, as obrigações de retenção podem exigir a manutenção de artefactos durante anos.
- Confirme que a origem já não existe. Verifica se a versão antiga está desativada e depois apaga a implementação para que deixe de consumir capacidade.
- Aplique as aprendizagens no futuro. Reincorpore os novos rastos de produção no seu conjunto de dados de referência para que a próxima migração arranque com menos custos.
Onde normalmente avaria
As equipas saltam a reforma, o que leva a uma acumulação de implantações de zombies. As equipas que não descontinuam ativamente as implementações têm muito mais implementações em produção do que os seus pares, e a maior parte desse total são resíduos estruturais de migrações anteriores. Um sub-passo comum que falha é a comunicação: o marketing e a documentação do produto continuam a referir-se ao modelo antigo após a troca.
O que trouxeste
O painel de observabilidade mostra que o número de implementações está a diminuir, mas decidir quais as implementações que ainda estão a suportar carga é algo que cabe à sua equipa avaliar. Faça da aposentação uma tarefa explicitamente acompanhada, e não apenas uma esperança.
A migração raramente é binária
As migrações reais são frequentemente feitas em estado dividido: parte de uma carga de trabalho é executada no novo modelo, enquanto uma via sensível à latência ou de maior risco permanece no modelo antigo, por vezes durante semanas. Planeie uma implementação parcial e uma reversão parcial, em vez de uma única transição do modelo antigo para o novo. A retirada costuma ocorrer semanas ou meses após a implementação, e são essas implementações antigas que persistem que surgem como proliferação.
Conteúdo relacionado
- Compreenda os prazos de depreciação e suporte na política de ciclo de vida e suporte dos Modelos Foundry
- Verifique as datas de reforma e as substituições no calendário modelo de reforma
- Veja o que já foi retirado em Modelos Reformados da Microsoft Foundry
- Compare os modelos candidatos com referências de desempenho e classificações de modelos
- Adapte instruções a um novo modelo com Otimize instruções com o Otimizador de Instruções
- Valide a qualidade antes de mudar, realizando avaliações no portal da Foundry
- Monitorize a carga de trabalho migrada com a Observabilidade na IA generativa