Nota
O acesso a esta página requer autorização. Pode tentar iniciar sessão ou alterar os diretórios.
O acesso a esta página requer autorização. Pode tentar alterar os diretórios.
O Azure Batch executa trabalhos em lote de computação paralela e de alto desempenho (HPC) em grande escala no Azure. Batch cria e gere pools de nós de computação, instala as aplicações que pretende executar e agenda trabalhos para serem executados nos nós.
Quando você usa o Azure, a confiabilidade é uma responsabilidade compartilhada. A Microsoft fornece uma variedade de recursos para oferecer suporte à resiliência e à recuperação. Você é responsável por entender como esses recursos funcionam em todos os serviços que você usa e selecionar os recursos necessários para atender aos seus objetivos de negócios e metas de tempo de atividade.
Este artigo descreve como tornar o Azure Batch resiliente a falhas transitórias, falhas de nós de computação, falhas em zonas de disponibilidade, falhas em toda a região e manutenção do serviço. Descreve também recomendações de implementação em produção, a arquitetura de fiabilidade do Batch, backup e restauro, e informações essenciais sobre o acordo de nível de serviço (SLA) do Azure Batch.
Recomendações de implantação de produção
Para cargas de trabalho em produção, siga as melhores práticas para o Azure Batch, incluindo estas recomendações de fiabilidade:
Projetar tarefas para tolerar interrupções e reexecuções. Tornar as tarefas idempotentes, fazer checkpoint do trabalho de longa duração e persistir os dados de saída e diagnóstico necessários em armazenamento durável. Para mais informações, consulte Resiliência a falhas transitórias e Resiliência a falhas de nós de computação.
Utilize múltiplos nós de computação quando a sua carga de trabalho tiver de continuar após uma falha de nó. Os nós de computação individuais não têm garantia de estar disponíveis. Disponibilize nós suficientes para que os restantes nós utilizáveis possam executar tarefas reagendadas.
Utilize a colocação em zona de disponibilidade quando tal for suportado. Configure a colocação da zona de disponibilidade quando a região, o SKU da máquina virtual (VM) e a configuração da carga de trabalho o permitirem. Os nós em zonas saudáveis podem continuar a executar tarefas durante uma interrupção da zona, mas planeie uma capacidade reduzida porque a capacidade de substituição depende da quota e da disponibilidade de VM nas zonas saudáveis. Para mais informações, veja Resiliência a falhas em zonas de disponibilidade.
Configure tarefas para direcionar pools dinamicamente em vez de um ID de pool fixo. Este design permite-lhe redirecionar um trabalho para um pool saudável se o pool original ficar indisponível ou não escalar para a capacidade desejada. Melhora a continuidade do negócio durante a manutenção ou falha do pool.
Mantenha as configurações dos agrupamentos atualizadas. Monitorize as datas de fim de vida (EOL) para imagens e SKUs de VM do Batch e migre os conjuntos antes do EOL. Siga as orientações de manutenção do serviço para manter o agente do nó Batch atualizado.
Visão geral da arquitetura de confiabilidade
Esta secção descreve alguns dos aspetos importantes do funcionamento do serviço que são mais relevantes do ponto de vista da fiabilidade. A secção apresenta a arquitetura lógica, que inclui alguns dos recursos e funcionalidades que implementa e utiliza. Também discute a arquitetura física, detalhando como o serviço funciona nos bastidores.
Arquitetura lógica
O Azure Batch utiliza vários tipos de recursos para executar cargas de trabalho batch. A configuração destes recursos determina como a sua carga de trabalho responde a falhas.
Todo o processamento em lote e os recursos estão associados a uma conta do Batch account. Uma solução em lote utiliza os seguintes componentes lógicos:
Conta em lote: Um recurso regional com o qual estão associados pools, jobs, tarefas e outros recursos em lote. Crias a conta e selecionas a sua região, modo de alocação de pool e definições de autenticação.
Pool: Um conjunto de nós de computação onde as tarefas são executadas. A configuração de um pool define a sua imagem e tamanho da VM, número de nós alvo, comportamento de escalabilidade, rede e atribuição em zonas. Configura cada pool para fornecer a capacidade, posicionamento e ambiente operacional que a sua carga de trabalho exige. A contagem de nós alvo corresponde à capacidade solicitada, mas o número de nós alocados pode ser menor devido a limites de quota, restrições de capacidade ou falhas de alocação.
Jobs e tarefas: Um job gere um conjunto de tarefas e está associado a um grupo. Uma tarefa executa uma aplicação ou script num nó de computação. Define jobs, tarefas, restrições, dependências, comportamento de retentativas e o agrupamento em que cada job é executado.
Conta de armazenamento associada: Uma conta do Armazenamento do Azure que pode associar opcionalmente a uma conta Batch. A maioria das soluções Batch utiliza uma conta de armazenamento associada para ficheiros de aplicação, ficheiros de recursos de tarefas, dados de entrada e dados de saída.
Depois de associar uma conta de armazenamento a uma conta Batch, o Batch refere-se a ela como autostorage account. Uma conta autostorage é necessária para pacotes de aplicações e também pode armazenar ficheiros de recursos de tarefas.
A fiabilidade de uma solução Batch depende dos seus recursos de armazenamento. És responsável por selecionar uma configuração de redundância de armazenamento que cumpra os teus requisitos de recuperação quando crias a conta de armazenamento. Transferir a saída da tarefa e outros dados duráveis dos nós de computação para o armazenamento. Para informações sobre as opções de fiabilidade do Armazenamento do Azure, veja Fiabilidade no Armazenamento de Blobs do Azure.
Para mais informações, consulte fluxo de trabalho e recursos do serviço Batch e contas Batch e contas do Armazenamento do Azure.
Arquitetura física
O Azure Batch tem um plano de controlo regional que processa operações de gestão em contas do Batch e outros recursos do Batch, como pools, jobs e tarefas. É separado dos nós de computação que executam tarefas.
Os pools Azure Batch utilizam Máquinas Virtuais do Azure e Conjuntos de Dimensionamento de Máquinas Virtuais. Um nó de computação é uma VM que processa parte de uma carga de trabalho Batch. Cada nó pertence a um pool e executa tarefas que o serviço Batch lhe atribui. O agente de nó Batch executa-se em cada nó e fornece a interface de comando e controlo entre o nó e o serviço Batch. Os nós de computação e o seu armazenamento local são efémeros. Quando um nó sai de um pool, perdem-se as alterações feitas no seu sistema operativo e nos ficheiros.
O modo de alocação de pools da conta Batch determina onde o Batch cria os recursos de computação e VM relacionados:
- Modo de alocação do conjunto do serviço Batch: O Batch aloca os recursos nas subscrições Azure geridas pelo serviço Batch.
- Modo de alocação do conjunto na subscrição do utilizador: O Batch cria os recursos diretamente na subscrição que contém a conta Batch.
As responsabilidades pela arquitetura física são divididas da seguinte forma:
Microsoft: A Microsoft opera o plano de controlo regional do Batch e a infraestrutura de serviços. O Batch aprovisiona os nós de computação de acordo com a configuração do pool e a capacidade disponível, agenda tarefas, monitoriza a saúde dos nós e tenta recuperar os nós após falhas na infraestrutura. O Batch pode recolocar na fila tarefas interrompidas para execução noutro nó disponível.
Tu: Selecionas a imagem e o tamanho da VM, tipos de nós, número de nós alvo, configuração de escalonamento, configuração de rede e colocação da zona de disponibilidade.
Também é responsável por manter capacidade suficiente para tolerar falhas de nós, monitorizar os estados dos nós e das tarefas, manter o sistema operativo convidado e o agente de nós atualizados, conceber tarefas para tolerar reexecuções e transferir os dados duráveis para fora dos nós de computação.
A recuperação de nós em lote não garante que uma carga de trabalho continue sem interrupções. Para mais informações, consulte Resiliência a falhas de nós de computação.
Resiliência a falhas transitórias
Falhas transitórias são falhas curtas e intermitentes em componentes. Eles ocorrem com frequência em um ambiente distribuído, como a nuvem, e são uma parte normal das operações. As falhas transitórias corrigem-se após um curto período de tempo. É importante que seus aplicativos possam lidar com falhas transitórias, geralmente tentando novamente as solicitações afetadas.
Todos os aplicativos hospedados na nuvem devem seguir as diretrizes de tratamento de falhas transitórias do Azure quando se comunicam com quaisquer APIs, bancos de dados e outros componentes hospedados na nuvem. Para obter mais informações, consulte Recomendações para o tratamento de falhas transitórias.
Numa solução Batch, falhas transitórias podem afetar tanto as aplicações e scripts que são executados como tarefas como quaisquer aplicações que chamem APIs Batch para gerir recursos Batch. O batch fornece mecanismos de retentativa ao nível da tarefa. És responsável por configurar as restrições das tarefas, tornar as tarefas idempotentes (seguras para executar mais do que uma vez) e configurar o comportamento de retentativas para chamadas ao serviço Batch e outras dependências.
Retentativas de tarefas e limites de tempo
Configure maxTaskRetryCount para controlar quantas vezes o Batch repete uma tarefa após o seu processo terminar com um código de saída diferente de zero:
- O valor predefinido,
0, significa que o Batch não tenta novamente a tarefa após um código de saída diferente de zero. - Um número inteiro positivo define um número máximo de tentativas após a tentativa inicial.
- Um valor de
-1permite tentativas ilimitadas. Este valor não é recomendado porque uma falha persistente pode fazer com que a tarefa seja executada indefinidamente.
Desenhe cada tarefa para que seja idempotente para que as tentativas não causem corrupção de dados ou saídas duplicadas. Para tarefas de longa duração, use checkpointing para que uma retentativa possa continuar a partir do progresso guardado. Para mais informações, consulte Conceção para retentativas e reexecuções.
Defina a restrição maxWallClockTime numa tarefa ou job para terminar trabalho que não progride dentro de um período aceitável. Um limite temporal também limita o efeito das falhas repetidas. Selecione as contagens de repetições e os limites de tempo que estejam alinhados com os objetivos de recuperação da carga de trabalho.
Falhas transitórias em dependências de tarefas
Aplicações e scripts que são executados como tarefas em lote frequentemente chamam outros componentes, como Armazenamento do Azure, bases de dados ou APIs. O batch não gere os pedidos individuais que o código da tarefa envia a estas dependências. Implemente o tratamento de falhas transitórias no código da tarefa, ou utilize funcionalidades de retentativa fornecidas pelo SDK da dependência. Siga as orientações de cada dependência para identificar erros passíveis de repetição, selecione as definições apropriadas de backoff e timeout, e respeite as instruções para repetição, como o cabeçalho Retry-After. Repita apenas operações que sejam seguras para repetir.
Se uma falha de dependência fizer com que o processo da tarefa saia com um código de saída diferente de zero, o Batch pode repetir toda a tarefa de acordo com maxTaskRetryCount. No entanto, o Batch não tenta novamente uma solicitação de dependência individual dentro de uma tarefa em execução.
Tentativas repetidas de pedidos à API em lote
As suas aplicações a correr fora do serviço podem chamar APIs Batch para criar e gerir pools, jobs, tarefas, nós de computação e outros recursos Batch. Configure estes clientes com políticas de retentativa que durem pelo menos cinco minutos para lidar com falhas de serviço Batch ou de rede transitórias.
Use o suporte de retentativas integrado do SDK quando estiver disponível. Por exemplo, a biblioteca cliente Azure.Compute.Batch para .NET expõe o comportamento de retentativas através de Azure.Core opções de retentativa.
Se interagir diretamente com as APIs do serviço Batch a partir do seu código, espere vários segundos antes de tentar novamente, use recuo exponencial com randomização (jitter) para evitar pedidos de repetição sincronizados e respeite o cabeçalho Retry-After devolvido com respostas de limitação como 429 Too Many Requests e 503 Service Unavailable.
Um timeout do pedido não significa necessariamente que o Batch não processou o pedido. Após um timeout, tente novamente a operação quando for seguro fazê-lo, ou recupere o estado do recurso para determinar se a operação original teve sucesso. Para mais informações, consulte Gestão e deteção de erros no Azure Batch.
Resiliência a falhas de nós de computação
Um nó de computação pode tornar-se indisponível devido a uma falha na infraestrutura, problema do sistema operativo ou problema de configuração. O batch tenta recuperar nós afetados por falhas de infraestrutura, mas não consegue recuperar automaticamente nem todas as falhas relacionadas com a configuração. Por exemplo, se um pacote de aplicação ou contentor falhar na instalação, deve corrigir o problema subjacente e poderá ser necessário remover e substituir o nó afetado.
Se uma falha de nó interromper uma tarefa, o Batch pode tentar novamente a tarefa no mesmo nó, se possível, até um limite interno. Se a tarefa não puder continuar nesse nó, o Batch pode colocá-la novamente na fila para execução noutro nó disponível. Estas tentativas de recuperação orientadas por serviços são independentes de maxTaskRetryCount e podem ocorrer mesmo quando o seu valor é 0.
Processo de recuperação de nós gerido pela Microsoft
A Microsoft gere a recuperação de nós orientada por serviços e a recolocação de tarefas na fila. Se o serviço Batch deixar de receber batimentos cardíacos de um nó durante tempo suficiente para desencadear a recuperação, o Batch pode realizar as seguintes ações:
-
Isolar o nó: Batch trata o nó como pouco saudável, define o seu estado para
unusable, e deixa de agendar novas tarefas no mesmo. - Identificar tarefas afetadas: O lote identifica tarefas que estavam a correr no nó como candidatas a reescalonamento.
-
Recolocar tarefas elegíveis na fila: Se uma tarefa afetada continuar no estado
running, o Batch pode redefini-la paraactivepara que o agendador a possa atribuir a outro nó. O batch não reinicia nem reexecuta uma tarefa que já foi persistida nesse estadocompleted. - Recuperar o nó: O Batch tenta restaurar o nó para um estado saudável ou substituir a VM subjacente.
A recuperação não é instantânea. Uma tarefa pode permanecer nesse running estado enquanto o Batch deteta a falha do nó e tenta reagendar a tarefa. Se não houver outro nó de computação disponível, a tarefa pode permanecer nesse estado até que o Batch a possa reagendar. Para mais informações, veja Limitações conhecidas para tarefas em lote.
Se o nó original retomar sinais de estado saudáveis antes do início da substituição, o Batch pode devolvê-lo a um estado estável. Se a substituição já tiver começado, o Batch pode remover a VM original e provisionar uma substituição.
As suas responsabilidades
A recuperação orientada por serviços não garante a execução ininterrupta da tarefa nem capacidade suficiente restante. És responsável pelas seguintes ações:
Mantenha capacidade suficiente: Se a sua carga de trabalho tiver de continuar enquanto um nó estiver indisponível, providencie nós suficientes para que os restantes possam executar tarefas reagendadas. Sem outro nó utilizável, as tarefas interrompidas têm de esperar.
Monitorize a capacidade utilizável: Acompanhe o número agregado de nós e os estados para que possa detetar quando um pool já não tem nós utilizáveis suficientes para a sua carga de trabalho. Estados como
unusable,startTaskFailed,unknown, epreemptedindicam capacidade reduzida. Para obter mais informações, consulte Monitorar soluções em lote contando tarefas e nós por estado.Investigar nós problemáticos: Se as tarefas falharem repetidamente, forem recolocadas na fila ou permanecerem no
runningestado após o nó atribuído se tornar inutilizável ou sair do pool, use metadados da tarefa para determinar se os problemas estão associados a um nó específico.Antes de remover um nó problemático, carregue os registos do agente do nó Batch e preserve os registos de tarefas relevantes, porque remover o nó elimina os seus ficheiros locais. Os registos de agentes de nó podem ajudar o Suporte da Microsoft a diagnosticar problemas de serviço Batch ou de nós, enquanto registos de tarefas como stdout e stderr podem ajudar a identificar problemas de aplicação e configuração. Para mais informações, consulte ficheiros de registo do agente Node.
Proteger o progresso da tarefa e os dados: Projetar tarefas para tolerarem interrupções e reexecuções. Mova checkpoints, output e outros dados duráveis para fora dos nós de computação porque o armazenamento local deles é efémero.
Para mais informações, consulte erros de pools e nós do Azure Batch e Gestão e deteção de erros no Azure Batch.
Resiliência a falhas na zona de disponibilidade
As zonas de disponibilidade são grupos fisicamente separados de centros de dados dentro de uma região Azure. Quando uma zona falha, os serviços podem ser transferidos para uma das zonas restantes.
O Batch suporta as zonas de disponibilidade de duas formas principais:
Plano de controlo: O plano de controlo do Batch é resiliente entre zonas em muitas regiões. Nessas regiões, as operações de gestão em contas do Batch e outros recursos do Batch podem continuar durante uma falha de zona. A Microsoft não publica quais as regiões que fornecem esta resiliência no plano de controlo.
Pools: Pode configurar um pool Batch para usar o posicionamento em zona de disponibilidade. Se uma zona ficar indisponível, os nós de computação em zonas saudáveis permanecem disponíveis para agendamento de tarefas.
Para a colocação dos nós de computação, este modelo de suporte é semelhante à redundância de zonas noutros serviços Azure porque um único pool pode conter nós de computação em múltiplas zonas de disponibilidade. No entanto, o Batch distribui os nós entre zonas na medida do possível. Tenta usar todas as zonas da região, mas não garante a colocação em todas as zonas ou uma distribuição uniforme. Não podes selecionar zonas específicas nem controlar o número de nós colocados em cada zona.
O diagrama seguinte mostra um exemplo de conta Batch. A conta tem um único pool com os seus nós distribuídos por três zonas de disponibilidade:
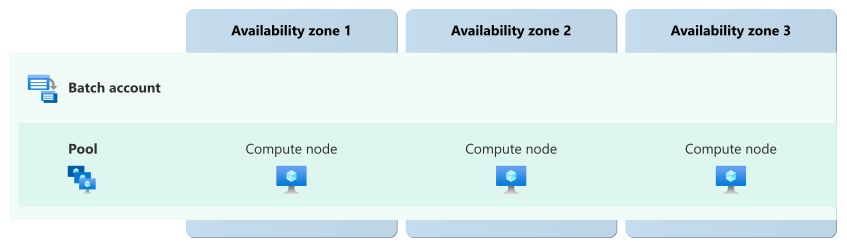
O diagrama mostra uma conta Batch que contém um pool. O pool tem três nós de computação, com um nó mostrado em cada uma das zonas de disponibilidade 1, 2 e 3. A colocação da zona de disponibilidade aplica-se aos nós de computação e não determina a resiliência da zona do plano de controlo Batch. A distribuição é um exemplo porque o Batch usa o equilíbrio de melhor esforço e não garante um nó em cada zona.
És responsável por tornar outros recursos dependentes, como contas de armazenamento, resistentes a zonas. Consulte os guias de fiabilidade de cada serviço. Para mais informações, consulte Guias de Fiabilidade para serviços Azure.
Requirements
Suporte por região: Crie o pool numa região do Azure que suporte zonas de disponibilidade.
Disponibilidade do SKU VM: O SKU VM selecionado deve estar disponível em mais do que uma zona da região. Utilize a API Resource SKUs List para verificar o
locationInfocampo do SKU VM.Acesso por subscrição: Para um modo de alocação de conjunto de subscrição de utilizadores, a subscrição não deve ter uma restrição de oferta de zona para o SKU de VM selecionado. Consulte
ResourceSkuRestrictionsna resposta da API da Lista de Resource SKUs. Se existir uma restrição, submeta um pedido de suporte para solicitar a sua remoção.Comunicação entre nós: Um pool não pode usar uma política de colocação de zona de disponibilidade quando a comunicação entre nós está ativada com uma SKU VM habilitada por InfiniBand.
Distribuição de instâncias entre zonas
Quando ativa a colocação de zonas de disponibilidade, o Batch tenta alocar nós de computação em todas as zonas de disponibilidade da região selecionada. Esta alocação é realizada num regime de melhor esforço. O batch controla a distribuição, e o número de nós em cada zona pode não ser igual.
Custo
Batch não acrescenta custo por permitir a colocação da zona de disponibilidade. É cobrado pelos recursos de computação, armazenamento, redes e outros recursos do Azure usados pela carga de trabalho. Se fornecer nós extra para tolerar a perda de uma zona, esses nós implicam os custos normais. Para mais informações, consulte Azure Batch pricing.
Configurar o suporte à zona de disponibilidade
Crie um novo pool com colocação de zonas de disponibilidade: Para criar um pool com colocação de zonas de disponibilidade ativado, veja Criar um pool de lote entre zonas de disponibilidade.
Alterar a colocação da zona de disponibilidade num pool existente: Deve selecionar a colocação da zona de disponibilidade ao criar o pool. Não podes alterar um pool existente para usar zonas de disponibilidade.
Pode criar um pool de substituição e atualizar cada uma das suas tarefas para o usar usando os seguintes passos:
Desativar o trabalho: Use a operação Desativar Trabalho e selecione como o Batch gere as tarefas que estão a correr quando submete o pedido:
-
Espera: O batch para de iniciar novas tarefas e permite que as tarefas em execução terminem no pool existente. O trabalho permanece no
disablingestado até que as tarefas em execução terminem. - Recolocar na fila: O batch interrompe tarefas em execução e devolve-as à fila. As tarefas podem correr novamente depois de ativares o job.
- Terminar: Batch interrompe tarefas em execução e marca-as como concluídas com informações de falha que indicam que foram terminadas. As tarefas não voltam a correr depois de ativares o trabalho.
Tarefas que já estão nesse
activeestado, o que significa que estão em fila mas não a correr, permanecem em fila independentemente da opção.Espera até o trabalho chegar ao
disabledestado antes de continuar. Nesse momento, nenhuma tarefa está a correr e o Batch não agenda novas tarefas.-
Espera: O batch para de iniciar novas tarefas e permite que as tarefas em execução terminem no pool existente. O trabalho permanece no
Editar o pool do trabalho: Use a operação Atualizar Trabalho para definir o pool do trabalho
poolInfo.poolIdpara o pool de substituição. O lote só permite que esta propriedade mude enquanto a tarefa estiver no estadodisabled. Certifique-se de que o pool de substituição existe e tem capacidade utilizável antes de ativar o trabalho. Se o pool não existir, o Batch aceita a atualização, mas não pode agendar tarefas até que cries o pool.Ativar a tarefa: Utilizar a operação Ativar Tarefa. A tarefa transita do estado
enablingpara o estadoactive. O batch então agenda tarefas em fila, incluindo tarefas devolvidas à fila pela opção Requeue, no pool de substituição. As tarefas que terminaram enquanto o Batch aplicava a opção Esperar e as tarefas concluídas pela opção Terminar não voltam a ser executadas.
Planejamento e gerenciamento de capacidade
O processo normal de recuperação de nós do Batch tenta substituir os nós que se tornam inutilizáveis durante uma falha de zona e restaurar o pool ao número configurado de nós alvo. Não aumenta esse alvo. Para manter capacidade suficiente para que a carga de trabalho continue quando uma zona não está disponível, considere sobredimensionar a capacidade do pool usando autoscale ou manualmente:
Se usar autoscale: Consulte a
$UsableNodeCountvariável definida pelo serviço na fórmula autoscale do pool para detetar quando a capacidade utilizável fica abaixo do limite de base que a sua carga de trabalho exige.$UsableNodeCounté uma variável autoscale por lote para o pool cuja fórmula está a ser avaliada, não uma métrica do Azure Monitor. O Azure Monitor publica métricas de contagem de nós do Batch ao nível da conta do Batch, e essas métricas não têm uma dimensãopoolId.Se gerir a capacidade manualmente: Use a operação List Pool Node Counts para recuperar contagens de nós dedicados e Spot em cada estado para cada pool. A operação não devolve um único total de nós utilizáveis. Avaliar estados de capacidade de tarefa, como
idleerunningcontra estados indisponíveis ou problemáticos, comounusable,unknown,offline, estartTaskFailed. As contagens devolvidas podem não estar atualizadas, por isso enumere os nós de computação do pool quando precisar de uma contagem exata.
O batch distribui os nós entre zonas com base no melhor esforço, pelo que a distribuição real pode não ser igual. Não presuma que os nós estão distribuídos de forma igual entre as zonas quando planeia a capacidade. Valide que a sua carga de trabalho consegue atingir os seus objetivos de recuperação com capacidade reduzida do pool.
Comportamento quando todas as zonas estão íntegras
Esta secção descreve o que esperar quando um pool Batch utiliza a colocação de zonas de disponibilidade e todas as zonas estão operacionais.
Operação entre zonas: O Batch agenda tarefas nos nós de computação disponíveis em todo o pool, independentemente da zona que contém cada nó.
Replicação de dados entre zonas: Os nós de computação por lote são efémeros e o Batch não replica ficheiros de tarefas entre zonas. És responsável por mover entradas, saídas, pontos de controlo e dados de diagnóstico que têm de sobreviver à perda de nós para armazenamento durável. Configure a redundância da conta de armazenamento para satisfazer os seus requisitos de disponibilidade.
Comportamento durante uma falha de zona
Esta secção descreve o que esperar quando um pool Batch utiliza a colocação da zona de disponibilidade e uma zona de disponibilidade está indisponível.
Deteção e resposta: A Microsoft monitoriza o serviço Batch e a saúde do nó de computação. Durante uma falha de zona, o Batch deteta perda contínua de batimentos cardíacos nos nós afetados e inicia o seu processo normal de recuperação de nós. Os nós em zonas saudáveis continuam disponíveis, e o Batch pode continuar a agendar tarefas neles.
Batch tenta restaurar o pool para o número de nós alvo configurado através do seu processo normal de recuperação, mas não aumenta esse alvo. És responsável por pedir capacidade adicional se o destino não fornecer capacidade suficiente para a carga de trabalho.
- Notificação: A Microsoft não o notifica automaticamente quando uma zona está inativa. No entanto, você pode usar a Integridade do Serviço do Azure para entender a integridade geral do serviço, incluindo quaisquer falhas de zona, e pode configurar alertas de Integridade do Serviço para notificá-lo sobre problemas.
Tarefas ativas: As tarefas a correr nos nós afetados são interrompidas. O batch pode reagendar tarefas nos nós disponíveis como parte do seu comportamento interno de recuperação. Projetar tarefas para tolerar retentativas e reexecuções, conforme descrito em Resiliência a falhas transitórias e Resiliência a falhas de nós de computação.
Perda de dados esperada: Os ficheiros nos nós de computação afetados ficam indisponíveis durante a interrupção e são perdidos se os nós forem reimaginados ou removidos do pool. O batch não replica estes ficheiros entre zonas. Os dados persistidos para armazenamento durável permanecem disponíveis de acordo com a configuração de redundância desse recurso de armazenamento.
Tempo de inatividade esperado: As tarefas em nós saudáveis continuam. As tarefas interrompidas ficam indisponíveis até que o Batch possa reprogramá-las para nós utilizáveis. Se não houver nó utilizável disponível, uma tarefa pode permanecer no estado
runningaté que o Batch possa reagendá-la. O tempo de recuperação depende da capacidade disponível do pool e da carga de trabalho em fila.As operações de gestão contra contas Batch e outros recursos Batch continuam se a conta estiver numa região onde o plano de controlo é resiliente em zonas. Noutras regiões, as operações de gestão podem não estar disponíveis até que a zona afetada recupere.
Redistribuição: Após perda prolongada de batimentos cardíacos, o Batch marca os nós afetados como
unusablee submete-os para substituição através do seu processo normal de recuperação de nódulos. O Batch tenta restaurar o pool até ao número de nós alvo configurado, mas a capacidade de substituição depende da quota e da disponibilidade da VM nas zonas saudáveis.Durante este processo, as tarefas permanecem associadas ao pool. O Batch continua a agendar tarefas a partir de jobs ativos em nós utilizáveis em zonas saudáveis. Se os nós de substituição forem atribuídos e se tornarem utilizáveis, o Batch também pode agendar tarefas nesses nós.
Este processo de recuperação não aumenta o número configurado de nós de destino. Se a sua carga de trabalho exigir capacidade para além desse objetivo, aumente-a manualmente ou configure a fórmula de autoescala do pool para o fazer.
Recuperação de zona
Batch gere o processo de recuperação quando uma zona recupera após uma falha. O batch segue o mesmo processo definido em Resiliência a falhas de nós de computação.
O batch não garante que os nós sejam reequilibrados de forma uniforme entre as zonas de disponibilidade após a recuperação. A colocação em zona mantém-se na medida do possível.
Teste de falhas de zona
Não se pode simular uma falha real numa zona de disponibilidade do Azure para testes. Em vez disso, usar um pool não produtivo para interromper tarefas representativas e retirar nós de computação suficientes de serviço para aproximar a perda de capacidade esperada. Considere utilizar as seguintes operações de nó suportadas:
- Reinicie os nós selecionados.
- Desative o agendamento de tarefas em nós selecionados.
- Remova nós selecionados do pool.
Quando uma operação lhe permite escolher como lidar com tarefas em execução, selecione a opção Requeue para que o Batch possa agendar as tarefas interrompidas nos nós restantes.
Durante o teste, verifique se o Batch reagenda tarefas interrompidas e se a reexecução não produz resultados duplicados ou inconsistentes. Confirme que os pontos de controlo e a saída permanecem disponíveis a partir do armazenamento durável, a monitorização deteta perda de nós e capacidade reduzida, e a carga de trabalho pode terminar com a capacidade restante.
Estas operações validam interrupções e reescalonamentos de tarefas, idempotência, checkpointing e tratamento de saída persistente. No entanto, não reproduzem todos os efeitos de uma falha em toda a zona.
Resiliência a falhas em toda a região
Uma conta em lote e os seus pools estão limitados a uma única região do Azure. Se a região sofrer uma falha, os seus trabalhos do Batch e conjuntos podem ser afetados.
O batch não replica contas, configuração de pool, jobs, tarefas, pacotes de aplicações ou dados de tarefas para outra região, nem fornece failover integrado entre regiões. És responsável por implementar e operar uma solução Batch multirregional quando a tua carga de trabalho tiver de tolerar uma falha regional.
Soluções multirregionais personalizadas para resiliência
Para construir uma solução multirregião, implemente pelo menos uma conta Batch em cada região que o seu design de recuperação utilize. As contas em lote operam de forma independente entre regiões. És responsável por selecionar as regiões, implementar e operar os recursos em cada região, e coordenar a configuração, replicação, failover e failback.
Pode desenhar uma abordagem ativo-ativa que submeta trabalho em múltiplas regiões durante a operação normal, ou uma abordagem ativa-passiva que mantenha a implementação secundária pronta para failover. Os designs ativo-ativo podem reduzir o tempo de recuperação porque ambas as implementações processam trabalho durante operações normais, enquanto os designs ativo-passivo podem reduzir os custos de computação em regime estacionário.
A lista seguinte apresenta exemplos das suas responsabilidades ao desenhar a solução:
Implementação: Pré-criar as contas do Batch, pools ou definições de implementação de pool, contas de armazenamento, recursos de rede e outras dependências em cada região. Verifique se cada região selecionada suporta as funcionalidades de Batch, tamanhos de VM e serviços dependentes que a sua carga de trabalho exige. Mantenha cada conta Batch e os recursos de armazenamento usados pelas suas tarefas na mesma região sempre que possível para evitar latência desnecessária. Defina contas do Batch, pools e recursos de suporte usando a infraestrutura como código para que a configuração possa ser reproduzida de forma consistente entre regiões.
Quotas e capacidade: Verifique as quotas aplicáveis da conta do Batch, da subscrição e da família de VM em cada região de recuperação, e peça aumentos antes de uma interrupção quando necessário. Uma quota é um limite, não uma garantia de capacidade. A disponibilidade das VMs varia consoante a região, a família de VMs e o momento. Para mais informações, consulte a conta do Batch e quotas de núcleos.
Replicação de dados: Mantenha os pacotes de aplicação, imagens de contentores, dados de entrada e dados de referência disponíveis em cada região de recuperação. O Batch não replica estes itens para ti.
Replicação de armazenamento: Configure redundância de armazenamento e replicação de dados entre regiões com base no objetivo do seu ponto de recuperação. Verifique se os dados replicados estão acessíveis a partir de cada região de recuperação. Para opções de fiabilidade de armazenamento, veja Fiabilidade no Armazenamento de Blobs do Azure.
Segmentação por região: Se as suas aplicações trabalharem com a sua conta Batch, desenhe-as para que possam selecionar outra conta Batch e os seus recursos de armazenamento associados sem necessidade de uma implementação de código.
Failover: O batch não move automaticamente a sua carga de trabalho para outra região. És responsável por detetar uma falha, determinar como a falha afeta a tua carga de trabalho, parar submissões para a conta do Batch afetada, encaminhar novos trabalhos para uma conta do Batch numa região em bom estado e decidir se deves reenviar trabalhos interrompidos. Os resultados do trabalho ou das tarefas que não replicaste fora da região afetada podem estar indisponíveis ou perdidos. O seu tempo de recuperação depende do seu modelo de implementação, capacidade disponível, replicação de dados e automação.
Recuperação de região: Depois de a disponibilidade de serviço ser restaurada na região afetada, valide a conta Batch, os pools, as dependências de armazenamento e o estado do trabalho antes de direcionar o trabalho para essa região. Resolva tarefas duplicadas ou parcialmente concluídas antes de submeter novamente. Batch não coordena este processo nem reconcilia o estado entre contas regionais.
Testes: Testar regularmente todo o processo regional de recuperação num ambiente não produtivo. Simular que uma implementação regional se torna indisponível, enviar submissões diretamente para outra conta regional do Batch, validar o acesso a pacotes de aplicação e dados de entrada, executar trabalhos representativos, recolher resultados e praticar o regresso da implementação recuperada ao serviço. Meça os resultados em relação ao teu objetivo de tempo de recuperação e ao objetivo do ponto de recuperação.
Backup e restauração
O Azure Batch não é um armazenamento durável para dados de entrada e saída de carga de trabalho. A Microsoft mantém o serviço Batch, mas tu és responsável por preservar a configuração e os dados necessários para recriar a tua carga de trabalho:
Configuração do Batch: Defina contas do Batch, pools, jobs e recursos de suporte usando infraestrutura como código, como o Bicep, e definições de jobs com controlo de versões. Estes artefactos fornecem uma forma repetível de recriar configurações na mesma região ou noutra região. Teste regularmente se as definições conseguem implementar um conjunto de agentes e executar um trabalho representativo.
Metadados por lote: O lote mantém registos de tarefas e trabalhos até eliminares o trabalho ou tarefa associado, mas esses registos não são uma cópia de segurança. Se precisar de manter este histórico, preserve os registos necessários fora do Batch.
Dados sobre nós de computação: Os nós de computação são efémeros e os seus sistemas de ficheiros não constituem uma cópia de segurança nem um armazenamento durável. Os dados num nó são perdidos quando este é reimaginado ou sai de um pool. O Batch também pode eliminar ficheiros de tarefas após o seu período de retenção expirar. Persistir os registos de saída e de diagnóstico necessários em armazenamento durável antes de uma tarefa ser concluída. Para tarefas de longa duração, persista os pontos de controlo durante a execução. Para mais informações, consulte Persistir a saída de trabalhos e tarefas e Monitorizar Azure Batch.
Dados em contas de armazenamento automático: Uma conta de armazenamento automático associada pode armazenar pacotes de aplicação e ficheiros de recursos de tarefas. Para além de configurar redundância que cumpra os seus objetivos de recuperação, considere se precisa de proteger estes dados contra eliminação acidental ou corrupção. Para mais informações, consulte Backup e recuperação no Armazenamento de Blobs do Azure.
Testes de restauração e recuperação
Para recuperar, implemente Batch e a configuração dos recursos de apoio, restaure ou reconecte os dados de entrada necessários e os artefactos da aplicação, e submeta novamente o trabalho que não foi concluído. Teste periodicamente tanto a reconstrução de recursos como a restauração de dados num ambiente de recuperação isolado ou não em produção. Utilize definições controladas por versões e dados com cópia de segurança, execute um trabalho representativo, verifique a saída resultante e o acesso às dependências, e meça o tempo de recuperação alcançado e o ponto de recuperação em relação aos seus objetivos. Verifica se as tarefas são idempotentes para que reenviar trabalhos incertos não corrompa dados nem crie saídas duplicadas.
Resiliência à manutenção de serviços
A Microsoft realiza a manutenção da plataforma e coordena atualizações de infraestrutura para o Azure Batch e outros serviços. És responsável por configurar o comportamento de atualização do pool e desenhar tarefas para tolerarem interrupções.
Manutenção do host: O Azure utiliza técnicas de manutenção, como migração em tempo real, sempre que possível. Se a manutenção exigir que um nó de computação seja reiniciado ou movido, as tarefas em execução podem ser interrompidas e o Batch pode reagenda-las. Tornar as tarefas idempotentes, persistir pontos de controlo e a saída em armazenamento durável.
Sistema operativo convidado: És responsável por manter o sistema operativo convidado e o agente de nó Batch atualizados. O comportamento das atualizações do sistema operativo depende da imagem e da configuração da atualização. Com a configuração adequada, as atualizações automáticas de imagens do sistema operativo para pools em lote podem atualizar os nós do pool sem interromper tarefas em execução. As atualizações automáticas de imagens do sistema operativo não suportam todas as imagens do sistema operativo Batch.
Atualizações do agente de nó: As atualizações automáticas de imagem do sistema operativo não atualizam automaticamente o agente de nó Batch. Os agentes dos nós de batch não são automaticamente atualizados enquanto o conjunto tiver nós de computação. Para receber um agente de nó mais recente, redimensione o pool para zero nós e volte a aumentar o pool, ou substitua o pool. Antes de remover nós, preserve quaisquer registos de saída de tarefas e registos de diagnóstico necessários. Para mais informações, consulte as atualizações do agente de nó em lote.
Siga as recomendações de implementação em produção e as orientações sobre falhas de nós de cálculo para ajudar a sua carga de trabalho a continuar ou a recuperar quando a manutenção interromper tarefas ou tornar os nós de computação indisponíveis.
Contrato de nível de serviço
O contrato de nível de serviço (SLA) para serviços do Azure descreve a disponibilidade esperada de cada serviço e as condições que sua solução deve atender para atingir essa expectativa de disponibilidade. Para mais informações, consulte Acordos de Nível de Serviço (SLA) para serviços online.
O SLA de disponibilidade do Azure Batch aplica-se a operações que realiza na API do Batch. Para informações detalhadas sobre os tipos de operações incluídas, consulte a redação do SLA. O tamanho do seu pool, distribuição de zonas e serviços dependentes afetam a disponibilidade de ponta a ponta da carga de trabalho, mas não alteram os termos do SLA do Batch.