Nota
O acesso a esta página requer autorização. Pode tentar iniciar sessão ou alterar os diretórios.
O acesso a esta página requer autorização. Pode tentar alterar os diretórios.
Ao usar o Fabric SDK para avaliação, pode testar programaticamente quão bem o seu agente de dados responde a perguntas em linguagem natural. Ao usar uma interface Python simples, pode definir exemplos de referência, executar avaliações e analisar resultados, tudo no ambiente do seu notebook. Este processo ajuda-o a validar a precisão, a depurar erros e a melhorar com confiança o seu agente antes de o implementar em produção.
Importante
Este recurso está em pré-visualização.
Pré-requisitos
Uma capacidade paga F2 ou superior do Fabric , ou umacapacidade do Power BI Premium (P1 ou superior) comMicrosoft Fabric ativado .- Permita o processamento cruzado e o armazenamento entre geo para IA com base nos requisitos explicados nas definições do tenant do agente de dados Fabric.
- Pelo menos uma destas fontes de dados, com dados: um armazém, uma casa de lago, um modelo semântico Power BI, uma base de dados KQL, uma base de dados espelhada ou uma ontologia. Deve ter acesso de leitura à fonte de dados.
Instalar o SDK do agente de dados
Para começar a avaliar programaticamente o seu agente de dados Fabric, instale o Fabric data agent SDK Python. Este SDK fornece as ferramentas e os métodos necessários para interagir com seu agente de dados, executar avaliações e registrar resultados. Instale a versão mais recente executando o seguinte comando no seu bloco de notas:
%pip install -U fabric-data-agent-sdk
Esta etapa garante que tenha os recursos e correções mais atualizados up-todisponíveis no SDK.
Carregue seu conjunto de dados de verdade terrestre
Para avaliar o seu agente de dados Fabric, precisa de um conjunto de perguntas de exemplo juntamente com as respostas esperadas. Use estas perguntas para verificar a precisão com que o agente responde a perguntas do mundo real.
Defina estas perguntas diretamente no seu código usando um DataFrame do pandas:
import pandas as pd

# Define a sample evaluation set with user questions and their expected answers.
# You can modify the question/answer pairs to match your scenario.
df = pd.DataFrame(
    columns=["question", "expected_answer"],
    data=[
        ["Show total sales for Canadian Dollar for January 2013", "46,117.30"],
        ["What is the product with the highest total sales for Canadian Dollar in 2013", "Mountain-200 Black, 42"],
        ["Total sales outside of the US", "19,968,887.95"],
        ["Which product category had the highest total sales for Canadian Dollar in 2013", "Bikes (Total Sales: 938,654.76)"]
    ]
)
Alternativamente, se tiver um conjunto de dados de avaliação existente, carregue-o a partir de um ficheiro CSV com as colunas question e expected_answer:
# Load questions and expected answers from a CSV file
input_file_path = "/lakehouse/default/Files/Data/Input/curated_2.csv"
df = pd.read_csv(input_file_path)
Esse conjunto de dados serve como entrada para a execução de avaliações automatizadas em relação ao seu agente de dados para avaliar a precisão e a cobertura.
Avalie e analise o seu agente de dados
O passo seguinte é executar a avaliação usando a evaluate_data_agent função. Esta função compara as respostas do agente com os resultados esperados e armazena as métricas de avaliação.
Note
Esta etapa requer um agente de dados que já tenha sido publicado para a fase que está a avaliar (production ou sandbox). Se ainda não tens um, vê Criar um agente de dados Fabric.
from fabric.dataagent.evaluation import evaluate_data_agent

# Name of your data agent
data_agent_name = "AgentEvaluation"

# (Optional) Name of the workspace if the data agent is in a different workspace
workspace_name = None

# (Optional) Name of the output table to store evaluation results (default: "evaluation_output")
# Two tables will be created:
# - "<table_name>": contains summary results (e.g., accuracy)
# - "<table_name>_steps": contains detailed reasoning and step-by-step execution
table_name = "demo_evaluation_output"

# Specify the data agent stage: "production" (default) or "sandbox"
data_agent_stage = "production"

# Run the evaluation and get the evaluation ID
try:
    evaluation_id = evaluate_data_agent(
        df,
        data_agent_name,
        workspace_name=workspace_name,
        table_name=table_name,
        data_agent_stage=data_agent_stage
    )
    print(f"Unique ID for the current evaluation run: {evaluation_id}")
except Exception as e:
    print(f"Evaluation failed: {e}")
Quando a execução terminar, verá uma saída semelhante ao texto seguinte:
Unique ID for the current evaluation run: <evaluation-id>
Obter resumo da avaliação
Após realizar a avaliação, pode obter um resumo geral dos resultados utilizando a get_evaluation_summary função. Esta função fornece informações sobre o desempenho geral do seu agente de dados, incluindo métricas como quantas respostas corresponderam às respostas esperadas.
from fabric.dataagent.evaluation import get_evaluation_summary

# Retrieve a summary of the evaluation results
summary_df = get_evaluation_summary(table_name)

Por defeito, esta função procura uma tabela chamada evaluation_output. Se especificaste um nome de tabela personalizado durante a avaliação (como demo_evaluation_output), passa esse nome como table_name argumento.
O DataFrame retornado inclui métricas agregadas, como o número de respostas corretas, incorretas ou pouco claras. Este resultado ajuda-o a avaliar rapidamente a precisão do agente e a identificar áreas a melhorar.
Inspecionar resultados detalhados da avaliação
Para aprofundar a forma como o seu agente de dados respondeu a cada pergunta individual, utilize a get_evaluation_details função. Esta função retorna um detalhamento detalhado da execução da avaliação, incluindo as respostas reais do agente, se elas corresponderam à resposta esperada e um link para o thread de avaliação (visível apenas para o usuário que executou a avaliação).
from fabric.dataagent.evaluation import get_evaluation_details

# Table name used during evaluation
table_name = "demo_evaluation_output"

# Whether to return all evaluation rows (True) or only failures (False)
get_all_rows = False

# Whether to print a summary of the results
verbose = True

# Retrieve evaluation details for a specific run
eval_details = get_evaluation_details(
    evaluation_id,
    table_name,
    get_all_rows=get_all_rows,
    verbose=verbose
)

Personalize seu prompt para avaliação
Por defeito, o Fabric SDK utiliza um prompt incorporado para avaliar se a resposta real do agente de dados corresponde à resposta esperada. No entanto, pode fornecer o seu próprio prompt para avaliações mais nuançadas ou específicas do domínio usando o critic_prompt parâmetro.
O seu prompt personalizado deve incluir os marcadores {query}, {expected_answer} e {actual_answer}. O processo de avaliação substitui dinamicamente estes espaços reservados para cada pergunta.
from fabric.dataagent.evaluation import evaluate_data_agent

# Define a custom prompt for evaluating agent responses
critic_prompt = """
    Given the following query, expected answer, and actual answer, please determine if the actual answer is equivalent to expected answer. If they are equivalent, respond with 'yes'.

    Query: {query}

    Expected Answer:
    {expected_answer}

    Actual Answer:
    {actual_answer}

    Is the actual answer equivalent to the expected answer?
"""

# Name of the data agent
data_agent_name = "AgentEvaluation"

# Run evaluation using the custom critic prompt
evaluation_id = evaluate_data_agent(df, data_agent_name, critic_prompt=critic_prompt)
Este recurso é especialmente útil quando:
- Pretendes aplicar critérios mais flexíveis ou mais rigorosos para determinar o que é considerado uma correspondência.
- As tuas respostas esperadas e reais podem variar no formato, mas ainda assim ser semanticamente equivalentes.
- Você precisa capturar nuances específicas de um domínio na forma como as respostas devem ser avaliadas.
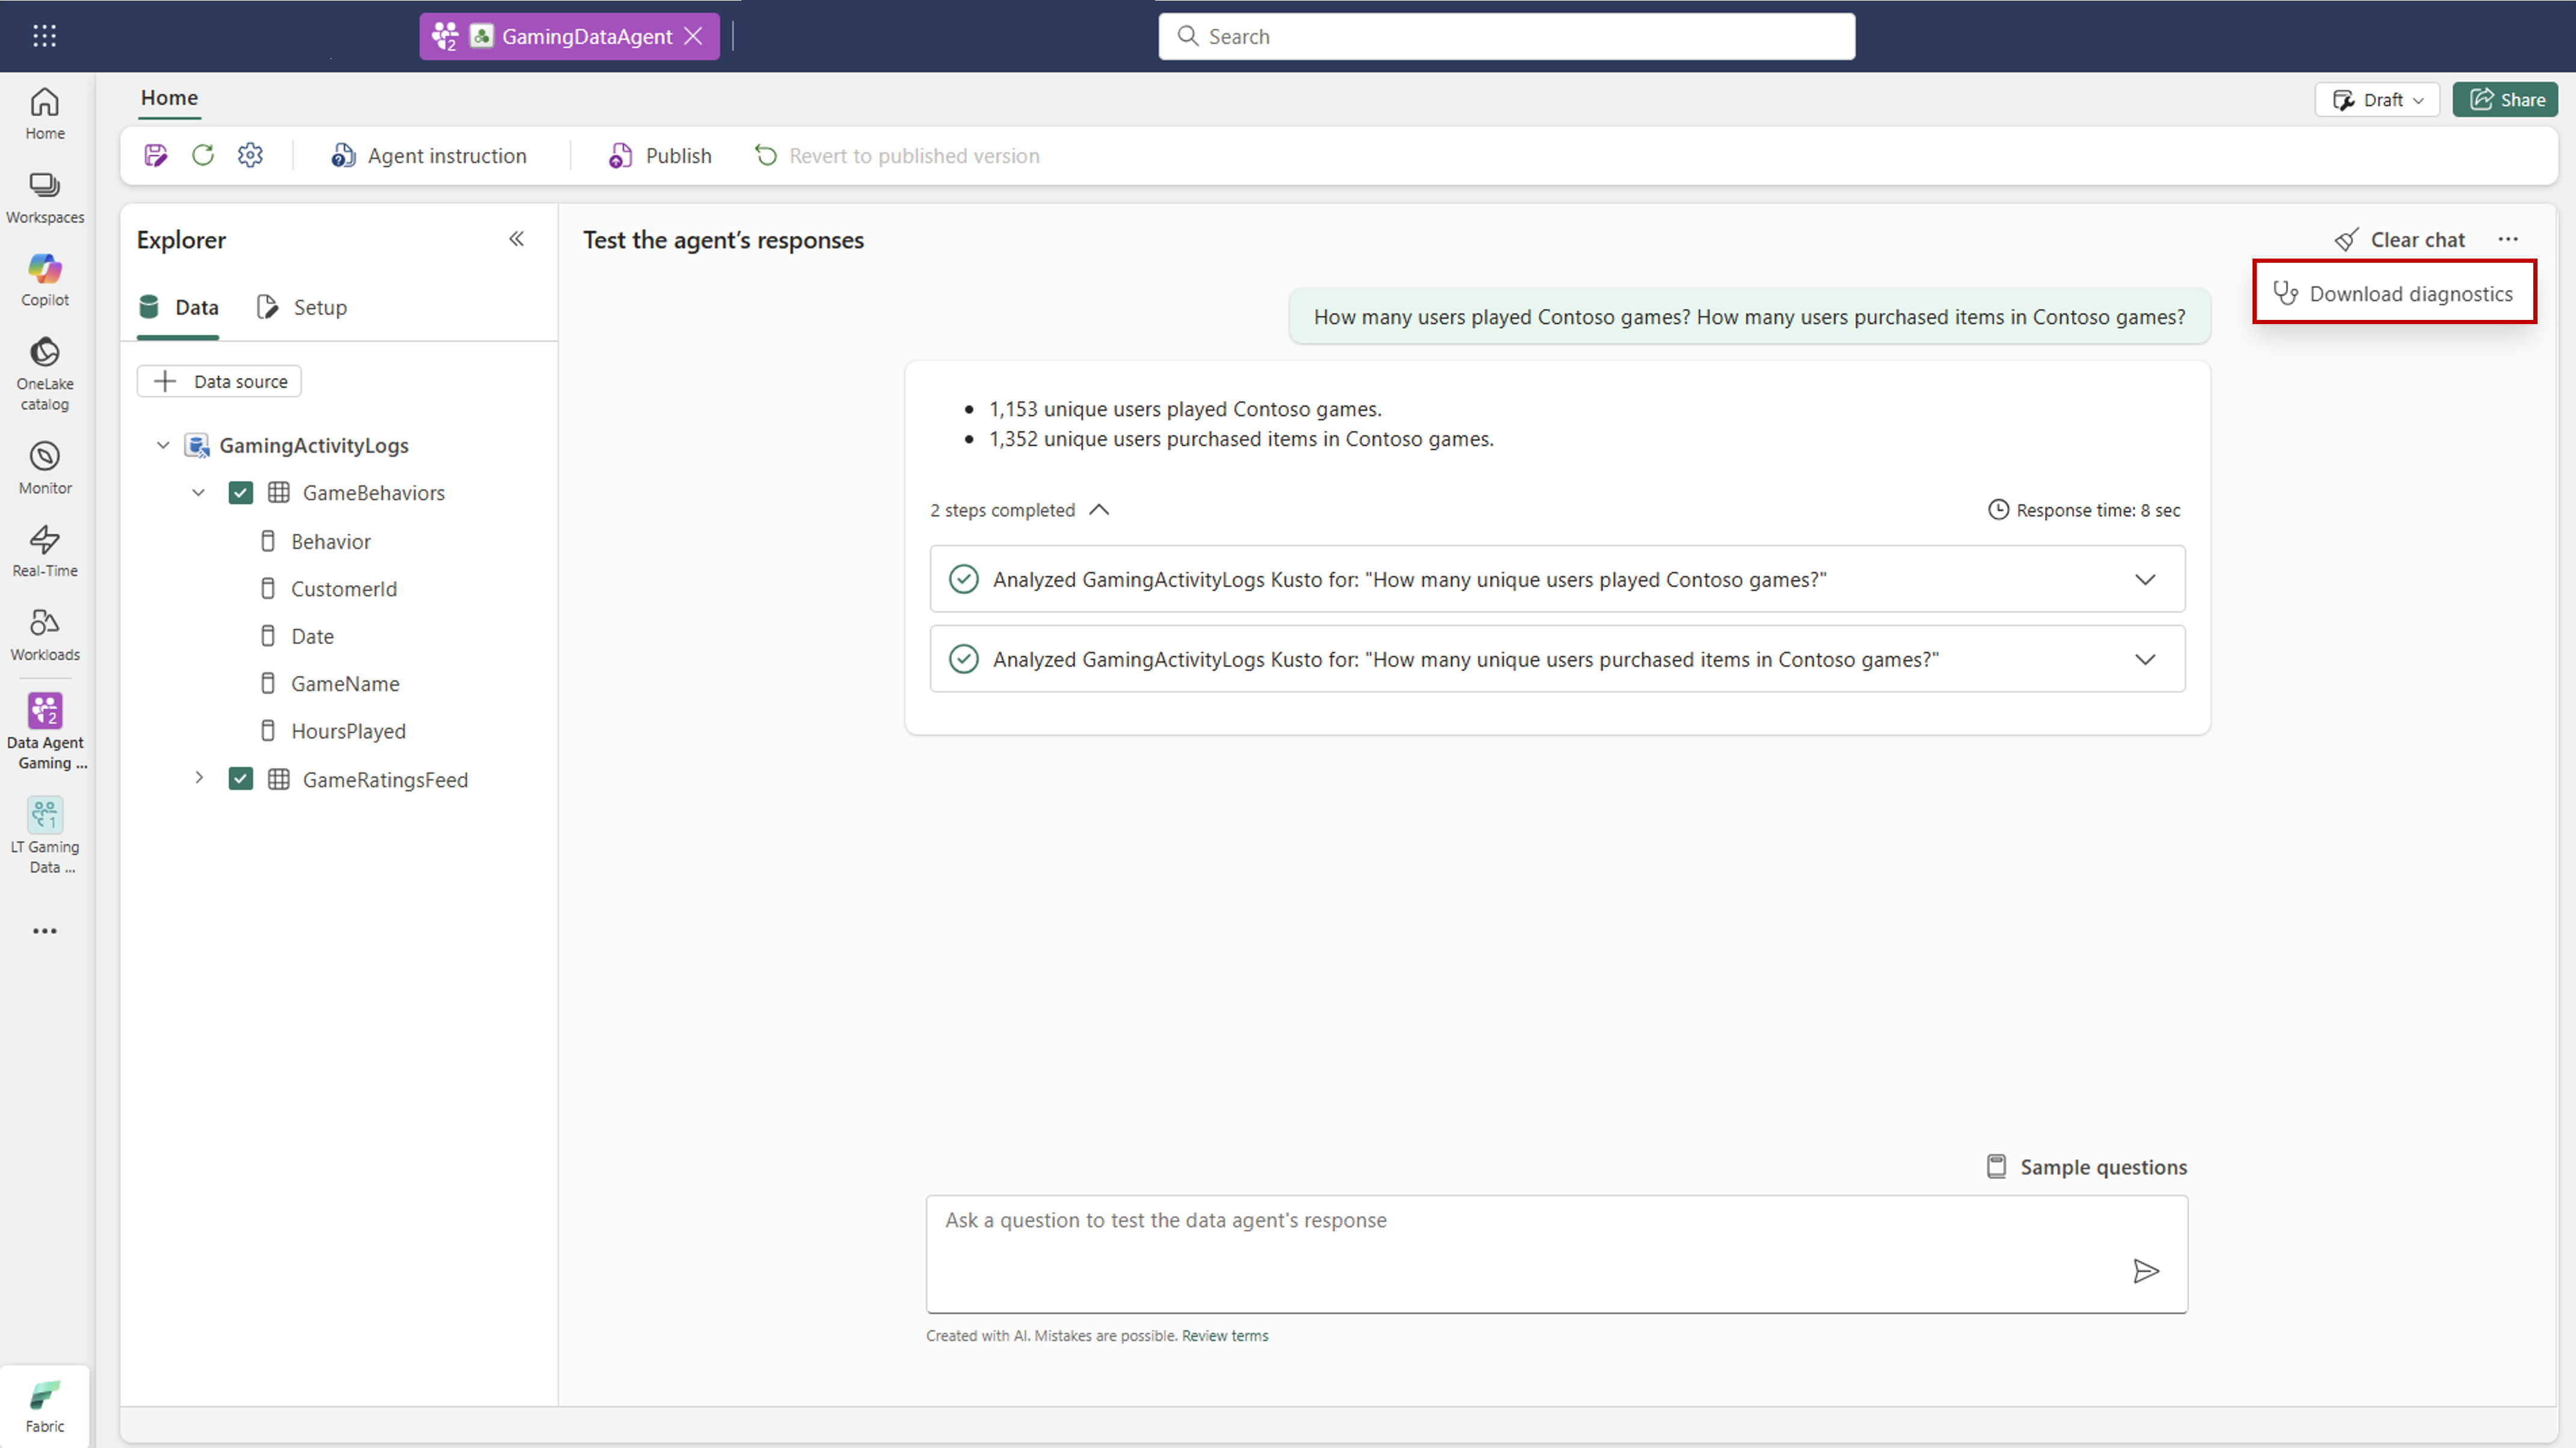
Botão de diagnóstico
O botão de Diagnóstico permite-lhe descarregar uma imagem completa dos passos de configuração e execução do seu agente de dados. Esta exportação inclui detalhes como definições da fonte de dados, instruções aplicadas, exemplos de consultas usadas e os passos subjacentes que o agente de dados seguiu para gerar a sua resposta.
Utilize esta funcionalidade quando trabalhar com o Suporte da Microsoft ou para resolver comportamentos inesperados. Ao rever o ficheiro descarregado, pode ver exatamente como o agente de dados processou o seu pedido, que configurações foram aplicadas e onde surgiram potenciais problemas. Este nível de transparência facilita a depuração e a otimização do desempenho do seu agente de dados.
Solução de problemas
| Issue | Motivo | Resolução |
|---|---|---|
| Agente de dados não encontrado | O data_agent_name ou workspace_name está incorreto, ou o agente não está publicado. |
Verifique o nome do agente e o espaço de trabalho, e certifique-se de que o agente está publicado no local especificado data_agent_stage. |
| Resultados vazios ou em falta | O nome da tabela não corresponde ao usado durante evaluate_data_agent. |
Passa o mesmo table_name para get_evaluation_summary e get_evaluation_details. |
message_url não é acessível |
As conversas de avaliação são visíveis apenas para o utilizador que realizou a avaliação. | Reexecute a avaliação sob a sua própria identidade para aceder aos links do tópico. |
| O prompt personalizado não produz qualquer efeito nem gera erros | O critic_prompt não contém os espaços reservados necessários. |
Inclua {query}, {expected_answer}, e {actual_answer} no seu enunciado. |
| Erro de permissão ou de capacidade | Falta de capacidade F2 ou superior, ou falta de acesso de leitura à fonte de dados. | Confirme os pré-requisitos, incluindo capacidade e acesso à leitura da fonte de dados. |