Nota
O acesso a esta página requer autorização. Pode tentar iniciar sessão ou alterar os diretórios.
O acesso a esta página requer autorização. Pode tentar alterar os diretórios.
Aplica-se a: SQL Server 2016 (13.x) e versões posteriores Base de Dados SQL do AzureAzure SQL Managed InstanceBase de dados SQL no Microsoft Fabric
Pode otimizar as suas consultas em documentos JSON usando índices padrão de árvore B. Os índices de banco de dados melhoram o desempenho das operações de filtragem e classificação. Sem índices, o Database Engine tem de realizar uma análise completa da tabela sempre que consultas dados.
Tip
Os índices funcionam da mesma forma em dados JSON no varchar/nvarchar ou no nativo json tipo de dados.
Note
O tipo de dados json e os índices JSON estão geralmente disponíveis no SQL Server 2025 (17.x), no Base de Dados SQL do Azure, no Azure SQL Managed Instance (com a política de atualização SQL Server 2025 ou Always-up-to-dateupdate policy) e na base de dados SQL no Microsoft Fabric.
Existem duas formas de indexar dados JSON, dependendo de como os armazena:
| Tipo de índice | Description |
|---|---|
| Índice JSON | Quando guardar JSON numa coluna json, crie um índice JSON na coluna. Um único índice JSON pode otimizar muitas consultas que utilizam funções como JSON_VALUE, JSON_PATH_EXISTS e JSON_CONTAINS para pesquisar valores no documento. Esta abordagem é recomendada para o tipo de dados json. |
| Índice da coluna calculada | Quando guardar JSON como texto varchar ou nvarchar, ou quando quiser indexar uma única propriedade JSON como uma coluna fortemente tipada, crie uma coluna computada com JSON_VALUE e construa um índice padrão nessa coluna. |
Indexar uma coluna JSON com um índice JSON
Aplica-se a: Base de Dados SQL do Azure, Azure SQL Managed Instance, SQL Server 2025 (17.x) e base de dados SQL no Microsoft Fabric
Podes criar um índice JSON diretamente numa coluna json . O índice JSON indexa os caminhos dentro do documento JSON, pelo que um único índice pode otimizar muitas pesquisas no documento sem uma coluna calculada separada para cada propriedade.
Note
Índices JSON não são suportados no SQL Server 2022 (16.x) e versões anteriores.
O exemplo seguinte cria uma tabela com uma coluna json e um índice JSON nessa coluna:
CREATE TABLE Orders
(
    OrderID INT IDENTITY PRIMARY KEY,
    OrderDetails JSON NOT NULL
);

CREATE JSON INDEX IX_OrderDetails
    ON Orders (OrderDetails);
Com o índice JSON implementado, o Database Engine pode usá-lo para otimizar consultas que utilizam JSON_VALUE, JSON_PATH_EXISTS, ou JSON_CONTAINS. Por exemplo, a seguinte consulta pode usar o índice JSON para filtrar encomendas pelo nome do cliente:
SELECT OrderID
FROM Orders
WHERE JSON_VALUE(OrderDetails, '$.Customer.Name') = N'Aaron Campbell';
Para a sintaxe completa, opções de índice e a lista completa de predicados suportados, veja CREATE JSON INDEX.
Indexar propriedades JSON usando colunas computadas
Utilize um índice de coluna calculado quando armazenar JSON como texto varchar ou nvarchar, ou quando quiser expor uma única propriedade JSON como uma coluna fortemente tipada para filtrar ou ordenar. Normalmente, queres filtrar ou ordenar os resultados das consultas por uma ou mais propriedades dos documentos JSON.
Example
Neste exemplo, suponha que a tabela AdventureWorks.SalesOrderHeader tenha uma coluna Info que contenha várias informações no formato JSON sobre ordens de venda. Por exemplo, ele contém dados não estruturados sobre clientes, vendedores, endereços de entrega e faturamento, e assim por diante. Você pode usar valores da coluna Info para filtrar ordens de venda de um cliente.
Por padrão, a coluna Info usada não existe, ela pode ser criada no AdventureWorks banco de dados com o código a seguir. Os exemplos a seguir não se aplicam à AdventureWorksLT série de bancos de dados de exemplo.
IF NOT EXISTS (SELECT *
               FROM sys.columns
               WHERE object_id = OBJECT_ID('[Sales].[SalesOrderHeader]')
                     AND name = 'Info')
    ALTER TABLE [Sales].[SalesOrderHeader]
        ADD [Info] NVARCHAR (MAX) NULL;
GO

UPDATE h
SET [Info] =
(
    SELECT concat(p.FirstName, N' ', p.LastName) AS [Customer.Name],
            p.BusinessEntityID AS [Customer.ID],
            p.[PersonType] AS [Customer.Type],
            soh.SalesOrderID AS [Order.ID],
            soh.SalesOrderNumber AS [Order.Number],
            soh.OrderDate AS [Order.CreationDate],
            soh.TotalDue AS [Order.TotalDue]
    FROM [Sales].SalesOrderHeader AS soh
        INNER JOIN [Sales].[Customer] AS c
            ON c.CustomerID = soh.CustomerID
        INNER JOIN [Person].[Person] AS p
            ON p.BusinessEntityID = c.CustomerID
    WHERE soh.SalesOrderID = h.SalesOrderID
    FOR JSON PATH, WITHOUT_ARRAY_WRAPPER
)
FROM [Sales].SalesOrderHeader AS h;
Consulta para otimizar
Aqui está um exemplo do tipo de consulta que você deseja otimizar usando um índice.
SELECT SalesOrderNumber,
       OrderDate,
       JSON_VALUE(Info, '$.Customer.Name') AS CustomerName
FROM Sales.SalesOrderHeader
WHERE JSON_VALUE(Info, '$.Customer.Name') = N'Aaron Campbell';
Exemplo de índice
Se quiser acelerar os filtros ou ORDER BY cláusulas sobre uma propriedade em um documento JSON, você pode usar os mesmos índices que já está usando em outras colunas. No entanto, não é possível diretamente propriedades de referência nos documentos JSON.
- Primeiro, crie uma "coluna virtual" que retorne os valores que você deseja usar para filtragem.
- Em seguida, crie um índice nessa coluna virtual.
O exemplo a seguir cria uma coluna computada que pode ser usada para indexação. Em seguida, ele cria um índice na nova coluna calculada. Este exemplo cria uma coluna que expõe o nome do cliente, que é armazenado no caminho $.Customer.Name nos dados JSON.
ALTER TABLE Sales.SalesOrderHeader
    ADD vCustomerName AS JSON_VALUE(Info, '$.Customer.Name');

CREATE INDEX idx_soh_json_CustomerName
    ON Sales.SalesOrderHeader(vCustomerName);
Esta instrução retorna o seguinte aviso:
Warning! The maximum key length for a nonclustered index is 1700 bytes.
The index 'vCustomerName' has maximum length of 8000 bytes.
For some combination of large values, the insert/update operation will fail.
A função JSON_VALUE pode retornar valores de texto de até 8000 bytes (por exemplo, como o nvarchar(4000) tipo). No entanto, os valores com mais de 1700 bytes não podem ser indexados. Se você tentar inserir o valor na coluna computada indexada que é maior que 1700 bytes, a operação de linguagem de manipulação de dados (DML) falhará.
Para obter um melhor desempenho, tente converter o valor exposto usando uma coluna computada no menor tipo de dados aplicável. Use int e tipos de datetime2 em vez de tipos de cadeia de caracteres.
Mais informações sobre a coluna computada
Uma coluna computada não é persistente. Uma coluna computada só é computada quando o índice precisa ser reconstruído. Não ocupa espaço adicional na mesa.
É importante que você crie a coluna computada com a mesma expressão que planeja usar em suas consultas - neste exemplo, a expressão é JSON_VALUE(Info, '$.Customer.Name').
Você não precisa reescrever suas consultas. Se você usar expressões com a função JSON_VALUE, conforme mostrado na consulta de exemplo anterior, o SQL Server verá que há uma coluna computada equivalente com a mesma expressão e aplicará um índice, se possível.
Plano de execução para este exemplo
Aqui está o plano de execução para a consulta neste exemplo.
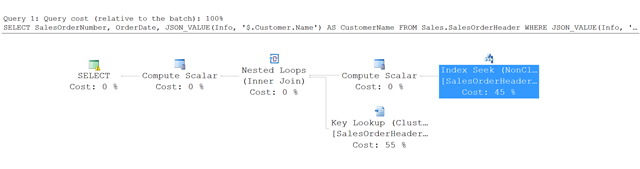
Em vez de uma verificação de tabela completa, o SQL Server usa uma busca de índice no índice não clusterizado e localiza as linhas que satisfazem as condições especificadas. Em seguida, ele usa uma pesquisa de chave na tabela SalesOrderHeader para buscar as outras colunas que são referenciadas na consulta - neste exemplo, SalesOrderNumber e OrderDate.
Otimize ainda mais o índice com colunas incluídas
Se você adicionar colunas necessárias no índice, poderá evitar essa pesquisa extra na tabela. Você pode adicionar essas colunas como colunas incluídas padrão, conforme mostrado no exemplo a seguir, que estende o exemplo anterior CREATE INDEX.
CREATE INDEX idx_soh_json_CustomerName
    ON Sales.SalesOrderHeader(vCustomerName)
    INCLUDE(SalesOrderNumber, OrderDate);
Nesse caso, o SQL Server não precisa ler mais dados da tabela porque tudo o SalesOrderHeader que ele precisa está incluído no índice JSON não clusterizado. Esse tipo de índice é uma boa maneira de combinar dados JSON e de coluna em consultas e criar índices ideais para sua carga de trabalho.
Os índices de colunas calculadas são sensíveis à ordenação
Uma característica importante dos índices de colunas calculadas sobre dados JSON é que têm em conta a intercalação. O resultado da função JSON_VALUE que você usa ao criar a coluna computada é um valor de texto que herda seu agrupamento da expressão de entrada. Portanto, os valores no índice são ordenados usando as regras de agrupamento definidas nas colunas de origem.
Para demonstrar que os índices reconhecem agrupamento, o exemplo a seguir cria uma tabela de coleta simples com uma chave primária e conteúdo JSON.
CREATE TABLE JsonCollection
(
    id INT IDENTITY CONSTRAINT PK_JSON_ID PRIMARY KEY,
    [json] NVARCHAR (MAX) COLLATE SERBIAN_CYRILLIC_100_CI_AI
        CONSTRAINT [Content should be formatted as JSON] CHECK (ISJSON(json) > 0)
);
O comando anterior especifica a ordenação cirílica sérvia para a coluna json. O exemplo a seguir preenche a tabela e cria um índice na propriedade "name".
INSERT INTO JsonCollection
VALUES (N'{"name":"Иво","surname":"Андрић"}'),
       (N'{"name":"Андрија","surname":"Герић"}'),
       (N'{"name":"Владе","surname":"Дивац"}'),
       (N'{"name":"Новак","surname":"Ђоковић"}'),
       (N'{"name":"Предраг","surname":"Стојаковић"}'),
       (N'{"name":"Михајло","surname":"Пупин"}'),
       (N'{"name":"Борислав","surname":"Станковић"}'),
       (N'{"name":"Владимир","surname":"Грбић"}'),
       (N'{"name":"Жарко","surname":"Паспаљ"}'),
       (N'{"name":"Дејан","surname":"Бодирога"}'),
       (N'{"name":"Ђорђе","surname":"Вајферт"}'),
       (N'{"name":"Горан","surname":"Бреговић"}'),
       (N'{"name":"Милутин","surname":"Миланковић"}'),
       (N'{"name":"Никола","surname":"Тесла"}');
GO

ALTER TABLE JsonCollection
    ADD vName AS JSON_VALUE(json, '$.name');

CREATE INDEX idx_name
    ON JsonCollection(vName);
Os comandos anteriores criam um índice padrão na coluna calculada vName, que representa o valor da propriedade JSON $.name. Na página de código cirílico sérvio, a ordem das letras é А, Б, В, Г, Д, Ђ, Е, etc. A ordem dos itens no índice é compatível com as regras cirílicas sérvias porque o resultado da função JSON_VALUE herda seu agrupamento da coluna de origem. O exemplo a seguir consulta essa coleção e classifica os resultados por nome.
SELECT JSON_VALUE(json, '$.name'),
       *
FROM JsonCollection
ORDER BY JSON_VALUE(json, '$.name');
Se você examinar o plano de execução real, verá que ele usa valores classificados do índice não clusterizado.
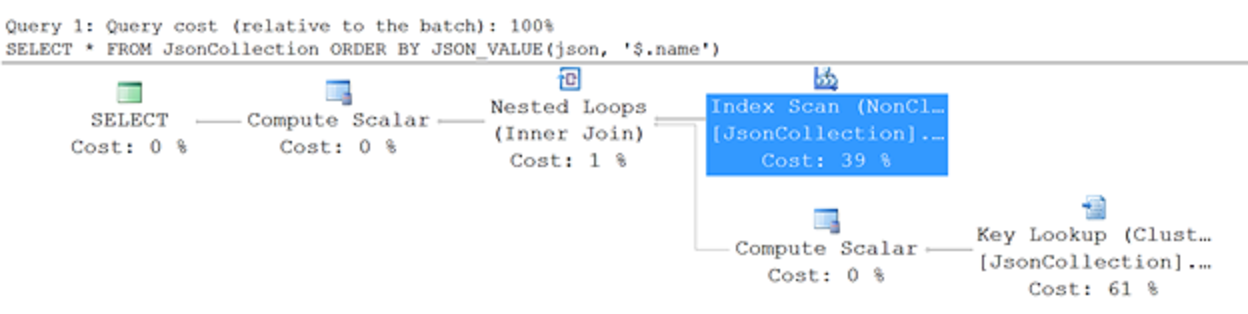
Embora a consulta tenha uma cláusula ORDER BY, o plano de execução não usa um operador Sort. O índice JSON já está ordenado de acordo com as regras cirílicas sérvias. Portanto, o SQL Server pode usar o índice não clusterizado onde os resultados já estão classificados.
No entanto, se você alterar o agrupamento da expressão ORDER BY - por exemplo, se você adicionar COLLATE French_100_CI_AS_SC após a função JSON_VALUE - você obterá um plano de execução de consulta diferente.
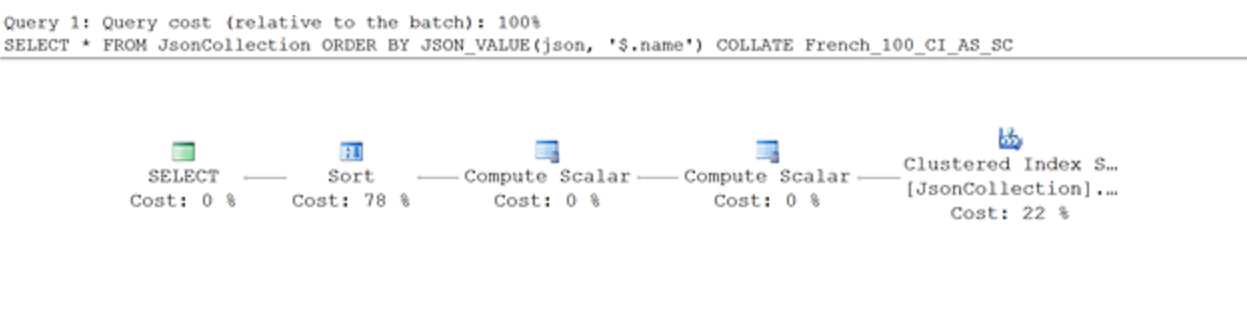
Como a ordem dos valores no índice não é compatível com as regras de agrupamento em francês, o SQL Server não pode usar o índice para ordenar os resultados. Portanto, ele adiciona um operador Sort que classifica os resultados usando regras de agrupamento em francês.
Vídeos da Microsoft
Para obter uma introdução visual ao suporte JSON interno, consulte o seguinte vídeo: