Escolha um formato de tabela de dados
Os engenheiros de dados enfrentam uma decisão crítica logo no início de cada pipeline de dados: que formato de tabela deve armazenar os seus dados? Esta escolha afeta o desempenho das consultas, a fiabilidade das transações, a interoperabilidade com outras plataformas e a manutenção a longo prazo da arquitetura da sua casa do lago.
O Azure Databricks suporta múltiplos formatos de armazenamento, cada um desenhado para diferentes cenários. Compreender as diferenças ajuda-o a escolher o formato certo para as suas necessidades específicas.
Compreender formatos de ficheiros versus formatos de tabela
Antes de comparar opções, é importante distinguir entre formatos de ficheiro e formatos de tabela. Um formato de ficheiro como Parquet, CSV ou JSON define como os dados são fisicamente armazenados no disco. Um formato de tabela como Delta Lake ou Apache Iceberg constrói-se sobre formatos de ficheiro adicionando uma camada de metadados que acompanha transações, alterações de esquema e localizações de ficheiros de dados.
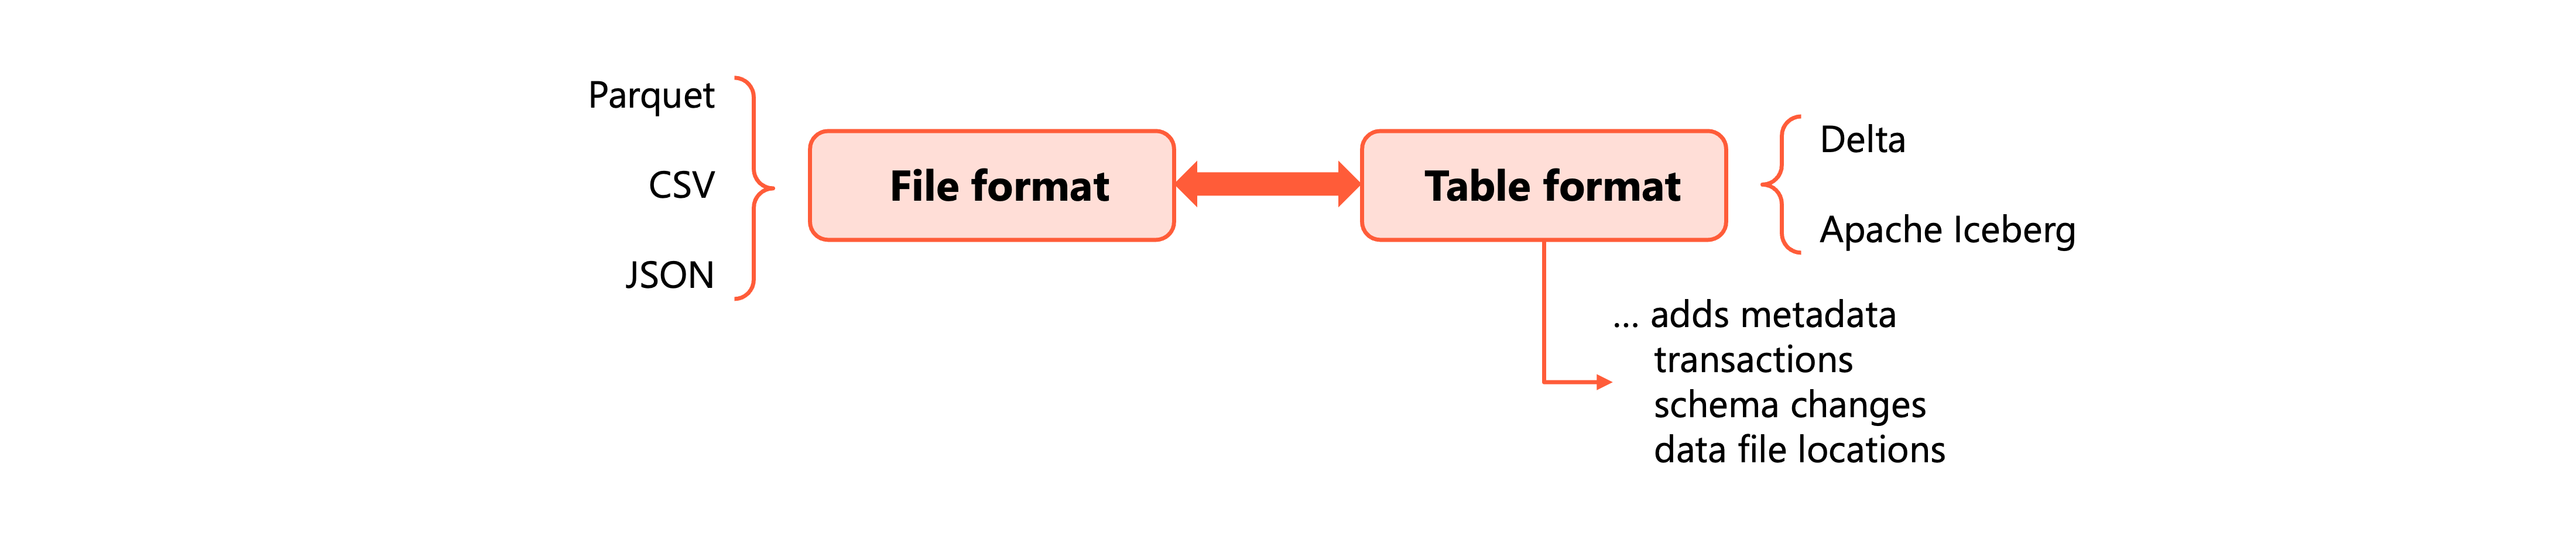
Tanto a Delta Lake como a Apache Iceberg usam o Parquet como formato de ficheiro subjacente. A principal diferença reside na camada de metadados que permite funcionalidades avançadas como transações ACID, viagens no tempo e evolução de esquemas.
Como o Parquet armazena dados de forma diferente
O parquet utiliza armazenamento em colunas em vez de armazenamento em linhas. Esta diferença fundamental impacta significativamente o desempenho das consultas analíticas.
Em formatos baseados em linhas como o CSV, os dados são organizados por registo. Ler uma única coluna requer varrer cada linha do ficheiro. Em formatos colunares como o Parquet, os dados de cada coluna são armazenados em conjunto. Quando uma consulta precisa apenas de colunas específicas, o Parquet lê apenas essas colunas e ignora completamente o resto.
O Parquet organiza os dados em grupos de linhas, cada um contendo chunks de coluna. Cada bloco de coluna armazena estatísticas, incluindo valores mínimos e máximos desse segmento de dados. Quando executa uma consulta com uma condição de filtro, o motor de consulta verifica primeiro essas estatísticas. Se o valor do filtro estiver fora do intervalo mínimo/máximo de um grupo de linhas, o motor ignora toda essa secção.
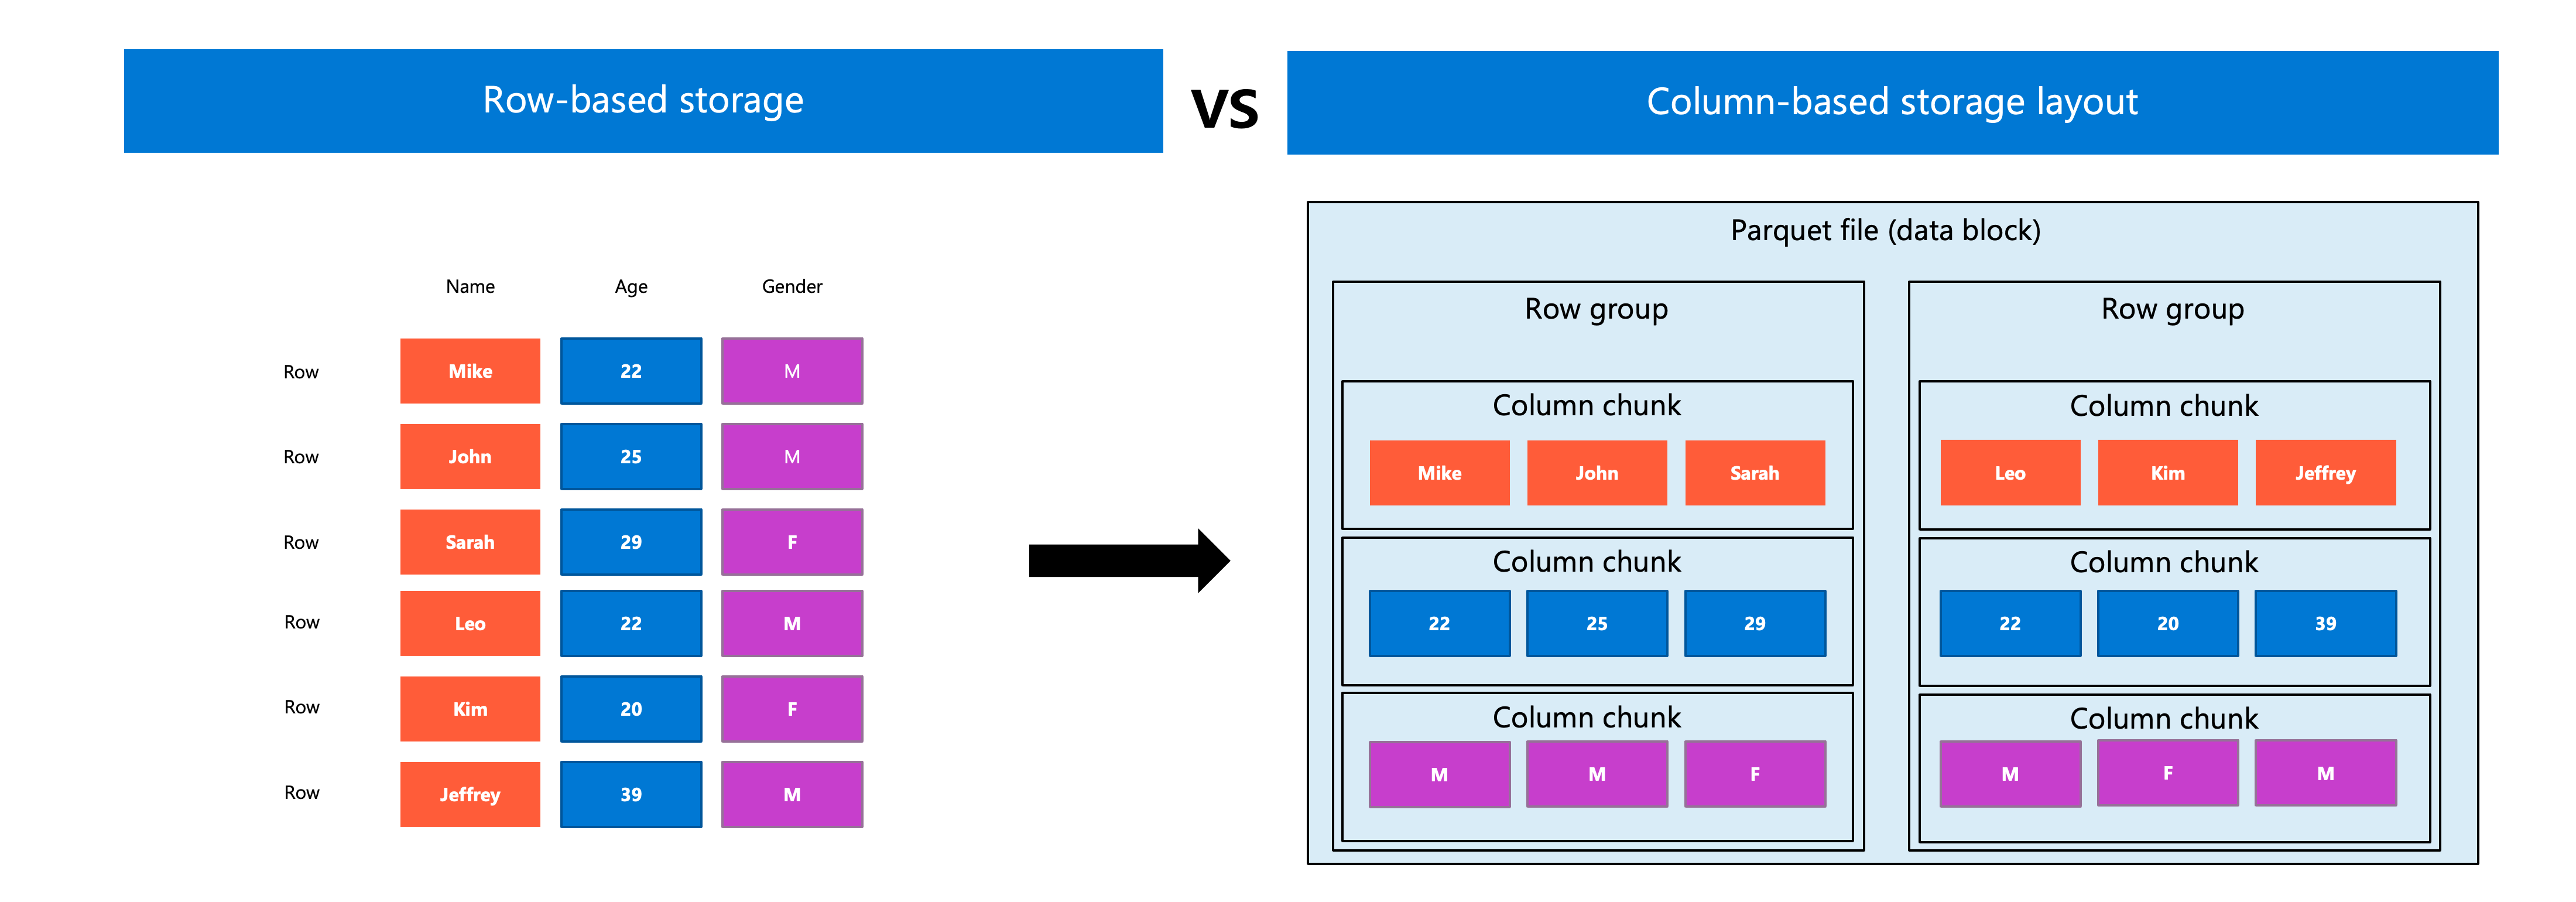
Esta abordagem colunar fornece duas técnicas de otimização que melhoram dramaticamente o desempenho das análises:
- Poda de colunas: O motor lê apenas as colunas referenciadas pela sua consulta, reduzindo substancialmente a I/O.
- Execução antecipada de condições: As condições do filtro são avaliadas com base nas estatísticas das colunas antes da leitura dos dados, ignorando completamente os grupos de linhas não pertinentes.
Para cargas de trabalho analíticas que normalmente acedem a um subconjunto de colunas em várias linhas, o Parquet supera largamente os formatos baseados em linhas.
Delta Lake como formato padrão
Delta Lake é o formato de armazenamento predefinido para todas as tabelas no Azure Databricks. Quando crias uma tabela sem especificar um formato, o Azure Databricks usa automaticamente o Delta Lake.
A Delta Lake estende ficheiros Parquet com um registo de transações que regista todas as alterações na sua tabela. Este registo de atividades permite várias capacidades que o Parquet sozinho não oferece:
Transações ACID: Múltiplos leitores e escritores simultâneos podem aceder à mesma tabela sem corrupção de dados. Cada transação é concluída na totalidade ou não tem efeito.
Viagem no tempo: Consulte versões anteriores da sua tabela usando carimbos temporais ou números de versão. Reverta as alterações se necessário.
Imposição e evolução do esquema: A tabela valida os dados de entrada contra o esquema definido, impedindo que dados corrompidos ou incompatíveis entrem no seu lakehouse. Quando os requisitos mudam, pode adicionar novas colunas, modificar tipos de dados ou renomear colunas sem reescrever dados existentes.
Batch unificado e streaming: Use a mesma tabela tanto como fonte em lote como fonte ou destino de streaming.
O Delta Lake integra-se profundamente com a plataforma Azure Databricks. Funcionalidades como clustering líquido e otimização preditiva estão disponíveis tanto para as tabelas Delta Lake como para as Apache Iceberg geridas no Unity Catalog. No entanto, o feed de dados de alteração é específico do Delta Lake e depende do seu registo de transações.
Para a maioria dos cenários em Azure Databricks, Delta Lake é a escolha recomendada. Proporciona os benefícios de desempenho do Parquet com garantias transacionais que os sistemas de dados de produção exigem.
Apache Iceberg para cenários multiplataforma
Apache Iceberg é um formato alternativo de tabela aberta que o Azure Databricks suporta para tabelas geridas e estrangeiras. Tal como o Delta Lake, o Iceberg fornece transações ACID, evolução de esquemas e funcionalidades de viagem no tempo baseadas em ficheiros Parquet.
A estrutura lógica hierárquica e bem definida do Iceberg torna-o altamente flexível, suportando escalabilidade e otimizações avançadas. Suporta poda de manifestos, estatísticas ao nível de ficheiro, particionamento oculto e evolução de partições.
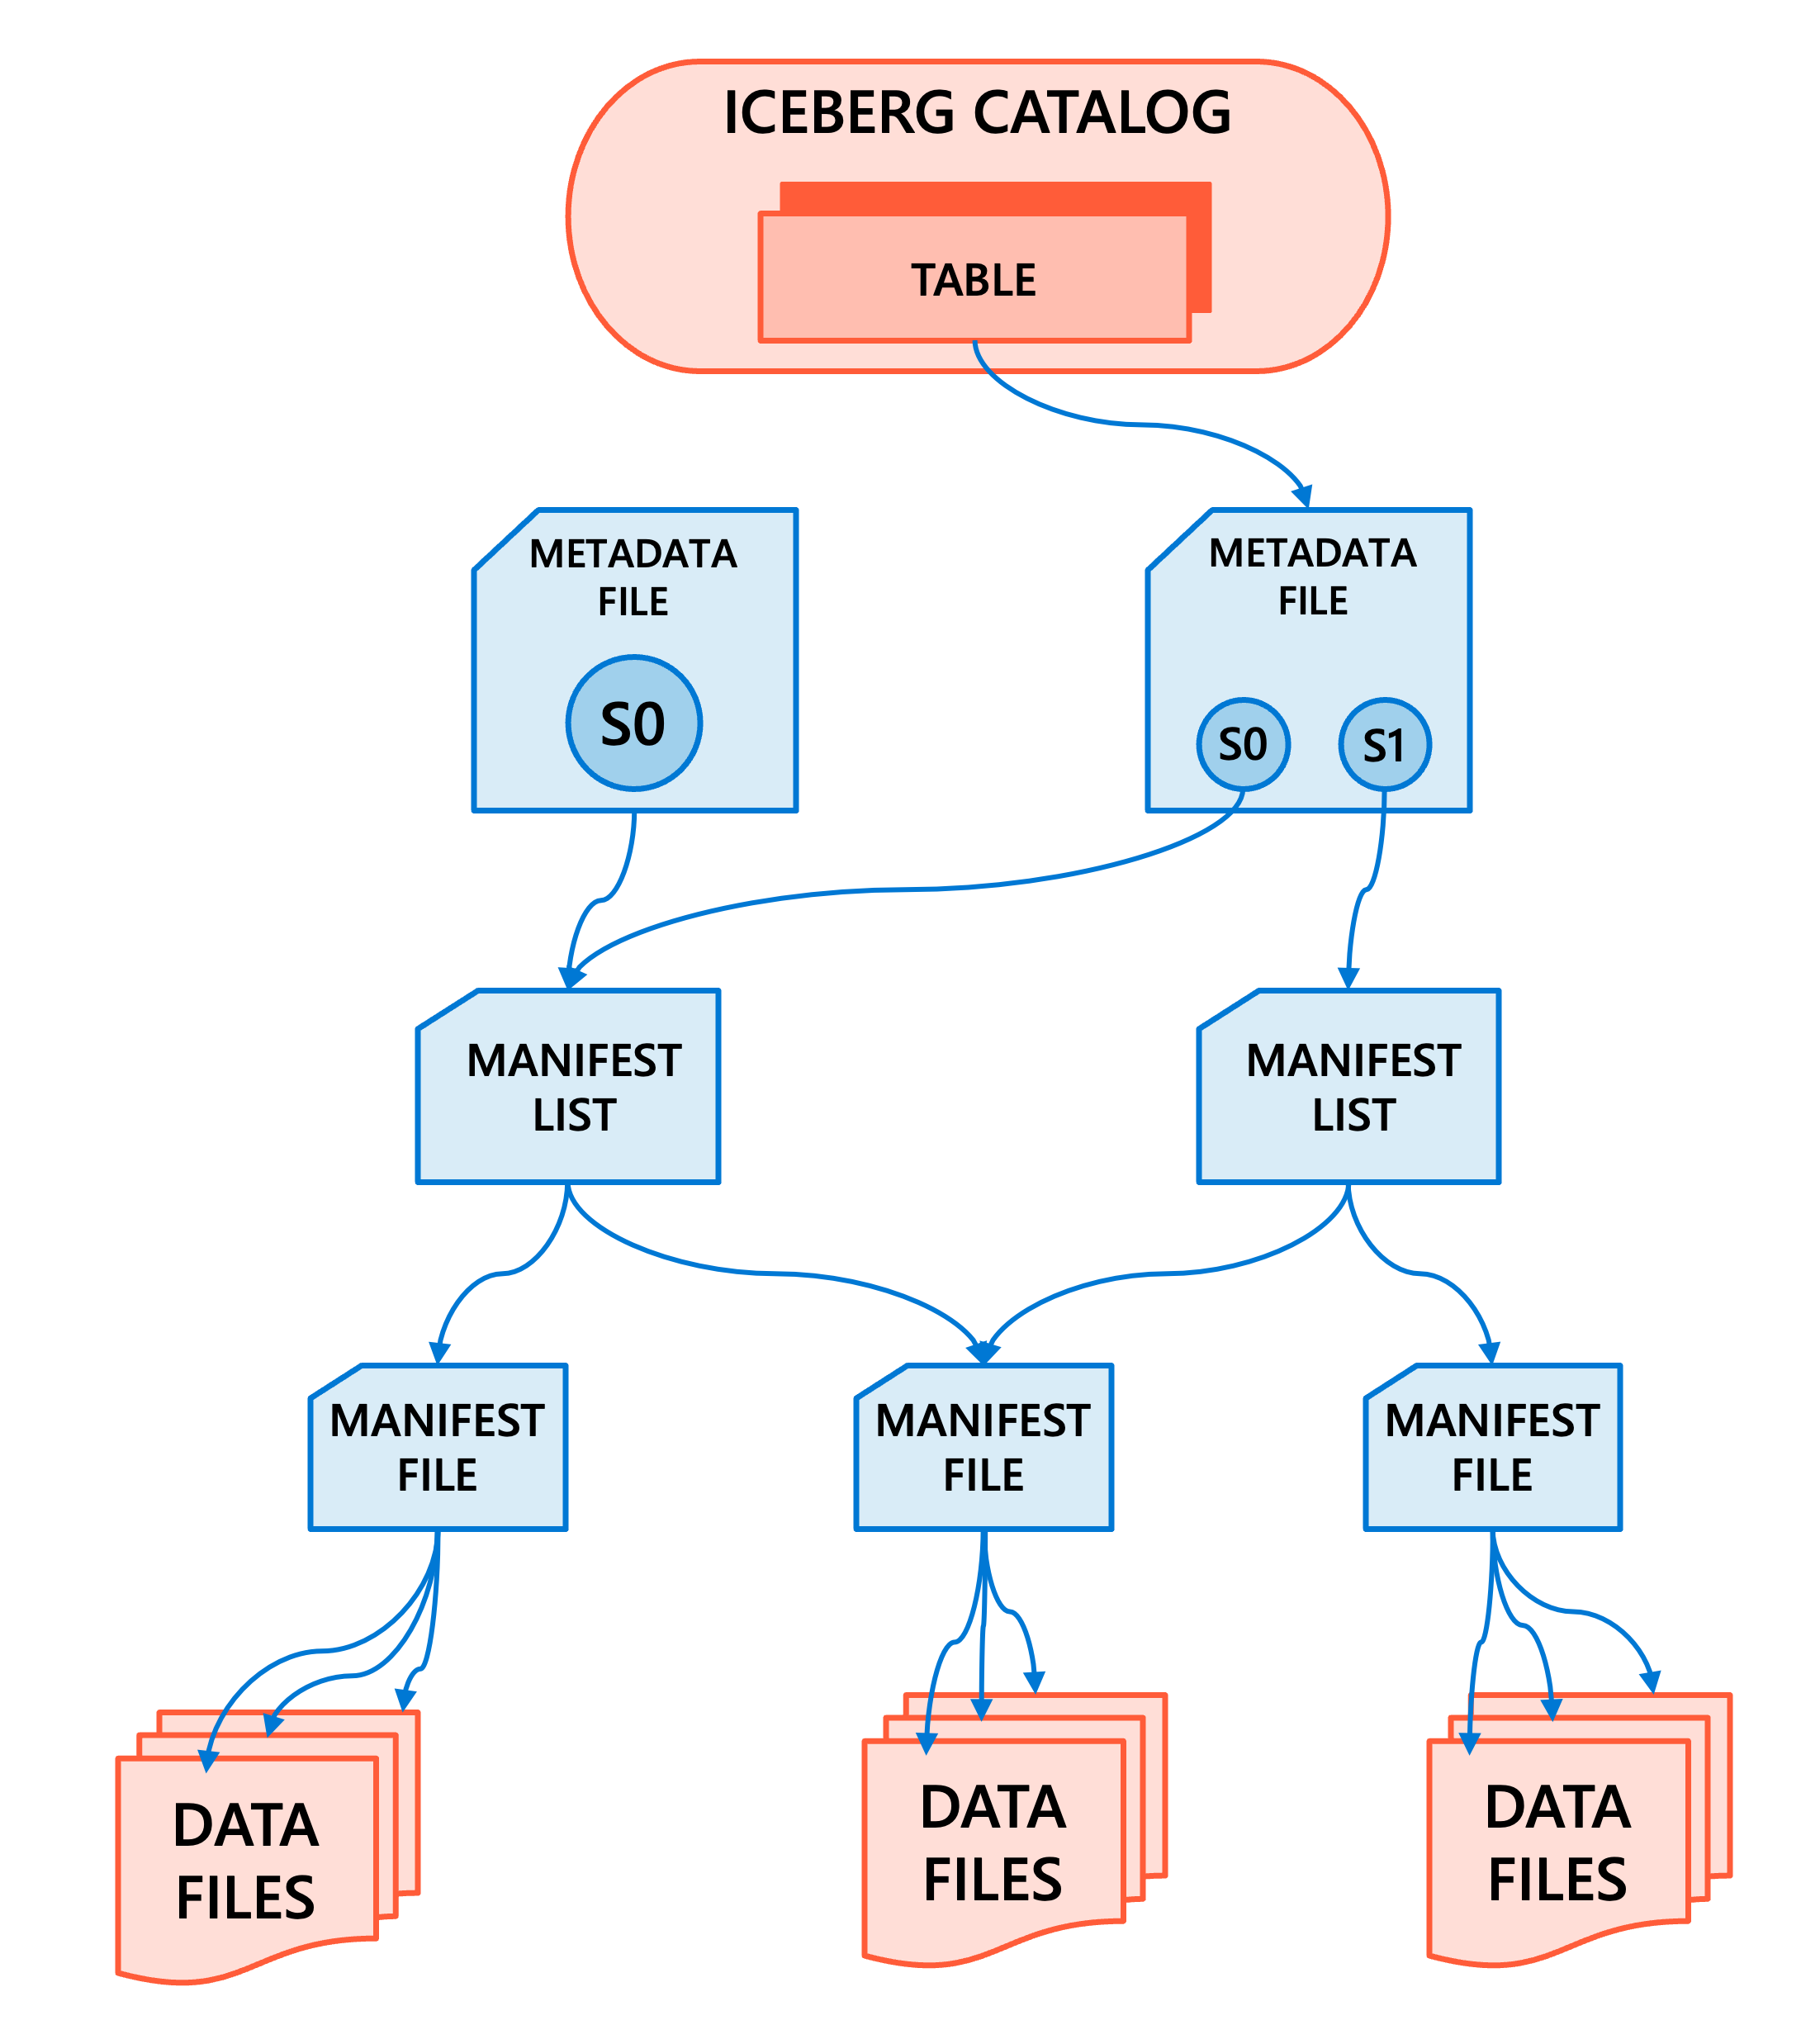
A principal razão para escolher o Iceberg é a interoperabilidade. Iceberg é amplamente adotado em todo o ecossistema de dados, incluindo plataformas como Snowflake, Amazon Athena, Trino, Apache Spark e Apache Flink. Se a sua organização executa cargas de trabalho em múltiplas plataformas que precisam de ler e escrever as mesmas tabelas, o Iceberg fornece um formato comum que todas as plataformas compreendem.
O Unity Catalog pode gerir tabelas Iceberg diretamente, permitindo que o Azure Databricks sirva como catálogo Iceberg para motores externos. Também pode ler tabelas Iceberg geridas por outros catálogos como AWS Glue ou Snowflake Horizon Catalog através de ligações a tabelas estrangeiras.
Considere Iceberg quando:
- Os seus dados precisam de ser acedidos por vários motores de processamento fora do Azure Databricks.
- A sua organização padronizou o Iceberg para partilha de dados multiplataforma.
- Estás a integrar-te com sistemas que não suportam o Delta Lake.
Para cargas de trabalho que funcionam principalmente dentro do Azure Databricks, o Delta Lake continua a ser o formato recomendado devido à sua integração mais profunda com a plataforma e funcionalidades de otimização.
Quando se aplicam os formatos baseados em linhas
CSV e JSON continuam a ser escolhas válidas para cenários específicos, embora sejam menos eficientes para análises em grande escala.
Use CSV ou JSON quando:
- Recebes dados de sistemas externos nestes formatos como zona de aterragem inicial.
- Precisa de dados legíveis para humanos para depuração ou inspeção rápida.
- Estás a integrar-te com sistemas que só suportam formatos baseados em texto.
- Os volumes de dados são suficientemente pequenos para que as diferenças de desempenho sejam negligenciáveis.
Para armazenamento persistente de dados analíticos, converta ficheiros CSV ou JSON recebidos em tabelas Delta Lake durante a ingestão. Esta conversão capta os ganhos de eficiência do armazenamento colunar, ao mesmo tempo que acrescenta garantias transacionais.
Aplicar critérios de decisão
A escolha de um formato de tabela depende das suas necessidades específicas. Comece com Delta Lake como escolha padrão, depois avalie as alternativas apenas quando determinadas restrições as exigirem.
| Consideração | Lago Delta | Apache Iceberg | CSV/JSON |
|---|---|---|---|
| Desempenho analítico | Excelente | Excelente | Fraco |
| Transações ACID | Yes | Yes | Não |
| Viagem no tempo | Yes | Yes | Não |
| Integração com Azure Databricks | Profundo | Suportado | Básico |
| Compatibilidade entre plataformas | Crescimento | Amplo | Universal |
| Recomendado para produção | Yes | Sim (quando é necessária interoperabilidade) | Não (apenas zona de aterragem) |
A tua escolha também depende dos padrões organizacionais. Se a sua equipa de arquitetura estabeleceu convenções para formatos de tabelas, alinhe-se com essas decisões para manter a consistência em toda a sua plataforma de dados.