Implementar verificações de validação
Os pipelines de dados frequentemente encontram registos com valores em falta, identificadores duplicados ou valores que estão fora dos intervalos aceitáveis. Sem verificações de validação implementadas, estes problemas de qualidade dos dados propagam-se a jusante, causando análises incorretas, relatórios falhados e decisões empresariais pouco fiáveis. As verificações de validação detetam estes problemas no ponto de ingestão de dados, garantindo que apenas dados de qualidade fluam através do seu pipeline.
Nesta unidade, aprende como implementar verificações de validação para nulidade, cardinalidade de dados e verificação de intervalo usando expectativas dos pipelines Lakeflow e restrições da tabela Delta Lake.
Compreenda as abordagens de validação no Azure Databricks
O Azure Databricks fornece dois mecanismos principais para implementar verificações de validação: expectativas de pipeline e restrições de tabelas. Cada abordagem serve diferentes cenários e oferece capacidades distintas.
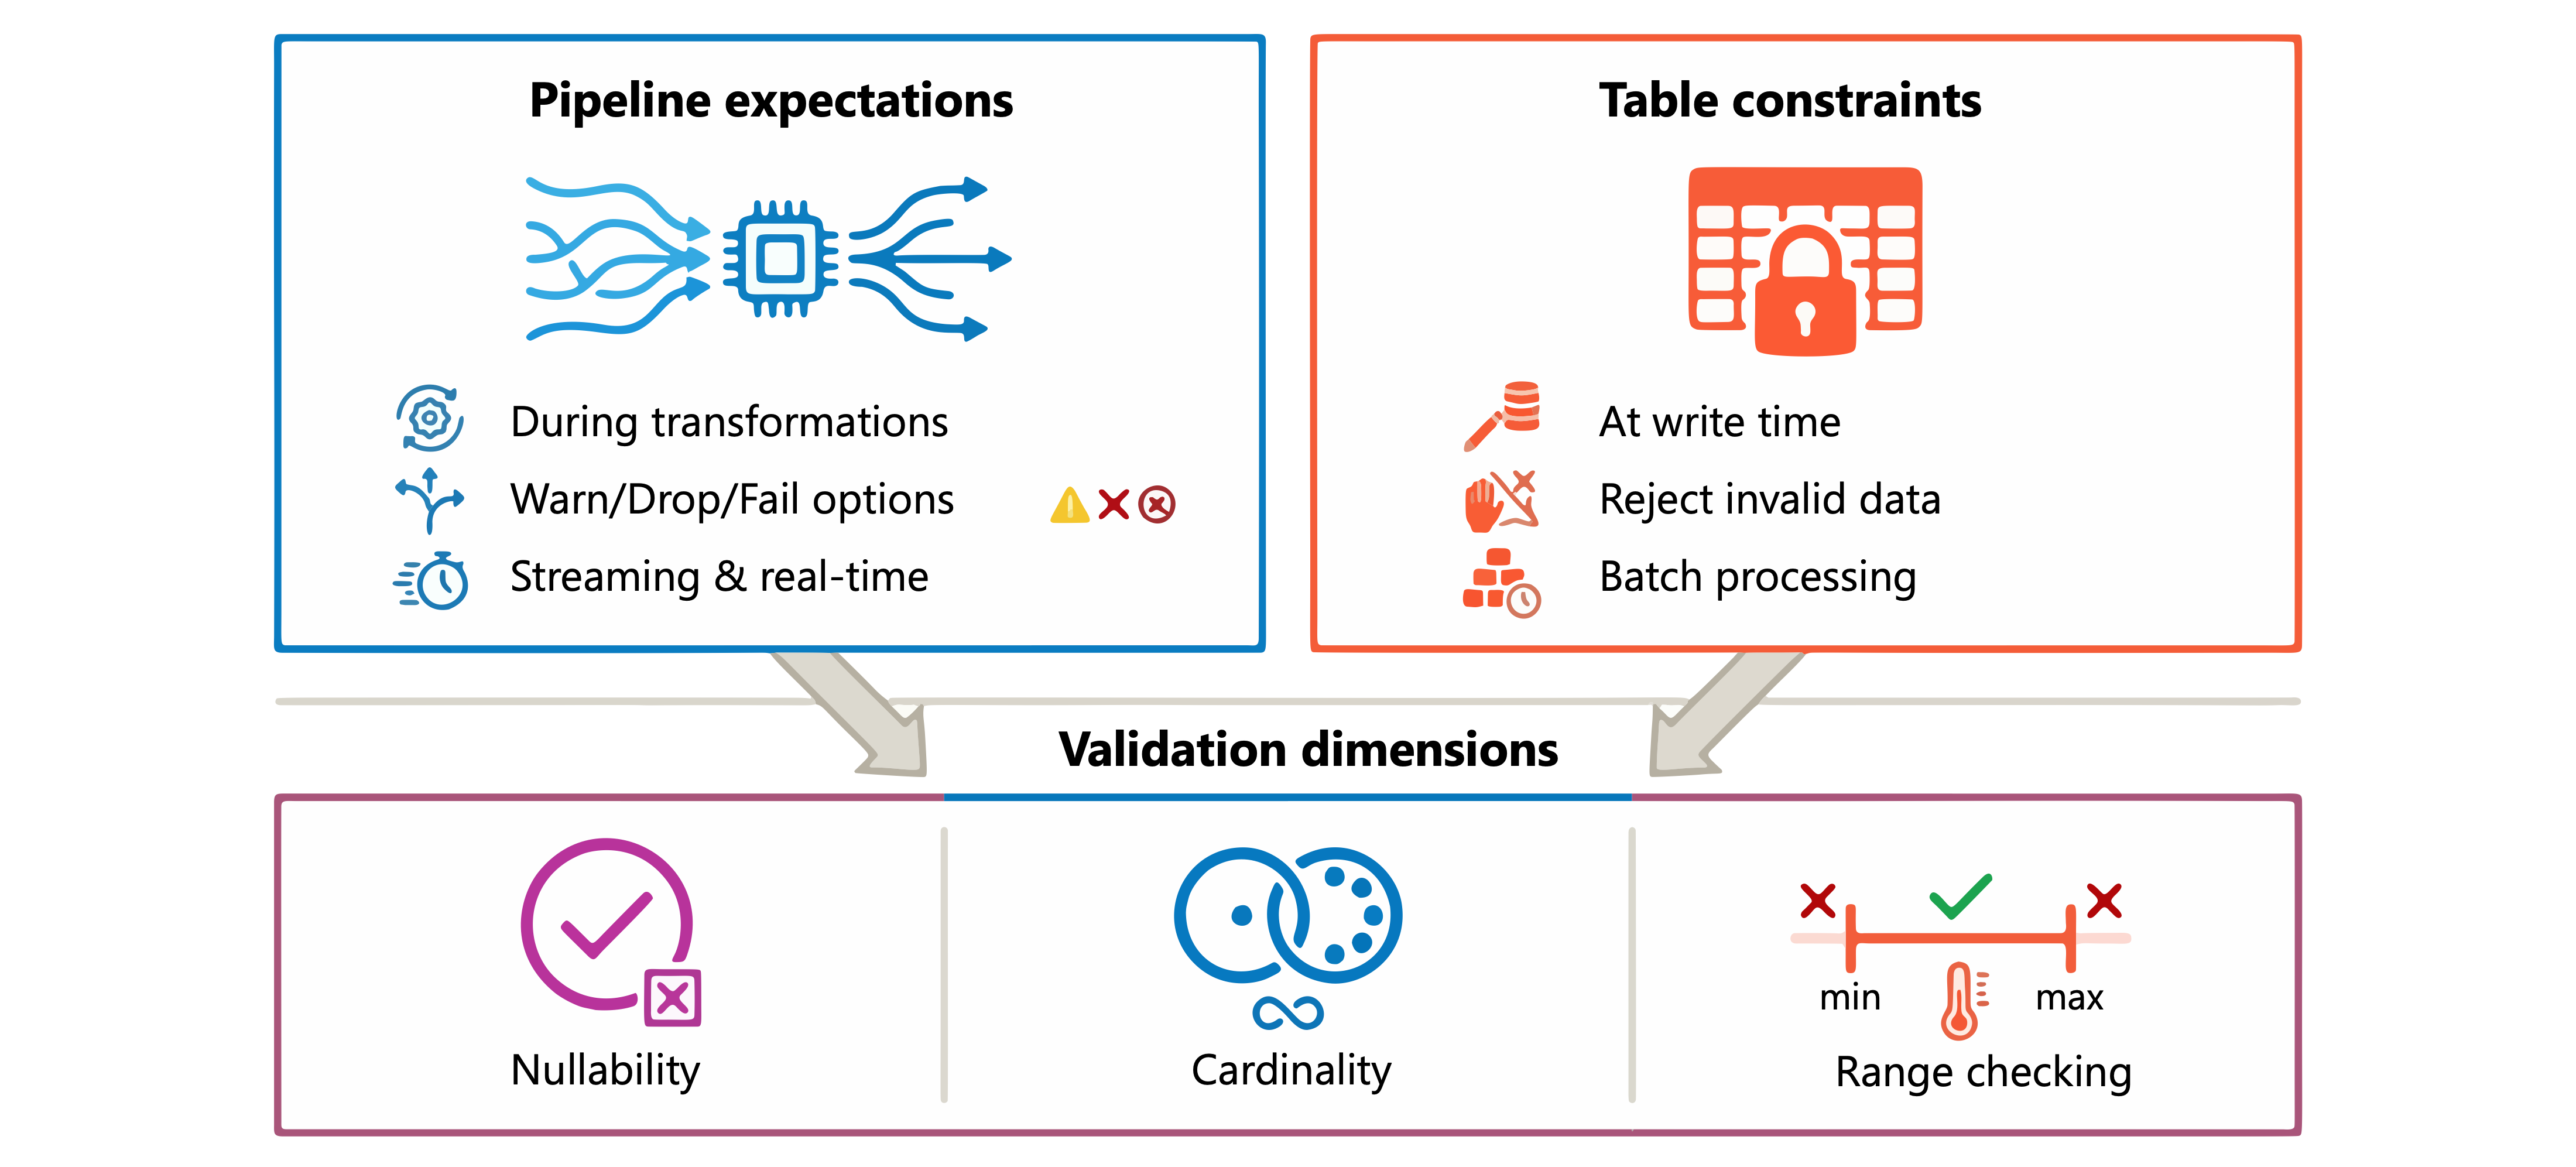
As expectativas de pipeline aplicam validação durante as transformações de dados nos pipelines Lakeflow. As expectativas permitem-lhe avisar, eliminar registos inválidos ou interromper o pipeline quando os dados violam as regras definidas. Esta abordagem funciona bem para tabelas de streaming e visualizações materializadas onde é necessário controlo de qualidade em tempo real.
As restrições das tabelas aplicam regras diretamente nas tabelas Delta Lake. As restrições rejeitam dados inválidos no momento da escrita, impedindo que registos defeituosos entrem nas suas tabelas. Esta abordagem adequa-se ao processamento em lote e a cenários que exigem garantias rigorosas de integridade dos dados.
Com estas abordagens, pode validar três dimensões chave da qualidade dos dados: anulabilidade (garantir que os valores necessários existem), cardinalidade dos dados (verificar a unicidade quando esperado) e verificação de intervalo (confirmar que os valores estão dentro dos limites aceitáveis).
Implementar verificações de anulabilidade
A validação de nulidade garante que as colunas exigidas contêm valores. Considere uma tabela de clientes onde email e customer_id devem sempre ter valores. Pode implementar estas verificações usando as expectativas do seu pipeline.
Usando Python, adicione decoradores de expectativas à definição da sua tabela de streaming:
from pyspark import pipelines as dp

@dp.table
@dp.expect_or_drop("valid_email", "email IS NOT NULL")
@dp.expect_or_drop("valid_customer_id", "customer_id IS NOT NULL")
def customers():
    return spark.readStream.table("raw.customers")
A mesma validação em SQL usa a CONSTRAINT cláusula:
CREATE OR REFRESH STREAMING TABLE customers(
    CONSTRAINT valid_email EXPECT (email IS NOT NULL) ON VIOLATION DROP ROW,
    CONSTRAINT valid_customer_id EXPECT (customer_id IS NOT NULL) ON VIOLATION DROP ROW
) AS SELECT * FROM STREAM(raw.customers);
Para tabelas Delta Lake fora dos pipelines, use NOT NULL restrições na definição da tabela:
CREATE TABLE customers (
    customer_id INT NOT NULL,
    email STRING NOT NULL,
    first_name STRING,
    last_name STRING
);
Também pode adicionar restrições de anulabilidade às tabelas existentes:
ALTER TABLE customers ALTER COLUMN email SET NOT NULL;
Observação
Antes de adicionar uma NOT NULL restrição a uma tabela existente, o Azure Databricks verifica se todas as linhas existentes satisfazem essa restrição. A operação falha se existirem valores nulos na coluna.
Validar a cardinalidade dos dados
A validação de cardinalidade assegura que as colunas que se espera contenham valores únicos realmente o façam. Esta verificação é essencial para chaves primárias, identificadores de transações e outros campos onde duplicados indicam problemas de qualidade dos dados.
As expectativas do pipeline podem validar a cardinalidade verificando condições que indicam problemas de unicidade. Por exemplo, pode verificar que um Número de Segurança Social aparece apenas uma vez por pessoa:
from pyspark.sql.window import Window
from pyspark.sql.functions import count

@dp.table
@dp.expect("unique_ssn_per_person", "ssn_count = 1")
def employees():
    df = spark.table("raw.employees")
    w = Window.partitionBy("ssn")
    return df.withColumn("ssn_count", count("*").over(w))
Para verificações de cardinalidade mais abrangentes, combine expectativas com lógica de agregação na sua transformação:
CREATE OR REFRESH MATERIALIZED VIEW order_validation AS
SELECT
    order_id,
    COUNT(*) as occurrence_count
FROM orders
GROUP BY order_id
HAVING COUNT(*) > 1;
Esta visualização materializada identifica quaisquer IDs de ordem duplicados, permitindo-lhe investigar e resolver questões de cardinalidade.
O Delta Lake suporta restrições principais de chave que documentam a unicidade esperada, embora estas restrições sejam informativas e não aplicadas:
CREATE TABLE orders (
    order_id INT NOT NULL,
    customer_id INT,
    order_date DATE,
    CONSTRAINT orders_pk PRIMARY KEY (order_id)
);
Sugestão
Embora as principais restrições de chave não sejam aplicadas, ajudam a otimizar consultas e a documentar a estrutura pretendida do seu modelo de dados. Use as expectativas do pipeline para reforçar ativamente a singularidade.
Aplicar a verificação de alcance
A validação de intervalo confirma que valores numéricos, de data e outros se enquadram em limites aceitáveis. Esta verificação deteta erros de introdução de dados, falhas do sistema e problemas de integração que produzem valores fora do alcance.
Defina expectativas de intervalo usando operadores de comparação ou a BETWEEN cláusula:
@dp.table
@dp.expect_or_fail("valid_age", "age BETWEEN 0 AND 150")
@dp.expect_or_fail("valid_salary", "salary >= 0")
@dp.expect_or_fail("valid_hire_date", "hire_date <= current_date()")
def employees():
    return spark.readStream.table("raw.employees")
Em SQL, aplique as mesmas verificações de intervalo:
CREATE OR REFRESH STREAMING TABLE transactions(
    CONSTRAINT valid_amount EXPECT (amount > 0) ON VIOLATION DROP ROW,
    CONSTRAINT valid_date EXPECT (transaction_date <= current_date()) ON VIOLATION DROP ROW,
    CONSTRAINT valid_quantity EXPECT (quantity BETWEEN 1 AND 10000) ON VIOLATION DROP ROW
) AS SELECT * FROM STREAM(raw.transactions);
Para tabelas Delta Lake, use CHECK restrições para impor intervalos durante a escrita.
ALTER TABLE employees ADD CONSTRAINT valid_age CHECK (age >= 18 AND age <= 120);
ALTER TABLE transactions ADD CONSTRAINT positive_amount CHECK (amount > 0);
As verificações de intervalo também podem validar regras de negócio que combinam múltiplas condições:
@dp.expect("valid_discount", """
    discount_percent >= 0
    AND discount_percent <= 100
    AND (discount_percent <= 50 OR customer_tier = 'PREMIUM')
""")
Esta expectativa garante que os descontos se mantenham dentro dos limites e garante que apenas os clientes premium recebam descontos acima de 50%.
Escolha ações para falhas de validação
Quando a validação falha, escolhe como o seu pipeline responde. Cada ação adequa-se a diferentes requisitos empresariais e níveis de criticidade de dados.
| Ação | Caso de uso | Comportamento |
|---|---|---|
| Aviso (padrão) | Monitorização e análise | Registos inválidos são gravados no destino; Métricas registadas |
| Largar | Limpeza de dados | Registos inválidos removidos antes da escrita |
| Falha | Integridade crítica dos dados | Paragens de oleoduto; Reversão de transações |
Use a ação de aviso quando precisar de visibilidade sobre questões de qualidade dos dados sem bloquear o fluxo de dados:
@dp.expect("has_phone", "phone_number IS NOT NULL")
Use drop quando registros inválidos devem ser filtrados silenciosamente:
@dp.expect_or_drop("complete_address", "street IS NOT NULL AND city IS NOT NULL")
Use fail quando a integridade dos dados é crítica e registos inválidos são inaceitáveis:
@dp.expect_or_fail("valid_account_balance", "balance >= 0")
Pode visualizar métricas de expectativas na interface do pipeline selecionando um conjunto de dados com expectativas e abrindo o separador Qualidade dos Dados . Estas métricas ajudam-no a monitorizar as taxas de validação e a identificar problemas sistemáticos de qualidade dos dados.
Agora que já sabe como implementar verificações de validação, pode garantir que os seus pipelines de dados mantêm padrões de qualidade para anulabilidade, cardinalidade e intervalos de valor.