Preparar dados para recuperação
Tip
Consulte a guia Texto e imagens para obter mais detalhes!
A recuperação só pode encontrar informação que tenha sido tornada pesquisável. Antes de uma aplicação RAG poder responder a perguntas, necessita de um pipeline de indexação que prepare os dados fonte.
O pipeline de indexação normalmente executa as seguintes tarefas:
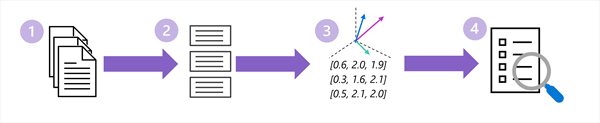
- Extrai o texto de origem.
- Divide o texto em passagens focadas.
- Codifica os tokens de texto como vetores de embedding que encapsulam atributos semânticos.
- Cria um índice que pode ser usado para pesquisar os embeddings.
Vamos explorar cada uma destas tarefas com mais profundidade.
Selecionar e processar dados de origem
Uma fonte de conhecimento RAG pode incluir manuais de produtos, políticas, páginas web, registos de bases de dados, tickets de suporte ou outro conteúdo aprovado. O processo de preparação inclui normalmente estes passos:
- Carregue conteúdo de cada fonte.
- Extrair texto útil e estrutura de formatos como ficheiros PDF, apresentações, páginas web ou tabelas.
- Limpe o conteúdo removendo cabeçalhos repetidos, texto de navegação ou outros elementos que não sejam úteis para responder a perguntas.
- Adicione metadados como título, URL de origem, categoria, permissões de acesso e data de última atualização.
A qualidade da fonte importa. Documentos duplicados, desatualizados ou contraditórios podem levar a uma má recuperação e respostas pouco fiáveis. Os controlos de acesso também são essenciais: os utilizadores só devem recuperar conteúdos que estão autorizados a ver.
Dividir o conteúdo em blocos
Os documentos são frequentemente demasiado grandes para serem enviados a um modelo na íntegra. Estão divididos em passagens menores chamadas chunks. Cada bloco deve conter contexto suficiente para ser significativo, mantendo-se focado num tema específico.
Por exemplo, uma política de viagem pode ser dividida por secção em partes separadas para voos, hotéis, refeições e transporte terrestre. Uma pergunta sobre limites de hotéis pode então aceder à secção do hotel sem adicionar toda a política ao prompt.
O chunking envolve um compromisso:
- Blocos demasiado grandes podem conter informação irrelevante e consumir mais do contexto do modelo.
- Blocos demasiado pequenos podem separar uma afirmação de títulos, definições ou outra informação necessária para a compreender.
Os chunks muitas vezes sobrepõem-se ligeiramente para que o contexto importante não se perca numa fronteira.
Criar incorporações
As soluções RAG utilizam normalmente um modelo de embedding para converter cada chunk numa embedding: um vetor numérico que representa as características semânticas do conteúdo. Blocos com significados semelhantes têm embeddings próximos uns dos outros no espaço vetorial, mesmo quando usam palavras diferentes.
Indexar os dados
A solução armazena os chunks, os seus embeddings e metadados úteis num índice de pesquisa ou num armazenamento de dados com vetor. O índice pode suportar:
- Pesquisa por palavras-chave, que é eficaz quando palavras exatas, identificadores ou códigos de produto são importantes.
- Pesquisa vetorial, que encontra conteúdos semanticamente semelhantes.
- Pesquisa híbrida, que combina pesquisa por palavras-chave e vetor.
Preparar dados não é uma tarefa pontual. O pipeline de indexação deve adicionar novo conteúdo, atualizar o conteúdo alterado e remover conteúdos que já não são válidos para que a recuperação reflita a fonte atual de verdade.