Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
Вы можете взаимодействовать с файлами рабочей области, хранящимися в Azure Databricks программным способом. Это позволяет выполнять такие задачи, как:
- Хранение небольших файлов данных вместе с записными книжками и кодом.
- Запись файлов журналов в каталоги, синхронизированные с Git.
- Импорт модулей с помощью относительных путей.
- Создание или изменение файла спецификации среды.
- Запись выходных данных из записных книжек.
- Запись результатов выполнения таких библиотек, как Tensorboard.
Вы можете программно создавать, изменять, переименовать и удалять файлы рабочей области в Databricks Runtime 11.3 LTS и более поздних версиях. Эта функция поддерживается для записных книжек в Databricks Runtime 16.2 и выше, а также в бессерверной архитектуре версии 2 и выше.
Заметка
Чтобы отключить запись в файлы рабочей области, задайте переменную среды кластера WSFS_ENABLE_WRITE_SUPPORT=false. Дополнительные сведения см. в переменных среды .
Заметка
В Databricks Runtime 14.0 и выше по умолчанию текущий рабочий каталог (CWD) для локального выполнения кода — это каталог, содержащий блокнот или скрипт, выполняемый на запуске. Это изменение поведения в Databricks Runtime 13.3 LTS и ниже. См. Что такое текущий рабочий каталог по умолчанию?.
В бессерверной среде выполнения наличие рабочей директории не гарантируется, поэтому для указания файлов используйте абсолютные пути. См . ограничения бессерверных вычислений.
Чтение расположений файлов
Используйте команды оболочки для чтения расположений файлов, например в репозитории или локальной файловой системе.
Чтобы определить расположение файлов, введите следующее:
%sh ls
-
Файлы не в репозитории: Команда возвращает файловую систему
/databricks/driver. -
Файлы находятся в репозитории: команда возвращает виртуализированное репозиторие, например
/Workspace/Repos/name@domain.com/public_repo_2/repos_file_system.
Чтение файлов рабочей области данных
Вы можете программно считывать небольшие файлы данных, такие как файлы .csv или .json, из кода в ваших записных книжках. В следующем примере Pandas используется для запроса файлов, хранящихся в каталоге /data относительно корневого каталога репозитория проекта:
import pandas as pd
df = pd.read_csv("./data/winequality-red.csv")
df
С помощью Spark можно считывать файлы данных. Необходимо предоставить Spark полный путь.
- Файлы рабочей области в папках Git используют путь
file:/Workspace/Repos/<user-folder>/<repo-name>/path/to/file. - Файлы рабочей области в личном каталоге используют путь:
file:/Workspace/Users/<user-folder>/path/to/file.
Абсолютный или относительный путь к файлу можно скопировать из раскрывающегося меню рядом с файлом:
файловое раскрывающееся меню 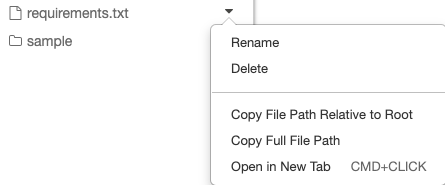
В приведенном ниже примере показано использование {os.getcwd()} для получения полного пути.
import os
spark.read.format("csv").load(f"file:{os.getcwd()}/my_data.csv")
Заметка
В рабочих областях, где корневой каталог и подключения DBFS отключены, можно также использовать dbfs:/Workspace для доступа к файлам рабочих областей с помощью служебных программ Databricks. Для этого требуется Databricks Runtime 13.3 LTS или более поздней версии. См. Отключить доступ к корневому каталогу DBFS и точкам монтирования в существующей рабочей области Azure Databricks.
Дополнительные сведения о файлах в Azure Databricks см. в статье Работа с файлами в Azure Databricks.
Программное создание, обновление и удаление файлов и каталогов
Вы можете программно управлять файлами рабочей области в Azure Databricks, как и с файлами в любой стандартной файловой системе.
Заметка
В Databricks Runtime 16.2 и выше и бессерверной среде 2 и выше все программные взаимодействия с файлами также доступны для записных книжек. Сведения о преобразовании файла в записную книжку см. в разделе "Преобразование файла в записную книжку".
Заметка
Родительская папка файла должна уже существовать до того, как вы в него записываете. Azure Databricks буферизирует операции записи файлов и асинхронно сбрасывает их в рабочую область, поэтому запись по пути, родительский каталог которого отсутствует, завершается ошибкой с AsyncFlushFailedException после вызова записи, а не в момент этого вызова. Сначала создайте родительский каталог, как показано в следующем примере.
В следующих примерах используются стандартные пакеты и функции Python для создания файлов и каталогов и управления ими.
import os

# Create a new directory

os.mkdir('dir1')

# Create a new file and write to it

with open('dir1/new_file.txt', "w") as f:
    f.write("new content")

# Append to a file

with open('dir1/new_file.txt', "a") as f:
    f.write(" continued")

# Delete a file

os.remove('dir1/new_file.txt')

# Delete a directory

os.rmdir('dir1')
import shutil

# Copy a dashboard

shutil.copy("my-dashboard.lvdash.json", "my-dashboard-copy.lvdash.json")

# Move a query to a shared folder

shutil.move("test-query.dbquery","shared-queries/")
Устранить дублирующиеся имена активов
В некоторых случаях папка рабочего пространства может уже содержать активы с тем же именем. Например, оба SQL-запроса могут иметь имя My query. Это может происходить, когда активы были созданы до того, как требование уникальности имен стало строго соблюдаться.
Если папка содержит дублирующиеся имена активов, файловый доступ к папке становится невозможным, хотя сами активы остаются незатронутыми. Вы можете увидеть такие ошибки, как:
-
Name not unique on network(OSError: [Errno 76]) — например, когда вы запускаетеlsили другие команды в веб-терминале или просматриваете список файлов в папке из блокнота. -
File name conflictилиRESOURCE_CONFLICT: Duplicate entities detected in the directory— например, во время операций с папками Git.
Заметка
Дублирующиеся имена не влияют на сами активы. Вы всё ещё можете открыть и использовать каждый ассет из браузера workspace. Затронуты только команды, обращающиеся к папке через файловую систему, — такие как веб-терминал, WSFS или операции с папкой Git.
Чтобы найти активы с дублирующимися именами, запустите следующий ноутбук. Он сканирует папку и её подпапки, а также перечисляет активы с одинаковым именем. Ноутбук предназначен только для чтения и не переименовывает и не удаляет ассеты.
Найти дублирующиеся ресурсы рабочего пространства
Чтобы устранить дублирующиеся имена с помощью интерфейса рабочего пространства:
- В браузере рабочей области откройте каждую папку, указанную ноутбуком.
- Переименуйте или удалите дублирующиеся ассеты, чтобы у каждого ассета в папке было уникальное имя.
Когда все имена ассетов в папке уникальны, доступ к файлам снова работает.