Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
Важно
Элементы, помеченные предварительным просмотром в этой статье, в настоящее время находятся в предварительной версии. Эта предварительная версия предоставляется без соглашения об уровне обслуживания, и Microsoft не рекомендуется для рабочих нагрузок рабочей среды. Некоторые функции могут не поддерживаться или могут иметь ограниченные возможности. Дополнительные сведения см. в разделе Supplemental Terms of Use for Microsoft Azure Previews.
Этот GitHub Action позволяет проводить автономную оценку агентов Microsoft Foundry Agents в конвейерах CI/CD. Это упрощает автономный процесс оценки, чтобы определить потенциальные проблемы и внести улучшения перед выпуском обновления в рабочей среде.
Чтобы использовать это действие, предоставьте набор данных с тестовых запросов и список оценщиков. Это действие вызывает агенты с запросами, выполняет оценки и создает сводный отчет.
Функции
- Agent Evaluation: автоматизация процесса предварительной оценки агентов Microsoft Foundry в вашем рабочем процессе CI/CD.
- Оценщики: используйте любые оценщики из каталога оценщиков платформы Foundry.
- Статистический анализ. Результаты оценки включают в себя доверительные интервалы и проверку статистической важности, чтобы определить, являются ли изменения значимыми, а не из-за случайного изменения.
Категории оценщика
- Оценщики агентов: процессные и системные оценщики для рабочих процессов агента.
- Оценщики RAG: оценивают сквозные процессы и процессы извлечения в системах RAG.
- Оценщики рисков и безопасности: оценка рисков и проблем безопасности в ответах.
- Оценщики общего назначения: оценка качества, например связность и беглость.
- Оценщики на основе OpenAI: используйте оценщики OpenAI, включая проверку строк, сходство текста и модель для оценки/меток.
- Пользовательские вычислители: Определите собственные пользовательские вычислители с помощью кода на Python или шаблонов LLM-as-a-judge.
Необходимые условия
- Проект. Дополнительные сведения см. в статье "Создание проекта".
- Агент Foundry.
Совет
Рекомендуемый способ проверки подлинности — использовать Microsoft Entra ID, которые можно использовать для безопасного подключения к Azure ресурсам. Процесс проверки подлинности можно автоматизировать с помощью действия Azure Login GitHub. Узнайте больше, см. раздел Действие входа в Azure с OpenID Connect.
Как настроить оценку агента ИИ
Входные данные для оценки агента ИИ
Параметры
| Имя | Обязательно? | Описание |
|---|---|---|
| Azure AI - проектная конечная точка | Да | Конечная точка проекта Microsoft Foundry. Чтобы найти это значение, откройте проект на портале Foundry и скопируйте конечную точку на странице обзора . |
| название развертывания | Да | Название развертывания модели ИИ Azure, которую следует использовать для оценки. Найдите существующие развертывания в разделе "Модели и конечные точки" на портале Foundry. |
| путь к данным | Да | Путь к файлу данных, содержащему оценщиков и входные запросы для оценки. |
| идентификаторы агента | Да | Идентификатор одного или нескольких агентов для оценки в формате agent-name:version (например, my-agent:1 или my-agent:1,my-agent:2). Несколько агентов разделены запятыми и сравниваются с результатами статистического теста. |
| базовый идентификатор агента | Нет | Идентификатор базового агента для сравнения при оценке нескольких агентов. Если он не указан, используется первый агент. |
Примечание
Чтобы найти идентификатор агента и версию, откройте проект на портале Foundry, перейдите в раздел Агентов, выберите вашего агента, и скопируйте идентификатор агента из области сведений. Версия — номер версии развертывания (например, my-agent:1).
Файл данных
Входной файл данных должен быть JSON-файлом со следующей структурой:
| Поле | Тип | Обязательно? | Описание |
|---|---|---|---|
| Имя | Строка | Да | Имя набора данных оценки. |
| Оценщиков | string[] | Да | Список имен оценщиков для использования. Ознакомьтесь со списком доступных оценщиков в каталоге оценщиков вашего проекта на портале Foundry: Build > Evaluations > каталог оценщиков. |
| данные | object[] | Да | Массив входных объектов с query и необязательными полями вычислителя, такими как ground_truth, context. Автоматическое сопоставление с вычислителями; используется data_mapping для переопределения. |
| openai_graders | Объект | Нет | Конфигурация для оценщиков на основе OpenAI (label_model, score_model, string_check и т. д.). |
| параметры_оценщика | Объект | Нет | Параметры инициализации, специфические для оценивателя (например, пороговые значения, пользовательские настройки). |
| сопоставление данных | Объект | Нет | Настраиваемые сопоставления полей данных (автоматически сформированные из данных, если они не предоставлены). |
Базовый пример файла данных
{
  "name": "test-data",
  "evaluators": [
    "builtin.fluency",
    "builtin.task_adherence",
    "builtin.violence"
  ],
  "data": [
    {
      "query": "Tell me about Tokyo disneyland"
    },
    {
      "query": "How do I install Python?"
    }
  ]
}
Дополнительные примеры файлов данных
| Имени файла | Описание |
|---|---|
| dataset-tiny.json | Набор данных с небольшим количеством тестовых запросов и оценщиков. |
| dataset.json | Набор данных со всеми поддерживаемыми типами оценщика и достаточным количеством запросов для вычисления доверия и статистического теста. |
| dataset-builtin-evaluators.json | Встроенные оценщики Foundry (например, согласованность, беглость, релевантность, обоснованность, метрики). |
| dataset-openai-graders.json | Пример оценки на основе OpenAI (модели меток, модели оценки, сходство текста, строковые проверки). |
| dataset-custom-evaluators.json | Пример пользовательских вычислителей с параметрами вычислителя. |
| dataset-data-mapping.json | Пример сопоставления данных, показывающий, как переопределить автоматическое сопоставление полей с пользовательскими именами столбцов данных. |
Рабочий процесс оценки агента ИИ
Чтобы использовать действие GitHub, добавьте действие GitHub в рабочие процессы CI/CD. Укажите условия триггера, такие как при фиксации изменений, и пути к файлам, чтобы активировать автоматизированные рабочие процессы.
Совет
Чтобы свести к минимуму затраты, не выполняйте оценку для каждого коммита.
В этом примере показано, как выполнять оценку агента ИИ при сравнении различных агентов с помощью идентификаторов агентов.
name: "AI Agent Evaluation"

on:
  workflow_dispatch:
  push:
    branches:
      - main

permissions:
  id-token: write
  contents: read

jobs:
  run-action:
    runs-on: ubuntu-latest
    steps:
      - name: Checkout
        uses: actions/checkout@v4

      - name: Azure login using Federated Credentials
        uses: azure/login@v2
        with:
          client-id: ${{ vars.AZURE_CLIENT_ID }}
          tenant-id: ${{ vars.AZURE_TENANT_ID }}
          subscription-id: ${{ vars.AZURE_SUBSCRIPTION_ID }}

      - name: Run Evaluation
        uses: microsoft/ai-agent-evals@v3-beta
        with:
          # Replace placeholders with values for your Foundry Project
          azure-ai-project-endpoint: "<your-ai-project-endpoint>"
          deployment-name: "<your-deployment-name>"
          agent-ids: "<your-ai-agent-ids>"
          data-path: ${{ github.workspace }}/path/to/your/data-file
Результаты оценки агента ИИ
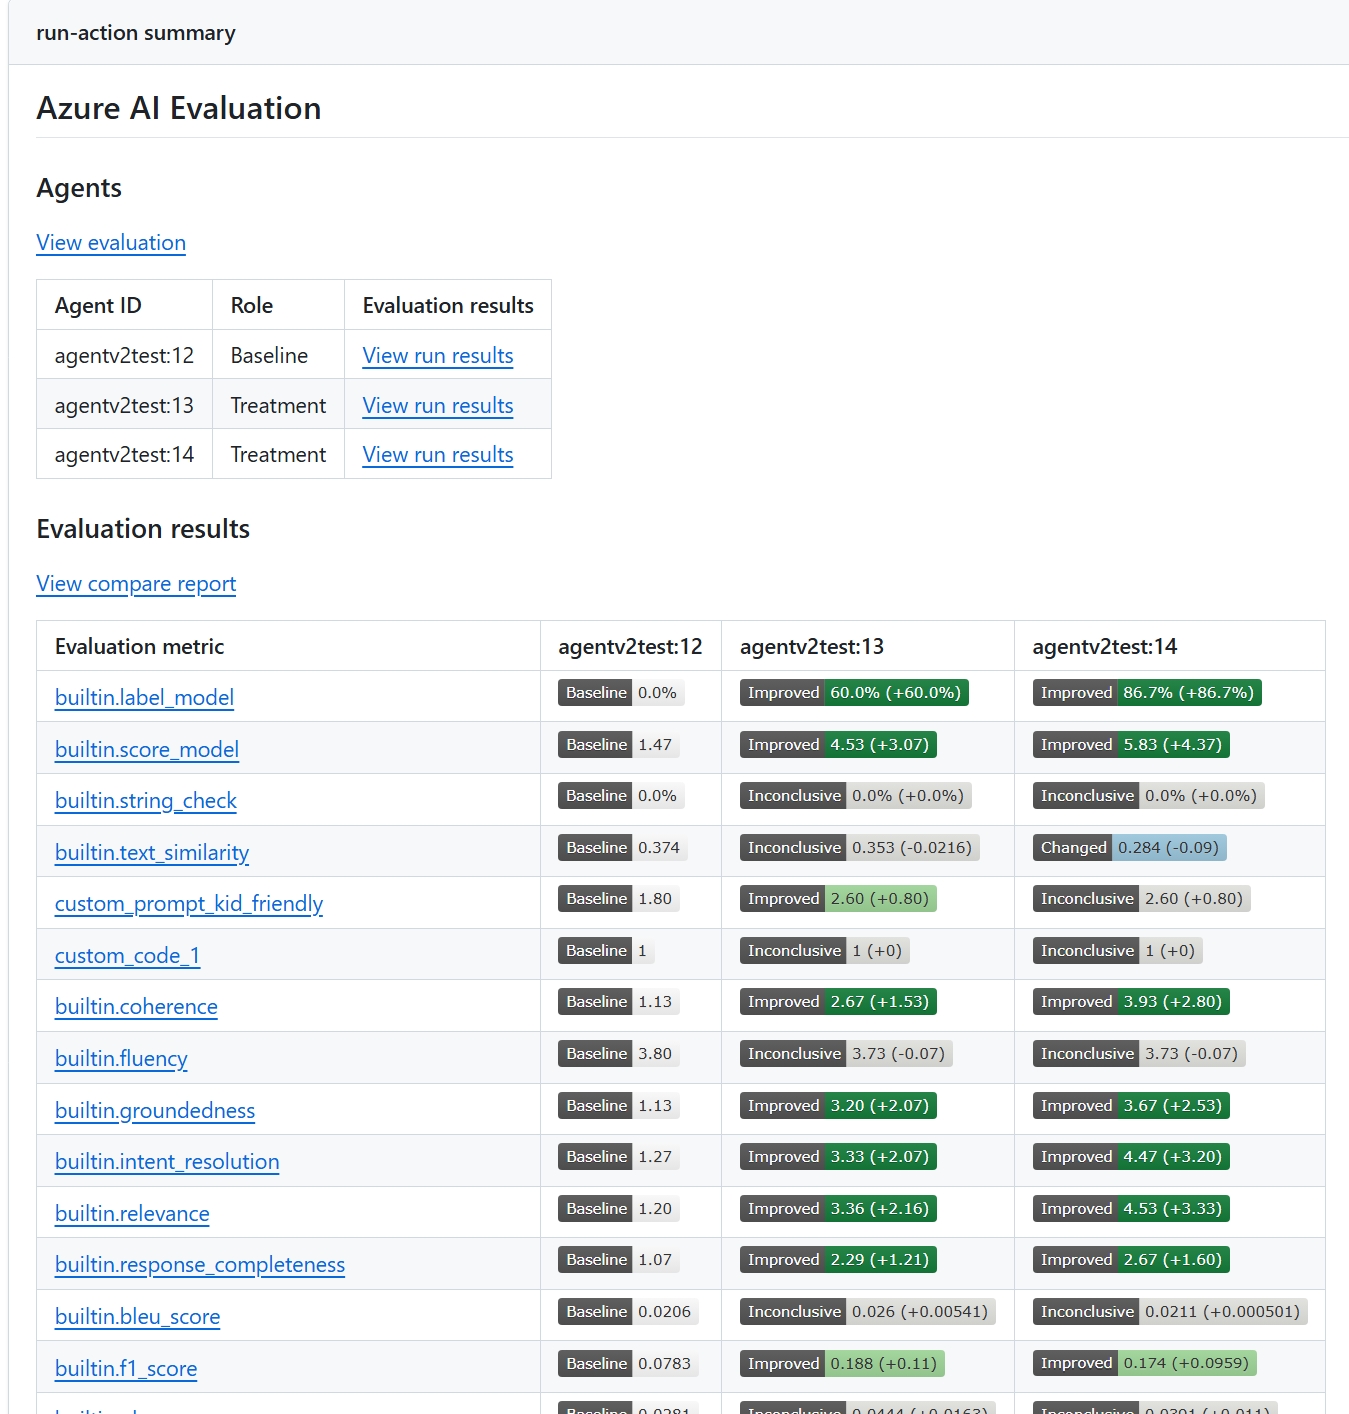
Результаты оценки выводятся в сводный раздел для каждого действия оценки ИИ GitHub, выполняемого в Actions в GitHub. В отчете показаны оценки для каждой метрики, доверительных интервалов и (при оценке нескольких агентов) парное статистическое сравнение, указывающее, являются ли различия значимыми или случайными вариантами.
На следующем снимке экрана показан пример отчета, сравнивающего два агента.