Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
Функциональные зависимости — это связи между столбцами в таблице, где значения в одном столбце определяют значения в другом столбце. Общие сведения об этих зависимостях помогут вам выявить закономерности и связи в данных. Это понимание может помочь в проектировании функций, очистке данных и задачах построения модели. Функциональные зависимости действуют как эффективная инвариантная, которая помогает находить и устранять проблемы с качеством данных, которые могут быть трудно обнаружить в противном случае.
В этой статье вы используете семантическую ссылку, чтобы:
- Найдите зависимости между столбцами FabricDataFrame
- Визуализация зависимостей
- Определение проблем с качеством данных
- Визуализация проблем с качеством данных
- Принудительное применение функциональных ограничений между столбцами в наборе данных
Предварительные требования
Получите подписку Microsoft Fabric. Или зарегистрируйте бесплатную пробную версию Microsoft Fabric.
Войдите в Microsoft Fabric.
Перейдите в Fabric с помощью переключателя интерфейса в левой нижней части домашней страницы.
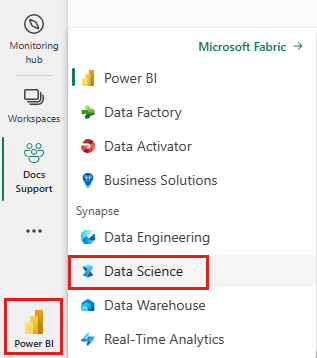
- Перейдите в интерфейс обработки и анализа данных, найденный в Microsoft Fabric.
- Создайте записную книжку для копирования и вставки кода в ячейки.
- Для Spark 3.4 и более поздних версий семантическая ссылка доступна в среде выполнения по умолчанию при использовании Fabric и не требуется устанавливать ее. Если вы используете Spark 3.3 или ниже или хотите обновить до последней версии семантической ссылки, можно выполнить следующую команду:
python %pip install -U semantic-link - Добавьте Lakehouse в блокнот.
Семантическая ссылка доступна в среде выполнения Fabric по умолчанию. Чтобы обновить последнюю версию семантической ссылки, выполните следующую команду:
%pip install -U semantic-link
Поиск функциональных зависимостей в данных
Функция SemPy find_dependencies обнаруживает функциональные зависимости между столбцами FabricDataFrame. Функция использует пороговое значение условной энтропии для обнаружения приблизительных функциональных зависимостей, где низкая условная энтропия указывает на сильную зависимость между столбцами. Чтобы сделать find_dependencies функцию более выборочной, задайте более низкое пороговое значение условной энтропии. Более низкий порог означает, что обнаруживаются только более сильные зависимости.
В этом фрагменте кода Python показано, как использовать find_dependencies:
from sempy.fabric import FabricDataFrame
from sempy.dependencies import plot_dependency_metadata
import pandas as pd


df = FabricDataFrame(pd.read_csv("your_data.csv"))

deps = df.find_dependencies()
Функция find_dependencies возвращает Объект FabricDataFrame с обнаруженными зависимостями между столбцами.
Список представляет столбцы с сопоставлением 1:1. Функция также удаляет транзитивные края, чтобы попытаться обрезать потенциальные зависимости.
При указании dropna=True параметра функция устраняет строки, имеющие значение NaN в любом столбце из оценки. Эта ликвидация может привести к нетранстивным зависимостям, как показано в следующем примере:
| А | Б | С |
|---|---|---|
| 1 | 1 | 1 |
| 1 | 1 | 1 |
| 1 | NaN | 9 |
| 2 | NaN | 2 |
| 2 | 2 | 2 |
В некоторых случаях цепочка зависимостей может формировать циклы при указании dropna=True параметра, как показано в следующем примере:
| А | Б | С |
|---|---|---|
| 1 | 1 | NaN |
| 2 | 1 | NaN |
| NaN | 1 | 1 |
| NaN | 2 | 1 |
| 1 | NaN | 1 |
| 1 | NaN | 2 |
Визуализация зависимостей в данных
После поиска функциональных зависимостей в наборе данных с помощью find_dependenciesplot_dependency_metadata функции можно визуализировать зависимости. Эта функция принимает результирующий FabricDataFrame из find_dependencies и создает визуальное представление зависимостей между столбцами и группами столбцов.
В этом фрагменте кода Python показано, как использовать plot_dependencies:
from sempy.fabric import FabricDataFrame
from sempy.dependencies import plot_dependency_metadata
from sempy.samples import download_synthea
import pandas as pd

download_synthea(which='small')

df = FabricDataFrame(pd.read_csv("synthea/csv/providers.csv"))

deps = df.find_dependencies()
plot_dependency_metadata(deps)
Функция plot_dependency_metadata создает визуализацию, отображающую группировку столбцов 1:1. Столбцы, принадлежащие одной группе, объединяются в одну ячейку. Если функция не находит подходящих кандидатов, она возвращает пустой FabricDataFrame.

Определение проблем с качеством данных
Проблемы с качеством данных могут принимать множество форм, например отсутствующие значения, несоответствия или неточности. Чтобы обеспечить надежность и допустимость любого анализа или модели, созданной на основе данных, важно определить и устранить эти проблемы. Одним из способов обнаружения проблем с качеством данных является изучение нарушений функциональных зависимостей между столбцами в наборе данных.
Эта list_dependency_violations функция поможет найти нарушения функциональных зависимостей между столбцами набора данных. При задании детерминирующего столбца и зависимого столбца функция показывает значения, которые нарушают функциональную зависимость, а также количество соответствующих вхождений. Эти сведения помогут вам проверить приблизительные зависимости и определить проблемы с качеством данных.
В следующем фрагменте кода показано, как использовать функцию list_dependency_violations :
from sempy.fabric import FabricDataFrame
from sempy.samples import download_synthea
import pandas as pd

download_synthea(which='small')

df = FabricDataFrame(pd.read_csv("synthea/csv/providers.csv"))

violations = df.list_dependency_violations(determinant_col="ZIP", dependent_col="CITY")
В этом примере функция предполагает функциональную зависимость между столбцами ZIP (детерминант) и CITY (зависимыми). Если набор данных имеет проблемы с качеством данных, например один и тот же ZIP-код, назначенный нескольким городам, функция выводит данные с проблемами:
| ЗИП | ГОРОД | подсчет |
|---|---|---|
| 12345 | Бостон | 2 |
| 12345 | Сиэтл | 1 |
Это означает, что два разных города (Бостон и Сиэтл) имеют одно и то же значение ZIP-кода (12345). В результате в наборе данных возникает проблема с качеством данных.
Функция list_dependency_violations предоставляет дополнительные параметры, которые могут обрабатывать отсутствующие значения, отображать значения, сопоставленные с нарушением значений, ограничивать количество возвращенных нарушений и сортировать результаты по подсчету или детерминированному столбцу.
Выходные list_dependency_violations данные помогут определить проблемы с качеством данных в наборе данных. Однако следует тщательно изучить результаты и рассмотреть контекст данных, чтобы определить наиболее подходящий курс действий для решения выявленных проблем. Этот подход может включать в себя больше очистки, проверки или исследования данных, чтобы обеспечить надежность и допустимость анализа или модели.
Визуализация проблем с качеством данных
Проблемы с качеством данных могут повредить надежности и действительности любого анализа или модели, созданной на основе этих данных. Определение и устранение этих проблем важно для обеспечения точности результатов. Чтобы обнаружить проблемы с качеством данных, изучите нарушения функциональных зависимостей между столбцами в наборе данных. Визуализация этих нарушений может показать проблемы более четко, и помочь вам решить их более эффективно.
Функция plot_dependency_violations может помочь визуализировать нарушения функциональных зависимостей между столбцами в наборе данных. Учитывая детерминированный столбец и зависимый столбец, эта функция показывает нарушения значений в графическом формате, чтобы упростить понимание характера и степени проблем качества данных.
В этом фрагменте кода показано, как использовать функцию plot_dependency_violations :
from sempy.fabric import FabricDataFrame
from sempy.samples import download_synthea
import pandas as pd

download_synthea(which='small')

df = FabricDataFrame(pd.read_csv("synthea/csv/providers.csv"))

df.plot_dependency_violations(determinant_col="ZIP", dependent_col="CITY")
В этом примере функция предполагает существующую функциональную зависимость между столбцами ZIP (детерминант) и CITY (зависимыми). Если набор данных имеет проблемы с качеством данных , например, один и тот же ZIP-код, назначенный нескольким городам, функция создает граф нарушений значений.
Функция plot_dependency_violations предоставляет дополнительные параметры, которые могут обрабатывать отсутствующие значения, отображать значения, сопоставленные с нарушением значений, ограничивать количество возвращенных нарушений и сортировать результаты по подсчету или детерминированному столбцу.
Функция plot_dependency_violations создает визуализацию, которая может помочь определить проблемы с качеством данных набора данных. Однако следует тщательно изучить результаты и рассмотреть контекст данных, чтобы определить наиболее подходящий курс действий для решения выявленных проблем. Этот подход может включать в себя больше очистки, проверки или исследования данных, чтобы обеспечить надежность и допустимость анализа или модели.

Принудительное применение функциональных ограничений
Качество данных имеет решающее значение для обеспечения надежности и допустимости любого анализа или модели, созданного на основе набора данных. Применение функциональных ограничений между столбцами в наборе данных может помочь улучшить качество данных. Функциональные ограничения гарантируют, что связи между столбцами имеют точность и согласованность, что может привести к более точному анализу или результатам модели.
Функция drop_dependency_violations применяет функциональные ограничения между столбцами в наборе данных. Он удаляет строки, которые нарушают заданное ограничение. Учитывая детерминированный столбец и зависимый столбец, эта функция удаляет строки со значениями, которые не соответствуют функциональному ограничению между двумя столбцами.
В этом фрагменте кода показано, как использовать функцию drop_dependency_violations :
from sempy.fabric import FabricDataFrame
from sempy.samples import download_synthea
import pandas as pd

download_synthea(which='small')

df = FabricDataFrame(pd.read_csv("synthea/csv/providers.csv"))

cleaned_df = df.drop_dependency_violations(determinant_col="ZIP", dependent_col="CITY")
В этом примере функция применяет функциональное ограничение между столбцами ZIP (determinant) и CITY (зависимыми). Для каждого значения детерминированного функция выбирает наиболее распространенное значение зависимого столбца и удаляет все строки с другими значениями. Например, учитывая этот набор данных, строка с CITY=Seattle удаляется, и в выходных данных соблюдается функциональная зависимость ZIP -> CITY.
| ЗИП | ГОРОД |
|---|---|
| 12345 | Сиэтл |
| 12345 | Бостон |
| 12345 | Бостон |
| 98765 | Балтимор |
| 00000 | Сан-Франциско |
Функция drop_dependency_violations предоставляет verbose возможность управления подробностью вывода. Задав параметр verbose=1, можно увидеть количество удаленных строк. Значение verbose=2 показывает все содержимое всех удаленных строк.
Функция drop_dependency_violations может применять функциональные ограничения между столбцами в наборе данных, что может помочь улучшить качество данных и привести к более точным результатам анализа или модели. Однако внимательно рассмотрим контекст данных и функциональные ограничения, которые вы решили применить, чтобы убедиться, что вы не случайно удалите ценные сведения из набора данных.