Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
Используйте функциональные зависимости для очистки данных. Функциональная зависимость существует, если один столбец в семантической модели (набор данных Power BI) зависит от другого столбца. Например, ZIP code столбец может определить значение в столбце city . Функциональная зависимость отображается как связь "один ко многим" между значениями в двух или нескольких столбцах.DataFrame В этом руководстве используется набор данных Synthea, чтобы показать, как функциональные зависимости помогают обнаруживать проблемы с качеством данных.
В этом руководстве описано, как:
- Применение знаний домена для формирования гипотез о функциональных зависимостях в семантической модели.
- Ознакомьтесь с компонентами библиотеки Python семантической компоновки (SemPy), которая автоматизирует анализ качества данных. К этим компонентам относятся:
-
FabricDataFrame— структура, похожая на pandas, с дополнительной семантической информацией. - Функции, автоматизирующие оценку гипотез о функциональных зависимостях и выявления нарушений в семантических моделях.
-
Необходимые условия
Получите подписку Microsoft Fabric. Или зарегистрируйте бесплатную пробную версию Microsoft Fabric.
Войдите в Microsoft Fabric.
Перейдите в Fabric с помощью переключателя интерфейса в левой нижней части домашней страницы.
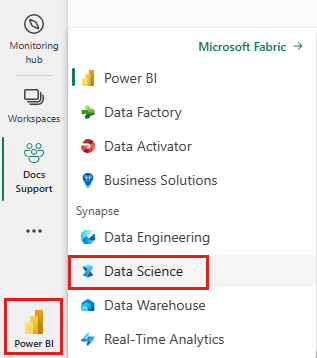
- Выберите рабочие области в области навигации, а затем выберите рабочую область, чтобы задать ее в качестве текущей рабочей области.
Следуйте инструкциям в записной книжке
Используйте записную книжку data_cleaning_functional_dependencies_tutorial.ipynb , чтобы следовать этому руководству.
Чтобы открыть сопровождающую записную книжку для этого руководства, следуйте инструкциям в подготовьте вашу систему для руководств по науке о данных для импорта записной книжки в ваше рабочее пространство.
Если вы хотите скопировать и вставить код на этой странице, можно создать новую записную книжку.
Перед запуском кода обязательно подключите lakehouse к записной книжке .
Настройка записной книжки
В этом разделе описана настройка среды записной книжки.
Проверьте версию Spark. Если вы используете Spark 3.4 или более поздней версии в Microsoft Fabric, семантическая ссылка включена по умолчанию, поэтому ее не нужно устанавливать. Если вы используете Spark 3.3 или более ранних версий или хотите обновить до последней семантической ссылки, выполните следующую команду.
%pip install -U semantic-linkИмпортируйте модули, используемые в этой записной книжке.
import pandas as pd
import sempy.fabric as fabric
from sempy.fabric import FabricDataFrame
from sempy.dependencies import plot_dependency_metadata
Скачайте примеры данных. В этом руководстве используйте набор данных Synthea синтетических медицинских записей (небольшая версия для простоты).
download_synthea(which='small')
Изучение данных
Инициализировать
FabricDataFrameсодержимое файлаproviders.csv .providers = FabricDataFrame(pd.read_csv("synthea/csv/providers.csv")) providers.head()Проверьте наличие проблем с качеством данных функции SemPy
find_dependencies, настроив граф автоопределенных функциональных зависимостей.deps = providers.find_dependencies() plot_dependency_metadata(deps)
График показывает, что
IdопределяетNAMEиORGANIZATION. Этот результат ожидается, так какIdэто уникально.Убедитесь, что
Idэто уникально.providers.Id.is_uniqueКод возвращает
Trueдля подтверждения уникальностиId.

Подробный анализ функциональных зависимостей
График функциональных зависимостей также показывает, что ORGANIZATION определяет ADDRESS и ZIP, как ожидалось. Однако вы можете ожидать, что ZIP также определяет CITY, но пунктирная стрелка указывает, что зависимость является только приблизительной, указывая на проблему качества данных.
В графе существуют и другие особенности. Например, NAME не определяет GENDER, Id, SPECIALITYили ORGANIZATION. Каждое из этих особенностей может быть стоит исследовать.
- Более подробно рассмотрим приблизительную связь между
ZIPCITYи с помощью функции SemPylist_dependency_violationsдля перечисления нарушений:
providers.list_dependency_violations('ZIP', 'CITY')
- Нарисуйте граф с помощью функции визуализации
plot_dependency_violationsSemPy. Этот график полезен, если количество нарушений невелико:
providers.plot_dependency_violations('ZIP', 'CITY')

На графике нарушений зависимостей отображаются значения ZIP на левой стороне и значения для CITY правой стороны. Ребро соединяет zip-код на левой стороне графика с городом на правой стороне, если существует строка, содержащая эти два значения. Края аннотированы с количеством таких строк. Например, есть две строки с почтовым кодом 02747-1242, одна строка с городом "NORTH DARTHMOUTH" и другой с городом "DARTHMOUTH", как показано в предыдущем графике и следующем коде:
- Подтвердите наблюдения на графике, выполнив следующий код:
providers[providers.ZIP == '02747-1242'].CITY.value_counts()
На графике также показано, что среди строк, имеющих
CITYзначение "DARTHMOUTH", девять строк имеютZIP02747-1262. Одна строка имеетZIPзначение 02747-1242. Одна строка имеетZIPзначение 02747-2537. Подтвердите эти наблюдения с помощью следующего кода:providers[providers.CITY == 'DARTHMOUTH'].ZIP.value_counts()Существуют другие zip-коды, связанные с DARTMOUTH, но эти zip-коды не отображаются в графе нарушений зависимостей, так как они не указывают на проблемы с качеством данных. Например, почтовый индекс "02747-4302" однозначно связан с "DARTMOUTH" и не отображается в графе нарушений зависимостей. Подтвердите, выполнив следующий код:
providers[providers.ZIP == '02747-4302'].CITY.value_counts()
Сводка проблем с качеством данных, обнаруженных с помощью SemPy
Граф нарушений зависимостей показывает несколько проблем с качеством данных в этой семантической модели:
- Некоторые названия городов являются верхним регистром. Используйте строковые методы для устранения этой проблемы.
- Некоторые имена городов имеют квалификаторы (или префиксы), такие как "Север" и "Восток". Например, ZIP-код "2128" сопоставляется с "East BOSTON" один раз и "БОСТОН" один раз. Аналогичная проблема возникает между "NORTH DARTMOUTH" и "DARTMOUTH". Удалите эти квалификаторы или сопоставите ZIP-коды с городом с наиболее распространенным вхождением.
- В некоторых названиях городов есть опечатки, такие как "PITTSFIELD" и "PITTSFILED" и "NEWBURGPORT" и "NEWBURYPORT". Для "NEWBURGPORT", исправьте этот опечаток с помощью наиболее распространенного вхождения. Для "PITTSFIELD", с одним вхождением каждый, автоматическая диамбигуация гораздо сложнее без внешних знаний или языковой модели.
- Иногда префиксы, такие как "Запад", сокращены до одной буквы "W". Замените "W" на "Запад", если все вхождения "W" стоят на "Запад".
- Почтовый индекс "02130" сопоставляется с "БОСТОН" один раз и "Ямайка равнина" один раз. Эта проблема не легко исправить. С большими данными сопоставляется с наиболее распространенным вхождением.
Очистка данных
Исправьте заглавную букву, изменив значения в регистр заголовка.
providers['CITY'] = providers.CITY.str.title()Снова выполните обнаружение нарушений, чтобы убедиться, что существует меньше неоднозначности.
providers.list_dependency_violations('ZIP', 'CITY')
Измените данные вручную или удалите строки, которые нарушают функциональные ограничения между столбцами с помощью функции SemPy drop_dependency_violations .
Для каждого значения детерминированной переменной выбирает наиболее распространенное значение зависимой переменной drop_dependency_violations и удаляет все строки с другими значениями. Примените эту операцию только в том случае, если вы уверены, что эта статистическая эвристика приводит к исправлению результатов для данных. В противном случае напишите собственный код для обработки обнаруженных нарушений.
Запустите функцию
drop_dependency_violationsвZIPстолбцах иCITYстолбцах.providers_clean = providers.drop_dependency_violations('ZIP', 'CITY')Перечисление любых нарушений зависимостей между
ZIPиCITY.providers_clean.list_dependency_violations('ZIP', 'CITY')
Код возвращает пустой список, указывающий на отсутствие дополнительных нарушений функционального ограничения ZIP -> CITY.
Связанное содержимое
См. другие руководства по семантической ссылке или SemPy:
- Руководство. Анализ функциональных зависимостей в примере семантической модели
- Руководство. Извлечение и вычисление мер Power BI из записной книжки Jupyter
- Руководство. Обнаружение связей в семантической модели с помощью семантической ссылки
- Руководство. Обнаружение связей в наборе данных Synthea с помощью семантической ссылки
- Руководство по проверке данных с помощью SemPy и больших ожиданий (GX)