Poznámka
Na prístup k tejto stránke sa vyžaduje oprávnenie. Môžete sa skúsiť prihlásiť alebo zmeniť adresáre.
Na prístup k tejto stránke sa vyžaduje oprávnenie. Môžete skúsiť zmeniť adresáre.
Tip
Power BI Dataflow Gen1 je teraz v legacy stave a nedostane investície do nových funkcií. Pre prémiových zákazníkov s prístupom k Fabric je odporúčanou cestou Dataflow Gen2 , ktorá ponúka zlepšenia vo výkone, škálovateľnosti, spoľahlivosti, funkčnosti a zabudovanej AI. Pro/PPU zákazníci môžu naďalej používať Gen1, keďže usmernenia Gen2 pre tieto scenáre sa vyvíjajú. Pozrite si Upgrade z Dataflow Gen1 na Dataflow Gen2 pre odporúčania k aktualizácii.
Navrhovanie dimenzionálneho modelu je jednou z najčastejších úloh, ktoré môžete s tokom údajov vykonávať. V tomto článku sa zvýrazňujú niektoré z najlepších postupov pri vytváraní dimenzionálneho modelu pomocou toku údajov.
Pracovná pracovná toky údajov
Jedným z kľúčových bodov v každom systéme integrácie údajov je zníženie počtu prečítaných bodov zo zdrojového operačného systému. V tradičnej architektúre integrácie údajov sa toto zníženie vykoná vytvorením novej databázy s názvom staging database. Účelom vnášanej databázy je načítať údaje as-is zo zdroja údajov do vnášačnej databázy pravidelne.
Zvyšok integrácie dát potom používa staging databázu ako zdroj pre ďalšiu transformáciu a konvertuje ju na dimenzionálnu modelovú štruktúru.
Odporúčame, aby ste postup mali rovnaký postup pri používaní tokov údajov. Vytvorenie množiny tokov údajov, ktoré zodpovedajú len za načítanie údajov as-is zo zdrojového systému (a len za tabuľky, ktoré potrebujete). Výsledok sa potom uloží do štruktúry úložiska toku údajov (buď Azure Data Lake Storage, alebo Dataverse). Táto zmena zabezpečí, že operácia čítania zo zdrojového systému je minimálna.
V ďalšom kroku môžete vytvoriť ďalšie toky údajov, ktoré získavajú ich údaje z pracovnej verzie tokov údajov. Medzi výhody tohto prístupu patria:
- Zníži počet operácií čítania zo zdrojového systému a zníži zaťaženie zdrojového systému.
- Zníženie zaťaženia brán údajov pri použití lokálneho zdroja údajov.
- Vytvorenie priebežnej kópie údajov na účely zosúladenia v prípade zmien zdrojových systémových údajov.
- Vytvorenie zdrojového zdroja transformácie tokov údajov.
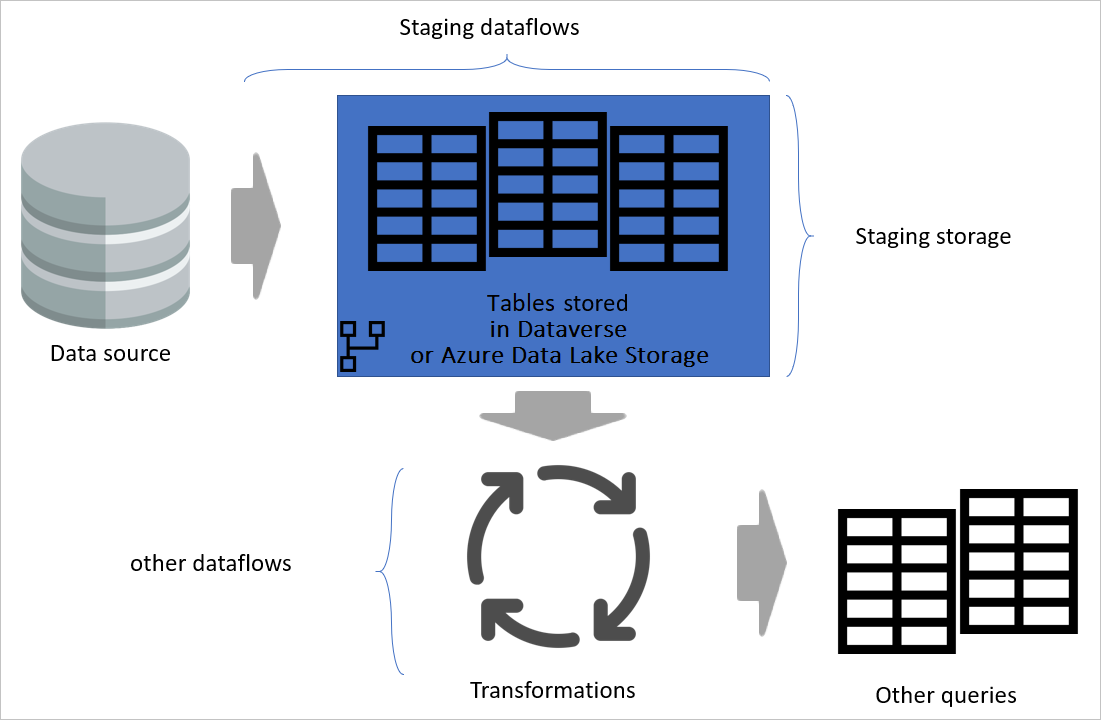
Diagram zdôrazňujúci staging dátové toky a staging úložisko. Diagram ukazuje, že dáta sú prístupné zo zdroja dát pomocou staging dataflow a tabuľky sú uložené buď v Cadavers alebo Azure Data Lake Storage. Zobrazí sa transformácia tabuliek spolu s inými tokmi údajov, ktoré sa potom odosielajú ako dotazy.
Transformácia tokov údajov
Keď oddelíte transformačné dátové toky od staging dátových tokov, transformácia je nezávislá od zdroja. Toto oddelenie pomáha vtedy, keď migrujete zdrojový systém do nového systému. V takom prípade stačí zmeniť fázové toky údajov. Toky údajov transformácie budú pravdepodobne fungovať bez problémov, pretože pochádzajú len z pracovných tokov údajov.
Toto oddelenie pomáha aj v prípade, že zdrojové systémové pripojenie je pomalé. Transformačný dataflow nemusí dlho čakať, kým záznamy prídu cez pomalé spojenie zo zdrojového systému. Staging dataflow už túto časť urobil a dáta sú pripravené na transformačnú vrstvu.

Vrstvená architektúra
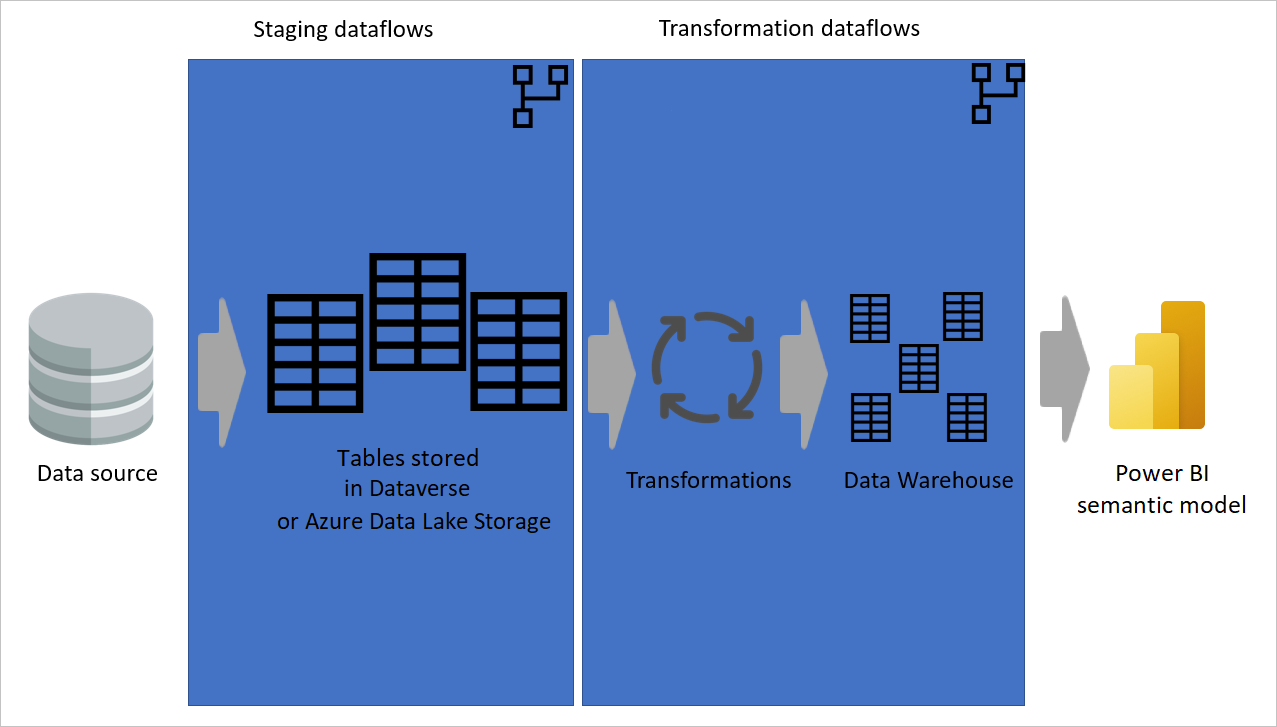
Vrstvená architektúra je architektúra, v ktorej vykonávate akcie v samostatných vrstvách. Fázové a transformačné toky údajov môžu byť dve vrstvy viacvrstvovej architektúry toku údajov. Pokusom o činnosti vo vrstvách sa zabezpečí minimálna požadovaná údržba. Keď chcete niečo zmeniť, stačí to zmeniť vo vrstve, kde sa to nachádza. Ostatné vrstvy by mali naďalej fungovať dobre.
Na nasledujúcom obrázku je znázornená viacvrstvová architektúra pre toky údajov, v ktorej sa ich tabuľky potom používajú v sémantických modeloch služby Power BI.
Použitie vypočítanej tabuľky v čo najväčšej možnej miere
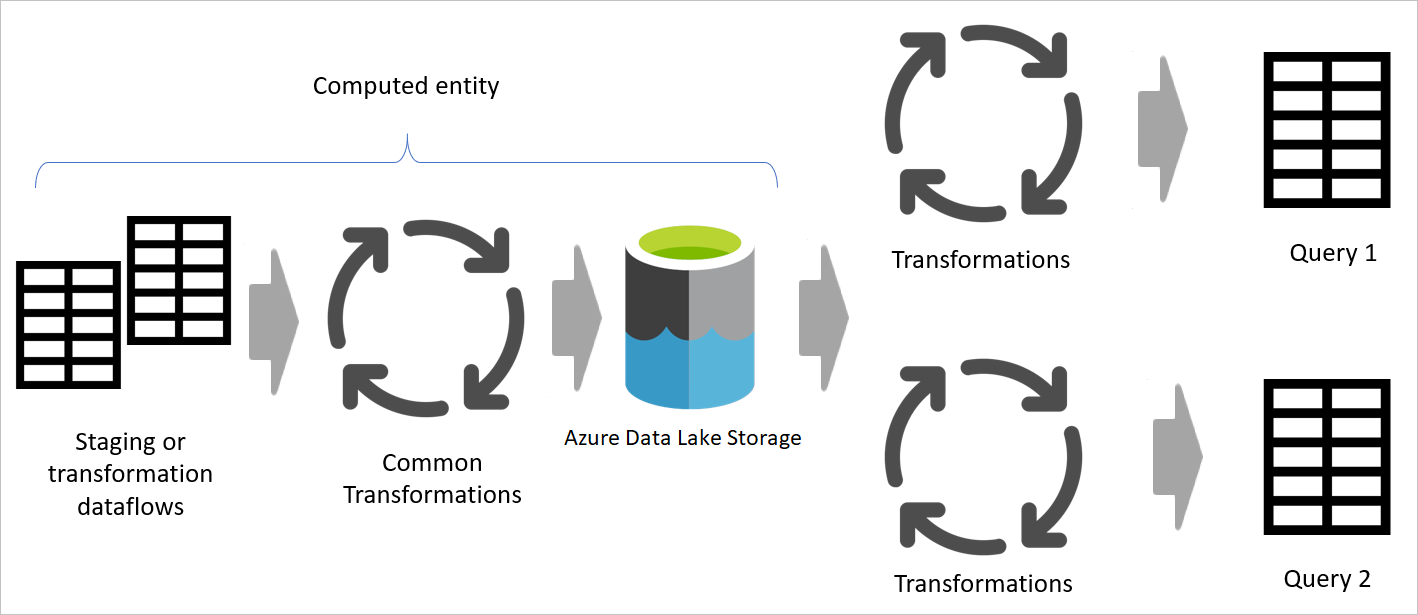
Keď použijete výsledok toku údajov v inom toku údajov, používate koncept vypočítanej tabuľky, čo znamená získanie údajov z už spracovanej a uloženej tabuľky. To isté sa môže stať v rámci toku údajov. Keď odkazujete na tabuľku z inej tabuľky, môžete použiť vypočítanú tabuľku. Táto metóda je užitočná, keď máte súbor transformácií, ktoré je potrebné vykonať vo viacerých tabuľkách, ktoré sa nazývajú spoločné transformácie.

Na predchádzajúcom obrázku vypočítaná tabuľka načíta údaje priamo zo zdroja. V architektúre prechodu a transformácie tokov údajov je však pravdepodobné, že vypočítané tabuľky pochádzajú z prechodných tokov údajov.
Vytvorenie hviezdicovej schémy
Najlepší dimenzionálny model je model hviezdicovej schémy, ktorý má dimenzie a faktové tabuľky navrhnuté tak, aby minimalizovali čas potrebný na dotazovanie dát z modelu. Model hviezdicovej schémy tiež uľahčuje pochopenie pre vizualizér dát.
Nie je ideálne preniesť údaje s rovnakým rozložením operačného systému do systému BI. Tabuľky údajov by sa mali rekonštruovať. Niektoré tabuľky by mali mať tvar tabuľky dimenzií, ktorá uchováva popisné informácie. Niektoré tabuľky by mali mať tvar tabuľky faktov, aby sa udržali agregovateľné údaje. Najlepšie rozloženie pre tabuľky faktov a tabuľky dimenzií, ktoré sa majú vytvoriť, je hviezdicová schéma. Pre viac informácií navštívte stránku Pochopte hviezdičkovú schému a jej význam pre Power BI.

Použitie jedinečnej hodnoty kľúča pre dimenzie
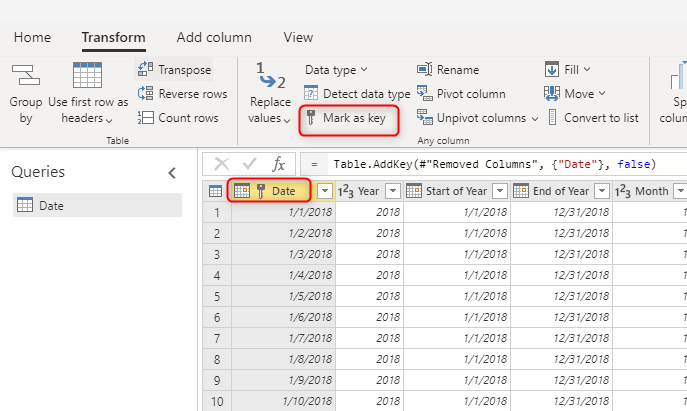
Pri vytváraní tabuliek dimenzií sa uistite, že máte pre každú z nich kľúč. Tento kľúč zabezpečí, že medzi dimenziami neexistujú žiadne vzťahy typu many-to-many (alebo inými slovami "slabý"). Kľúč môžete vytvoriť použitím niektorých transformácií, aby ste sa uistili, že stĺpec alebo kombinácia stĺpcov vracia jedinečné riadky v dimenzii. Potom je možné túto kombináciu stĺpcov označiť ako kľúč v tabuľke v toku údajov.
Vykonanie prírastkového obnovenia pre veľké tabuľky faktov
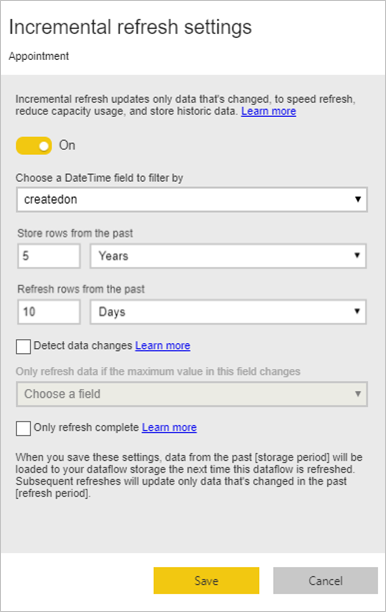
Tabuľky faktov sú vždy najväčšími tabuľkami v dimenzionálnom modeli. Odporúčame vám znížiť počet riadkov prenášaných pre tieto tabuľky. Ak máte veľmi veľkú tabuľku faktov, uistite sa, že pre danú tabuľku používate prírastkové obnovenie. Prírastkové obnovenie sa dá vykonať v sémantickom modeli služby Power BI a tiež v tabuľkách toku údajov.
Môžete použiť inkrementálne obnovenie len na obnovenie časti dát, tej, ktorá sa zmenila. Existuje viacero možností, ako vybrať, ktorá časť údajov sa má obnoviť a ktorá časť sa má zachovať. Pre viac informácií choďte na Používanie inkrementálneho obnovovania s Power BI dataflows.
Odkazovanie na vytvorenie dimenzií a tabuliek faktov
V zdrojovom systéme máte často tabuľku, ktorú používate na generovanie tabuliek faktov aj dimenzií v sklade údajov. Tieto tabuľky sú vhodnými kandidátmi na vypočítané tabuľky a aj priebežné toky údajov. Bežnú časť procesu, ako je napríklad čistenie údajov a odstránenie ďalších riadkov a stĺpcov, možno vykonať raz. Pomocou odkazu z výstupu týchto akcií môžete vytvoriť tabuľky dimenzií a faktov. Tento prístup používa vypočítanú tabuľku pre bežné transformácie.