opomba,
Dostop do te strani zahteva pooblastilo. Poskusite se vpisati alispremeniti imenike.
Dostop do te strani zahteva pooblastilo. Poskusite lahko spremeniti imenike.
Microsoft Common Data Service ponuja abstrakcijo, ki omogoča delo s katero koli vrsto podatkov, vključno z relacijskimi, nerelacijskimi, slikovnimi, datotekami, relativnim iskanjem ali podatkovnim jezerom. Ni potrebe po razumevanju vrste podatkov, saj Common Data Service razkriva nabor podatkovnih tipov, ki vam omogočajo izdelavo modela. Vrsta shrambe je optimizirana za izbrano vrsto podatkov.
Podatke lahko preprosto uvozite in izvozite s tokovi podatkov, dodatkom Power Query in storitvijo Azure Data Factory. Stranke storitve Dynamics lahko uporabljajo tudi storitev izvoza podatkov.
Common Data Service ima tudi povezovalnik za Power Automate in Azure Logic Apps, ki ga je mogoče uporabiti s stotinami drugih povezovalnikov v teh storitvah za storitve na mestu uporabe, infrastrukturo kot storitev (IaaS), platformo kot storitev (PaaS) ali programsko opremo kot storitev (SaaS). To vključuje vire v storitvah Azure, Microsoft 365, Dynamics 365, SAP ERP, Salesforce, Amazon Redshift, Access, Excel, besedilo/CSV, SharePointovi seznami, zbirke podatkov strežnika SQL Server, Oracle, MySQL, PostgreSQL, Blockchain in Azure Synapse Analytics.
Common Data Model
Če ste kdaj morali združiti podatke iz več sistemov in aplikacij, veste, kako draga in dolgotrajna naloga je to lahko. Brez možnosti enostavne skupne rabe in razumevanja istih podatkov vsaka aplikacija ali projekt integracije podatkov zahteva izvedbo po meri.
Common Data Model zagotavlja referenčno arhitekturo, ki je namenjena poenostavitvi tega postopka z zagotavljanjem podatkovnega jezika v skupni rabi za poslovne in analitične aplikacije. Sistem metapodatkov Common Data Model omogoča skupno rabo podatkov in njihovega pomena v aplikacijah in poslovnih procesih, kot so Power Apps, Power BI, Dynamics 365 in Azure.
Common Data Model vključuje nabor standardiziranih, razširljivih podatkovnih shem, ki so jih objavili Microsoft in njegovi partnerji. Ta zbirka vnaprej določenih shem vključuje tabele, atribute, semantične metapodatke in relacije. Sheme predstavljajo pogosto uporabljene koncepte in dejavnosti, kot sta račun in oglaševalska akcija, za poenostavitev ustvarjanja, združevanja in analize podatkov.
Sheme skupnega podatkovnega modela se lahko uporabijo za obveščanje o ustvarjanju tabel v storitvi Common Data Service. Nastale tabele bodo nato združljive z aplikacijami in analitiko, ki ciljajo na to definicijo skupnega podatkovnega modela.
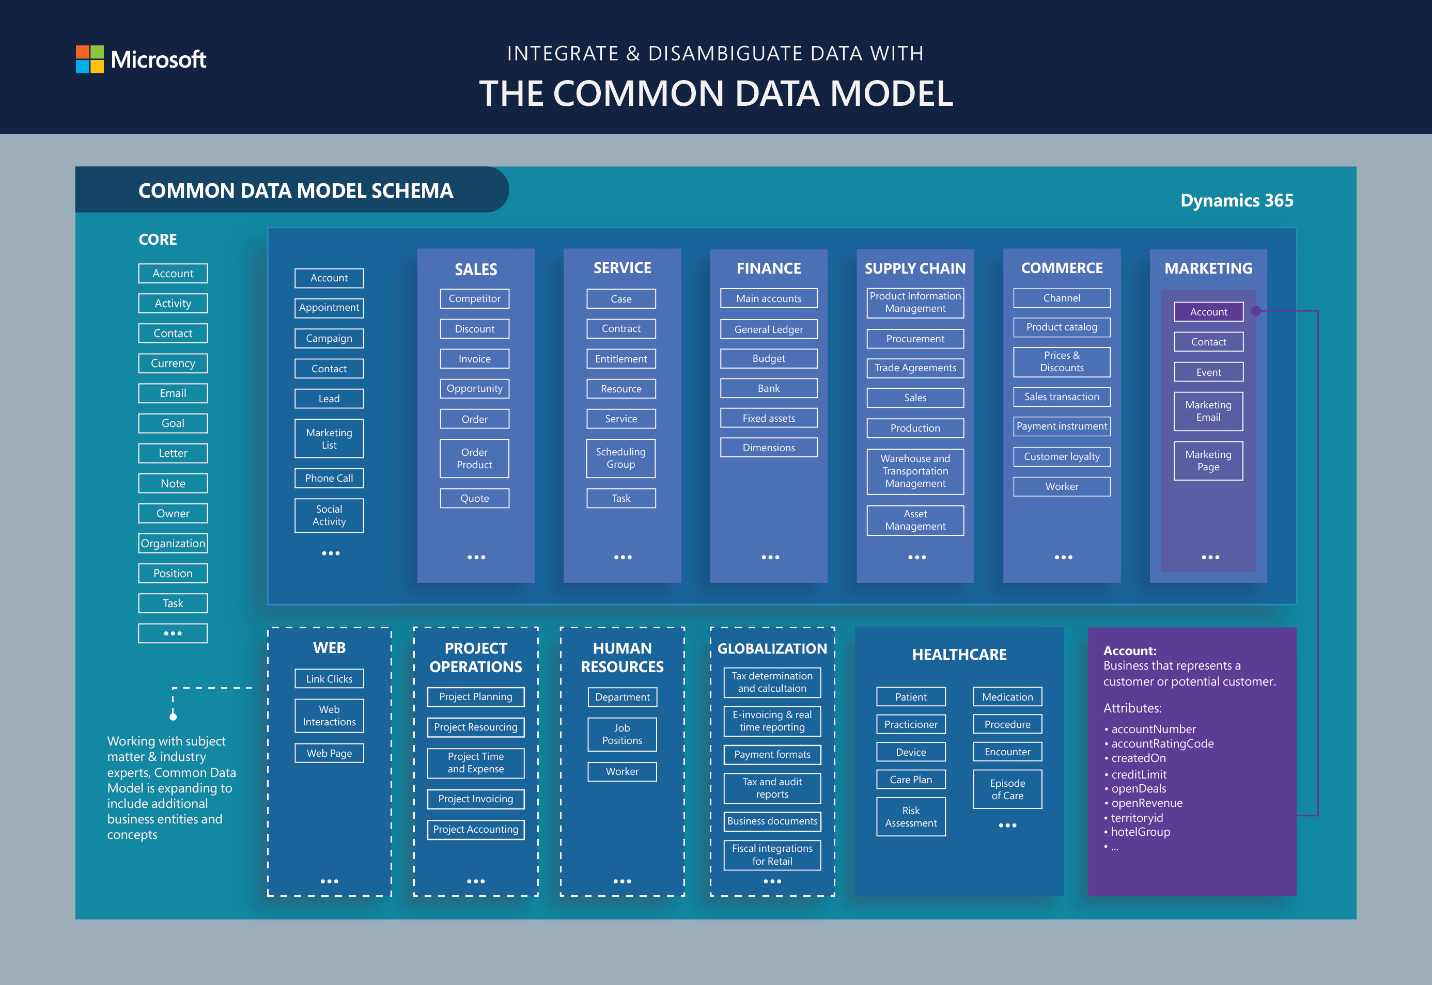
Na spodnji sliki so prikazani nekateri elementi standardnih tabel skupnega podatkovnega modela.
tabele,
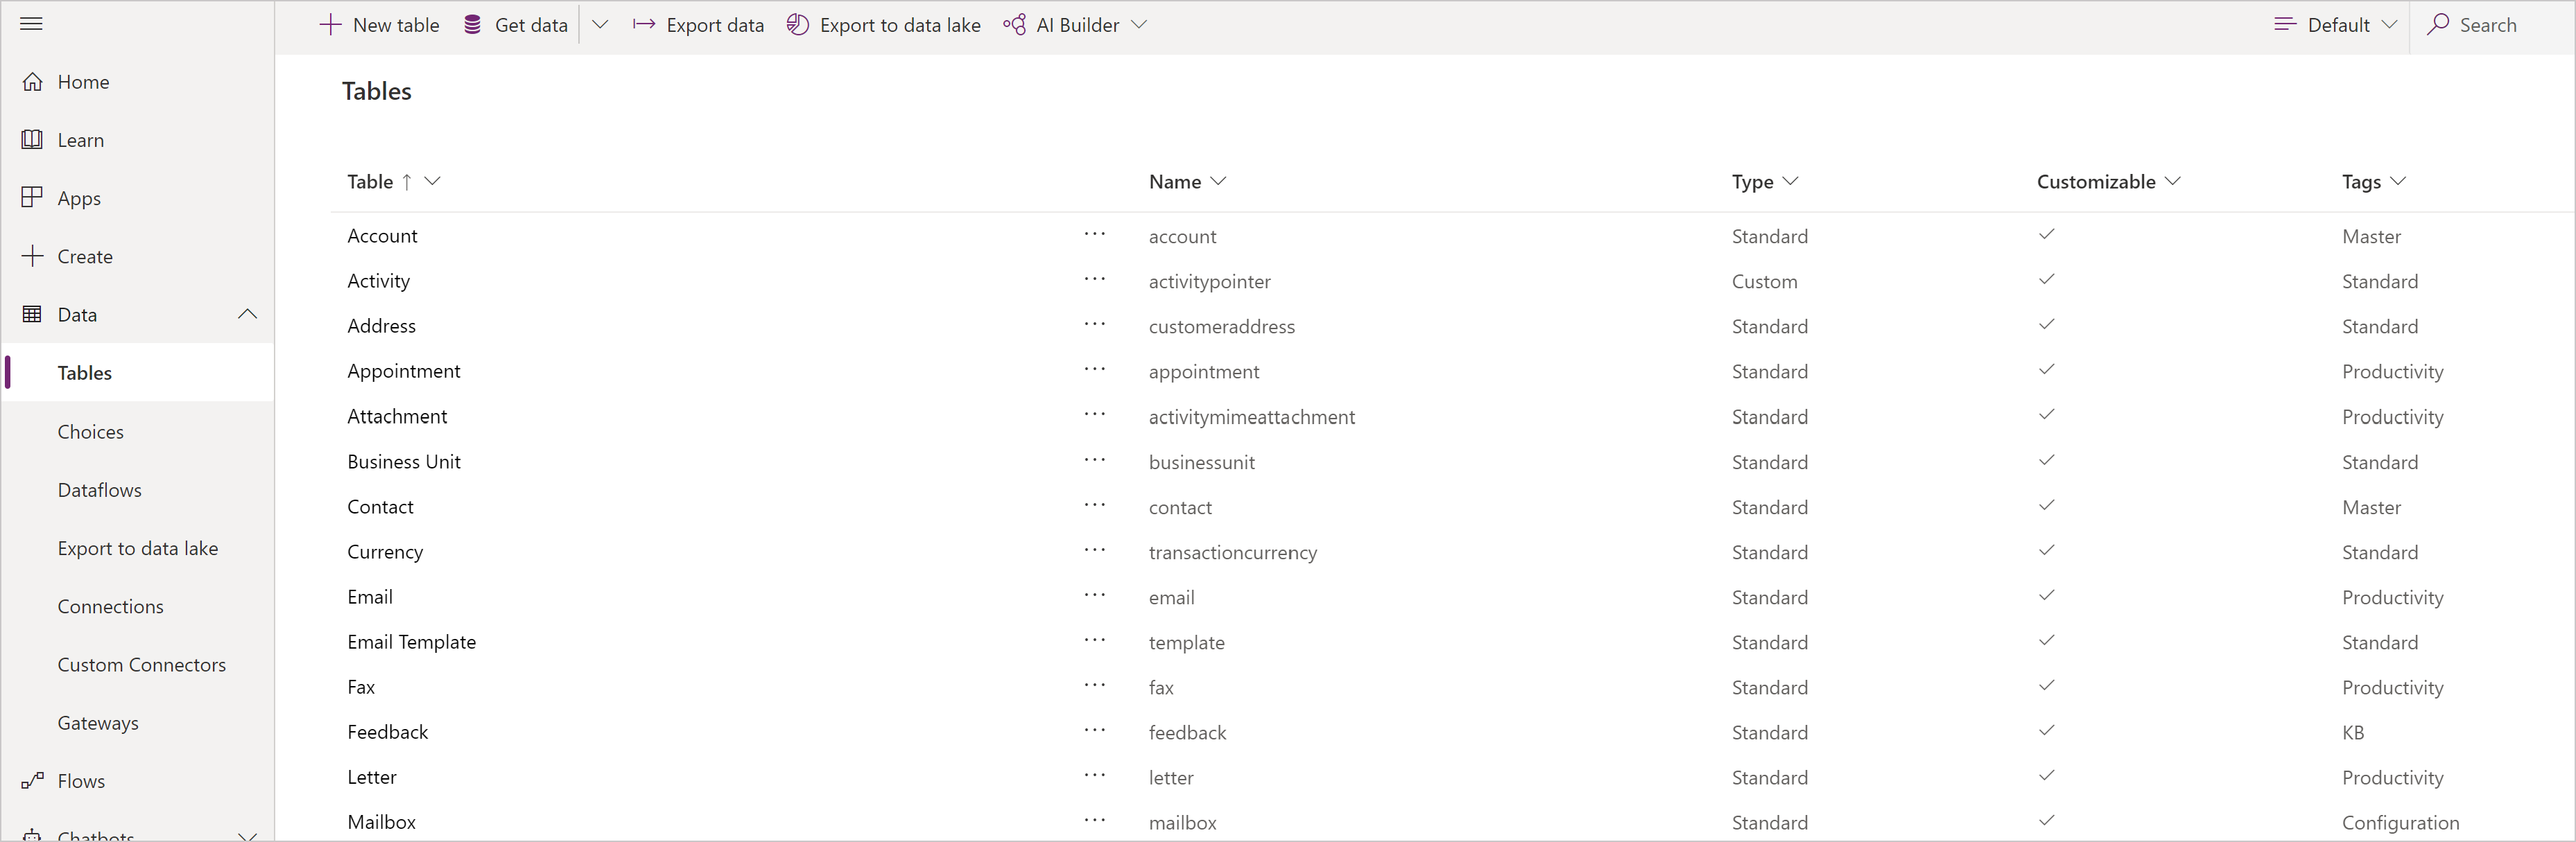
V storitvi Common Data Service se tabele uporabljajo za modeliranje in upravljanje poslovnih podatkov. Za povečanje produktivnosti Common Data Service vključuje nabor tabel, imenovanih standardne tabele. Te tabele so zasnovane v skladu z najboljšimi praksami, da zajamejo najpogostejše koncepte in scenarije v organizaciji. Standardne tabele so v skladu s skupnim podatkovnim modelom.
Nabor tabel, ki se pogosto uporabljajo v različnih panogah, kot sta Uporabnik in Skupina, je vključen v Common Data Service in se imenuje standardne tabele. Te vnaprej pripravljene tabele lahko tudi prilagodite, na primer vključite dodatne stolpce. Poleg tega lahko v storitvi Common Data Service preprosto ustvarite lastne tabele po meri.
Št. stolpcev
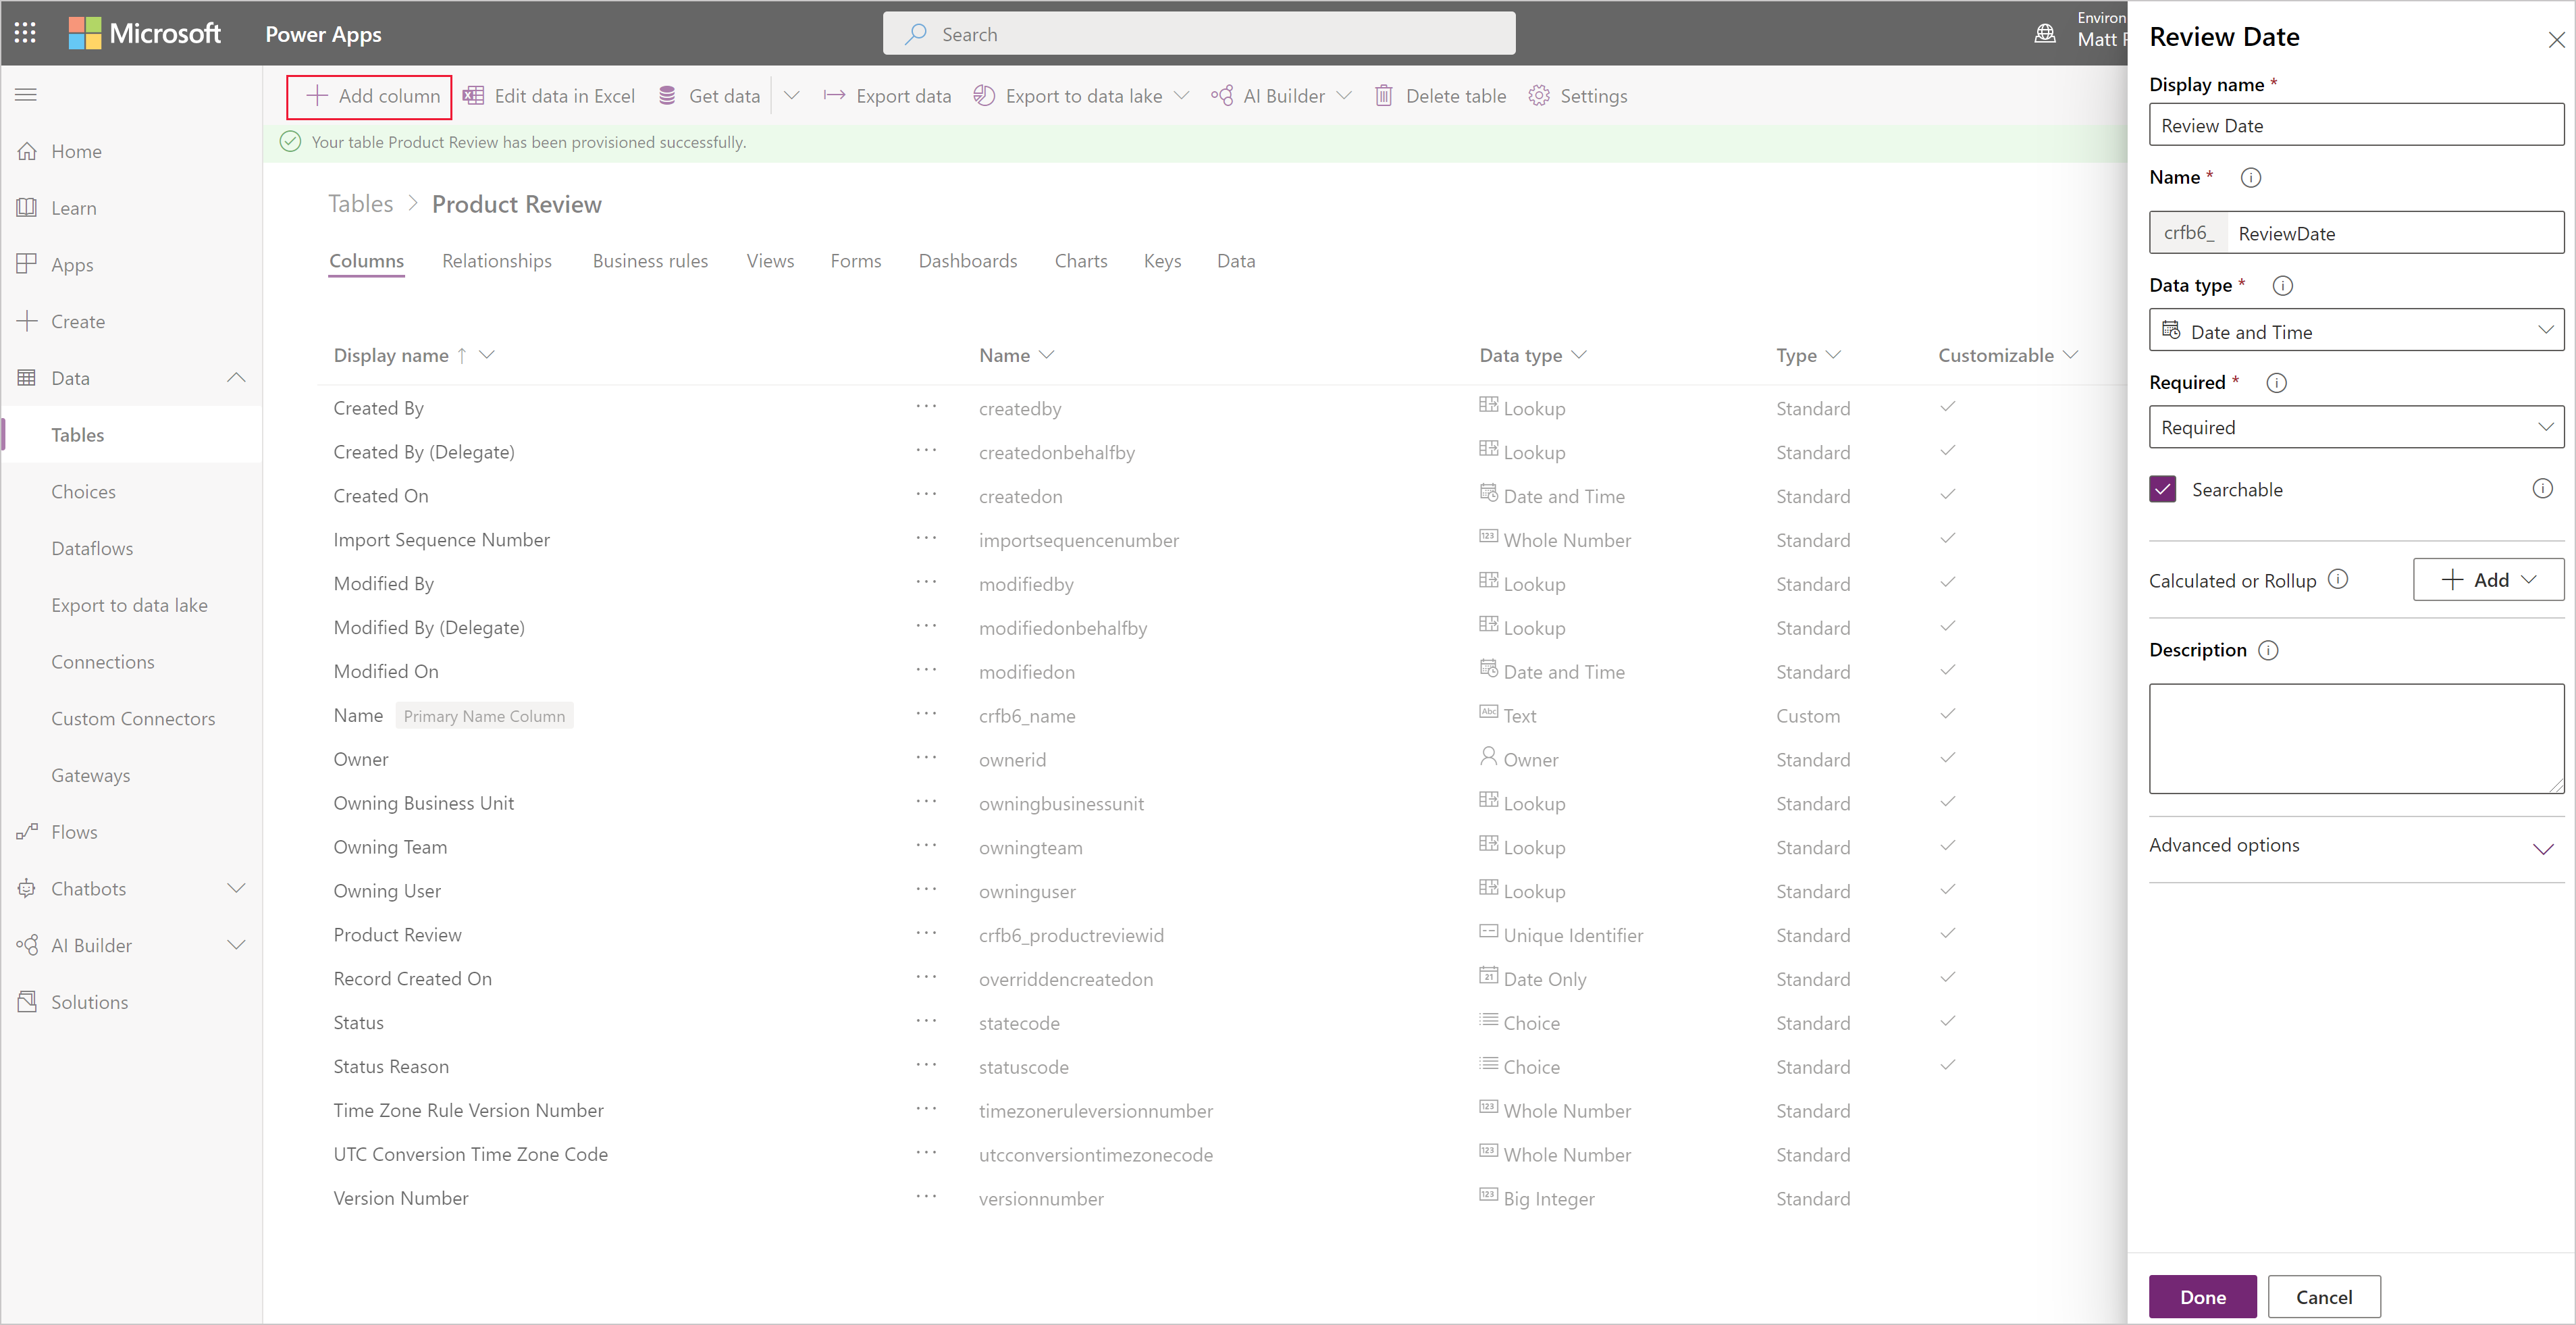
Stolpci določajo posamezne podatkovne elemente, ki jih je mogoče uporabiti za shranjevanje podatkov v tabeli. Razvijalci včasih imenujejo polja. Tabela, ki predstavlja predmet na univerzi, lahko vsebuje stolpce, kot so »Ime«, »Lokacija«, »Oddelek«, »Registrirani študenti« itd.
Stolpci imajo lahko različne vrste podatkov, kot so številke, nizi, digitalni podatki, slike in datoteke. Ni potrebe, da se relacijski in nerelacijski podatki umetno ločujejo, če so del istega poslovnega procesa ali toka. Common Data Service shranjuje podatke v najboljšo vrsto shranjevanja za ustvarjeni model.
Vsak od teh stolpcev je lahko povezan z enim od številnih podatkovnih tipov, ki jih podpira Common Data Service.
Več informacij: Vrste stolpcev
Relacije
Podatki v eni tabeli se pogosto nanašajo na podatke v drugi tabeli. Relacije tabel določajo, kako so vrstice lahko med seboj povezane v modelu Common Data Service.
Common Data Service ponuja preproste vizualne oblikovalce za določanje različnih vrst odnosov od ene tabele do druge (ali med tabelo in samo sobo). Vsaka tabela ima lahko relacijo z več tabelami, vsaka tabela pa ima lahko več kot eno relacijo z drugo tabelo.
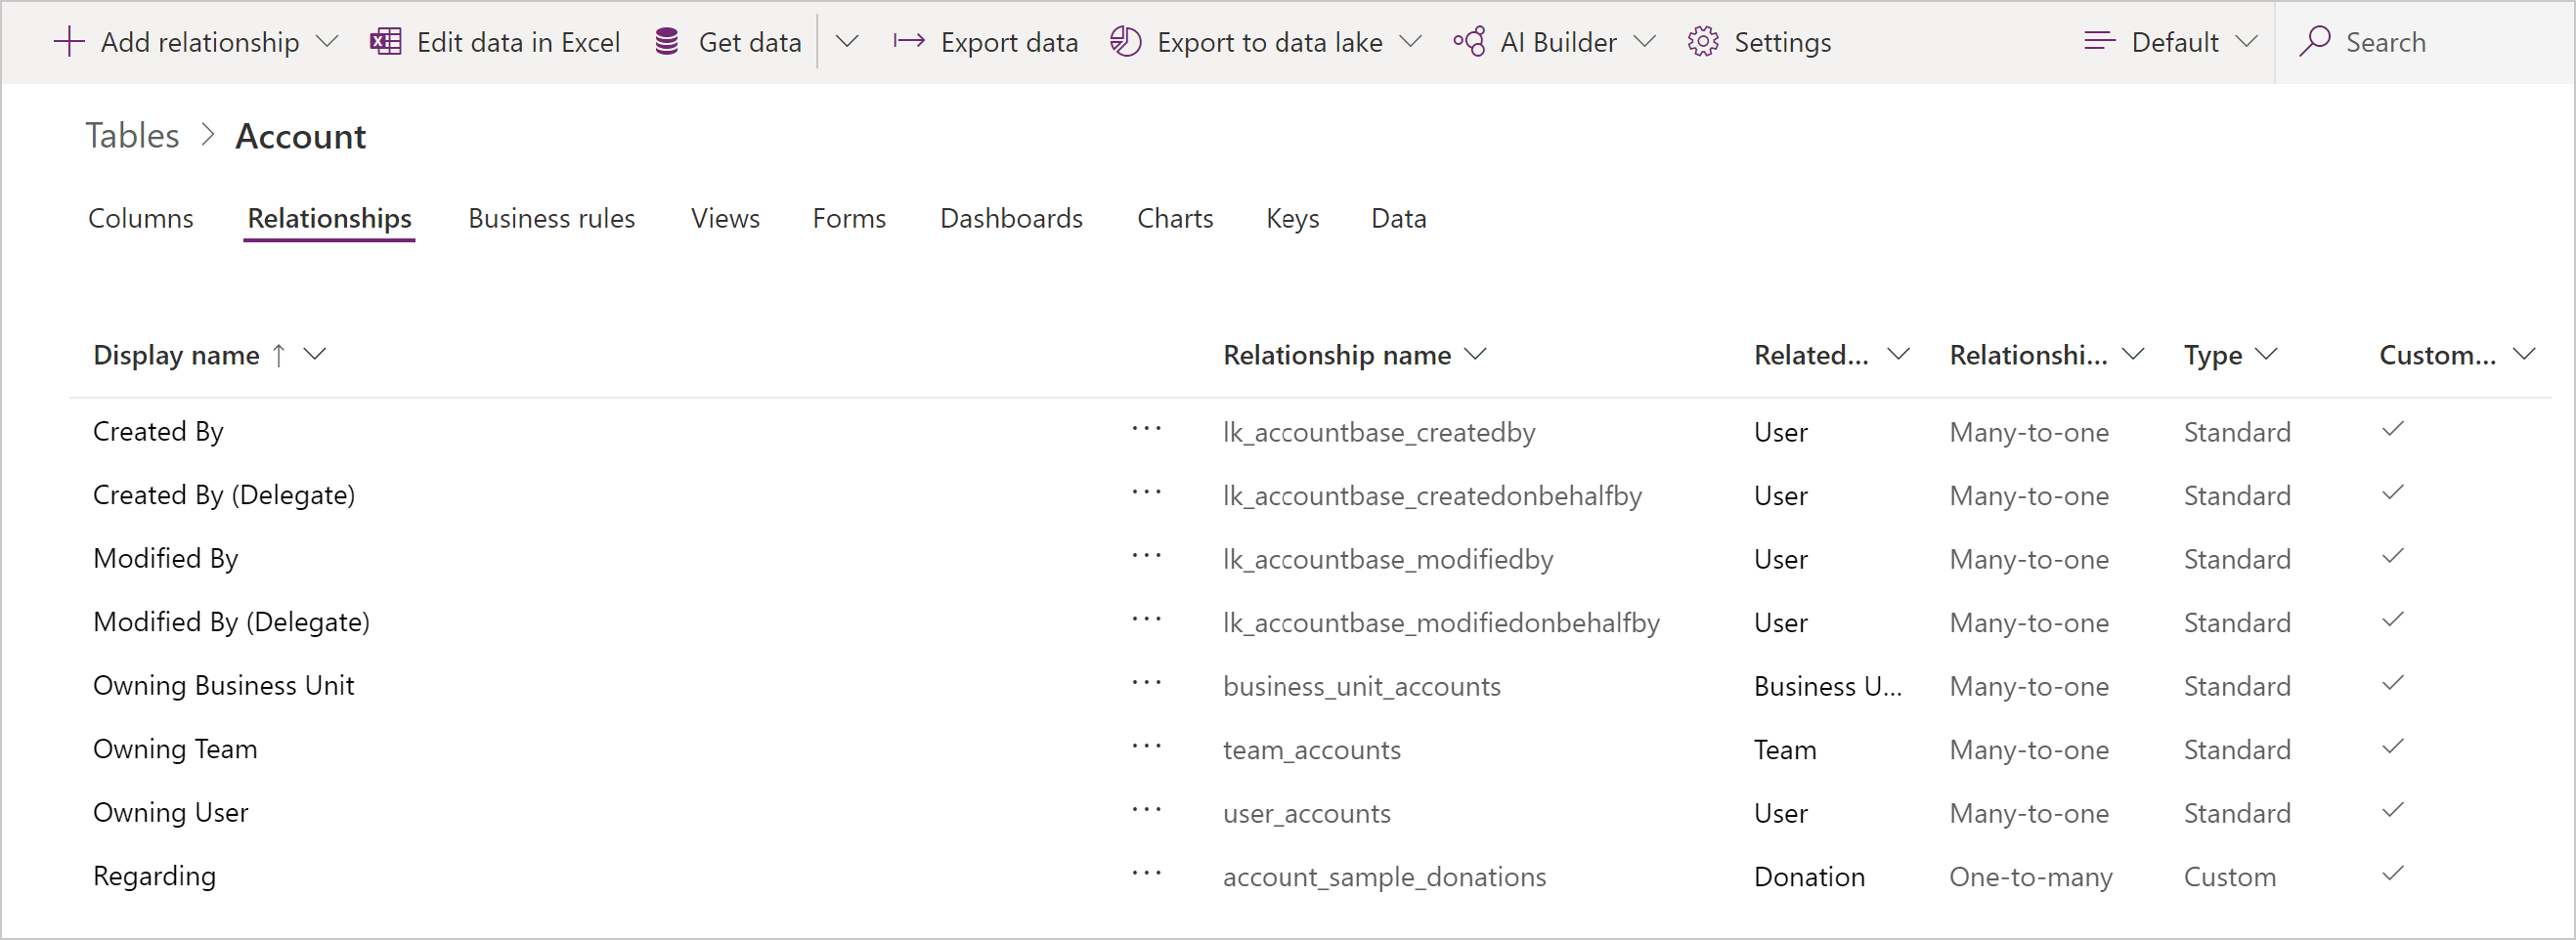
Vrste odnosov so:
Več proti ena: V tej vrsti relacije je lahko veliko zapisov tabele A povezanih z enim zapisom tabele B. Na primer, razred študentov ima eno učilnico.
Ena proti več: V tej vrsti relacije je lahko en zapis tabele B povezan z več zapisi tabele A. Na primer, en sam učitelj poučuje veliko razredov.
Več proti mnogim: V tej vrsti relacije se lahko vsak zapis v tabeli A ujema z več kot enim zapisom v tabeli B in obratno. Učenci se na primer udeležujejo številnih razredov in vsak razred ima lahko več učencev.
Ker so odnosi več proti ena najpogostejši, Common Data Service ponuja poseben podatkovni tip z imenom iskanje, ki ne le olajša določanje tega odnosa, temveč tudi poveča produktivnost pri ustvarjanju obrazcev in aplikacij.
Če želite več informacij o ustvarjanju relacij tabel, glejte Ustvarjanje relacije med tabelami.
Organizacije morajo pogosto upoštevati različne predpise, da zagotovijo razpoložljivost zgodovine interakcij s strankami, dnevnikov nadzora, poročil o dostopu in poročil o sledenju varnostnih incidentov. Organizacije bodo morda želele slediti spremembam podatkov Common Data Service za varnostne in analitične namene.
Common Data Service ponuja zmogljivost nadzora, kjer je mogoče spremembe tabel in podatkov atributov v organizaciji sčasoma razvrstiti za uporabo pri analizi in poročanju. Nadzor je podprt v vseh tabelah in atributih po meri – in najbolj prilagodljivih. Nadzor ni podprt pri spremembah metapodatkov, operacijah pridobivanja, izvozu ali preverjanju pristnosti. Če želite več informacij o konfiguraciji nadzora, glejte Upravljanje nadzora Common Data Service.
Common Data Service podpira analitiko tako, da omogoča izbiro tabel za zagon modelov strojnega učenja. Ima vnaprej vgrajeno zmogljivost AI prek AI Builderja.
Poišči
Common Data Service ponuja tri načine za poizvedovanje v vrsticah:
Iskanje Dataverse
Hitro iskanje (z eno ali več tabelami)
Napredno iskanje
opomba,
Hitro iskanje v več tabelah se imenuje tudi kategorizirano iskanje.
Če želite več informacij, glejte Primerjava iskanj.
Iskanje Dataverse
Iskanje Common Data Service zagotavlja hitre in celovite rezultate v več tabelah na enem seznamu, razvrščene po ustreznosti. Za izboljšanje učinkovitosti iskanja uporablja namensko storitev iskanja zunaj storitve Common Data Service (ki jo poganja Azure).
Iskanje Common Data Service prinaša naslednje izboljšave in prednosti:
Izboljša učinkovitost delovanja z uporabo zunanjega indeksiranja in tehnologije iskanja Azure.
Poišče ujemanja s katero koli besedo v iskalnem izrazu v katerem koli stolpcu v tabeli v primerjavi s hitrim iskanjem, kjer morajo biti vse besede iz iskalnega izraza v enem stolpcu.
Poišče ujemanja, ki vključujejo pregibne besede, kot so pretakanje, pretakanje ali pretakanje.
Vrne rezultate iz vseh tabel, po katerih je mogoče iskati, na enem seznamu, razvrščenih po ustreznosti, tako da boljše kot je ujemanje, višji je rezultat na seznamu. Ujemanje je pomembnejše, če je več besed iz iskalnega izraza najdenih v neposredni bližini. Manjša kot je količina besedila, kjer so najdene iskalne besede, večja je ustreznost. Če na primer najdete iskalne besede v imenu in naslovu podjetja, je to morda boljše ujemanje kot iskanje istih besed v dolgem članku, ki so daleč drug od drugega.
Poudari tekme na seznamu rezultatov. Ko se iskalni izraz ujema z izrazom v vrstici, je izraz v rezultatih iskanja prikazan kot krepko in ležeče besedilo.
Če želite več informacij o iskanju Common Data Service, glejte Uporaba iskanja Common Data Service za iskanje vrstic.
Hitro iskanje
Common Data Service vključuje možnost hitrega iskanja vrstic in ima pristope, ki iščejo samo eno vrsto tabele, na primer stranka, ali pa se uporabljajo za iskanje po več vrstah tabel hkrati, kot so stiki, uporabniki, stranke itd.
Hitro iskanje ene tabele se uporablja za iskanje vrstic samo ene vrste. Ta možnost iskanja je na voljo v pogledu.
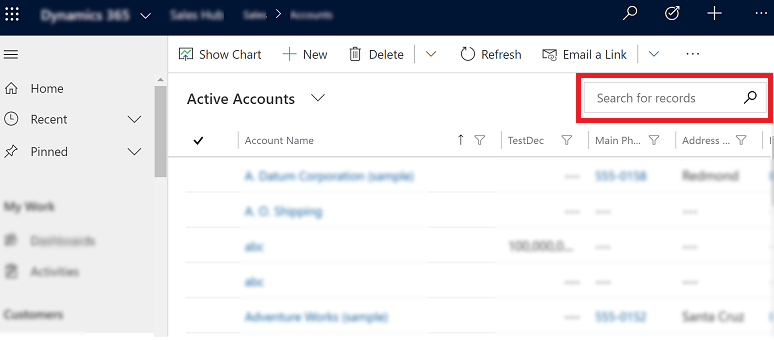
Hitro iskanje z več tabelami (kategorizirano iskanje) se uporablja tudi za iskanje vrstic, vendar jih najde v različnih vrstah tabel, kot so kupci ali stiki.
Podatkovno jezero
Common Data Service podpira neprekinjeno podvajanje podatkov tabele v Azure Data Lake Storage, ki ga je nato mogoče uporabiti za izvajanje analitike, kot so poročanje Power BI, strojno učenje, skladiščenje podatkov in drugi nadaljnji postopki integracije.
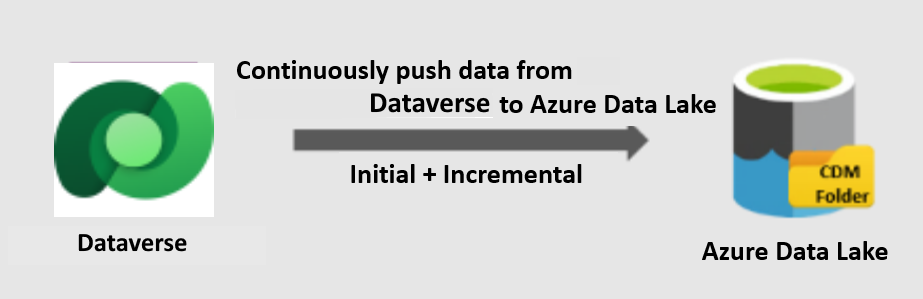
Ta funkcija je zasnovana za analizo velikih podatkov v podjetjih. Je stroškovno učinkovit, razširljiv, ima visoko razpoložljivost in zmogljivosti obnovitve po katastrofi ter omogoča najboljšo učinkovitost analitike v razredu.
Podatki so shranjeni v obliki zbirke podatkov Common Data Model, ki zagotavlja pomensko skladnost med aplikacijami in uvedbami. Standardizirani metapodatki in samoopisni podatki v skupnem podatkovnem modelu olajšajo odkrivanje metapodatkov in interoperabilnost med proizvajalci podatkov in uporabniki, kot so Power BI, Data Factory, Azure Databricks in Azure Machine Learning.