Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
Använd batchbearbetningspaketet för att komplettera och skala ut arbetsbelastningar i Speech-containrar. Det här verktyget med öppen källkod är tillgängligt som en container och underlättar batch-transkription för ett stort antal ljudfiler över valfritt antal lokala och molnbaserade slutpunkter för talcontainer.
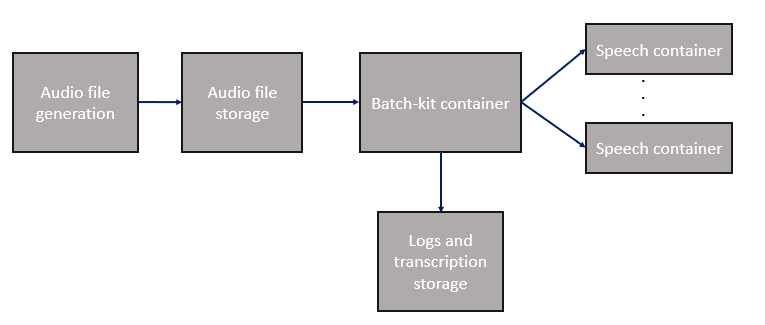
Batch Kit-containern är tillgänglig kostnadsfritt på GitHub och Docker Hub. Du debiteras bara för de Speech-containrar som du använder.
| Funktionalitet | beskrivning |
|---|---|
| Batch-ljudfilsdistribution | Skicka automatiskt ett stort antal filer till lokala eller molnbaserade slutpunkter för Speech-containern. Filer kan finnas på valfri POSIX-kompatibel volym, inklusive nätverksfilsystem. |
| Speech SDK-integrering | Skicka vanliga flaggor till Speech SDK, inklusive: n-bästa hypoteser, diarisering, språk, svordomsmaskering. |
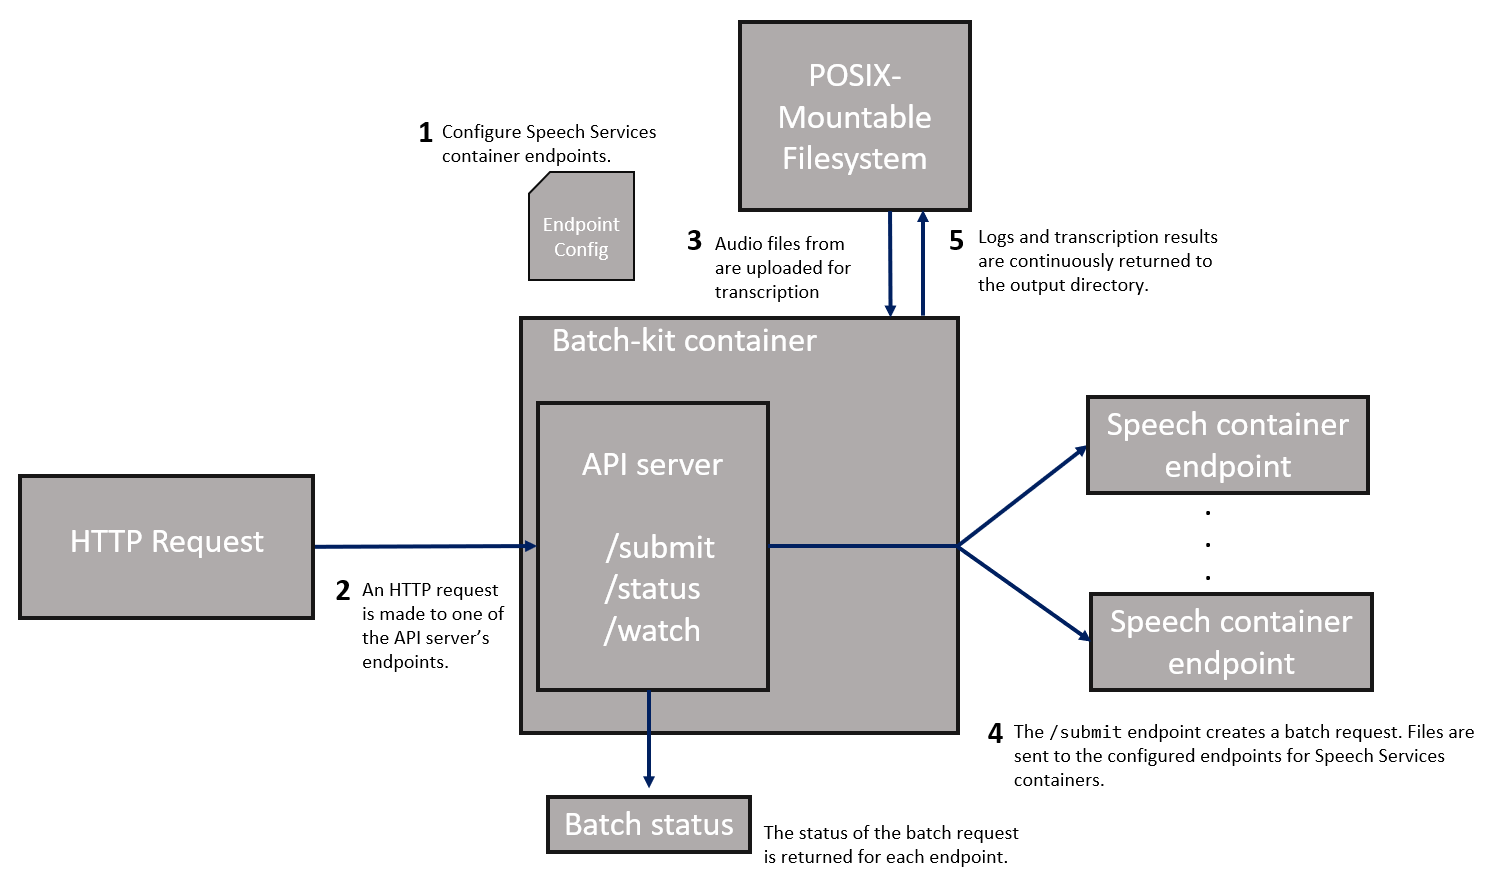
| Körningslägen | Kör batchklienten en gång, kontinuerligt i bakgrunden eller skapa HTTP-slutpunkter för ljudfiler. |
| Feltolerans | Försök automatiskt igen och fortsätt transkriptionen utan att förlora förloppet och skilja mellan vilka fel som kan och inte kan försökas igen. |
| Identifiering av slutpunktstillgänglighet | Om en slutpunkt blir otillgänglig fortsätter batchklienten att transkribera med hjälp av andra containerslutpunkter. När klienten är tillgänglig börjar den automatiskt använda slutpunkten. |
| Snabbväxling av slutpunkt | Lägg till, ta bort eller ändra slutpunkter för Speech-containern under körningen utan att avbryta batchförloppet. Uppdateringarna är omedelbara. |
| Realtidsloggning | Realtidsloggning av begäranden, tidsstämplar och felorsaker med Speech SDK-loggfiler för varje ljudfil. |
Bearbeta långt ljud på ett säkert sätt
Talcontainrar stöder ljud med en maximal varaktighet på 24 timmar. Segmentera ljud längre än 24 timmar innan du skickar det för transkription. Filstorlek är inte ett tillförlitligt substitut för varaktighet eftersom kodning, exempelfrekvens, bitdjup och kanalantal avgör antalet byte. Till exempel är 1 GB inte ett universellt segmenteringströskelvärde.
Vissa ljudpipelines använder en 32-bitarsräknare för att beräkna varaktigheten. Vid cirka 37,3 timmar kan räknaren svämma över och ge en kortare men giltig tidsangivelse. I det här fallet kan transkription rapportera framgång utan varning om att resultatet trunkeras. Den exakta platsen i koden för det här överflödet är inte känd.
Efter transkribering jämför du den ursprungliga ljudfilens längd med transkriptets slutliga offset eller den senast igenkända tidsstämpeln. Behandla ett resultat som slutar väsentligt före källljudet som ofullständigt, även om transkriptionen rapporterar framgång.
Om du konverterar källljud till RIFF/WAV använder du dessa värden för att identifiera var ett spill uppstod:
- En längd på
274,568,704byte för ett konverterat WAV-datasegment anger ett överflöde vid konvertering eller skrivning till fil. - En längd på
4,569,536,000byte för ett datablock, eller en fil som är större än 4 GB med korrekt huvud, indikerar att filen skrevs korrekt och att överflödet inträffade senare i bearbetningskedjan. Kontakta Microsoft support för att kontakta tekniker för det här fallet.
RF64 och Wave64 (W64) är inte några direkta lösningar på det här problemet. Varje läsare och sökväg för varaktighetskontroll i pipelinen måste ha stöd för det valda formatet. Den Python inbyggda modulen avvisar till exempel RF64-filerwave.
Hämta containeravbildningen med docker pull
Använd docker pull-kommandot för att ladda ned den senaste batch kit-containern.
Kommentar
I följande exempel hämtas en offentlig containeravbildning från Docker Hub. Vi rekommenderar att du autentiserar med ditt Docker Hub-konto (docker login) först i stället för att göra en anonym pull-begäran. För att förbättra tillförlitligheten när du använder offentligt innehåll importerar och hanterar du avbildningen i ett privat Azure-containerregister.
Läs mer om hur du arbetar med offentliga avbildningar.
docker pull docker.io/batchkit/speech-batch-kit:latest
Slutpunktskonfiguration
Batch-klienten använder en YAML-konfigurationsfil som anger de lokala containerslutpunkterna. Skriv följande exempel till /mnt/my_nfs/config.yaml, som används i följande exempel.
MyContainer1:
  concurrency: 5
  host: 192.168.0.100
  port: 5000
  rtf: 3
MyContainer2:
  concurrency: 5
  host: BatchVM0.corp.redmond.microsoft.com
  port: 5000
  rtf: 2
MyContainer3:
  concurrency: 10
  host: localhost
  port: 6001
  rtf: 4
Det här YAML-exemplet anger tre talcontainrar på tre värdar. Den första värddatorn anges med en IPv4-adress, den andra värddatorn körs på samma virtuella dator som batchklienten och den tredje containern anges med DNS-värdnamnet till en annan virtuell dator. Värdet concurrency anger maximalt antal samtidiga filavskrifter som kan köras på samma container. Värdet rtf (realtidsfaktor) är valfritt och kan användas för att justera prestanda.
Batch-klienten kan dynamiskt identifiera om en slutpunkt blir otillgänglig (till exempel på grund av ett problem med containerns omstart eller nätverk) och när den blir tillgänglig igen. Transkriptionsbegäranden skickas inte till containrar som inte är tillgängliga och klienten fortsätter att använda andra tillgängliga containrar. Du kan lägga till, ta bort eller redigera slutpunkter när som helst utan att avbryta batchens förlopp.
Kör batchbearbetningscontainern
Kommentar
- I det här exemplet används samma katalog (
/my_nfs) för konfigurationsfilen och indata, utdata och loggkataloger. Du kan använda värdbaserade eller NFS-monterade kataloger för dessa mappar. - När klienten körs med
–hflaggan visas de tillgängliga kommandoradsparametrarna och deras standardvärden. - Containern för batchbearbetning stöds endast i Linux.
Använd Docker-kommandot run för att starta containern. Det här kommandot startar ett interaktivt gränssnitt i containern.
docker run --network host --rm -ti -v /mnt/my_nfs:/my_nfs --entrypoint /bin/bash /mnt/my_nfs:/my_nfs docker.io/batchkit/speech-batch-kit:latest
Så här kör du batchklienten:
run-batch-client -config /my_nfs/config.yaml -input_folder /my_nfs/audio_files -output_folder /my_nfs/transcriptions -log_folder /my_nfs/logs -file_log_level DEBUG -nbest 1 -m ONESHOT -diarization None -language en-US -strict_config
Så här kör du batchklienten och containern i ett enda kommando:
docker run --network host --rm -ti -v /mnt/my_nfs:/my_nfs docker.io/batchkit/speech-batch-kit:latest -config /my_nfs/config.yaml -input_folder /my_nfs/audio_files -output_folder /my_nfs/transcriptions -log_folder /my_nfs/logs
Klienten börjar köra. Om en ljudfil transkriberades i en tidigare körning hoppar klienten automatiskt över filen. Filer skickas med ett automatiskt återförsök om tillfälliga fel inträffar och du kan skilja mellan vilka fel som du vill att klienten ska försöka igen på. Vid ett transkriptionsfel fortsätter klienten transkriptionen och kan försöka igen utan att förlora förloppet.
Körningslägen
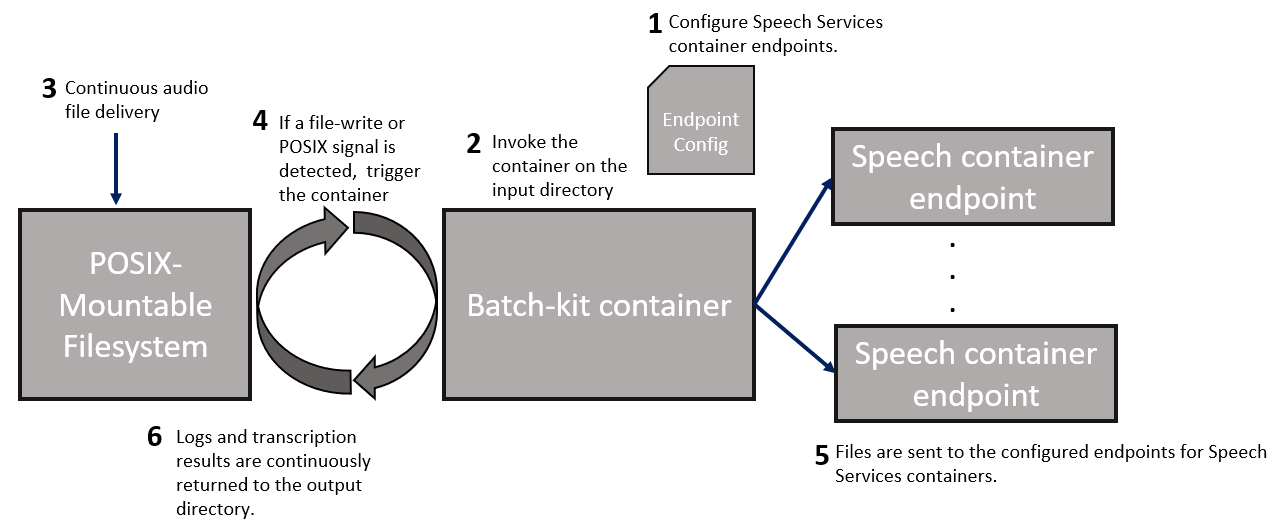
Batchbearbetningssatsen erbjuder tre lägen med hjälp av parametern --run-mode .
ONESHOT-läget transkriberar en batch ljudfiler (från en indatakatalog och en valfri fillista) till en utdatamapp.
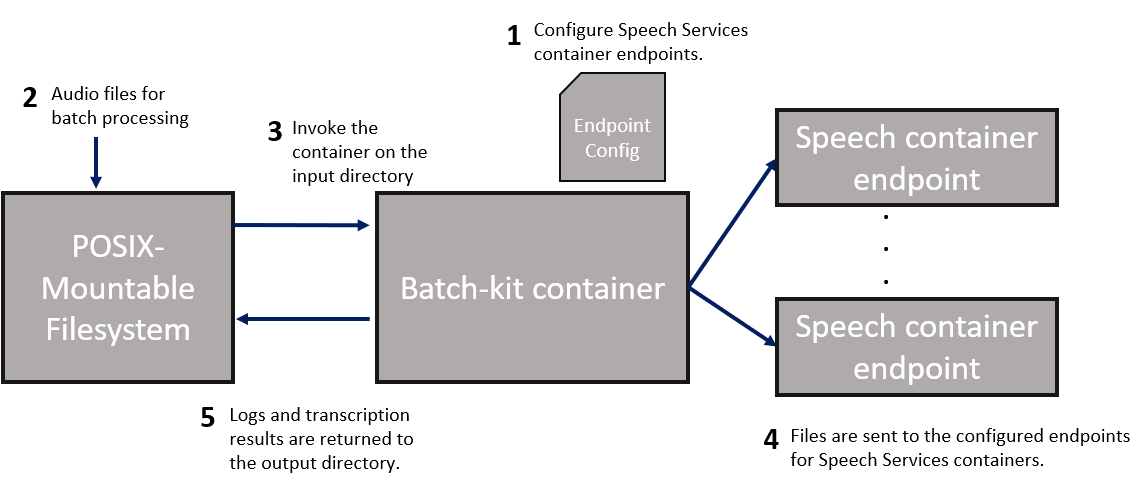
- Definiera slutpunkterna för Speechcontainern som batchklienten använder i
config.yaml-filen. - Placera ljudfiler för transkription i en indatakatalog.
- Anropa containern i katalogen för att börja bearbeta filerna. Om ljudfilen redan transkriberas i en tidigare körning med samma utdatakatalog (samma filnamn och kontrollsumma) hoppar klienten över filen.
- Filerna skickas till containerslutpunkterna från steg 1.
- Loggar och utdata från Speech-containern returneras till den angivna utdatakatalogen.
Loggning
Kommentar
Batch-klienten kan skriva över den run.log filen regelbundet om den blir för stor.
Klienten skapar en run.log fil i katalogen som anges av -log_folder argumentet i docker-kommandot run . Loggar registreras som standard på Debuggnivå. Samma loggar skickas till stdout/stderr, och filtreras beroende på argumenten -file_log_level eller console_log_level . Den här loggen är bara nödvändig för felsökning eller om du behöver skicka en spårning för support. Loggningsmappen innehåller också Speech SDK-loggarna för varje ljudfil.
Utdatakatalogen som anges av -output_folder innehåller en run_summary.json fil som skrivs om var 30:e sekund eller när nya transkriptioner har slutförts. Du kan använda den här filen för att kontrollera förloppet när batchen fortsätter. Den innehåller också den slutliga körningsstatistiken och den slutliga statusen för varje fil när batchen har slutförts. Batchen slutförs när processen avslutas korrekt.