Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
Den här guiden visar hur du verifierar återhämtning för ett Valkey-kluster som distribuerats i Azure Kubernetes Service (AKS) med hjälp av locust-belastningstestningsramverket. Den går igenom hur du skapar en testklient, distribuerar den till AKS, simulerar fel och analyserar klusterbeteende.
Anteckning
Den här artikeln innehåller referenser till termen master (primär), vilket är en term som Microsoft inte längre använder. När termen tas bort från Valkey-programvaran tar vi bort den från den här artikeln.
Skapa exempelklientprogram för Valkey
Följande steg visar hur du skapar ett exempelklientprogram för Valkey.
Exempelklientprogrammet använder locust-belastningstestningsramverket för att simulera en arbetsbelastning i valkey-klustret som du konfigurerade och distribuerade. Python-koden implementerar en Locust User-klass som ansluter till Valkey-klustret och utför en uppsättning och hämtar åtgärden. Du kan expandera den här klassen för att implementera mer komplexa åtgärder.
Anteckning
Vi rekommenderar att du använder det säkraste tillgängliga autentiseringsflödet. Autentiseringsflödet som beskrivs i den här proceduren kräver en mycket hög grad av förtroende för programmet och medför risker som inte finns i andra flöden. Du bör bara använda det här flödet när andra säkrare flöden, till exempel hanterade identiteter, inte är livskraftiga.
Skapa Dockerfile och
requirements.txtplacera dem i en ny katalog med hjälp av följande kommandon:mkdir valkey-client cd valkey-client cat > Dockerfile <<EOF FROM python:3.10-slim-bullseye COPY requirements.txt . COPY locustfile.py . RUN pip install --upgrade pip && pip install --no-cache-dir -r requirements.txt EOF cat > requirements.txt <<EOF valkey locust EOFlocustfile.pySkapa filen som innehåller Valkey-klientprogramkoden:cat > locustfile.py <<EOF import time from locust import between, task, User, events,tag, constant_throughput from valkey import ValkeyCluster from random import randint class ValkeyLocust(User): wait_time = constant_throughput(50) host = "valkey-cluster.valkey.svc.cluster.local" def __init__(self, *args, **kwargs): super(ValkeyLocust, self).__init__(*args, **kwargs) self.client = ValkeyClient(host=self.host) def on_stop(self): self.client.close() @task @tag("set") def set_value(self): self.client.set_value("set_value") @task @tag("get") def get_value(self): self.client.get_value("get_value") class ValkeyClient(object): def __init__(self, host, *args, **kwargs): super().__init__(*args, **kwargs) with open("/etc/valkey-password/valkey-password-file.conf", "r") as f: self.password = f.readlines()[0].split(" ")[1].strip() self.host = host self.vc = ValkeyCluster(host=self.host, port=6379, password=self.password, username="default", cluster_error_retry_attempts=0, socket_timeout=2, keepalive=1 ) def set_value(self, key, command='SET'): start_time = time.perf_counter() try: result = self.vc.set(randint(0, 1000), randint(0, 1000)) if not result: result = '' length = len(str(result)) total_time = (time.perf_counter()- start_time) * 1000 events.request.fire( request_type=command, name=key, response_time=total_time, response_length=length, ) except Exception as e: total_time = (time.perf_counter()- start_time) * 1000 events.request.fire( request_type=command, name=key, response_time=total_time, response_length=0, exception=e ) result = '' return result def get_value(self, key, command='GET'): start_time = time.perf_counter() try: result = self.vc.get(randint(0, 1000)) if not result: result = '' length = len(str(result)) total_time = (time.perf_counter()- start_time) * 1000 events.request.fire( request_type=command, name=key, response_time=total_time, response_length=length, ) except Exception as e: total_time = (time.perf_counter()- start_time) * 1000 events.request.fire( request_type=command, name=key, response_time=total_time, response_length=0, exception=e ) result = '' return result EOF
Skapa och pusha Docker-avbilden till ACR
Skapa Docker-avbildningen och ladda upp den till Azure Container Registry (ACR) med kommandot
az acr build.az acr build --image valkey-client --registry ${MY_ACR_REGISTRY} .Kontrollera att avbildningen har överförts med kommandot
az acr repository list.az acr repository list --name ${MY_ACR_REGISTRY} --output tableUtdata ska visa bilden
valkey-client, som i följande exempel:Result ---------------- valkey-client
Distribuera exempelklientpodden till AKS
Skapa en
Podsom använder Valkey-klientbilden som skapades i föregående steg med kommandotkubectl apply. Podspecificationen innehåller Secret Store CSI-volymen med valkey-lösenordet som klienten använder för att ansluta till Valkey-klustret.kubectl apply -f - <<EOF --- kind: Pod apiVersion: v1 metadata: name: valkey-client namespace: valkey spec: affinity: nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution: nodeSelectorTerms: - matchExpressions: - key: agentpool operator: In values: - nodepool1 containers: - name: valkey-client image: ${MY_ACR_REGISTRY}.azurecr.io/valkey-client command: ["locust", "--processes", "4"] volumeMounts: - name: valkey-password mountPath: "/etc/valkey-password" volumes: - name: valkey-password csi: driver: secrets-store.csi.k8s.io readOnly: true volumeAttributes: secretProviderClass: "valkey-password" EOFVidarebefordra port 8089 för att komma åt Locust-webbgränssnittet på din lokala dator med kommandot
kubectl port-forward.kubectl port-forward -n valkey valkey-client 8089:8089Öppna Locust-webbgränssnittet vid
http://localhost:8089och starta testet. Du kan justera antalet användare och yngningshastigheten för att simulera en arbetsbelastning i Valkey-klustret. Följande diagram använder 100 användare och en 10-spawnfrekvens: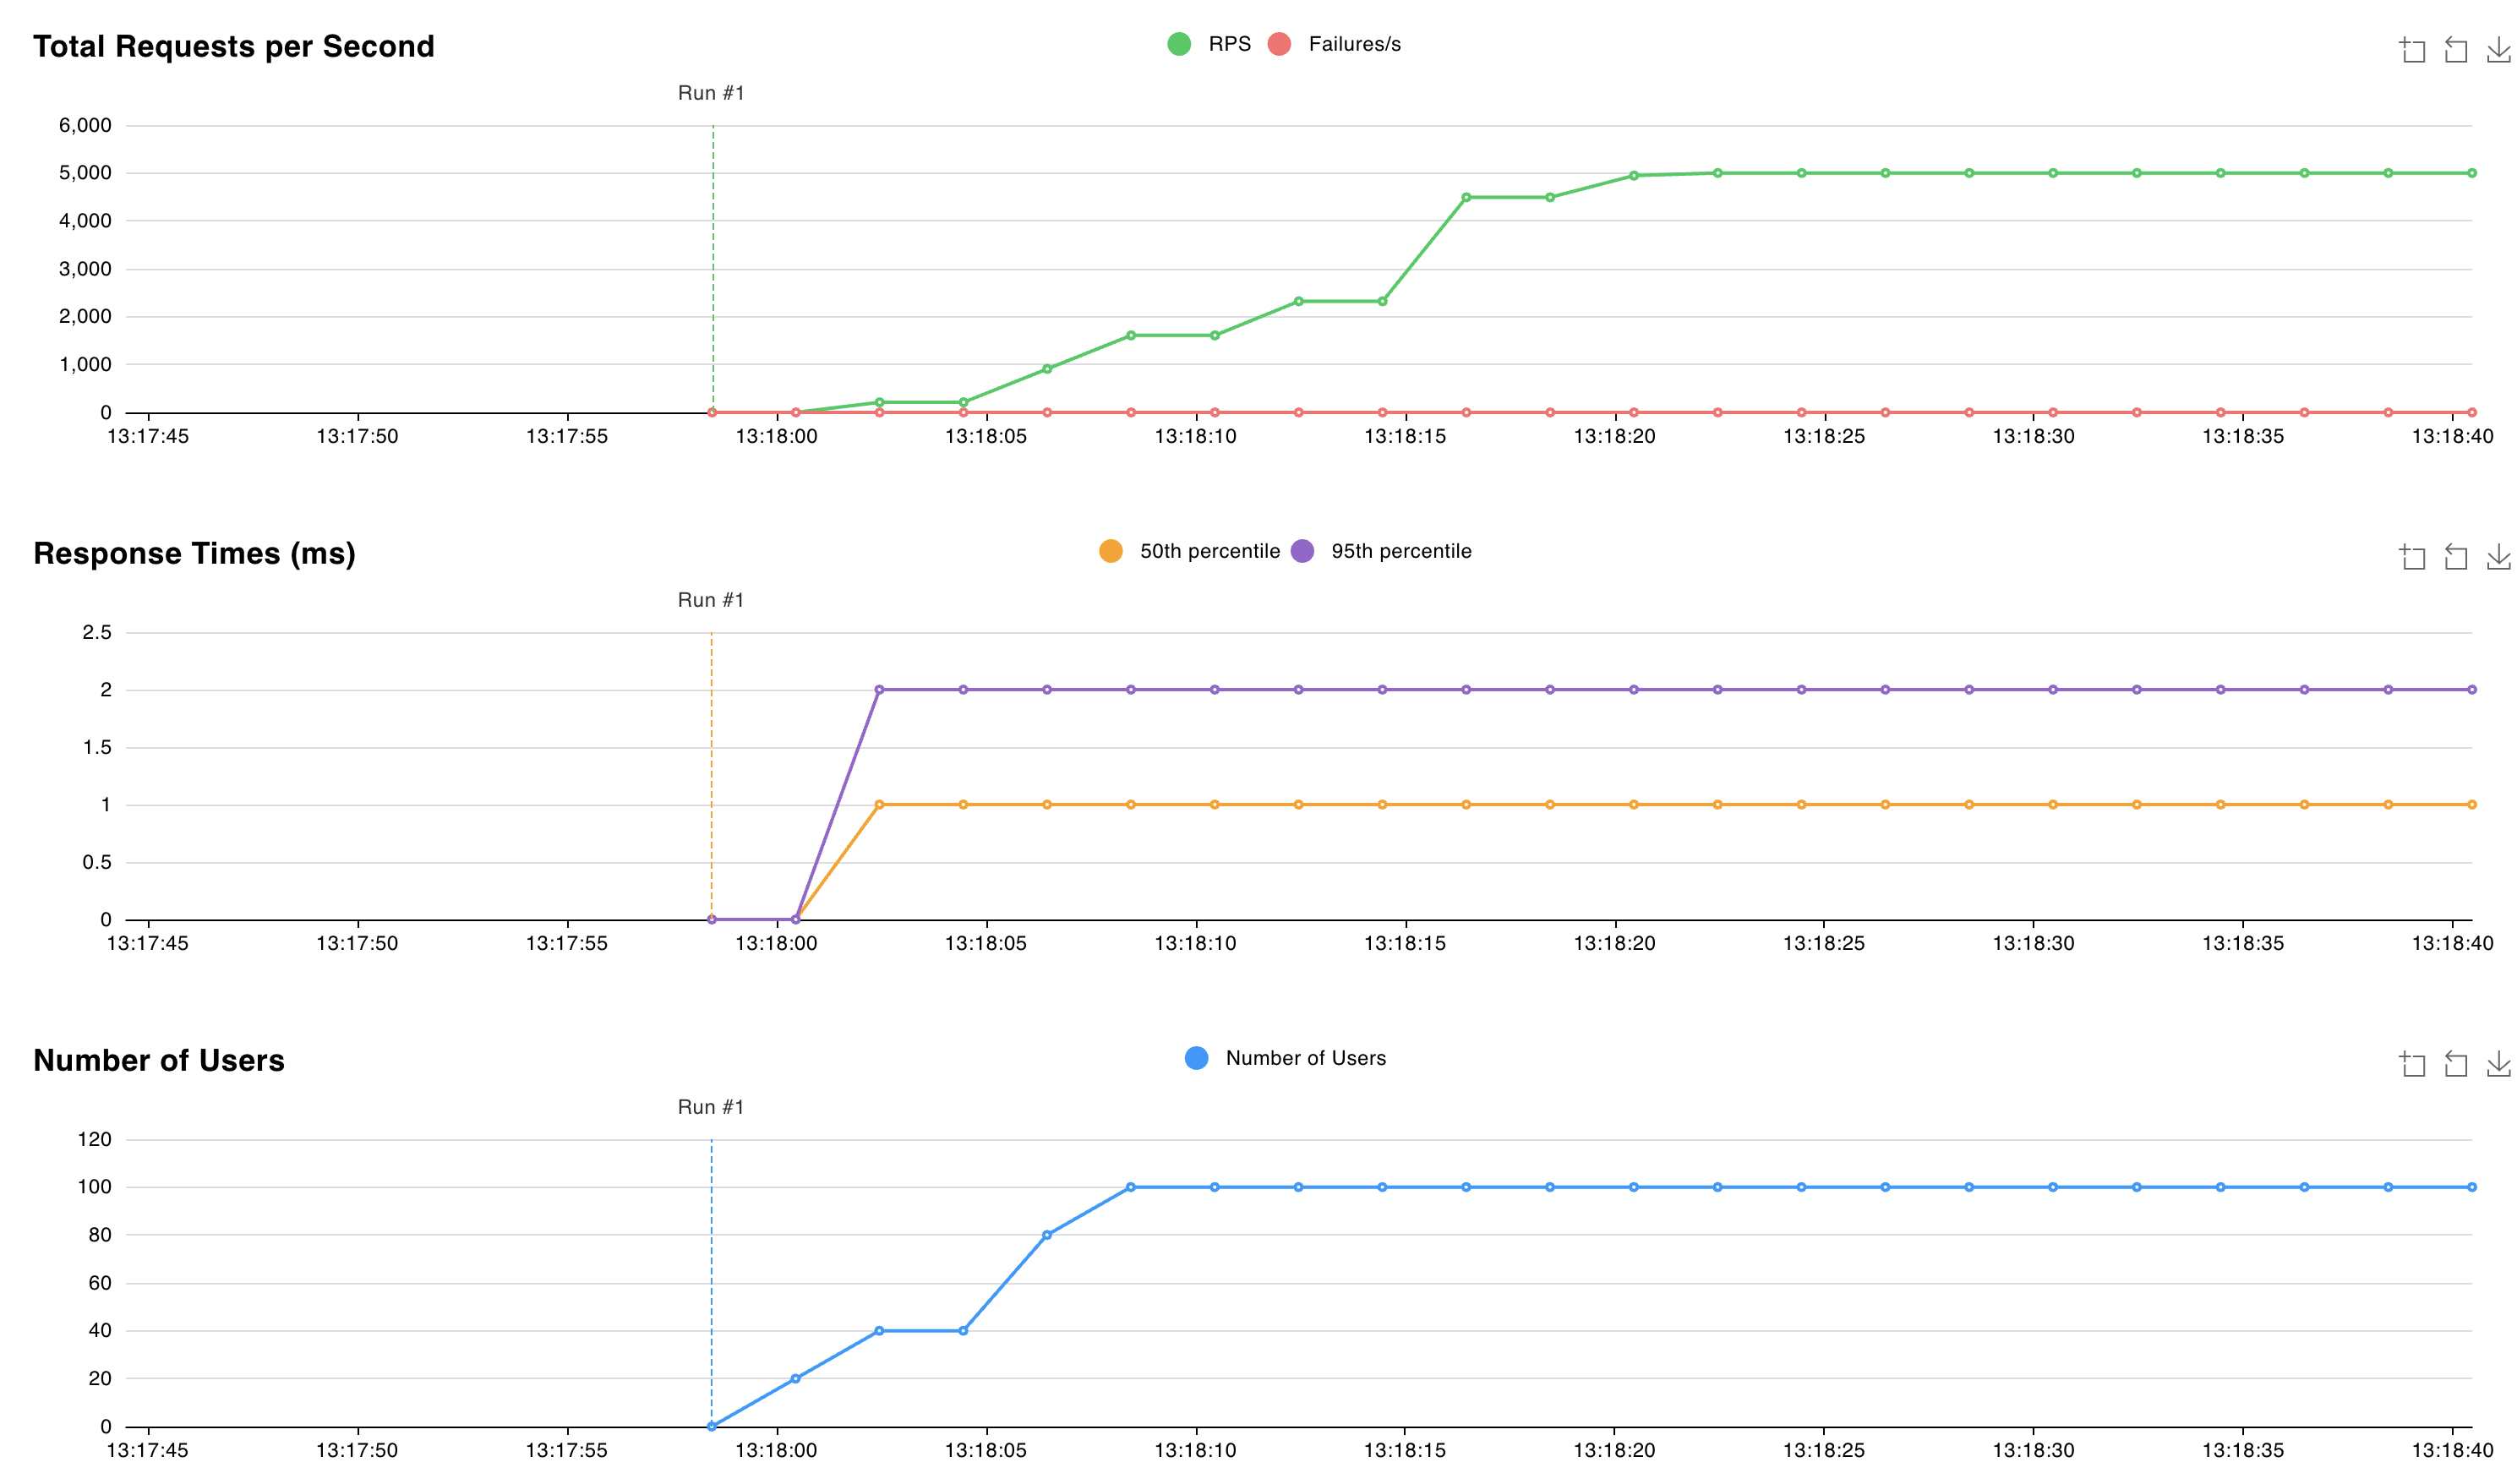
Simulera fel och observera Valkey-klusterbeteende
Simulera ett avbrott genom att ta bort
StatefulSetmed kommandotkubectl deleteoch flaggan--cascade=orphan. Målet är att kunna ta bort en enda podd utanStatefulSetatt den borttagna podden omedelbart återskapas.kubectl delete statefulset valkey-masters --cascade=orphanTa bort
valkey-masters-0-podden med kommandotkubectl delete pod.kubectl delete pod valkey-masters-0Kontrollera listan över pods med kommandot
kubectl get pods.kubectl get podsUtdata bör indikera att podden
valkey-masters-0har tagits bort. De andra poddarna ska vara i tillståndetRunning, som du ser i följande exempel:NAME READY STATUS RESTARTS AGE valkey-client 1/1 Running 0 6m34s valkey-masters-1 1/1 Running 0 16m valkey-masters-2 1/1 Running 0 16m valkey-replicas-0 1/1 Running 0 16m valkey-replicas-1 1/1 Running 0 16m valkey-replicas-2 1/1 Running 0 16mHämta loggarna för
valkey-replicas-0podden med hjälp avkubectl logs valkey-replicas-0kommandot .kubectl logs valkey-replicas-0I utdata ser vi att den fullständiga händelsen varar i cirka 18 sekunder:
1:S 05 Nov 2024 12:18:53.961 * Connection with primary lost.
1:S 05 Nov 2024 12:18:53.961 * Caching the disconnected primary state.
1:S 05 Nov 2024 12:18:53.961 * Reconnecting to PRIMARY 10.224.0.250:6379
1:S 05 Nov 2024 12:18:53.961 * PRIMARY <-> REPLICA sync started
1:S 05 Nov 2024 12:18:53.964 # Error condition on socket for SYNC: Connection refused
1:S 05 Nov 2024 12:18:54.910 * Connecting to PRIMARY 10.224.0.250:6379
1:S 05 Nov 2024 12:18:54.910 * PRIMARY <-> REPLICA sync started
1:S 05 Nov 2024 12:18:54.912 # Error condition on socket for SYNC: Connection refused
1:S 05 Nov 2024 12:18:55.920 * Connecting to PRIMARY 10.224.0.250:6379
[..CUT..]
1:S 05 Nov 2024 12:19:10.056 * Connecting to PRIMARY 10.224.0.250:6379
1:S 05 Nov 2024 12:19:10.057 * PRIMARY <-> REPLICA sync started
1:S 05 Nov 2024 12:19:10.058 # Error condition on socket for SYNC: Connection refused
1:S 05 Nov 2024 12:19:10.709 * Node c44d4b682b6fb9b37033d3e30574873545266d67 () reported node 9e7c43890613cc3ad4006a9cdc0b5e5fc5b6d44e     () as not reachable.
1:S 05 Nov 2024 12:19:10.864 * NODE 9e7c43890613cc3ad4006a9cdc0b5e5fc5b6d44e () possibly failing.
1:S 05 Nov 2024 12:19:11.066 * 10000 changes in 60 seconds. Saving...
1:S 05 Nov 2024 12:19:11.068 * Background saving started by pid 29
1:S 05 Nov 2024 12:19:11.068 * Connecting to PRIMARY 10.224.0.250:6379
1:S 05 Nov 2024 12:19:11.068 * PRIMARY <-> REPLICA sync started
1:S 05 Nov 2024 12:19:11.069 # Error condition on socket for SYNC: Connection refused
29:C 05 Nov 2024 12:19:11.090 * DB saved on disk
29:C 05 Nov 2024 12:19:11.090 * Fork CoW for RDB: current 0 MB, peak 0 MB, average 0 MB
1:S 05 Nov 2024 12:19:11.169 * Background saving terminated with success
1:S 05 Nov 2024 12:19:11.884 * FAIL message received from ba36d5167ee6016c01296a4a0127716f8edf8290 () about     9e7c43890613cc3ad4006a9cdc0b5e5fc5b6d44e ()
1:S 05 Nov 2024 12:19:11.884 # Cluster state changed: fail
1:S 05 Nov 2024 12:19:11.974 * Start of election delayed for 510 milliseconds (rank #0, offset 7225807).
1:S 05 Nov 2024 12:19:11.976 * Node d43f370a417d299b78bd1983792469fe5c39dcdf () reported node 9e7c43890613cc3ad4006a9cdc0b5e5fc5b6d44e     () as not reachable.
1:S 05 Nov 2024 12:19:12.076 * Connecting to PRIMARY 10.224.0.250:6379
1:S 05 Nov 2024 12:19:12.076 * PRIMARY <-> REPLICA sync started
1:S 05 Nov 2024 12:19:12.076 * Currently unable to failover: Waiting the delay before I can start a new failover.
1:S 05 Nov 2024 12:19:12.078 # Error condition on socket for SYNC: Connection refused
1:S 05 Nov 2024 12:19:12.581 * Starting a failover election for epoch 15.
1:S 05 Nov 2024 12:19:12.616 * Currently unable to failover: Waiting for votes, but majority still not reached.
1:S 05 Nov 2024 12:19:12.616 * Needed quorum: 2. Number of votes received so far: 1
1:S 05 Nov 2024 12:19:12.616 * Failover election won: I'm the new primary.
1:S 05 Nov 2024 12:19:12.616 * configEpoch set to 15 after successful failover
1:M 05 Nov 2024 12:19:12.616 * Discarding previously cached primary state.
1:M 05 Nov 2024 12:19:12.616 * Setting secondary replication ID to c0b5b2df8a43b19a4d43d8f8b272a07139e0ca34, valid up to offset:     7225808. New replication ID is 029fcfbae0e3e4a1dccd73066043deba6140c699
1:M 05 Nov 2024 12:19:12.616 * Cluster state changed: ok
Under det här tidsfönstret på 18 sekunder ser vi att skrivningar till den Shard som tillhör den borttagna podden misslyckas och Valkey-klustret väljer en ny primär. Svarstiden för begäran ökar till 60 ms under den här tidsperioden.
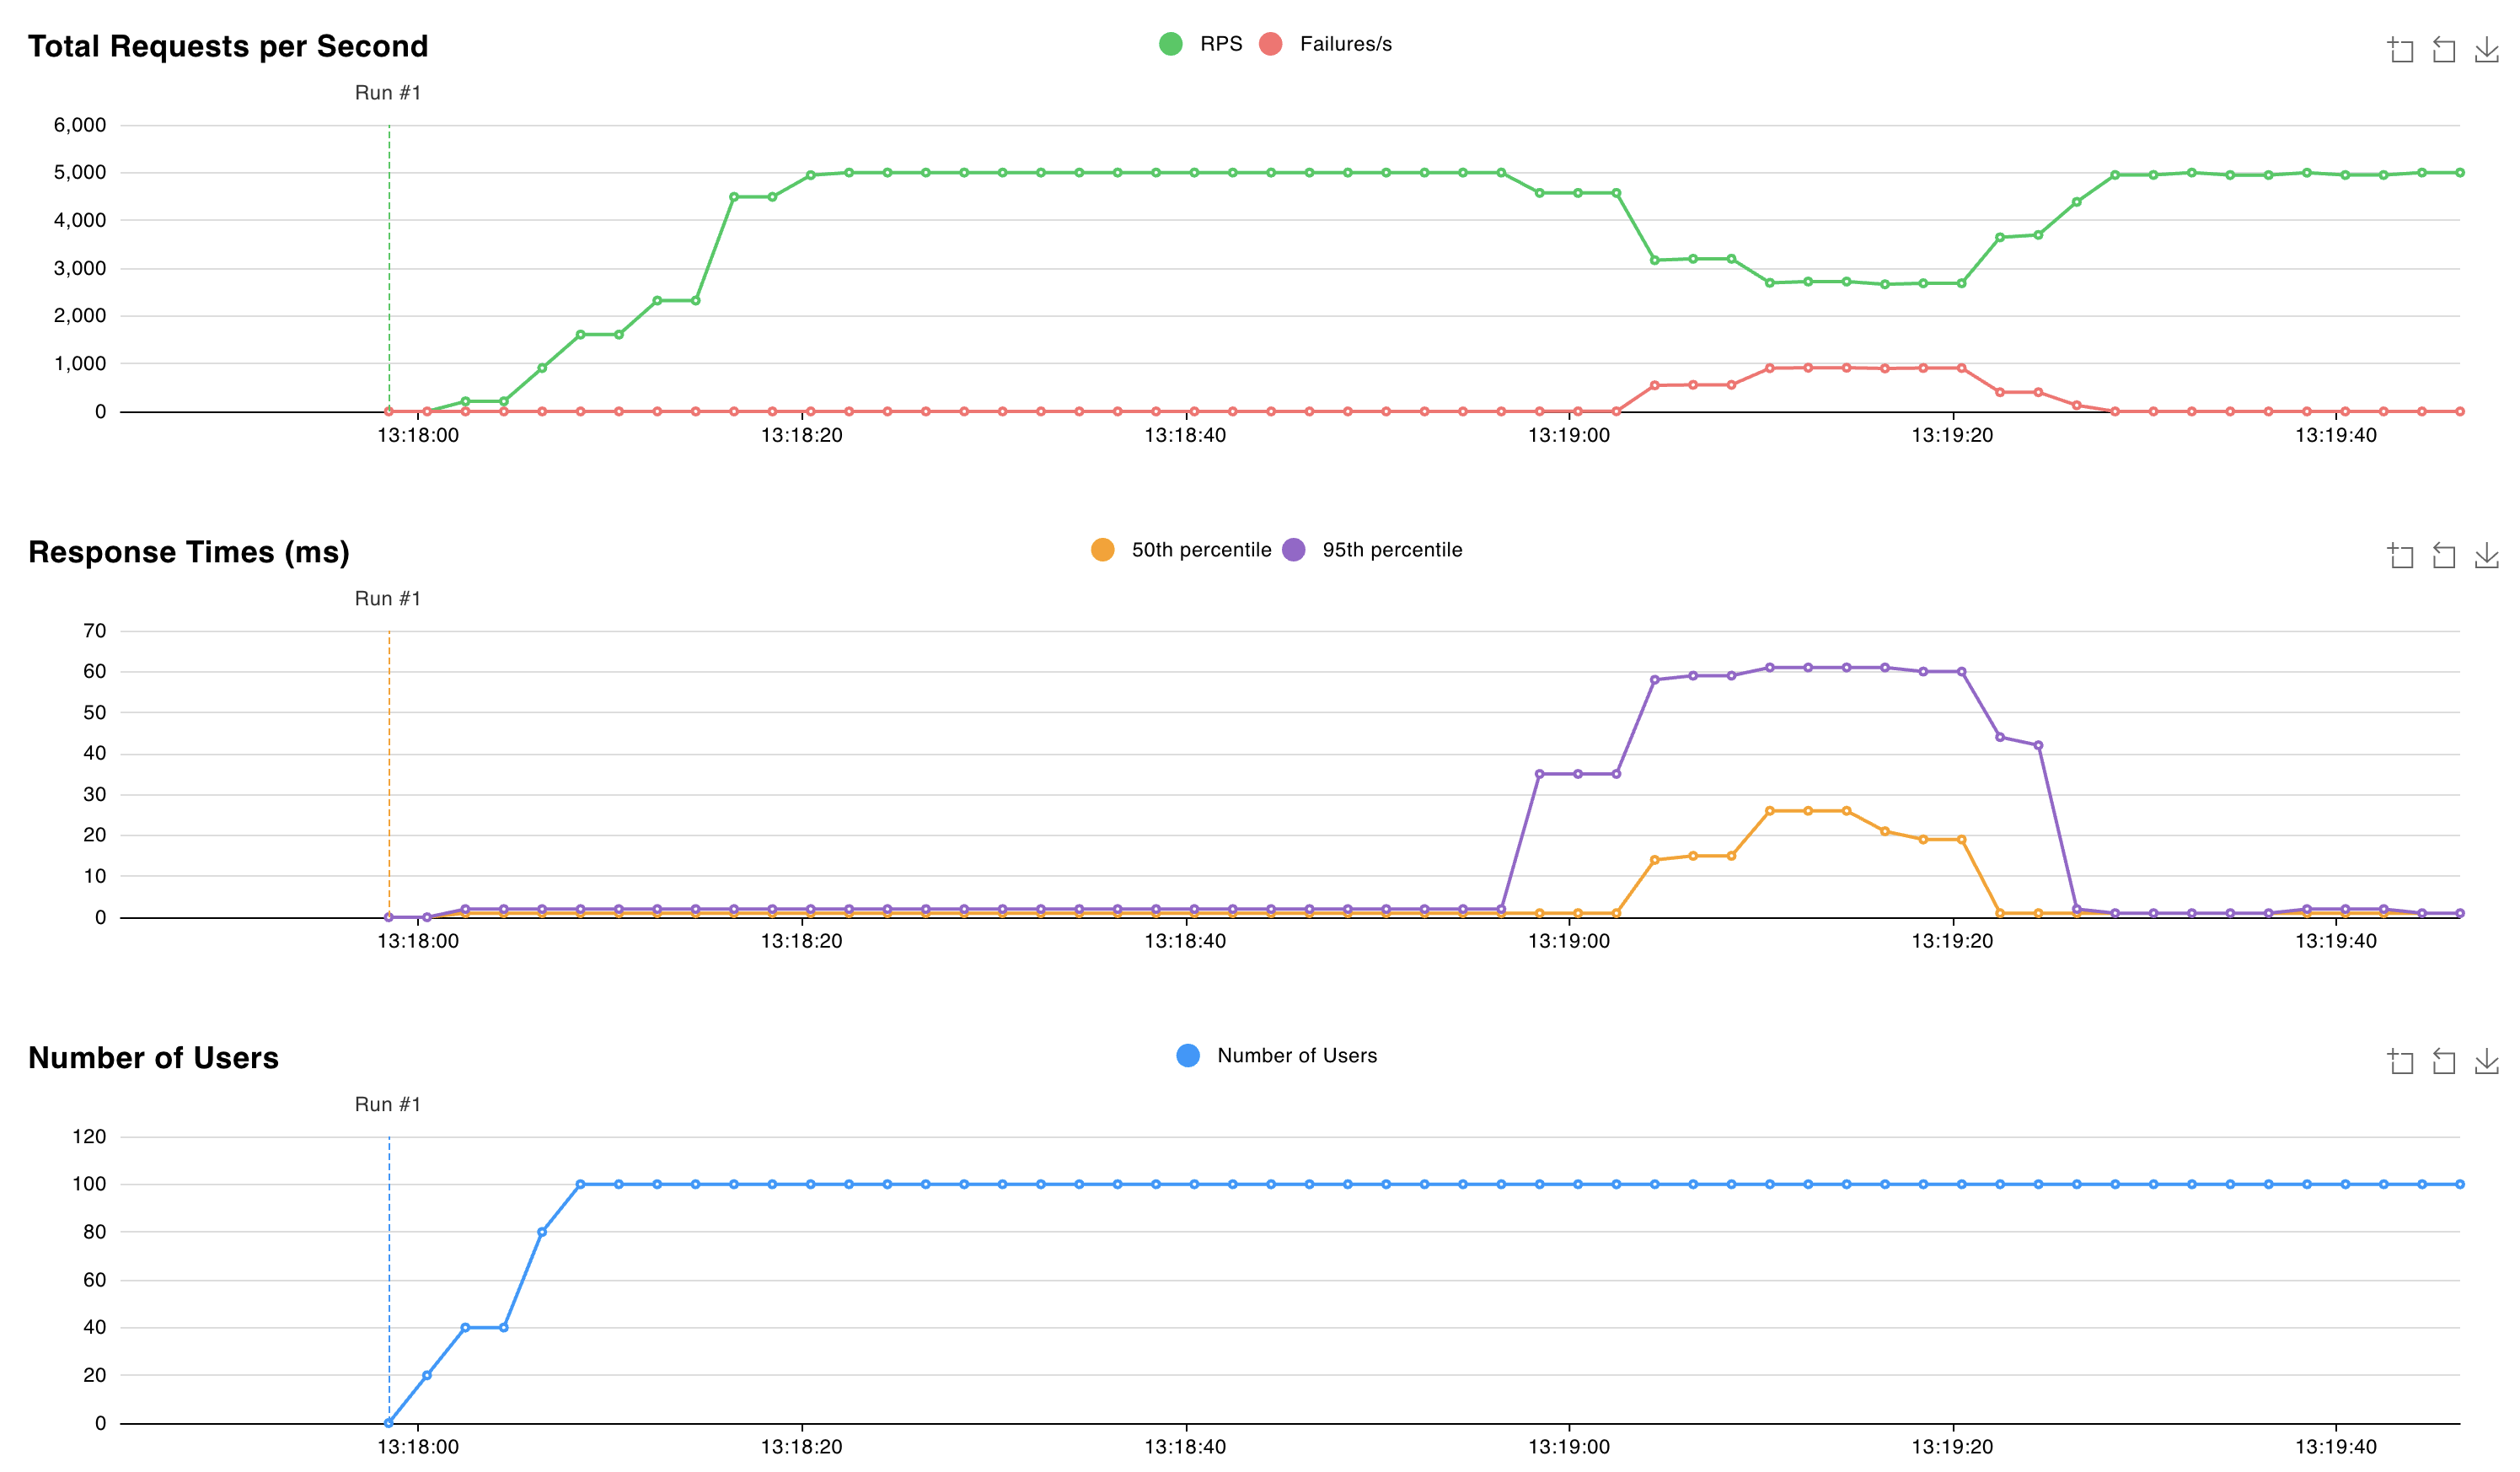
När den nya primärservern har valts fortsätter Valkey-klustret att hantera begäranden med en latens på cirka 2 ms.
Nästa steg
Deltagare
Microsoft underhåller den här artikeln. Följande deltagare skrev den ursprungligen:
- Nelly Kiboi | Tjänsttekniker
- Saverio Proto | Huvudtekniker för kundupplevelse