Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
Begreppet flera innehavare i Azure Data Explorer syftar på att betjäna olika klienter och lagra sina data i ett enda kluster.
Important
En multitenant-lösning kan också arkitekteras i Microsoft Fabric's Real-Time Intelligence arbetsbelastning med hjälp av KQL-databaser i en Eventhouse.
En tenant kan representera en kund, en grupp användare eller någon annan klassificering av användare där data behöver separeras längs tenantens gränser. Du kan också ha flernivålösningar för flera klientorganisationer, till exempel flera applikationer som var och en har flera klientorganisationer. Den här artikeln beskriver inte det här scenariot, men liknande principer gäller.
En viktig faktor är hur slutanvändarna kommer åt sina klientdata. När slutanvändarna får direkt åtkomst till Azure Data Explorer måste åtkomstkontrollen konfigureras i Azure Data Explorer för att isolera användarens vy till sina egna data. När ett proxyprogram kommer åt sina data i Azure Data Explorer kan programmet utföra isoleringen.
Den här artikeln beskriver vissa distributionsarkitekturer och ger egenskaper för var och en. Du kan använda egenskaperna för att avgöra vilken arkitektur som passar bäst för din lösning.
Störande granne
I allmänhet innebär delning av ett kluster mellan många klienter, oavsett vilken arkitektur som används, att olika klienter delar klustrets resurser. Detta kan leda till bullriga granne antipattern.
Om en klientorganisation till exempel utför många beräkningsintensiva frågor eller inmatningar påverkas sannolikt andra klienter av resurssvält. Detta kan minimeras med hjälp av arbetsbelastningsgrupper. Du kan också använda principer för att styra cachelagring och övergripande lagring.
Översikt över arkitekturer
I nästa avsnitt beskrivs distributionsarkitekturer i detalj. Det här avsnittet kontrasterar arkitekturerna för att underlätta beslutsfattandet.
| Architecture | Strengths |
|---|---|
| En hyresgäst per databas | – Klientisolering: inget behov av proxy – Kan ha olika policyer, till exempel kvarhållningspolicyer, per klientorganisation – Flexibilitet i schemautveckling per klientorganisation – Enkel och snabb borttagning av klientdata |
| En tabell för många hyresgäster | – Effektiv datakonsolidering och omfattningshantering – Förenklad schemautveckling - Passar bäst för materialiserade vyer – Perfekt för partitionering |
| En klient per tabell i en enda databas | Rekommenderas inte |
Arkitektur: En hyresgäst per databas

Detta är en populär och rak arkitektur. Varje klientorganisation får en egen databas. Varje databas har samma schema.
Egenskaperna för den här arkitekturen är:
Etablering av en ny hyresgäst: Kräver att skapa en ny databas och distribuera schemaentiteter på den.
Tar bort en klientorganisation: Kräver att databasen tas bort. Du kan ta bort en databas på några sekunder. Förbrukar små och konstanta resurser som inte är linjära med klientorganisationens datavolym.
Uppdateringar av databasscheman: Varje tenant kan uppdateras självständigt vid olika tidpunkter. Program som har åtkomst till databaserna måste vara medvetna om vilken version av varje databas de interagerar med.
Principer för kvarhållning och cachelagring: Varje klientorganisation kan ha egna unika principer som gör att du kan tillhandahålla anpassade principer för kvarhållning och cachelagring till dina kunder.
Säkerhetsgräns per klientorganisation:
- För program med flera klientorganisationer (proxy): Konfigurera ditt program så att det riktar sig mot den relevanta databasen. Använd åtkomstbegränsning för frågor för att förbjuda frågor mellan databaser.
- För användare med direkt åtkomst: Användare kan beviljas åtkomst på databasnivå. Att ge användarna direkt åtkomst till databasen skapar ett beroende för implementeringsinformationen, vilket gör det svårt att ändra implementeringen. Därför rekommenderar vi starkt att du använder proxymetoden för att komma åt databasen.
Aggregera data från flera klienter i stor skala: Använd union-operatorn för att aggregera data mellan databaser. Den här metoden kan dock bli besvärlig när antalet klienter ökar. Även om aggregering av data från flera klienter kan vara ett designmål från klientorganisationens perspektiv kan det vara av intresse för lösningsägaren att aggregera data från alla klienter för att samla in statistik.
Fragmentering av extenter: Varje hyresgäst som matar in några poster per databastabell leder till att små extenter skapas som senare måste sammanfogas. Detta resulterar i högre kostnader för omfattningshantering. Därför rekommenderar vi starkt att du använder strömmande inmatning, till exempel Event Hubs eller Event Grid-inmatning. Om du vill använda strömmande inmatning måste du se till att den är aktiverad i klustret och tabellen.
Materialiserade vyer och partitioneringsprincip. När antalet hyresgäster ökar är det viktigt att komma ihåg att det finns gränser för hur många materialiserade vyer och partitionsprinciper ett kluster kan köra effektivt.
Event Grid- och Event Hubs-dataanslutningar: Dessa dataanslutningar skapas per databas. Därför kräver den här arkitekturen en dataanslutning och En Event Grid- eller Event Hubs-instans per klientorganisation, vilket ökar hanteringskomplexiteten. Överväg att använda händelseroutning för Event Hubs och Event Grid.
Arkitektur: En tabell för många hyresgäster
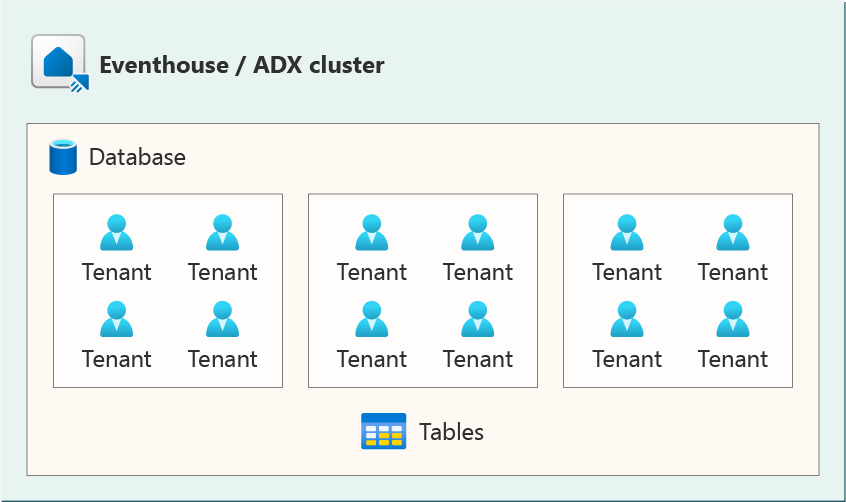
Den här arkitekturen är mer aggressiv i sin konsolidering med hjälp av en enda databas för alla klienter. Varje tabell i databasen har en kolumn för klientorganisations-ID , eller motsvarande, som möjliggör filtrering av en enskild klientorganisations data. Du kan partitioneringstabeller efter klientorganisation för att förbättra frågeprestanda, eftersom de flesta frågor sannolikt kommer att filtreras efter klientorganisation. Om möjligt bör du överväga partition med en annan kolumn med hjälp av en sammansatt partitionsnyckel. Du kan till exempel skapa en sammansatt partitionsnyckel som sammanfogar klientorganisations-ID:t och andra kolumners värden.
Egenskaperna för den här arkitekturen är:
Etablering av en ny klientorganisation: Etablering av en ny klientorganisation kräver ingen databasskapande eller schemajustering. Det nya hyresgäst-ID:t används i nya poster.
Tar bort en klientorganisation: Kräver en mjuk borttagning eller rensning av klientorganisationens data. Du kan gruppera flera rensningar tillsammans, till exempel i slutet av veckan för att begränsa påverkan på resursförbrukningen.
Uppdateringar av databasscheman: Alla klientorganisationers schema uppgraderas samtidigt. Eftersom alla hyresgäster delar tabell, påverkas alla hyresgäster samtidigt när tabellscheman ändras.
Principer för kvarhållning och cachelagring: Principerna är desamma för alla klienter eftersom de alla delar samma tabell.
Säkerhetsgräns per klientorganisation:
- För multitenant-applikation (proxy): Använd Begränsa-instruktionen
- För användare med direkt åtkomst: Använd säkerhetsprincipen på radnivå och bekanta dig med dess begränsningar. Att ge användarna direkt åtkomst till databasen skapar ett beroende för implementeringsinformationen, vilket gör det svårt att ändra implementeringen. Därför rekommenderar vi starkt att du använder proxymetoden för att komma åt databasen.
Aggregera data från flera klienter i stor skala: Användare med tillräcklig åtkomstbehörighet kan köra en standardaggregeringsfråga på flera klientorganisationers data.
Fragmentering av omfattningar: Eftersom alla klienter matar in data i samma tabell kan data vanligtvis konsolideras och effektivt matas in i en eller några få omfattningar.
Materialiserade vyer och partitioneringspolicy: Dessa kan användas på en multitenant-tabell. Du kan förbättra prestanda genom att partitionera kolumnen Klient-ID eller motsvarande. Mer information finns i Scenarier för partitionsprinciper.
Event Grid- och Event Hubs-dataanslutningar: Du konsoliderade dataanslutningar eftersom data för alla klienter hamnar i en tabell.
Arkitektur: En hyresgäst per tabell i en enda databas

Den här arkitekturen är en kombination av tidigare arkitekturer där data för alla klienter hamnar i en enda databas men separata tabeller. Den här arkitekturen kan inte samla in alla fördelar med de andra arkitekturerna.
Även om varje klientorganisations data är åtskilda finns de alla i samma säkerhetskontext i samma databas. Precis som arkitekturen för flera databaser kan den här arkitekturen leda till fragmentering i stor utsträckning. Tabellnamnet är olika för varje klientorganisation och därför måste frågorna anpassas för varje klientorganisation.