Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
Azure Data Explorer (ADX) är en fullständigt hanterad analysplattform för realtidsanalys av storskalig telemetri och loggdata. Den här artikeln förklarar hur kostnaden per GB som matas in beräknas i Azure Data Explorer, vilka faktorer som driver den och hur du kan optimera klustret för kostnadseffektivitet. Stordataanalysplattformar använder olika prismodeller. Många plattformar baserar prissättningen på faktorer som frågevolym, datainmatning, lagringstid och beräkningsresurser. Den här komplexiteten gör det svårt att jämföra priser mellan produkter.
För att förstå kostnaden för att använda Azure Data Explorer använder den här artikeln måttkostnaden per GB som matas in. Det här måttet är den totala klusterkostnaden (beräkning, lagring, nätverk och tjänstpålägg) dividerat med den totala ursprungliga storleken data som matats in under den perioden.
En representativ ögonblicksbild av ADX-kluster i juni 2025 används för att grunda exempelanalysen. Följande avsnitt visar de viktigaste resultaten från analysen, förklarar vad som driver kostnadsvariationerna och hur användare kan optimera kostnaden per GB som matas in utan att äventyra prestandan.
Anmärkning
- Alla kostnadssiffror i den här artikeln visar listpriser och inkluderar inte rabatter eller åtagandebaserade besparingar.
- I den här exempelanalysen uttrycks kostnaden per GB i exempelkostnadsenheter (SKU:er), där varje SCU representerar en allmän kostnadsenhet, till exempel en US-cent.
- Information om listpriser och hur du beräknar dem finns i Priskalkylatorn för Azure Data Explorer.
Kostnad per GB inmatad analys
Diagrammet nedan visar medianvärdet för daglig GB som matats in i ursprunglig storlek (Y-axel) jämfört med mediankostnaden per GB som matas in (X-axeln) för varje kostnadsgrupp. Bubbelstorlek representerar gruppens andel av de totala data som matas in i tjänsten.
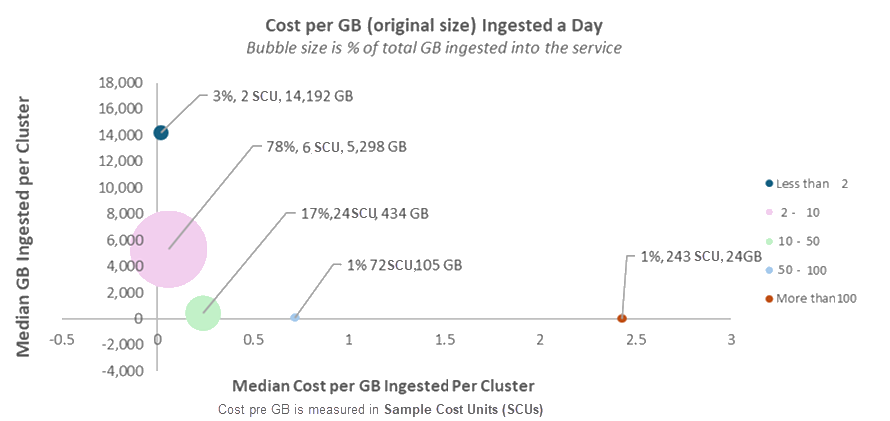
Kostnaden per GB som matas in varierar mellan kluster, men flera mönster sticker ut:
De flesta data (>75%) matas in till en kostnad mellan 2 och 10 SCUs per GB (före rabatter).
Mindre än 5% av datan bearbetas med mindre än 2 SCU:er per GB.
Även inom samma användningskategori (eller "bubbla") ser du en betydande variation. I den största bubblan matas till exempel ett kluster in med 2 SCU:er per GB, medan ett annat når 10 SCU:er per GB. Det är en 5X skillnad. I nästa avsnitt förklaras de viktigaste orsakerna till den här varianten.
Kluster med högre kostnad per GB är mindre vanliga och har vanligtvis lägre inmatningsvolymer. I allmänhet innebär mindre datavolymer högre kostnad per GB.
Viktigt!
Bubbeldiagrammet visar att kostnaden per GB som matas in varierar mellan kluster. Den här varianten indikerar inte bra eller dåliga metoder. Den återspeglar olika scenarier, konfigurationer och användningsmönster för tjänsten.
Ett kluster kan till exempel behålla data längre för efterlevnad, vilket ökar lagringskostnaderna. En annan kan använda uppdateringsprinciper som bearbetar data under inmatning, vilket ökar beräkningsanvändningen. Dessa scenarier är avsiktliga designval som är anpassade till specifika mål, och de påverkar naturligtvis kostnaden per GB.
Vad driver kostnaden per GB som tas emot
De här nyckelfaktorerna ligger bakom variationerna i kostnaden per GB som matas in per kluster:
Lagringstid: Ju längre du lagrar data, desto högre kostnad. Se kvarhållningsprincip.
Hög CPU-användning: Åtgärder som tunga frågor, databehandling eller transformeringar orsakar hög CPU-användning.
Cacheinställningar: Cachelagring av mer data ökar prestandan men kan öka kostnaderna. Se cache-policy.
Användning av kalla data: Förfrågningar som har åtkomst till kalla data utlöser lästransaktioner och ökar kostnaderna. Se frekvent och kall cache.
Dataomvandling och optimering: Funktioner som uppdateringsprinciper, materialiserade vyer och partitionering förbrukar CPU-resurser och kan öka kostnaden. Se Uppdatera principer, materialiserade vyer och partitioner.
Inmatningsvolym: Kluster fungerar mer kostnadseffektivt vid högre inmatningsvolymer.
Direktuppspelning jämfört med köad inmatning: Var och en har en annan kostnadsprofil beroende på användningsfallet. Se streaming och i kö.
Schemadesign: Breda tabeller med många kolumner behöver mer beräknings- och lagringsresurser, vilket ökar kostnaderna.
Avancerade funktioner: Alternativ som följare, privata slutpunkter och Python-sandbox-miljöer förbrukar mer resurser och kan öka kostnaden.
Val av datapipeline: Vissa inmatningsvägar kostar mindre. Event Grid-inmatning är till exempel vanligtvis billigare än Event Hubs.
Autoskalning: Kluster utan autoskalning kostar ofta mer eftersom de inte justerar sin storlek baserat på efterfrågan.
Du kan konfigurera de flesta av dessa faktorer för att optimera både prestanda och kostnad.
En närmare titt på viktiga kostnadsdrivrutiner
Det här avsnittet utforskar de viktigaste faktorerna som påverkar kostnaden per GB som matas in i Azure Data Explorer, vilket ger insikter om hur du kan hantera och optimera dessa kostnader.
Datakvarhållningspåverkan på kostnaden
I ADX lagras alla inmatade data i beständig lagring. Varje tabell och materialiserad vy har en kvarhållningsprincip som definierar hur länge data sparas. Desto längre data behålls, desto högre kostnad, baserat på priser för Azure Storage. När du behöver långsiktig lagring, till exempel för efterlevnad, ökar kostnaden per GB som matas in eftersom den inkluderar löpande lagringskostnader.
Utöver den omfattningsstorlek som rapporterats av klustret finns det två ytterligare kostnadsdrivrutiner:
- Kvarhållningsbuffert: Ytterligare 7 dagars data lagras som standard för att skydda mot oavsiktlig dataförlust.
- Omkostnader för återställning: För tabeller där återställningsinställningen är aktiverad (standard) behålls data i ytterligare 14 dagar. Detta inkluderar mellanliggande blobar som genereras under sammanslagnings- och återskapandeåtgärder.
Klusterstorlek
Klusterstorlek är antalet datorer (noder) i klustret. Varje dator lägger till kostnader, beroende på dess typ (SKU). Autoskalning justerar klusterstorleken baserat på CPU-användning, så att systemet kan optimera kostnader och prestanda genom att undvika inaktiva eller redundanta resurser.
Autoskalning justerar klusterstorleken för att säkerställa att cachelagrade data passar inom det tillgängliga SSD-utrymmet. Därför kan en stor cache öka klusterstorleken och om processoranvändningen är låg kan detta leda till en högre kostnad per GB. Mer information om hur du optimerar cachestorleken finns på cachflikenverktyget Clusters Insight.
Kluster som kör många frågor eller utför processorintensiva uppgifter som materialiserade vyer, uppdateringsprinciper eller partitionering kan skala klustret, vilket ökar kostnaden per GB. Observera att dessa funktioner avsevärt kan öka frågeprestanda och minska frågans CPU-användning och därmed förbättra den övergripande effektiviteten.
Datavolym som matas in
När ett kluster växer läggs fler noder till, vilket ökar den totala kostnaden. Den kostnaden är spridd över alla inmatade data, så ju mer data du matar in, desto lägre kostnad per GB.
Användning av kalla data
När frågor ofta får åtkomst till kalla data som lagras på disk orsakar de lästransaktioner som använder mer resurser och kan öka den totala klusterkostnaden.
Direktuppspelning jämfört med köad inmatning
Varje inmatningsmetod har olika egenskaper för kostnader, svarstider och funktioner, så var och en är bättre för olika scenarier. För kostnader är strömmande inmatning billigare när du matar in många små tabeller med klusslande data, medan köad inmatning är mer kostnadseffektivt för stora tabeller.
Tips/Råd
Optimera kostnaden per GB som matas in
Kontrollera konfigurationerna för de viktigaste kostnadsdrivrutinerna för att säkerställa att de passar klustrets behov och tjänstkrav för effektivitet. I synnerhet:
- Minimera frågor över kalla data för att minska lästransaktioner.
- Aktivera autoskalning för att dynamiskt matcha klusterstorleken efter efterfrågan.