Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
Projektet sdp-meta från Databricks Labs innehåller verktyg för att generera pipelines från metadata som du underhåller.
Note
Det open-source sdp-meta-projektet, liksom alla projekt i databrickslabs GitHub-konto, finns endast för utforskningsändamål. Azure Databricks stöder det inte eller tillhandahåller serviceavtal (SLA) för det. Skicka inte in Azure Databricks-supportärenden för problem som rör det här projektet. Skapa i stället ett GitHub problem, som granskas när tiden tillåter.
Vad är sdp-meta?
Med Lakeflow-pipelines kan du deklarativt ange en tabell och generera ett flöde i en pipeline som både skapar tabellen och håller den uppdaterad när källdata ändras. Men om din organisation har hundratals tabeller är det tidskrävande att generera och hantera dessa pipelines, vilket kan leda till inkonsekventa metoder.
SDK-metaprojektet är ett metadatadrivet metaprogrammeringsramverk utformat för att arbeta med Lakeflow-pipelines. Det här ramverket möjliggör automatisering av brons- och silverdatapipelines genom att använda metadata som registrerats i en uppsättning JSON- och YAML-filer. Vid körning läser generiska pipelines din metadata och bygger dynamiskt de flöden som beskrivs i den. Brons- och silverbearbetning kan ske i separata pipelines eller tillsammans i en kombinerad pipeline. Du genererar metadata för dina pipelines, och sdp-meta genererar dina pipelines.
Med logiken centraliserad på ett ställe (metadata) är systemet snabbare, återanvändbart och enklare att underhålla.
Note
Projektet sdp-meta hette tidigare dlt-meta, efter den äldre Delta Live Tables-funktionen i Azure Databricks.
Delta Live Tables har ersatts av Lakeflow-pipelines, och sdp-meta arbetar med Lakeflow-pipelines. Om du uppgraderar en befintlig dlt-meta installation, se migreringsguiden i sdp-meta-dokumentationen.
Fördelar med sdp-meta
Det finns två huvudsakliga användningsområden för sdp-meta:
- Importera och rensa enkelt ett stort antal tabeller.
- Framtvinga datateknikstandarder för flera pipelines och användare.
Fördelarna med att använda en metadatadriven metod är:
- Att underhålla metadata kan göras utan kunskap om Python- eller SQL-kod.
- Att underhålla metadata i stället för koden kräver mindre omkostnader och minskar felen.
- Koden genereras av sdp-meta, så den förblir konsekvent och har mindre anpassad kod över pipelines och publicerade tabeller.
- Du kan enkelt gruppera tabeller i pipelines i metadata, vilket genererar det antal pipelines som behövs för att mest effektivt uppdatera dina data.
Hur SDP-meta fungerar
Följande bild visar en översikt av sdp-metasystemet:
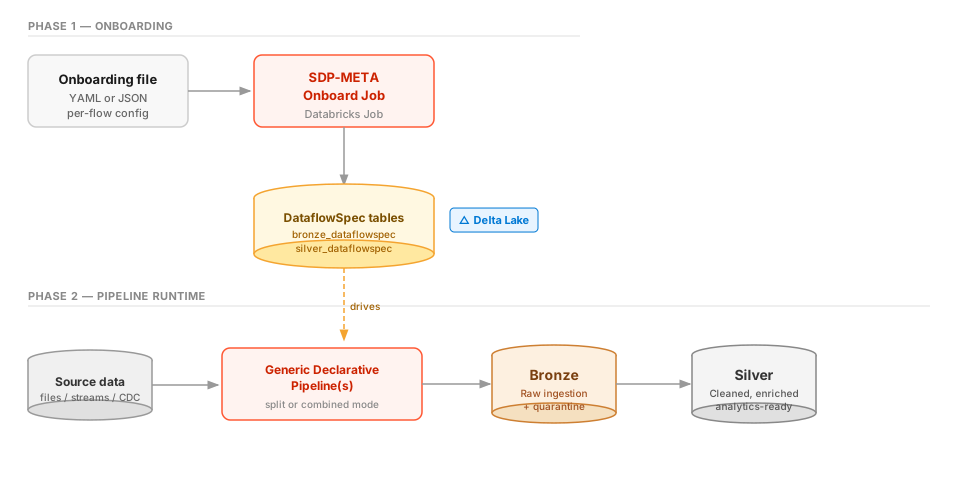
- Du skapar metadatafilerna som indata till sdp-meta, för att specificera dina källfiler och utdata, kvalitetsregler och nödvändig bearbetning. Dessa onboardingfiler kan skrivas i JSON eller YAML.
- Du ansvarar för sdp-meta-onboardingjobbet. Motorn kompilerar onboardingfilerna till en dataflödesspecifikation, kallad DataflowSpec, och lagrar dem i deltatabeller (
bronze_dataflowspecochsilver_dataflowspec) för senare användning. - Vid körning läser en generisk pipeline DataflowSpec och bygger dynamiskt bronsbearbetningsgrafen. Den läser dina källdata (filer, strömmar eller CDC) och tillämpar rätt datakrav i enlighet med dina kvalitetsregler, genererar dina bronstabeller och sätter poster som inte uppfyller dessa regler i karantän.
- Silverbearbetning kan köras i en separat generisk pipeline, vilket är standard för Deklarative Automation Bundles, eller i samma pipeline när du använder kombinerat läge. Pipelinen använder DataflowSpec för att tillämpa lämpliga transformationer och annan bearbetning och genererar silvertabeller som är rensade, berikade och klara för analys.
Du kör pipelines genererade av sdp-meta för att hålla utdata uppdaterade när din källdata uppdateras.
Get started
För att använda sdp-meta måste du:
- Distribuera och konfigurera sdp-meta-lösningen.
- Förbered metadata för dina tabeller i brons- och silverlagret.
- Skapa ett jobb för att registrera metadata.
- Använd metadata för att skapa pipelines för dina tabeller.
SDK-metaprojektet stöder flera distributionsgränssnitt: paket (rekommenderat), en interaktiv CLI, en Databricks-app med webbläsarbaserat GUI, en MCP-server för AI-assisterad installation och en portabel Agent Skill för färdighetsmedvetna AI-agenter.
Dokumentationen för sdp-meta på GitHub har en handledning som hjälper dig att komma igång med denna process. För mer information, se hur du startar med sdp-meta på GitHub.