Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
Important
Objekt som har markerats som förhandsversioner i den här artikeln är för närvarande i förhandsversion. Den här förhandsversionen tillhandahålls utan ett serviceavtal och Microsoft rekommenderar det inte för produktionsarbetsbelastningar. Vissa funktioner kanske inte stöds eller kan vara begränsade. Mer information finns i Kompletterande villkor för användning av Microsoft Azure-förhandsversioner.
Important
Interaktiv träning kräver uttryckligt godkännande för åtkomst. Begär åtkomst via registreringsformuläret för förhandsversionen och vänta på godkännande innan du skapar en utbildningssession.
Interaktiv träning (förhandsversion) är ett API för att skapa en egen process för efterträning för modeller med öppna vikter i Microsoft Foundry. Du kontrollerar experimentet i Python. Foundry kör modellsampling och loRA-uppdateringar (low-rank adaptation) på serverlösa GPU:er.
För förstärkningsinlärning (RL) styr din kod insamling av rollouter, belöningar, fördelar och schemaläggning av uppdateringar. Samma primitiver stöder övervakad inlärning, preferensinlärning, destillation och arbetsflöden med anpassad förlustfunktion.
När du ska använda detta
Använd interaktiv träning när själva träningsloopen är en del av din forskning:
- Du behöver en anpassad inlärningssignal. Tillhandahåll demonstrationer, beräkna belöningar och fördelar, eller skapa en lokal förlust för preferensinlärning eller andra mål.
- Din modell interagerar med en miljö. Samordna modellsvar, verktygsanrop, observationer och belöningar i din drivrutin.
- Du behöver kontroll över enskilda uppdateringar. Välj batchar, tokenmasker, förlustinställningar och optimeringsparametrar. Bestäm när du ska ackumulera gradienter och tillämpa en uppdatering.
- Du vill inspektera och anpassa ett experiment. Exempel från den aktuella adaptern, utvärdera på reserverade testprompter och välj nästa prompt baserat på observerade resultat.
- Du måste bevara och fortsätta framstegen. Spara adapter och optimerartillstånd och återuppta sedan i en kompatibel session. Behåll datamängdens position och andra experimenttillstånd i drivern.
Hanterad fine-tuning stöder även bedömare för förstärkningsfinjustering. Välj interaktiv träning när du behöver kontroll över loopen, inte bara inställningarna för gradern eller jobbet. Se Välj din träningsmetod.
Vem gör vad
Ditt Python-program är träningsdrivrutinen. Den förbereder indata och samordnar experimentet. Foundry underhåller modellen och adaptertillståndet och kör de begärda åtgärderna.
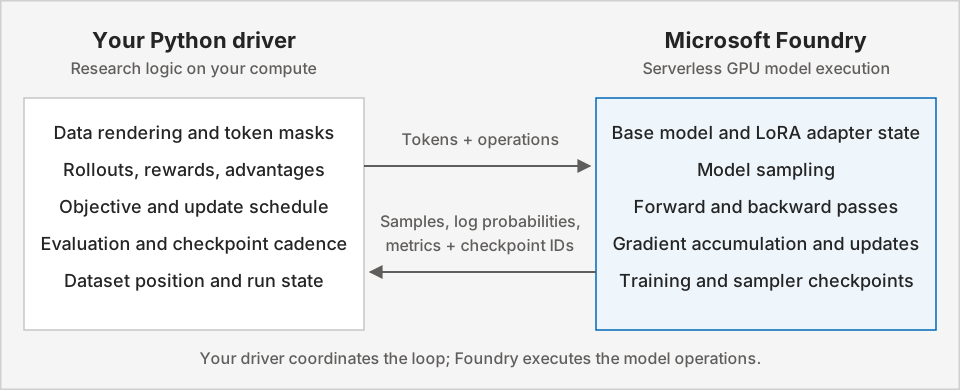
Drivrutinen kan köras på en processor, inklusive din egen dator eller en beräkningsmiljö. En belöningsmodell eller miljö som du lägger till kan ha egna beräkningskrav. Håll drivern igång medan den hanterar loopen.
Grundläggande begrepp och primitiva datatyper
En session är tillståndskänslig: gradientberäkning, uppdateringar av optimeraren och sampling är separata åtgärder på en vald modell och en adapter. Med den här separationen kan du välja när du vill samla in data, ackumulera gradienter, uppdatera och utvärdera.
| Grundsten | Vad det gör |
|---|---|
| Träningssession och LoRA-adapter |
FineTuningSession.create initierar en basmodell med stöd med din adapterkonfiguration. Sessionen innehåller det tillstånd som används av efterföljande åtgärder. |
| Tokeniserade batcher och masker |
Datum bär modellindata och förlustindata. Masker anger vilka token som bidrar till inlärning, till exempel assistenttoken i stället för uppmaningar eller verktygsobservationer. |
| Provtagning |
sample genererar svar från en vald samplerkontrollpunkt. RL-indata parar ihop samplade token med deras loggsannolikheter från rollout och belöningsbaserade advantage-värden. |
| Framåt- och bakåtpass |
forward returnerar utdata för förlustfunktionen per exempel utan att ackumulera gradienter.
forward_backward beräknar det valda målet och ackumulerar gradienter. Den tillämpar inte en uppdatering av optimeraren. |
| Uppdatering av optimeraren |
optim_step tillämpar ackumulerade gradienter med dina Adam-parametrar. Du väljer när du ska uppdatera och vilken inlärningshastighet som ska användas. |
| Samplerkontrollpunkt |
save_weights_for_sampler förbereder adapterparametrar för generering. Läs in dessa vikter på nytt efter en uppdatering före sampling från den uppdaterade adaptern. |
| Träningscheckpoint |
save_weights bevarar adaptervikter och optimerartillstånd.
FineTuningSession.create_from_checkpoint återupptar träningen i en kompatibel session. |
SDK inkluderar cross_entropy för övervakade uppdateringar och RL-förluster som importance_sampling och ppo. Dessa förluster är förlustprimitiver, inte fördefinierade algoritmer från slutpunkt till slutpunkt. Se Viktiga begrepp för indatakontrakt och anpassad förlustsammansättning.
Så här fungerar en RL-loop
Överväg ett matematiskt resonemangsexperiment: din modell genererar flera svar på varje problem och ditt program bedömer deras korrekthet. Ett genomarbetat exempel följer du Kom igång.
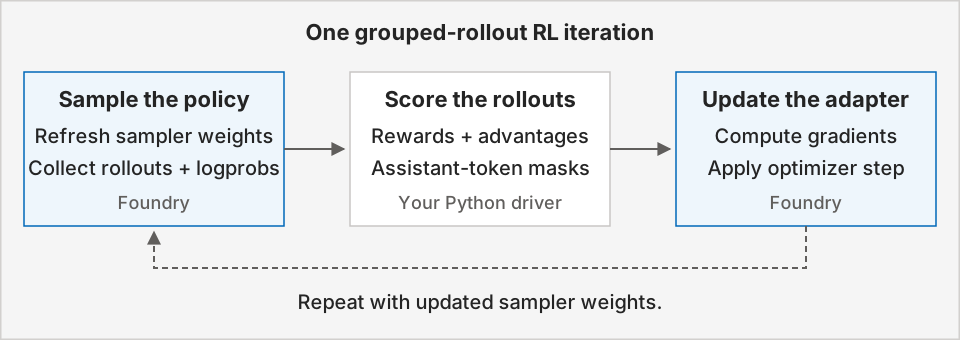
Upprätta en separat valideringsbaslinje och testa din belöningsfunktion före den första uppdateringen. Upprepa sedan:
- Förbered den aktuella policyn för sampling. Spara exempelvikter från träningsadaptern och samla sedan in flera svar, eller rollouts, för varje prompt.
- Poängsätt och jämför svar. Din belöningsfunktion tilldelar en poäng till varje rollout. Subtrahera promptgruppens genomsnittliga belöning för att skapa varje rollouts fördel.
- Förbered inlärningssignalen. Justera samplade assistenttoken med deras rollout-loggsannolikheter och advantage-värden. Exkludera uppmaningar och miljöobservationer från inlärningssignalen.
- Beräkna gradienter. Skicka in batchen till
forward_backwardmedimportance_sampling. Slutför gradientberäkningen före uppdateringen som förbrukar den. - Uppdatera adaptern. Anropa
optim_stepoch uppdatera sedan exempelvikter innan du samlar in svar från den uppdaterade policyn. - Utvärdera och bevara framsteg. Jämför korrekthet på valideringsdata med baslinjen och spara checkpoints för träning vid ditt valda intervall.
Get started
Välj den startpunkt som passar din uppgift:
- Snabbstart: Följ snabbstartsexemplet för att klona lagringsplatsen och köra ett kort recept för förstärkningsinlärning.
- Prova andra recept: Utforska repo för finjusteringsexempel för fler träningsexempel.
- Slå upp en operation: Använd SDK-fuskbladet (förhandsversion) för funktioner och nyckelparametrar.
- Förstå träningsloopen: Läs Viktiga begrepp för belöningar, fördelar, tokenmasker och checkpoints.
Modeller och regioner som stöds
Se översikten för finjustering för modeller som stöds och regioner som stöds.