Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
Den här artikeln beskriver en sexfasprocess för att migrera en LLM-driven arbetsbelastning från en basmodell till en annan: vad du bör tänka på i varje fas, vilken Microsoft Foundry-funktioner gäller och hur arbetet ändras för olika typer av team.
Vad modellmigrering innebär
Varje modell som du kör i produktion har ett slutdatum. När en modell som du är beroende av ersätts, eller när en nyare modell skulle fungera bättre för din arbetsbelastning, migrerar du. Att byta en modell är inte en enradsändring: en annan modell kan tyst skifta ton, formatering, JSON-form, svarstid, kostnad eller verktygsanropsbeteende och bryta nedströmskod som är beroende av det gamla beteendet.
En lyckad migrering bevarar programmets beteende eller förbättrar det på mätbara sätt. Framgång kräver en repeterbar process för att upptäcka drift, anpassa sig på ett säkert sätt och bevisa kvalitet före bred distribution.
När du ska migrera
En migrering startar vanligtvis av någon av fyra orsaker:
- En modell dras tillbaka. På Foundry levereras varje allmänt tillgänglig modell med ett datum för när den tas ur bruk, och äldre modellfamiljer ersätts med tiden. Information om policy och datum för utfasning finns i Foundry Models livscykel- och supportpolicy och schema för modellutfasning.
- Det finns en bättre modell. En nyare modell erbjuder högre kvalitet, lägre kostnad, bättre svarstid eller en funktion (till exempel strukturerade utdata eller förbättrat verktygsanrop) som din arbetsbelastning behöver.
- Ett problem med kostnader eller svarstider tvingar fram en ändring. Den aktuella modellens svarstid eller enhetskostnad uppfyller inte längre dina behov.
- Ett kapacitetsgap blockerar produkten. Den aktuella modellen kan inte göra något som din produkt nu kräver.
Vad händer på pensionsdatumet
Vad Azure gör när en modell tas ur bruk beror på hur du köper kapacitet, och Foundry använder olika termer för varje alternativ:
-
Standard-, Global Standard- och Data Zone Standard-distributioner (betala per användning)uppgraderas automatiskt enligt ett rullande schema för varje region. Du styr tidsinställningen med
versionUpgradeOptioninställt på något av:OnceNewDefaultVersionAvailable,OnceCurrentVersionExpiredellerNoAutoUpgrade(vilket innebär att distributionen slutar fungera vid pensionering). Prioriterad bearbetning följer samma väg. - Etablerade (PTU) -distributioner uppgraderas inte automatiskt. Du migrerar dem själv, antingen på plats (trafiken flyttas över ett fönster på 20–30 minuter utan stilleståndstid) eller sida vid sida (ställ upp den nya distributionen, testa, flytta trafik, ta bort den gamla).
- Batchdistributioner följer en strategi sida vid sida: distribuera den nya modellen, skicka om jobben och avveckla den gamla distributionen.
Oavsett vilken sökväg som gäller är utvecklarutmaningen densamma: vid ett angivet datum börjar trafiken träffa en annan modell. En slutpunkt som fortfarande svarar innebär inte att appen fortfarande fungerar korrekt, så både automatiskt uppgraderade och manuellt migrerade arbetsbelastningar drar nytta av utvärderingen och valideringen som beskrivs i den här artikeln.
Migrera före slutdatumet
Automatisk uppgradering fungerar bara som ett skyddsnät för distributioner med användningsbaserad betalning, inte som en plan för migrering. Provisionerade driftsättningar har inget säkerhetsnät. Hur som helst är det inte en ersättning för en migreringsplan. Två policyåtaganden ger dig utrymme att migrera enligt ditt eget schema i stället för att vänta på tidsgränsen:
- Ersättningsmodellen blir tillgänglig cirka 90 dagar före pensioneringen i Global Standard och cirka 30 dagar före pensioneringen i etablerade regioner där föregångaren går i pension. Använd det här fönstret för att utvärdera den nya modellen och migrera manuellt.
- Pensionsdatum kan inte förlängas. Det finns ingen undantagsprocess, så ett datum som du inte planerade för gäller fortfarande för dig.
Du behöver inget utfasningsmeddelande för att starta. Om en nyare modell är billigare, snabbare eller mer kapabel kan du köra den genom processen nu. Att migrera omvandlar avsiktligt pensionsdatumet till en formalitet. Eftersom migreringar upprepas är det värt att göra processen repeterbar.
Vem ska använda migreringsprocessen?
Migreringsprocessen passar bäst när ditt team skapar en LLM-baserad funktion i en större produkt eller plattform, migrerar på en ungefär kvartalsvis takt och har en tydlig ägare (till exempel ett centralt plattformsteam eller appteamet) som kör varje migrering avsiktligt.
Den här processen passar även AI-nativa team, där modellen är produkten. Faserna är desamma, men de körs snabbare och ofta parallellt i stället för i strikt sekvens.
Processen förutsätter att du växlar mellan basmodeller, det vill säga modeller som du driftsätter i den form de publiceras i modellkatalogen, utan anpassning på viktnivå. Finjusterade arbetsbelastningar ligger utanför omfånget. De kan inte uppgraderas automatiskt, eftersom de har en egen tidslinje för när träning och driftsättning tas ur bruk. Att anpassa finjusterade arbetsbelastningar innebär destillation eller omträning i stället för prompt- och schemaändringar. Om du använder finjusterade driftsättningar bör du planera att finjustera på nytt mot den ersättande basmodellen i god tid.
Migreringsfaser
En migrering går igenom sex faser. Varje fas genererar utdata som nästa fas använder. Migreringsfaserna är:
Identifiera → Utvärdera → Anpassa → verifiera → → dra tillbaka
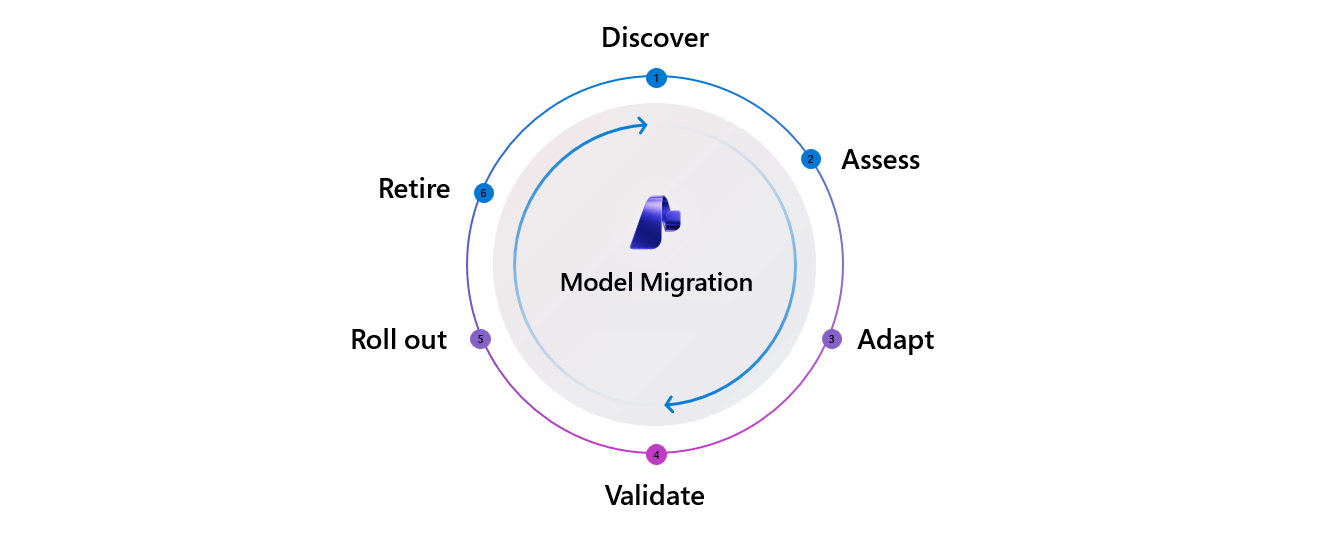
Följande tabell beskriver varje fas och de Foundry-funktioner och verktyg som stöder den. Funktioner är tillgängliga i både Microsoft Foundry och Azure OpenAI om de inte bara är markerade med Foundry, vilket innebär att Azure OpenAI inte har någon motsvarighet.
Avsnitten per fas senare i den här artikeln förklarar varför varje fas finns, hur ett lyckat resultat ser ut, vad du bör tänka på, när du ska använda varje funktion och var fasen ofta bryts.
| Fas | Description | Funktioner och verktyg |
|---|---|---|
| Upptäcka | Lär dig att en modelländring kommer eller behövs och bestäm om du vill agera. |
|
| Värdera | Välj målmodellen och bekräfta att den är driftstillgänglig. |
|
| Anpassa | Spela upp den aktuella arbetsbelastningen på den nya modellen, diagnostisera beteendeändringar och omkonstruera frågor, parametrar, verktygsdefinitioner, utdatascheman och den anropande koden runt dem. |
|
| Verifiera | Poängsätta den anpassade arbetsbelastningen mot ett kvalitetskriteriet för att avgöra om det är säkert att skicka. |
|
| Rulla ut | Befordra till produktion genom stegvis exponering, övervaka beteendet i drift och genomför eller rulla tillbaka. |
|
| Dra tillbaka | Avveckla den gamla driftsättningen, frigör kapacitet, arkivera utvärderingar och uppdatera dokumentationen för nedströmsledet. |
|
Innan du migrerar: Förbered en testdatauppsättning
Det här förberedelsesteget sammanställer en uppsättning representativa indata, förväntade utdata och överenskomna framgångskriterier innan något migreringsarbete påbörjas. Den här uppsättningen är ett avgörande beroende i mitten av processen: du kan inte köra om i anpassningsfasen utan indata, och du kan inte poängsätta i valideringsfasen utan facit och kriterier.
Vad du bör tänka på
- Skapa datamängden innan du väljer ett mål. Datauppsättningen beskriver din arbetslast, inte kandidatmodellen, så du kan sammanställa den parallellt med Discover.
- Samla in indata från verkliga eller syntetiska källor. Använd insamlad produktionstrafik eller utvalda domänexempel som CSV eller JSONL. När du inte har representativa data än genererar du syntetiska och kontradiktoriska indata med simulatorn.
- Samla in instrumentdata innan du behöver den. Inspelning av produktionsinnehåll kräver aktivering och är aldrig retroaktiv, så du kan inte analysera trafik som du inte spelade in. Starta loggningsprompter, svar, svarstid och tokenantal nu.
- Frys datauppsättningen. Håll indata, grundsanningar och framgångskriterier fasta för hela migreringen. Om någon av dem ändras kan du inte längre jämföra käll- och målresultat.
Du behöver också en inventering över de modelldistributioner som din arbetslast använder, inklusive deras distributionstyper (Standard, Provisioned eller Batch). För varje källmodell bör du notera dess pensionsdatum och föreslå ersättning från modellens pensionsschema.
Fas 1: Identifiera
Syftet med upptäcktsfasen är att upptäcka att en modelländring är på väg eller värd att genomföra och att avgöra om man ska agera. Resultatet är ett beslut om att gå vidare eller inte, och att fortsätta med den nuvarande modellen är också ett giltigt val. Ett lyckat resultat är en tidig, strukturerad signal som ger dig utfasningsdatum, ersättningsmodell och migreringsfönster, eller ett avsiktligt beslut att behålla den aktuella modellen.
Vad du bör tänka på
- Vad är pensionsdatumet, och hur mycket landningsbana har du egentligen? Behandla utfasningsdatumet minus validerings- och distributionstiden som den verkliga tidsgränsen.
- Finns det en namngiven föreslagen ersättare, eller behöver du nominera kandidater själv?
- Har ändringen efterlevnads- eller regionala begränsningar (för reglerade arbetsbelastningar spelar tillgänglighet och certifiering ofta roll innan kvaliteten gör det)?
Där det ofta bryts
Team får inkonsekvent information om avvecklingar via ett e-postmeddelande, en banner i en portal eller ett internt meddelande, och de uppmärksammar det sent. Den fördröjningen förkortar ett redan tätt fönster. Ensamutvecklare och små team upptäcker ofta att något har avvecklats genom ett fel i produktion i stället för genom ett tillkännagivande.
Vad du tar med dig
Pensionsschemat och modell-API:et exponerar data på ett stabilt kontrakt. Mogna organisationer lägger till ett tunt internt meddelandelager ovanpå för att dirigera det till rätt ägare.
Fas 2: Utvärdera
Syftet med utvärderingsfasen är att välja kandidatmålmodellen och bekräfta att du kan köra den: rätt region, rätt distributionstyp, tillräckligt med kvot och tillgänglighet tillsammans med den aktuella modellen så att återställning förblir möjlig. Ett lyckat resultat är ett tydligt val bland kandidatmodeller, där region, SKU, kvot och kostnad bekräftas innan justeringen startar.
Vad du bör tänka på
- Kvalitet och positionering mellan kandidater. När flera modeller används parallellt ska du avgöra vilken som passar din arbetslast bäst utifrån kvalitet, inte bara vilken som får högst poäng i ett offentligt benchmark.
- Kostnad för egen trafik. Prisstrukturen skiftar mellan modellgenerationer. Resonemangstoken, cachelagrad indata och overhead för strukturerade utdata kan få enhetsekonomin att variera med en faktor på två eller mer, så prognostisera månadskostnaden utifrån historisk trafik snarare än enbart utifrån listpris.
- Drifttillgänglighet. Bekräfta region, SKU och kvot och att målet kan köras sida vid sida med källan så att du behåller en återställningssökväg.
- Efterlevnadskontroll. För reglerade arbetsbelastningar kan certifiering och regional tillgänglighet filtrera kandidatlistan innan kvaliteten går in i konversationen.
Där det ofta bryts
Beslutsförlamning uppstår när flera kandidater har otydlig positionering. Team upptäcker bara mitt i planen att den valda modellen inte är tillgänglig i deras region eller SKU. Eller så visar en kostnadsprognos att den nya modellen är väsentligt dyrare för verklig trafik.
Vad du tar med dig
Benchmarks beräknas på offentliga datauppsättningar, så behandla rankningslistan som ett filter i stället för mållinjen och bekräfta slutlistan mot din egen arbetsbelastning. Kostnadsprojektion är samma sak: månadsvyn kommer från dina egna tokenloggar, vilket är enkelt när du har trafikdata.
Fas 3: Anpassa
Syftet med Adapt-fasen är att arbetsbelastningen ska fungera bra på den nya modellen. Spela upp den befintliga arbetsbelastningen oförändrad först (för att isolera modelldrivna beteendeändringar), diagnostisera vad som skiftade och sedan iterativt återskapa. Ett lyckat resultat är en jämförelse av beteendet sida vid sida mot verklig eller representativ trafik, med varje ändring spårad.
Anpassa är mer än snabbredigering
Promptar är den mest synliga delen, men en migrering berör vanligtvis fyra andra områden:
-
Parametrar.
temperature,top_p,max_tokens, och kontroller för resonemangsinsats motsvarar inte varandra exakt mellan olika generationer, och nyare modellfamiljer kanske inte stöder vissa parametrar. - Verktygsdefinitioner. Du kan behöva omformulera eller skärpa argumentnamn, beskrivningar och obligatoriska fält som vägledde den gamla modellen på ett tillförlitligt sätt.
- Utdatascheman. Modellerna skiljer sig åt i hur de följer strukturerade utdata. Du kan behöva lägga till explicita begränsningar i ett schema som den gamla modellen löst uppfyllde, eller så kanske du äntligen kan tillämpa ett schema.
- Anropar kod. Skillnader i API och SDK (Chat Completions jämfört med Responses, streamingformat samt nya eller omdöpta begärandefält). Du kan också behöva uppdatera underordnad parsning som antog den gamla svarsformen.
För agentiska arbetsbelastningar och arbetsflödesarbetsbelastningar överväger schema- och verktygsanropsarbete ofta promptarbetet.
Vad du bör tänka på
- Spela upp igen utan ändringar innan du justerar. Kör den aktuella konfigurationen på målmodellen utan några ändringar. Den här metoden hjälper dig att separera det beteende som modellen ändrade från de ändringar du introducerar och ger dig en baslinje.
- Se vad som faktiskt förändras. Utförlighet, resonemangsdjup, efterlevnad av strukturerad utdata, utformning av verktygsanrop, avvisningsbeteende och latensvariation förändras alla ofta.
- Spela upp verkliga spår för att upptäcka regressioner i verktygsanrop. Extra fält, omdöpta argument och ändrad sekvenseringsyta endast i verkliga spårningar, inte i prestandamått med en enda tur.
- Spåra dina ändringar. Snabb ombyggnad är lätt att göra och lätt att förlora. Behåll originalet och registrera vad som har ändrats och varför.
Foundry-funktioner
Tre Foundry-funktioner stöder den här fasen:
- Prompt Optimizer är knappen Optimera direkt under fältet systeminstruktioner i agentlekplatsen. Den omstrukturerar dina instruktioner med hjälp av metodtips för prompt-engineering, visar resonemang per stycke för varje ändring och stöder en iterate-loop: lägg till ett förslag som "behåll JSON-schemat exakt" och optimera igen. Endast tillgängligt i Foundry, inte Azure OpenAI.
- Agentoptimering justerar instruktioner, verktyg och modellval tillsammans för agentarbetsbelastningar. Endast tillgängligt i Foundry, inte Azure OpenAI.
- Simulatorn genererar syntetiska och kontradiktoriska indata när du inte har produktionsdata att spela upp.
Där det ofta bryts
För inbäddade, produktinriktade arbetsbelastningar tar den här fasen vanligtvis mest tid eftersom diagnosloopen är manuell: team kör om prompter, jämför skillnaderna och registrerar sällan vad de har ändrat eller varför.
Vad du tar med dig
- Börja med optimerarna och verifiera sedan. De tillämpar allmänna metodtips i ett enda pass i stället för att passa din datauppsättning, och de justerar instruktionstext i stället för verktygsdefinitioner eller utdatascheman. Behandla utdata som ett starkt utkast: kopiera den ursprungliga prompten först (det finns ingen versionshistorik) och utvärdera sedan mot din frusna datauppsättning innan du litar på ändringen.
- Planera för extra manuellt arbete vid flyttar mellan olika familjer. Det finns inget "optimera för målmodell X"-flöde, så att flytta mellan modellfamiljer innebär avsiktlig prompt- och schemaöversättning.
- Registrera trafik innan du behöver den. Replay är bara så bra som det du fångar upp, och insamling av innehåll måste aktiveras och gäller aldrig retroaktivt.
Fas 4: Verifiera
Syftet med valideringsfasen är att avgöra om den anpassade arbetsbelastningen är säker att skicka genom att bedöma den mot ett kvalitetskriterium på en kurerad datauppsättning. Bedömningsramverket kan vara regelbaserat, referensbaserat, en LLM som domare, mänsklig granskning eller ett domänspecifikt ramverk. Ett lyckat resultat är att leverera en tillförlitlig utvärderingssvit som körs på ett låst dataset och som både appteamet och eventuella granskare har förtroende för.
Validering är en fas, men den har två beröringspunkter, så behandla den inte som en enskild slutpunktshändelse:
- Förbered dig tidigt. Lås datauppsättningen och framgångskriterierna i Innan du migrerar innan du anpassar dig. I samma ögonblick som dessa ändras slutar källan och målet att vara jämförbara.
- Gate sent, i två pass. Kör först den aktuella modellen på den frysta testmängden för att fastställa en ursprungsbaslinje, det värde du måste överträffa. Poängsätt sedan target på samma uppsättning och avgör.
Vad du bör tänka på
- Håll datamängden och kriterierna låsta. Detta är den enskilt viktigaste disciplinen i processen för att hålla resultaten jämförbara.
- Mät de tre dimensioner som ligger till grund för godkännande: kvalitet (poäng från utvärderare eller granskare), svarstid (tid till första token och genomströmning, begränsat till det anrop som du migrerar) och kostnad (kostnad för in- och utmatningstoken per begäran).
- Anpassa bedömningsmatrisen till arbetsbelastningen. En bedömningsmatris för kliniska sammanfattningar, ett påstående om sekvensering av verktygsanrop för agenter eller befintliga användaråterkopplingssignaler kan vara mer meningsfulla än ett generiskt poängvärde.
- Behandla grinden som en signal för AI-inbyggda team. I stället för en engångsbedömning av typen godkänd/underkänd körs utvärderingen kontinuerligt, vid varje commit, och integreras med Roll out.
Foundry-funktioner
Två Foundry-funktioner stöder den här fasen:
- Azure AI Evaluation SDK innehåller mer än 30 inbyggda utvärderare som omfattar förankring, relevans, informationshämtning, koherens, språkligt flyt, referensbaserade mått (F1, BLEU och ROUGE), säkerhet, agenter och Azure OpenAI-bedömare. Den innehåller också en anpassad LLM-as-judge för uppgiftsspecifika kriterier.
- Portalutvärdering använder samma utvärderare på modell-, agent-, dataset- och spårmål.
Kör den identiska uppsättningen utvärderare mot både källa och mål på den låsta datamängden så att siffrorna är jämförbara.
| Dimension | Vad du ska mäta | Where |
|---|---|---|
| Kvalitet | Utvärderarpoäng på källa jämfört med mål | Azure AI Evaluation SDK, portalutvärdering |
| Fördröjning | Tid till första token och genomströmning | Topplista för benchmark, driftsmått |
| Cost | Kostnad för in- och utdatatoken per begäran | Utvärderingsutdata, modellpriser |
Där det ofta bryts
De flesta team har ingen utvärderingssvit, och de som har en har ofta byggt den själva. För reglerade arbetsbelastningar tillkommer en obligatorisk mänsklig granskning eller kvalitetsgranskning, vilket blir den flaskhalsen. De här migreringarna stannar vid Verifiera, inte Anpassa.
Vad du tar med dig
Utvärderarna är redo att användas, men att sammanställa en testuppsättning som är relevant för domänen från din egen produktionstrafik är ett praktiskt arbete för modellarbetslaster (icke-agentbaserade). Det är därför förberedelsesteget betalar sig självt.
Fas 5: Lansering
Syftet med den här fasen är att höja upp den verifierade konfigurationen till produktion i steg: icke-produktion först, sedan en kanarie- eller viktad procentandel och sedan bredare exponering. Under hela processen ska du övervaka svarstid i realtid, fel och, helst, kvalitet jämfört med baslinjen före migreringen. Genomför sedan ändringarna eller återställ dem. Ett lyckat resultat är en gradvis exponering genom kanarie-, viktad eller skuggtrafik, en livekvalitetssignal utöver svarstid och fel och en bevarad återställningsväg.
Vad du bör tänka på
- Känna till din distributionstyp. Distributionstypen avgör mekaniken: Standard-family-distributioner kan uppgraderas automatiskt enligt ett schema som du styr. Etablerade, batchbaserade och finjusterade distributioner migreras manuellt. Följande tabell visar mekaniken efter typ.
- Bevara en återställningskorridor. Behåll den gamla driftsättningen tillgänglig tills du känner dig säker. Återställningsbeslut som framtvingas av en tidsgräns för utfasning i stället för av bevis är ett varningstecken som du började för sent.
- När du inte kan använda canary använder du skugg- eller speglingsläge. Reglerade flöden (PHI, finansiella transaktioner) kan ofta inte exponera en ny modell för verklig kundtrafik. Motsvarigheten kör den nya modellen på produktionsindata offline och jämför utdata med den gamla modellen utan att påverka användarna.
- Var uppmärksam på regressioner som offline-utvärderingen inte fångade upp. Latens för verkliga användare och beteende i gränsfall blir bara synliga vid produktionsbelastning.
Migreringsmekanik efter distributionstyp
| Distributionstyp | Migreringsmetod | Quota |
|---|---|---|
| Standard, Global standard, Standard för datazon | Automatisk uppgradering enligt ett löpande schema. Kontrollera tidsinställningen med versionUpgradeOption (OnceNewDefaultVersionAvailable, OnceCurrentVersionExpiredeller NoAutoUpgrade). Prioriterad bearbetning följer samma väg. |
Överförs automatiskt |
| Provisionerad | Manuell: på plats (trafiken flyttas över ett fönster på 20–30 minuter) eller sida vid sida (ny distribution, flytta trafik, ta bort den gamla). | Säkerställ först kvoten för målmodellen |
| Batch | Parallellt: distribuera den nya modellen, skicka in jobben igen och avveckla sedan den gamla distributionen. | Säkerställ kvoten för målmodellen |
| Finjusterad (ligger utanför den här artikelns omfattning) | Inte automatiskt uppgraderad; separat tränings- och distributionsavgångsklocka. Finjustera eller destillera till den nya basmodellen. | Säkerställ kvoten för målmodellen |
När trafiken har flyttats över konfigurerar du kontinuerlig utvärdering för att utvärdera en viss procentandel av produktionstrafiken på Foundry Observability-instrumentpanelen, kopplad till spårningar för grundorsaksanalys, samt Azure Monitor-aviseringar när kvaliteten sjunker.
Där det ofta bryts
Kvalitetsregressioner som offlineutvärderingen missade visas under produktionsbelastning. Återställningsbeslut tvingas ofta av en tidsgräns för utfasning snarare än av bevis, vilket är ett tecken på att migreringen startade för sent.
Vad du tar med dig
Viktad routning mellan två driftsättningar implementeras i din egen gateway eller i applikationslagret, och rollbackfönstret är ett medvetet val för att hålla den gamla driftsättningen varm under en viss period (team som arbetar med inbyggda system vill vanligtvis ha cirka 30 dagar). Båda är värda att ta fram en gång och återanvända vid varje migrering.
Fas 6: Dra tillbaka
Syftet med Retire-fasen är att avveckla den gamla driftsättningen, frigöra kapacitet, arkivera utvärderingsartefakter och kommunicera ändringen vidare till kundinriktad dokumentation, marknadsföringssidor, supportmanualer och revisionsloggar där bevarande krävs. Till slut är den gamla driftsättningen borta, antalet driftsättningar visar en nedåtgående trend och erfarenheterna förs vidare till nästa cykel.
Vad du bör tänka på
- Behandla pensionering som styrning, inte bara rensning. För reglerade arbetsbelastningar kan kvarhållningsskyldigheter kräva att artefakter bevaras i flera år.
- Kontrollera att källan verkligen är borta. Kontrollera att den gamla versionen har dragits tillbaka och ta sedan bort distributionen så att den slutar förbruka kapacitet.
- För lärdomarna vidare. För tillbaka nya produktionsspår till ditt guldstandarddataset så att nästa migrering blir billigare.
Där det ofta bryts
Team hoppar över pensioneringen, vilket leder till en ackumulering av zombiedistributioner. Team som inte aktivt avvecklar har betydligt fler aktiva driftsättningar än jämförbara team, och merparten av detta är strukturella rester från tidigare migreringar. Ett vanligt missat understeg är kommunikation: marknadsförings- och produktdokumentation refererar fortfarande till den gamla modellen efter växlingen.
Vad du tar med dig
Observability-dashboarden visar att antalet driftsättningar har en nedåtgående trend, men att avgöra vilka driftsättningar som fortfarande bär trafik är något som ditt team får bedöma. Gör pensionen till en explicit spårad uppgift snarare än ett hopp.
Migrering är sällan binär
Verkliga migreringar är ofta uppdelade: delar av arbetsbelastningen körs på den nya modellen medan en latenskänslig eller mer riskfylld del ligger kvar på den gamla, ibland i veckor. Planera för stegvis utrullning och stegvis återgång i stället för ett enda byte från den gamla modellen till den nya. Pensionering släpar ofta efter Rulla ut med veckor eller månader, och de kvardröjande gamla distributionerna är det som visas som spridning.
Relaterat innehåll
- Förstå tidslinjer för utfasning och support i Foundry Models livscykel- och supportpolicy
- Kontrollera pensionsdatum och ersättningar i modellens pensionsschema
- Se vad som redan har dragits tillbaka i tillbakadragna Microsoft Foundry-modeller
- Jämför kandidatmodeller med modellmått och rankningslistor
- Anpassa prompter till en ny modell med Optimera prompter med Prompt Optimizer
- Verifiera kvaliteten innan du växlar genom att köra utvärderingar från Foundry-portalen
- Övervaka den migrerade arbetsbelastningen med Observabilitet i generativ AI