Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
Flexbearbetning (förhandsversion) erbjuder inferens med 50 % rabatt jämfört med standardbearbetning för arbetsbelastningar som kan tolerera långsammare svarstider och att resurser ibland inte är tillgängliga. Välj Flex-bearbetning för en enskild begäran till Responses API eller Chat Completions API genom att ställa in service_tier på flex.
Använd Flex-bearbetning för icke-interaktivt och lågprioritetsarbete, till exempel modellutvärderingar, databerikning, dokumentanalys och asynkrona programarbetsflöden. För svarstidskänsliga eller kapacitetskänsliga arbetsbelastningar använder du Standardbearbetning, Prioritetsbearbetning eller etablerat dataflöde i stället.
Important
Med introduktionen av Flex-bearbetning bearbetas endast begäranden som är inställda service_tier på flex när den valda modellen stöder Flex-bearbetning. En modell som inte stöds returnerar en HTTP 400 invalid_request_error och återgår inte till Standard-bearbetning. Flex-bearbetning har inga SLA:er för latens eller tjänst.
Förutsättningar
Ett Azure-abonnemang. Skapa en kostnadsfritt.
En Azure OpenAI-resurs med en modell som stöds som distribueras med hjälp av distributionstypen Global Standard.
Resursslutpunkten och en API-nyckel eller Microsoft Entra ID autentiseringsuppgifter. Exemplen i den här artikeln använder en API-nyckel som lagras i
AZURE_OPENAI_API_KEYmiljövariabeln.En arbetsbelastning som kan tolerera variabel svarstid och tillfälliga resursotillgängliga svar.
Python 3.10 eller senare och OpenAI Python-paketet för Python exempel:
pip install --upgrade openai
Skicka en Flex-begäran
Ange service_tier till flex i varje begäran som ska använda Flex-bearbetning. Värdet model är namnet på din Azure modelldistribution.
Python
I följande exempel skickas en Flex-begäran med hjälp av svars-API:et:
import os

from openai import OpenAI

AZURE_OPENAI_ENDPOINT = "https://YOUR-RESOURCE-NAME.openai.azure.com"

# Create a client with a longer timeout for Flex requests.
openai = OpenAI(
    base_url=f"{AZURE_OPENAI_ENDPOINT}/openai/v1/",
    api_key=os.environ["AZURE_OPENAI_API_KEY"],
    timeout=900.0,
)

# Send a request for Flex processing.
response = openai.responses.create(
    model="YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    input="Analyze these records and summarize the recurring themes.",
    service_tier="flex",
)

print(response.output_text)
print(f"Processed by service tier: {response.service_tier}")
<generated-analysis>
Processed by service tier: flex
Svaret innehåller den genererade analysen och den tjänstnivå som bearbetar begäran.
Referens:Svars-API
REST
I följande exempel skickas samma begäran direkt till svars-API:et:
curl -X POST https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/responses \
  -H "Content-Type: application/json" \
  -H "api-key: $AZURE_OPENAI_API_KEY" \
  -d '{
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
    "service_tier": "flex"
  }'
{
    "service_tier": "flex",
    "status": "completed",
    "output": [<response-output>]
}
Kontrollera vilken nivå som bearbetar begäran genom att kontrollera fältet service_tier i ett lyckat svar.
Referens:REST-referens för svars-API
Välj ett bearbetningsalternativ
Flex-, Standard- och Priority-bearbetning är alternativ på tjänstnivå för API-begäranden online. Batch och etablerad kapacitet är separata driftsättnings- och köpalternativ.
| Option | Så här väljer du det | Svarstid och tillgänglighet | Kostnadsmodell | Passar bäst för |
|---|---|---|---|---|
| Flexbearbetning | Ange begärandenivå service_tier till flex. |
Variabel svarstid. Begäranden kan returnera HTTP 429 när Flex-kapacitet inte är tillgänglig. | 50% rabatt jämfört med standardtokenpriser. Rabatter för cachelagrade token gäller också. | Utvärderingar, berikning, offlineanalys och fördröjningstolerant bakgrundsarbete. |
| Standardbearbetning | Ange begärandenivå service_tier till default, eller använd standardnivån som konfigurerats för distributionen. |
Bästa möjliga onlinebearbetning för allmänna arbetsbelastningar. | Standardkostnad för betalning per token. | Arbetsbelastningar för utveckling, testning och produktion med variabel trafik. |
| Prioritetsbearbetning | Konfigurera Prioritet för distributionen eller ange begärandenivå service_tier till priority. |
Lägre och mer konsekvent svarstid, med ett definierat mål för modeller som stöds. | Prioriterat pris per token. | Latenskänsliga onlineapplikationer utan åtagande om reserverad kapacitet. |
| Batch | Skicka ett asynkront batchjobb till en Batch-distribution. | Resultaten beräknas vara klara inom 24 timmar. Inget mål för svarstid i realtid. | Rabatterat batchpris. | Stora offlinejobb som inte kräver ett omedelbart svar. |
| Provisionerad kapacitet | Skapa en provisionerad distribution och köp eller reservera provisionerade dataflödesenheter (PTU:er). | Reserverad kapacitet med förutsägbart dataflöde och svarstid. | PTU-fakturering per timme eller en Azure reservation. | Verksamhetskritiska produktionsarbetsbelastningar med stora volymer. |
Välj Flex-bearbetning när alla följande villkor gäller:
- Din arbetsbelastning kan tolerera längre och varierande bearbetningstider.
- Du föredrar lägre kostnad framför förutsägbar svarstid.
- Ditt program kan försöka med tillfälliga fel igen eller dirigera en misslyckad begäran till Standard-bearbetning.
- Den valda modellen och begärandekontexten stöds.
Använd inte Flex-bearbetning när något av följande villkor gäller:
- En användare väntar på ett interaktivt svar.
- Begäran måste slutföras inom ett strikt svarstidsmål.
- Programmet kan inte tolerera eller försöka utföra tillfälliga HTTP 429-svar igen.
- Du behöver reserverad bearbetningskapacitet eller förutsägbart dataflöde.
Flexbearbetning har följande egenskaper:
-
Val på begärandenivå: Ange
service_tiertillflexför varje begäran som ska använda Flex-bearbetning. - Ingen separat distribution: Skicka Standard- och Flex-begäranden till samma Global Standard-distribution och välj nivån per begäran.
- API:er som stöds: Använd API för svar eller API för chattslutsättning.
- Synkront svar: API-anropet förblir synkront, även om arbetsbelastningen kan ta längre tid att slutföra. Flexbearbetning är inte detsamma som Batch-API:et.
- Kapacitetsberoende tillgänglighet: En begäran kan returnera HTTP 429 när Flex-kapaciteten inte är tillgänglig.
-
Ingen automatisk återgång till Standard: Programmet måste uttryckligen göra ett nytt försök med
service_tierangivet somdefaultom Standard-bearbetning är godtagbar. - Delad kvot: Flex- och Standard-begäranden använder den kvot som tilldelats global standarddistribution.
- Samma modellutdatakvalitet: Flex använder samma underliggande modell som Standard. Bearbetningsnivån ändrar svarstid, tillgänglighet och pris, inte modellkvalitet.
Note
Flex-indata- och utdatatoken får 50% rabatt jämfört med motsvarande standardtokenpriser. Berättigade cachelagrade indatatoken får också den tillämpliga cachelagrade tokenrabatten. Aktuella priser finns i Azure OpenAI-priser.
Granska modeller som stöds
Flexbearbetning har begränsad modelltillgänglighet vid start.
gpt-5.6-sol är den första modellen som stöds. I följande tabell visas modeller som stöds. Microsoft lägger till fler modeller när stöd blir tillgängligt.
| Modell | Version | Distributionstyp | Tillgänglighet i regionen |
|---|---|---|---|
gpt-6.1-sol |
2026-09-29 |
Global Standard | Alla Azure regioner där Global Standard är tillgängligt |
gpt-6-sol |
2026-09-22 |
Global Standard | Alla Azure regioner där Global Standard är tillgängligt |
gpt-6-luna |
2026-09-22 |
Global Standard | Alla Azure regioner där Global Standard är tillgängligt |
gpt-6-astra |
2026-09-03 |
Global Standard | Alla Azure regioner där Global Standard är tillgängligt |
gpt-5.6-sol |
2026-07-09 |
Global Standard | Alla Azure regioner där Global Standard är tillgängligt |
gpt-5.6-luna |
2026-07-09 |
Global Standard | Alla Azure regioner där Global Standard är tillgängligt |
gpt-5.6-terra |
2026-07-09 |
Global Standard | Alla Azure regioner där Global Standard är tillgängligt |
Kontrollera tabellen innan du skickar en Flex-begäran. Anta inte att en modell eller en ny modellversion stöder Flex-bearbetning eftersom den stöder standard- eller prioritetsbearbetning. En modell som inte stöds returnerar HTTP 400. För att undvika att störa ditt program implementerar du en återställning på programnivå till Standard-bearbetning när standardpriser och prestanda är acceptabla.
Återgå till standardbearbetning
Flex-bearbetning dirigerar inte automatiskt en begäran till Standard när Flex-kapaciteten inte är tillgänglig. Om det är viktigare att slutföra begäran än att behålla Flex-prissättningen försöker du igen med service_tier inställd på default.
I följande exempel används en princip där slutförande prioriteras. Den försöker först med Flex-bearbetning och gör sedan ett nytt försök en gång med Standard-bearbetning efter ett HTTP 429-svar:
import os

from openai import OpenAI, RateLimitError

AZURE_OPENAI_ENDPOINT = "https://YOUR-RESOURCE-NAME.openai.azure.com"

# Create a client with a longer timeout for Flex requests.
openai = OpenAI(
    base_url=f"{AZURE_OPENAI_ENDPOINT}/openai/v1/",
    api_key=os.environ["AZURE_OPENAI_API_KEY"],
    timeout=900.0,
)

request = {
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
}

# Try Flex processing, and fall back to Standard after an HTTP 429 response.
try:
    response = openai.responses.create(**request, service_tier="flex")
except RateLimitError:
    response = openai.responses.create(**request, service_tier="default")

print(response.output_text)
print(f"Processed by service tier: {response.service_tier}")
<generated-analysis>
Processed by service tier: <flex-or-default>
Återställning till Standard ändrar begärans prissättning och prestandaegenskaper. Använd endast det här mönstret när arbetsbelastningen kan acceptera standardpriser.
Ett HTTP 429-svar kan indikera otillgänglig Flex-kapacitet eller en kvotgräns. Eftersom Flex- och Standard-behandling delar samma kvot kan Standard-begäran också misslyckas om det ursprungliga svaret berodde på kvoten. Tillämpa återförsöksgränser och hantera en sekund RateLimitError i ditt program. När tjänsten returnerar den Flex-specifika felidentifieraren använder du den för att begränsa återställning till kapacitetsrelaterade svar.
För arbetsbelastningar som prioriterar den lägsta kostnaden bör du försöka igen med Flex-bearbetning med exponentiell backoff innan du faller tillbaka. För arbetsbelastningar som prioriterar slutförandetiden återgår du till Standard efter det första Flex-kapacitetsfelet.
Referens:RateLimitError
Hantera Flex-fel
Särskilja permanenta begärandefel från tillfälliga kapacitetsfel.
| HTTP-statuskod | Error | Orsak | Rekommenderad hantering |
|---|---|---|---|
| 400 | invalid_request_error |
Den valda modellen, modellversionen, kontextlängden, API:et eller begärandekonfigurationen stöder inte Flex-bearbetning. | Försök inte skicka samma begäran igen utan att ändra den. Välj en modell eller kontextlängd som stöds eller försök uttryckligen igen med service_tier inställt på default. |
| 408 | Tidsgräns för begäran | Begäran slutförs inte inom den konfigurerade tidsgränsen för klienten eller tjänsten. Flex-begäranden kan ta längre tid än Standard-begäranden. | Använd en längre timeout för klienten. Försök igen med begränsad exponentiell backoff. Om slutförandetiden är viktigare än Flex-prissättningen kan du försöka igen med Standard. |
| 429 | Resursen är inte tillgänglig eller begränsad på grund av för många förfrågningar | Flex-kapaciteten är tillfälligt otillgänglig eller så överskred begäran en tillämplig hastighetsgräns. Flex-kapacitet är förinställbar, så tillfällig otillgänglighet är mer sannolikt under rusningstid. | Om begäran överskred en hastighetsgräns ökar du hastighetsgränsen för Global Standard-distributionen genom att tilldela mer kvot. Flex och Standard delar den här kvoten. Om prenumerationen inte har tillräckligt med kvot för en stor dataflödesarbetsbelastning begär du en kvotökning. Om Flex-kapaciteten är tillfälligt otillgänglig försöker du igen med exponentiell backoff och jitter, distribuerar fördröjningstolerant arbete till perioder med låg belastning, till exempel veckodagar eller helger, eller försöker igen med service_tier inställt på default. Respektera Retry-After när den finns. |
| 500, 502, 503 eller 504 | Tillfälligt tjänstfel | Ett tillfälligt tjänst- eller gatewayproblem förhindrade slutförande. | Försök igen med begränsad exponentiell backoff. Skicka inte ett obegränsat antal återförsök. |
| 401 eller 403 | Autentiserings- eller auktoriseringsfel | Autentiseringsuppgifterna saknas, är ogiltiga, har upphört att gälla eller har inte åtkomst till resursen. | Korrigera tilldelningen av autentiseringsuppgifter eller roller. Försök inte igen förrän konfigurationen ändras. |
| 404 | Distributionen hittades inte | Distributionsnamnet eller ändpunkten är felaktigt. | Kontrollera att model matchar distributionsnamnet och att bas-URL:en pekar på rätt Azure OpenAI-resurs. |
Note
En Flex-begäran som avvisas på grund av att det saknas bearbetningskapacitet faktureras inte. Du kanske märker mindre tillgänglig kapacitet för hastighetsbegränsning eftersom Flex- och Standard-begäranden delar den kvot som tilldelats global standarddistribution.
Använd exponentiell fördröjning med slumpmässig variation för HTTP 408-, 429- och övergående 5xx-svar. Ange maximalt antal återförsök och maximal fördröjning så att en misslyckad begäran inte finns kvar i en obundna återförsöksloop.
- Respektera
Retry-Afternär svaret innehåller det. - Annars väntar du på en exponentiellt ökande fördröjning med slumpmässig jitter.
- Försök endast med Flex igen medan fördröjningen fortfarande är acceptabel för arbetsbelastningen.
- Återgå till Standard om återförsöksbudgeten är slut och programmet tillåter högre standardkostnad.
- Returnera ett uttryckligt fel om varken fördröjd Flex-bearbetning eller standardfallback uppfyller applikationens krav.
Försök inte upprepade gånger samma Flex-begäran som inte stöds. Ett nytt försök lyckas först när du har ändrat modell, kontextlängd, API-konfiguration eller tjänstnivå.
Övervaka användning och kostnader
Använd Azure Monitor mått för att jämföra Flex- och Standard-trafik på samma distribution. Övervaka begärandevolym, tokenförbrukning, svarstid, fel och den hastighet med vilken Flex-begäranden återgår till Standard i ditt program.
Logga in på Azure-portalen.
Gå till din Azure OpenAI-resurs och välj Mått.
Lägg till måttet Azure OpenAI Requests. Du kan också lägga till Azure OpenAI-svarstid, Azure OpenAI-användning och felmått.
Lägg till ett filter där ServiceTierRequest är lika med
flex.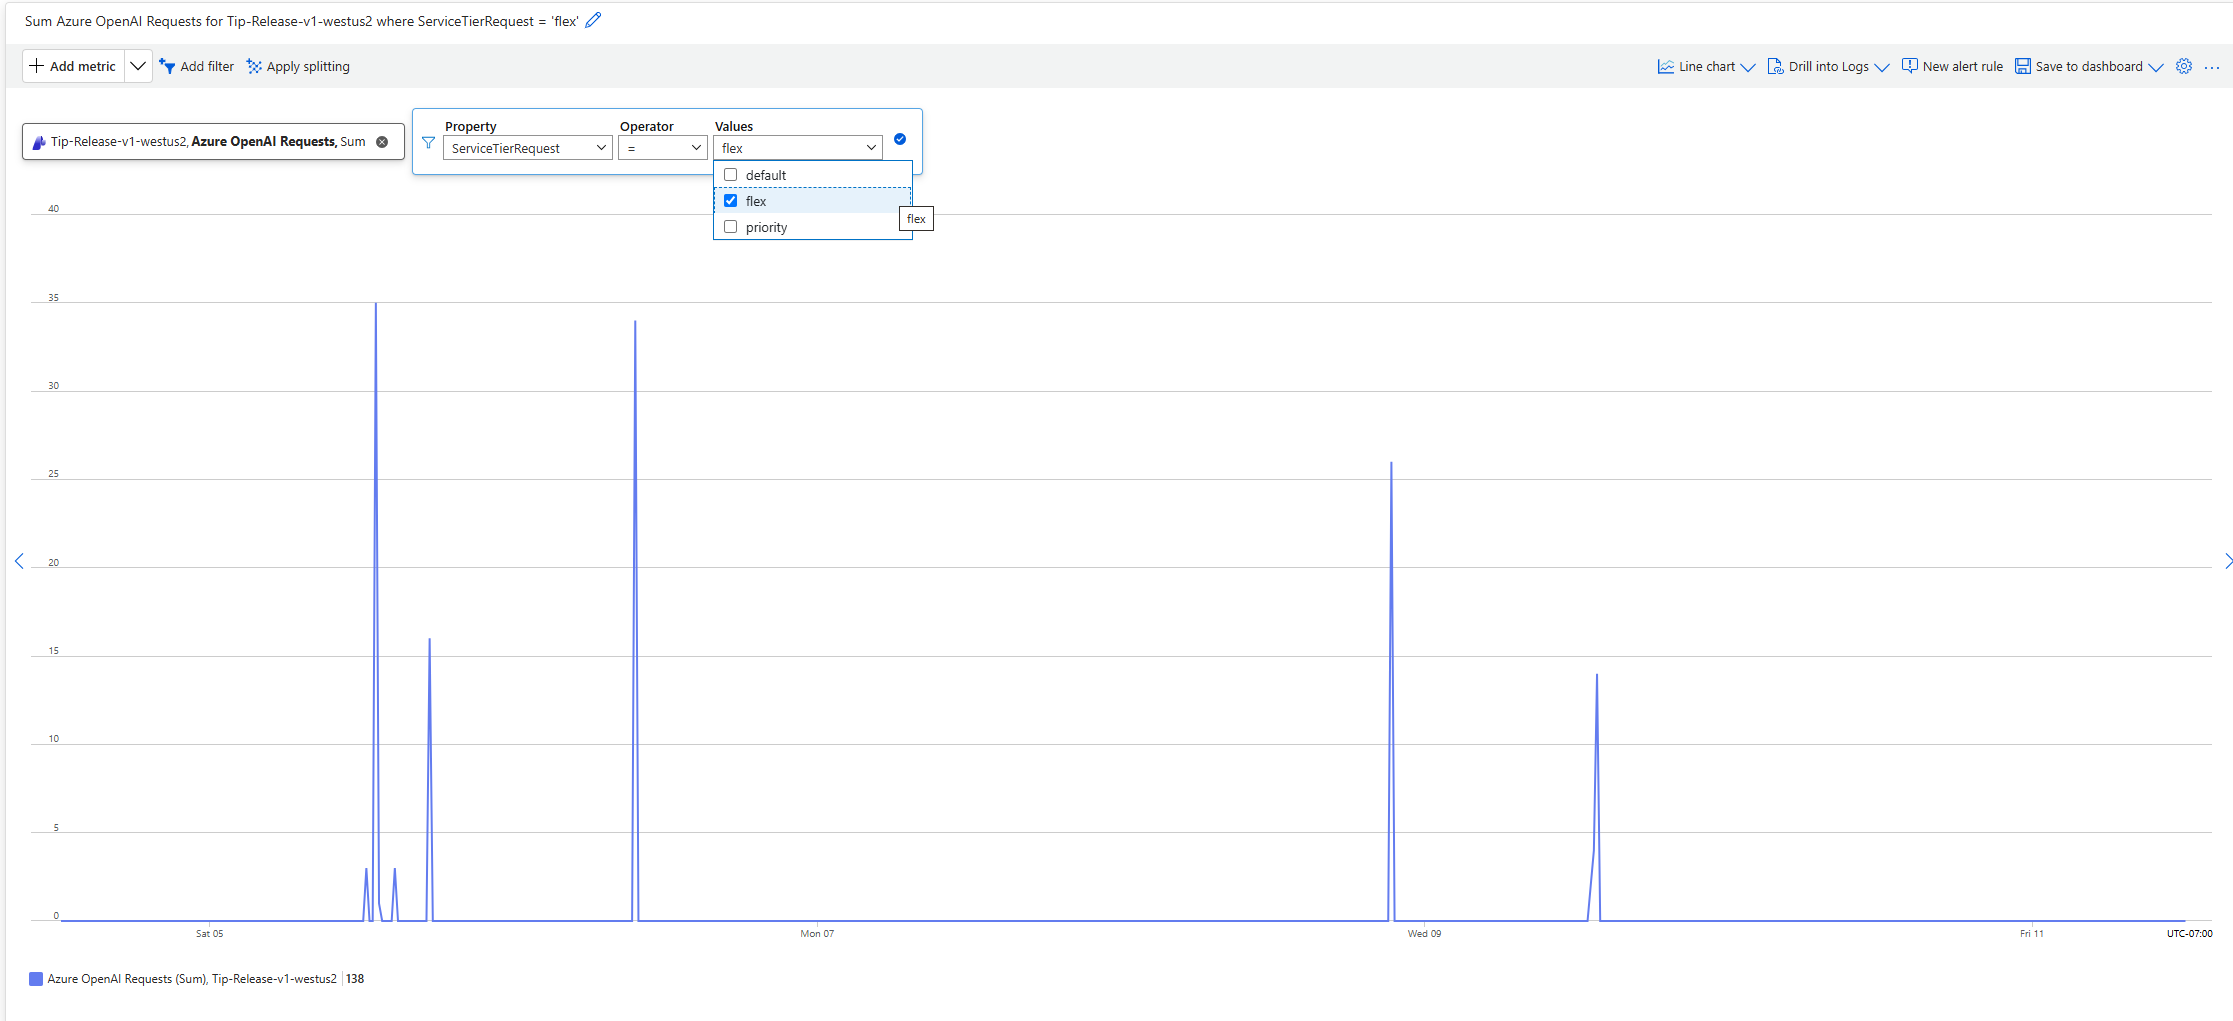
Skapa aviseringar för varaktiga HTTP 429-svar, ökade felfrekvenser och svarstider som överskrider arbetsbelastningens återförsöksbudget.
Spåra följande signaler för varje arbetsbelastning:
| Signal | Varför det spelar roll |
|---|---|
| Antal Flex-begäranden | Visar användning och trafik som dirigeras till mer kostnadseffektiv bearbetning. |
| Frekvens för lyckade Flex-begäranden | Visar hur ofta Flex-kapaciteten accepterar och slutför begäranden. |
| HTTP 429-hastighet | Visar perioder då Flex-kapacitet eller distributionskvot är begränsad. |
| Antal och frekvens för standardåterställning | Visar tillförlitlighetsfördelarna och den extra kostnaden från programkontrollerad återställning. |
| Indata, cachelagrade indata och utdatatoken | Har stöd för kostnadsattribuering och verifierar effekten av promptcachning. |
| Latens från början till slut | Hjälper till att avgöra om en arbetsbelastning förblir lämplig för Flex. |
antal invalid_request_error HTTP 400 |
Identifierar modeller som inte stöds, modellversioner, kontextlängder eller konfigurationer av begäranden. |
Mer information om distributioner av övervakningsmodeller finns i Övervaka Azure OpenAI.
Flex-användning debiteras på dedikerade Flex-mätare så att du kan skilja den från standardanvändning. Använd Kostnadsanalys för att granska Kostnader för Flex-token efter resurs och distribution.
- I Azure-portalen öppnar du Cost Management + Faktureringskostnadsanalys>.
- Filtrera efter den prenumeration, resursgrupp eller Azure OpenAI-resurs som innehåller distributionen.
- Gruppera eller filtrera efter Meter för att skilja Flex-förbrukning från standardförbrukning.
- Lägg till ett filter för faktureringsetikett, välj distribution och välj distributionens namn.
- Jämför Flex-kostnadsbesparingar med standardåterställningskostnader och arbetsbelastningens slutförandekrav.
Flex-indata- och utdatatoken prissätts till 50% av motsvarande standardpriser. Cachelagring av prompter kan minska kostnaden ytterligare för kvalificerade cachelagrade indatatoken. En Flex-begäran som avvisas på grund av att det saknas bearbetningskapacitet faktureras inte.
Tillämpa metodtips för produktion
- Ange en längre tidsgräns. Flex-begäranden kan ta längre tid än Standard-begäranden. Börja med en klienttimeout som är lämplig för din arbetsbelastning, till exempel 15 minuter, och testa med representativa frågor.
- Använd ett begränsat antal omförsök. Begränsa återförsök och total förfluten tid.
- Lägg till jitter. Randomisera backoff-fördröjningar för att undvika synkroniserade återförsökstoppar.
- Gör återställningsalternativet tydligt. Ställ in
service_tierpådefaulti stället för att förlita dig på implicit beteende. - Spåra den bearbetade nivån. Registrera svarsvärdet
service_tiermed svarstid, status, tokenanvändning och kostnadsdata. - Separera interaktiv trafik och bakgrundstrafik. Behåll användarriktade begäranden om standard, prioritet eller etablerat dataflöde om inte variabel Flex-svarstid är acceptabel.
- Kontrollera duplicerat arbete. Se till att applikationen inte skickar in samma logiska jobb flera gånger efter timeoutar på klientsidan.
- Testa felvägar. Verifiera hanteringen för HTTP 400, 408, 429 och tillfälliga 5xx-svar innan du använder Flex-bearbetning i produktionsarbetsflöden.
- Granska modellstöd före uppgraderingar. En ersättningsmodell eller modellversion ärver inte flexstöd automatiskt.
Åsidosätt tjänstnivån med ett begärandehuvud
x-ms-service-tier Använd begärandehuvudet när ett gateway-, proxy- eller centraliserat routningslager behöver välja tjänstnivå utan att granska eller ändra begärandetexten. Headern kan också minska behovet av ändringar vid migrering för applikationer som redan väljer en OpenAI-tjänstnivå via ett huvudfält i begäran.
Rubriken accepterar följande värden:
| Rubrikvärde | Begärd bearbetningsnivå |
|---|---|
flex |
Flex |
priority |
Prioritet |
default |
Standard |
auto |
Prioritet |
När rubriken är närvarande och giltig har den service_tier företräde framför värdet i begärandetexten.
| Indata för rubrik | Begärandetextindata | Beteende och utdata |
|---|---|---|
| Rubrik utelämnad | Giltigt service_tier värde |
Begärandetexten väljer nivån. Ett lyckat svar identifierar den bearbetade nivån i service_tier. |
| Giltigt sidhuvudsvärde | Valfritt värde eller utelämnat | Rubriken väljer den begärda nivån. Ett lyckat svar identifierar den bearbetade nivån i service_tier. |
| Rubrikvärde som inte stöds | Valfritt värde eller utelämnat | Begäran returnerar HTTP 400. Tjänsten återgår inte till värdet för begärandetexten. |
I det här exemplet begärs Flex-bearbetning via rubriken. Rubriken åsidosätter default värdet i begärandetexten:
curl -X POST https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/responses \
  -H "Content-Type: application/json" \
  -H "api-key: $AZURE_OPENAI_API_KEY" \
  -H "x-ms-service-tier: flex" \
  -d '{
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
    "service_tier": "default"
  }'
{
    "service_tier": "flex",
    "status": "completed",
    "output": [<response-output>]
}
Override-rubriken tillhandahåller ingen automatisk reservlösning. Ett ogiltigt rubrikvärde eller en nivå som den valda distributionen inte stöder returnerar HTTP 400.