Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
Eventstream i Microsoft Fabric är en fullt hanterad tjänst för händelseinsamling och streaming som möjliggör realtidsdatabehandling och analys. Du kan integrera eventstream med Fabric-notebooks med Spark Structured Streaming för att bearbeta och analysera strömmande data i realtid.
Denna integration låter dig utforska händelseströmmar och andra realtidskällor via Real-Time hubben, direkt från dina Fabric anteckningsböcker. Du kan också skapa nya händelseströmmar och börja ta in data från nästan 30 (och växande) streamingkällor, inklusive CDC-aktiverade databaser, meddelandemäklare, streamingtjänster och publika flöden. Den nya programmeringsmodellen gör det enkelt att ansluta till Eventstream, läsa strömmande data och utföra realtidsanalys med välkända Spark-API:er utan några anslutningssträngar eller inloggningsuppgifter, vilket gör det säkrare att bygga realtidsapplikationer
Förutsättningar
Innan du börjar måste du se till att du har följande förutsättningar:
- En Fabric-arbetsyta med eventstream aktiverat.
- En anteckningsboksmiljö uppsatt i Fabric.
- Grundläggande kunskaper om Spark Structured Streaming och PySpark eller Scala.
Steg för att fråga eventstream från en notebook-fil
Identifiera och lägg till eventstream i Notebook:
Öppna din Microsoft Fabric-anteckningsbok.
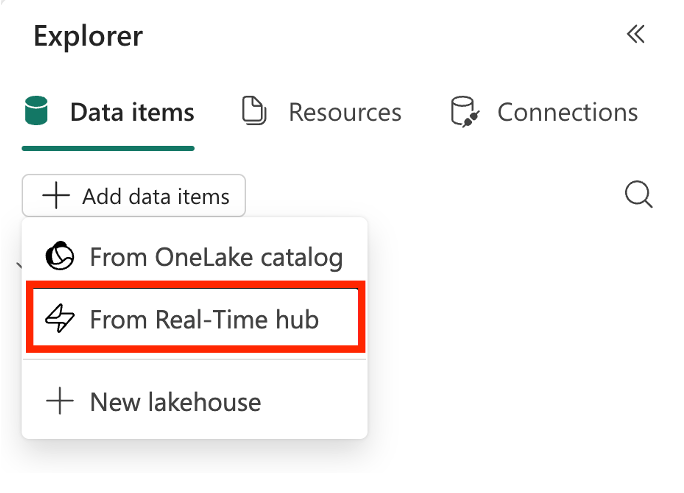
Välj Lägg till dataobjekt under fliken Dataobjekt och välj sedan From Real-Time hub från rullgardinsmenyn.
I dialogrutan Real-Time hubb letar du reda på målhändelseströmmen som du vill köra frågor mot med olika sök- och filteralternativ.
Lägg till händelseströmmen i din notebook-miljö.
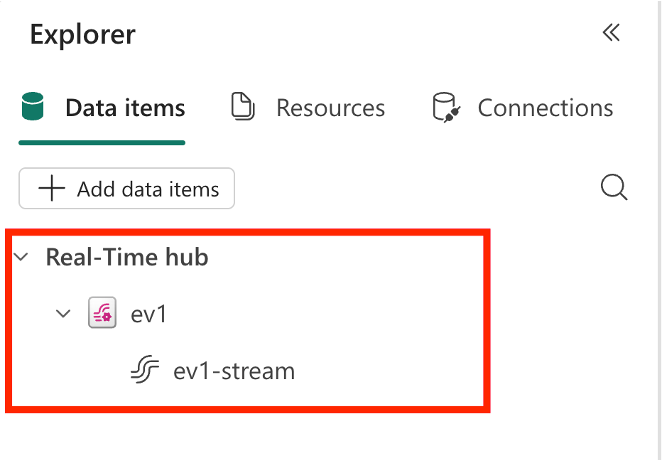
När eventstream-elementet har lagts till visas det under noden Real-Time hubb i notebook-objektutforskaren med elementnamnet. När du har expanderat noden visas standardströmmen eller den härledda strömmen i eventstream-elementet.
Läsa strömmande data från eventstream:
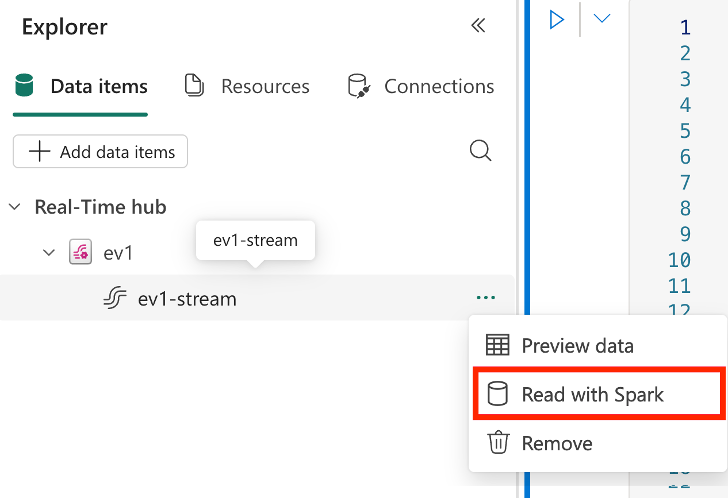
På snabbmenyn för eventstream-objektet i objektutforskaren väljer du Läs med Spark för att skapa en förkonfigurerad kodcell som ska läsas från den valda händelseströmmen.
I den nyligen skapade kodcellen kan du använda följande PySpark-kodfragment för att läsa strömmande data från händelseströmmen:
from pyspark.sql import SparkSession
from pyspark.sql.functions import col
from pyspark.sql.types import StringType
from pyspark.sql.dataframe import DataFrame

eventstream_options = {
    "eventstream.itemid": __in_eventstream_item_id,
    "eventstream.datasourceid": __in_eventstream_datasource_id
}

# Read from Kafka using the config map
df_raw = spark.readStream.format("kafka").options(**eventstream_options).load()

decoded_df = df_raw.select(
    col("key").cast(StringType()).alias("key"),
    col("value").cast(StringType()).alias("value"),
    col("partition"),
    col("offset")
)

def showDf(x:DataFrame, y:int):
    x.show()

# Print messages to the console
query = decoded_df.writeStream.foreachBatch(showDf).outputMode("append").start()
query.awaitTermination()
Värdet för
eventstream.itemidalternativen ocheventstream.datasourceidfylls automatiskt i parameterkodcellen ovanför den här kodcellen.Anmärkning
För varje val på Läs med Spark genereras en ny kodcell med nödvändiga parametrar som fylls i automatiskt och ett nytt notebook-mål skapas för Eventstream-objektet, där
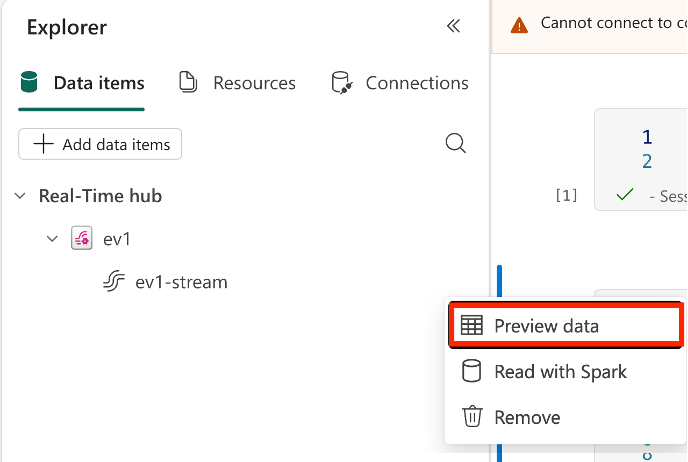
eventstream.datasourceidär unikt för varje notebook-mål. För ett notebook-objekt rekommenderar vi att du anger det en gång som mål för ett Eventstream-objekt för att undvika att skapa flera mål.Innan du kör ett jobb kan du även förhandsgranska strömmande data genom att klicka på knappen Förhandsgranska data i snabbmenyn för Eventstream-objektet. En sidopanel öppnas för att visa en ögonblicksbild av strömmande data bredvid notebooken.
Lägg till notebook-fil som mål: Du kan också lägga till anteckningsboken som mål för Eventstream för att börja mata in data i Eventstream inifrån notebook-filen. Mer information finns i Lägg till ett Spark Notebook-mål i en händelseström.
Conclusion
Genom att integrera eventstream i Fabric med anteckningsböcker med Spark Structured Streaming kan du sömlöst bearbeta och analysera realtidsdata. Genom att följa stegen som beskrivs i denna artikel kan du enkelt ansluta till Eventstream, läsa strömmande data och utföra realtidsanalys med hjälp av välkända Spark-API:er. Denna integration öppnar nya möjligheter för att bygga realtidsapplikationer och få insikter från strömmande data inom Fabric-ekosystemet.
Relaterat innehåll
För att lära dig mer om hur man arbetar med eventstreams och anteckningsböcker i Fabric, kolla in följande resurser