Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
Gäller för: ✅ Warehouse i Microsoft Fabric
Den här artikeln förklarar fördelarna med att utveckla och distribuera Fabric Data Warehouse med Fabric inbyggda Git-integration.
Important
Den här funktionen är i förhandsversion.
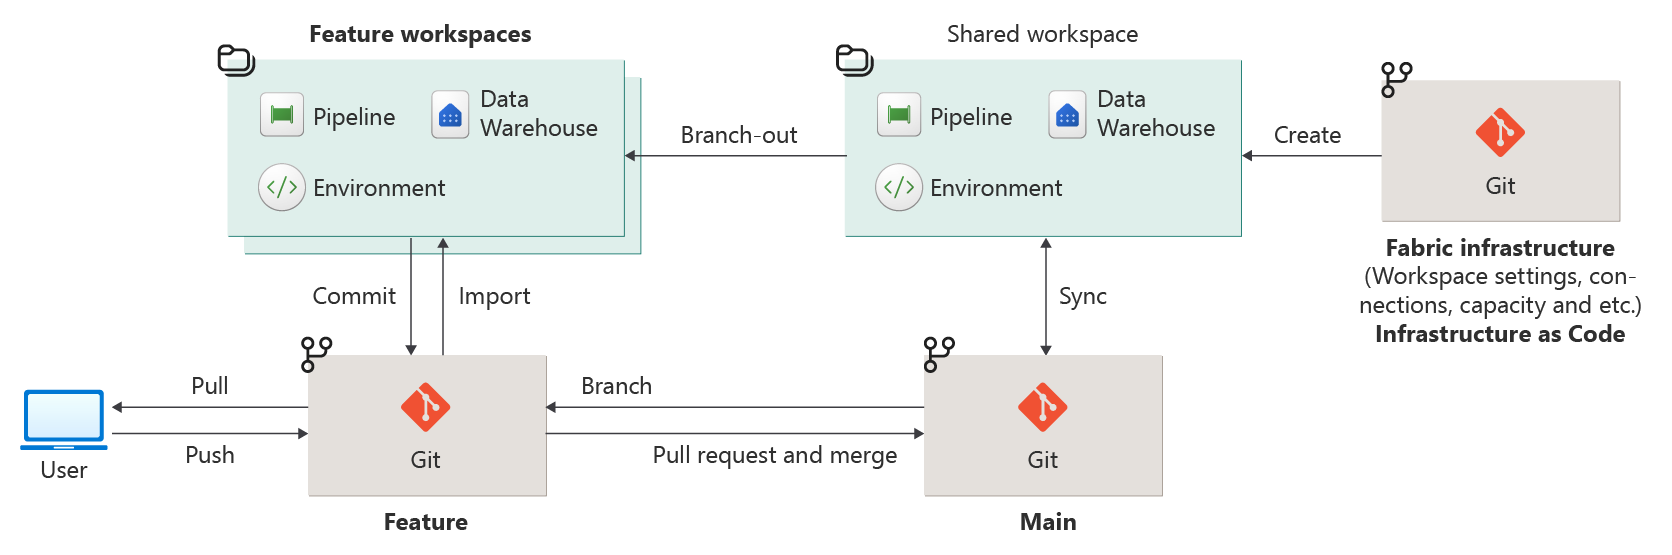
Genom att använda Git-integration i Fabric kan team tillämpa moderna versionshanteringsmetoder vid lagerutveckling. Utvecklare kan isolera förändringar i grenar, följa schemautveckling via commits, samarbeta via pull requests och synkronisera uppdateringar mellan Git-repositorier och Fabric-arbetsytor.
Vanliga scenarier är:
- Att genomföra schemaändringar på ett säkert sätt i grenar och arbetsytor
- Versionshantering av lagerobjekt i Git
- Samarbete över flera filialer och arbetsplatser
- Främjande av validerade förändringar mellan grenar
- Att hålla arbetsytsobjekt (lager och andra) i linje med Git-sanningskällan
För att upprätthålla konsekvens, spårbarhet och tillförlitlighet över lagerutvecklingslivscykler behöver du förstå dessa arbetsflöden.
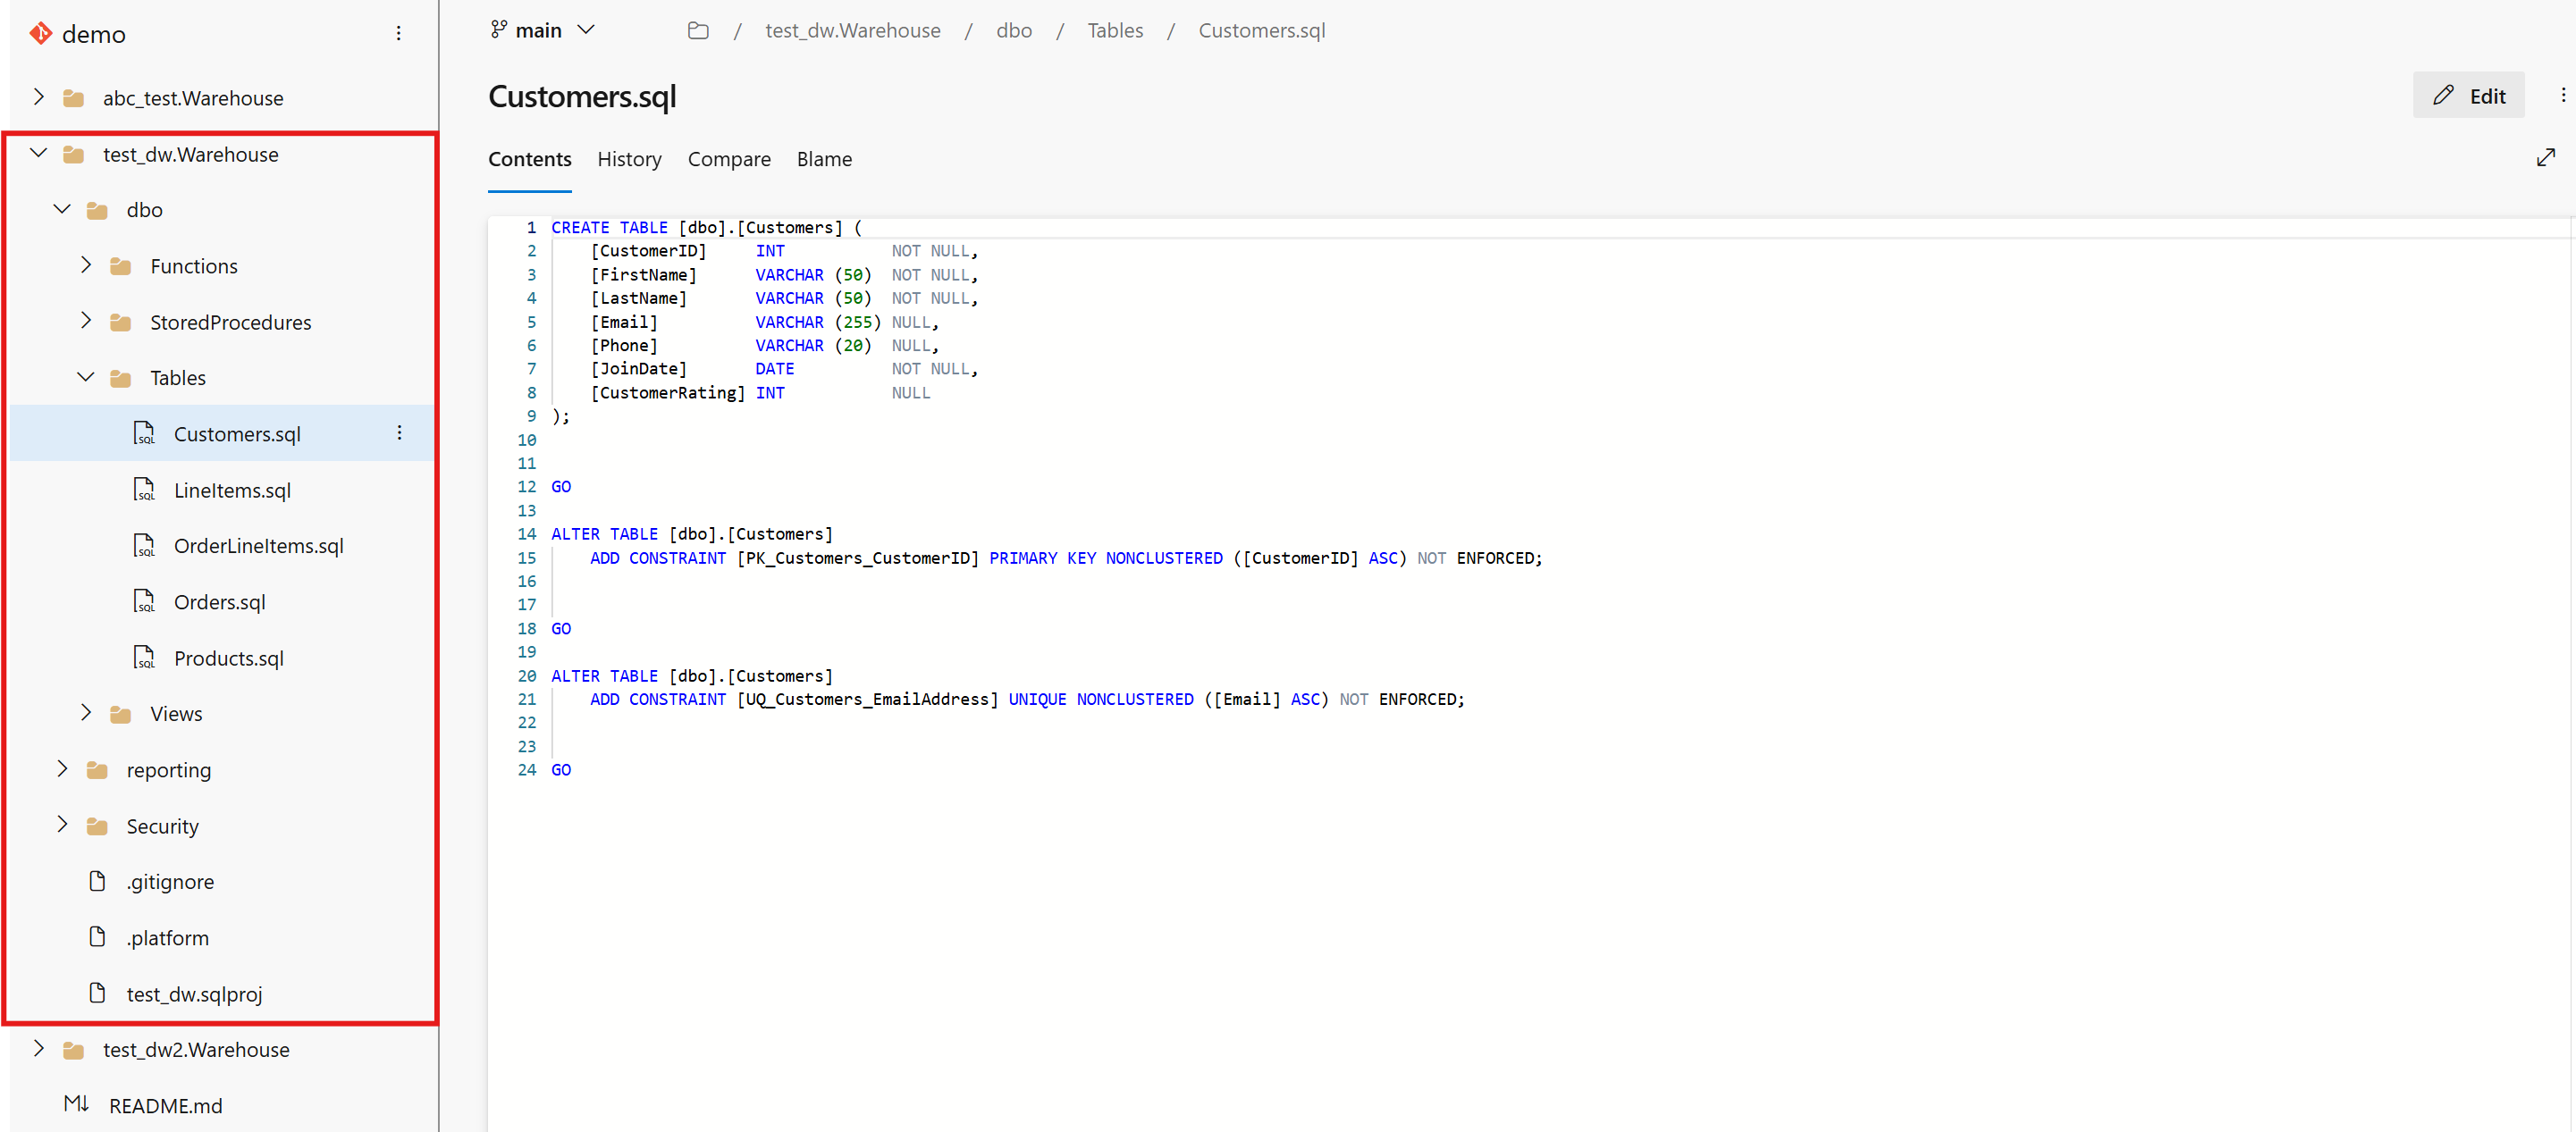
När du kopplar en Fabric Data Warehouse workspace till Git committar du warehouse-definitioner som ett databasprojekt. Detta projekt blir den auktoritativa representationen av lagerschemat i källkodskontroll och fungerar som grund för pågående utvecklingsaktiviteter. I versionskontrollutforskaren visas schemat som individuella .sql filer.
Genom att använda Fabric Git Integration och Fabric Data Warehouse kan du:
- Utveckla Fabric Data Warehouse med Git-integration.
- Distribuera Fabric Data Warehouse med hjälp av distributionspipelines.
- Distribuera och fortsätt att distribuera kontinuerligt med Fabric-portalen, Git, din egen IDE eller en lokal utvecklingsmiljö, distributionspipelines i Fabric eller externa system för kontinuerlig integrering/kontinuerlig leverans (CI/CD), inklusive pipelines i Azure DevOps Services eller GitHub.
Jämförelse
Under denna synkroniseringsprocess använder Fabric DacFx-baserad inkrementell schemautplacering för att tillämpa ändringar. Denna metod tillämpar endast relevanta schema-skillnader på lagret, istället för att uppdatera hela lagerdefinitionen.
Inkrementell extraktion hjälper till att minska onödig churn i källkontroll, bibehålla renare schema-skillnader mellan grenar och stödja effektiva arbetsflöden för förgrening och sammanslagning. Eftersom extraktionsprocessen är schema-medveten möjliggör den också tillförlitlig jämförelse och validering mellan arbetsytans tillstånd och de Git-spårade definitionerna.
Att standardisera hur datalagerscheman extraheras och lagras ökar enhetligheten i olika utvecklingsmiljöer. Schemadefinitioner förblir stabila mellan grenar, skillnader återspeglar mer exakt avsiktliga utvecklingsförändringar, och versionskontroll blir en tillförlitlig grund för driftsättning, samarbete och livscykelhantering.
Själva XMLA.json filen är utesluten under arbetsflödena för Git-integration. Fabric utesluter denna fil från commits och uppdateringar så att standard semantisk model metadata inte oavsiktligt lagras i Git. När man synkroniserar en arbetsyta från Git ignoreras det XMLA.json , vilket hjälper till att undvika konflikter, oavsiktliga överskrivningar och brus under grenväxling eller uppdateringar från Git.
Begränsningar i källkontroll
SQL-säkerhetsfunktioner såsom behörigheter kräver en skriptbaserad metod för export och migrering. Överväg att använda ett skript efter distributionen i ett SQL-databasprojekt. Du kan konfigurera ett skript efter distribution i projektet med tillägget SQL Database Projects som finns i Visual Studio Code.
Beroenden mellan objekt i lager och SQL-analys-slutpunkter stöds för närvarande inte i utvecklingsarbetsflöden. Som ett resultat kan scenarier som bygger på samordnade förändringar mellan dessa objekt fungera inte pålitligt.
Skript före eller efter distribution samt ytterligare publiceringskonfigurationer som läggs till direkt i databasprojektet via Git bevaras inte som en del av utvecklingsarbetsflödena. Du kan behöva hantera dessa konfigurationer separat utanför Fabric workspace.
Selektiva incheckningar på lagernivå stöds för närvarande inte. Ändringar genomförs på lagerartikelnivå snarare än på mer detaljerade objektnivåer.
Stöd för versionshantering för SQL-slutpunkter för analys är för närvarande inte tillgängligt. Denna begränsning kan begränsa hel livscykelhantering när lösningarna sträcker sig över både lager och SQL-analysändpunkter.
Begränsningar i Git-integrering
- När två eller flera lagerföremål refererar till varandra bildar de ett cykliskt beroende. Systemet upptäcker denna cirkulära referens under branch-out eller Git-till-arbetsområde-synkronisering, vilket gör att dessa operationer misslyckas. Undvik cykliska beroenden mellan föremål.
- Skapa för närvarande inte ett Dataflöde Gen2 med ett utdatamål till lagret. Ett nytt objekt med namnet
DataflowsStagingWarehousevisas på lagringsplatsen och blockerar incheckning och uppdatering från Git. - Beroenden mellan objekt, sekvensering av objekt och synkroniseringsluckor mellan SQL-analysslutpunkten och datavarulagret påverkar "grena ut till en ny eller befintlig arbetsyta" och "växla till en annan gren" under utveckling och kontinuerlig integration.
- Om ett objekt refererar till ett annat objekt i samma lager genom att använda tredelad namngivning (
database.schema.object), kan committing eller uppdatering från Git misslyckas. För mer information och en lösning, se Referenser till lagrets egna objekt genom att använda ett tredelat namn. - Om du ändrar en kolumn som har definierats med
IDENTITYkan det misslyckas att checka in eller uppdatera från Git tillsIDENTITY_INSERThar aktiverats för tabellen. - Om lagringsplatsen innehåller en
.sqlproj-fil som låser en äldreMicrosoft.Build.SqlSDK-version kan det misslyckas att checka in eller uppdatera från Git eftersom den äldre SDK-versionen inte känner igen nyare datalagersyntax, till exempelIDENTITY-kolumner ochCLUSTER BY. För mer information och en lösning, se Föråldrad .sqlproj i Git-arkivet. - Om ett objekt refererar till två eller flera tabeller i ett annat datalager utan att kvalificera varje kolumn med alias, kan incheckning eller uppdatering från Git misslyckas. För mer information och en lösning, se Icke-kvalificerade kolumner i objekt som refererar till två eller fler tabeller i ett annat lager.
- Om dina skript refererar till två eller flera olika objekt i samma schema i ett annat datalager och skriver schemanamnet med inkonsekvent användning av versaler och gemener, kan incheckning eller uppdatering från Git misslyckas. För mer information och en lösning, se Inkonsekvent versalisering av schemanamn.
- Tvetydiga kolumnfel, vars kandidatlista innehåller en
::avgränsare, kan uppstå vid incheckning eller uppdatering i Git, även när det inte finns någon verklig tvetydighet. För mer information och lösningar, se Tvetydiga kolumnfel med dubbletter av kandidatobjekt.
Scenarier som inte stöds
Följande CI/CD-arbetsflöden stöds inte officiellt när datalager i olika arbetsytor har olika sorteringsordning. Även om dessa åtgärder kan lyckas utan fel kan de resultera i metadatafel.
I alla dessa scenarier, om ett sorteringskonflikt inträffar, använd Python-skriptet scripts/dw-collation-error-update-tmsl/pbi_interactive.py i Fabric toolbox GitHub-förråd för att uppdatera datamängdens (TMSL) sorteringsordning till att matcha lagersorteringen.
| Scenario | Description | Risk |
|---|---|---|
| Distributionspipelines | Att överföra databasens innehåll via pipelinesteg (till exempel Dev → Test → Prod) där måldatabasen skapades med en annan sorteringsordning än källan stöds inte. | Distributionen kan lyckas, men datauppsättningssortering uppdateras inte för att matcha mållagersortering. |
| Förgrena ut till en ny eller befintlig arbetsyta | Det går inte att använda Git-integrering för att förgrena sig från en befintlig arbetsyta till en ny eller befintlig arbetsyta där lagret har en annan sortering. | Informationslagerinnehåll synkroniseras, men sorteringsmetadata är inte avstämda. |
| Byta brancher på en arbetsyta | Det går inte att växla till en gren som var associerad med ett lager med en annan sortering på en Git-ansluten arbetsyta. | Synkroniserat innehåll kan överföra sorteringsantaganden som inte matchar det aktuella lagret. |
| Slå samman ändringar mellan arbetsytor via grenar | Sammanslagning av Git-grenar mellan arbetsytor där informationslagren har olika sortering stöds inte. | Sammanfogningen kan lyckas på Git-nivå, men den resulterande datamängdssorteringen återspeglar inte mållagrets sortering. |