Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
gäller för:✅ Warehouse i Microsoft Fabric
Denna artikel beskriver metoder för att migrera datalager från SQL Server till Microsoft Fabric Data Warehouse.
Tips/Råd
För mer information om strategi och planering, se Migrationsplanering: SQL Server till Fabric Data Warehouse.
Använd Fabric Migration Assistant för Data Warehouse för en automatiserad migreringsupplevelse från SQL Server. Resten av denna artikel beskriver fler manuella migreringssteg.
Följande tabell sammanfattar metoder för migrering av dataschema (DDL), databaskod (DML) och data. Varje alternativ beskrivs senare i denna artikel.
| Option | Method | Vad det gör | Färdighet eller preferens | Scenario |
|---|---|---|---|---|
| 1 | Datafabriken | Schemakonvertering Extrahering av data Datainsamling |
Data Factory-pipeline | Förenklad schema- och datamigrering. Rekommenderas för dimensionstabeller. |
| 2 | Data Factory med partitionering | Schemakonvertering Extrahering av data Datainsamling |
Data Factory-pipeline | Parallelliserad migration för stora faktatabeller. |
| 3 | Schemabaserad migrering | Schemakonvertering | Data Factory-pipeline | Migrera schemat först, och extrahera sedan och ta in data separat för bättre kontroll över genomströmningen. |
| 4 | SQL-migreringsskript | Schemakonvertering Extrahering av data Bedömning av kod |
T-SQL | Använd en IDE och skript för detaljerad kontroll över migreringsuppgifter. |
| 5 | SQL-databasprojekt | Schemakonvertering Bedömning av kod |
SQL-projektet | Använd ett databasprojekt för versionshantering, bedömning och distribution. |
| 6 | dbt | Schemakonvertering Konvertering av databaskod |
dbt | Återanvänd ett befintligt dbt-projekt genom att ändra adaptern och målkonfigurationen. |
Välj en arbetsbelastning för den första migreringen
När du bestämmer var du ska börja ett SQL Server till Fabric Data Warehouse migreringsprojekt, välj ett arbetsbelastningsområde där du kan:
- Bevisa möjligheten att migrera till Fabric Data Warehouse genom att snabbt leverera fördelarna med den nya miljön. Börja smått och enkelt, och förbered dig på flera små migrationer.
- Ge din tekniska personal tid att skaffa relevant erfarenhet av de processer och verktyg de använder för att migrera andra arbetsbelastningar.
- Skapa en mall för vidare migreringar som är specifik för din SQL Server-miljö, verktyg och processer.
Tips/Råd
Skapa en inventering av objekt som behöver migreras och dokumentera migreringsprocessen från början till slut så att den kan upprepas för andra databaser eller arbetsbelastningar.
Datavolymen vid en initial migrering bör vara tillräckligt stor för att visa Fabric Data Warehouse kapaciteter och fördelar, men tillräckligt liten för att snabbt visa värde. En storlek på 1–10 terabyte är typisk.
Migrera med Fabric Data Factory
Fabric Data Factory tillhandahåller ett low-code-gränssnitt som kan konvertera tabell-DDL och migrera data från SQL Server.
Fabric Data Factory kan utföra följande uppgifter:
- Konvertera schema (DDL) till Fabric Data Warehouse syntax.
- Skapa schemaobjekt i Fabric Data Warehouse.
- Migrera data till Fabric Data Warehouse.
Alternativ 1. Schema- och datamigrering med Copy Assistant
Denna metod använder Data Factory Copy Assistant för att ansluta till källkoden SQL Server databasen, konvertera tabell-DDL till Fabric syntax och kopiera data till Fabric Data Warehouse. Du kan välja en eller flera källtabeller. Den genererade pipelinen använder en ForEach-aktivitet för att kopiera de valda tabellerna parallellt.
När du konfigurerar kopieringsoperationen:
- Använd SQL Server-kontakten för källkopplingen.
- Begränsa parallella kopior till en nivå som källdatabasen och nätverket kan upprätthålla.
- Övervaka käll-CPU, I/O, transaktionslogganvändning och produktionsarbetsbelastningsfördröjning under extraktion.
Rekommenderad användning
Använd Copy Assistant för ett enkelt gränssnitt som konverterar DDL och tar in valda tabeller i en operation. Denna metod passar bra för dimensionstabeller och mindre arbetsbelastningar.
För stora tabeller, använd partitionering för att öka läs- och skrivparallellismen.
Alternativ 2. Datamigrering med partitionering
För stora faktatabeller, använd en Copy activity för varje tabell och konfigurera källkodspartitionering. Använd fysiska partitioner när det är möjligt, eller konfigurera dynamisk omfångspartitionering genom att ange en lämplig numerisk eller datumskolumn samt dess minimi- och maximumvärden.
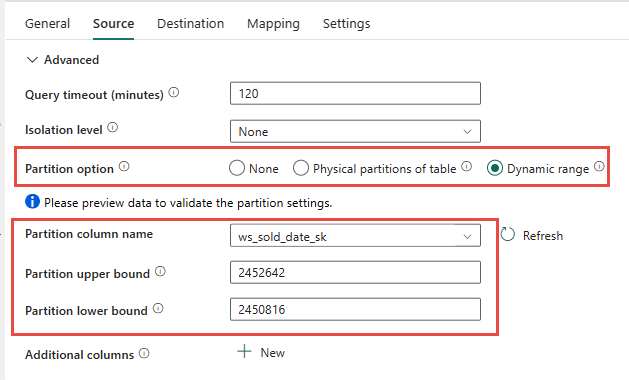
När du använder partitionering:
- Välj en partitionskolumn som fördelar raderna jämnt.
- Undvik att skapa fler samtidiga källförfrågningar än vad SQL Server kan hantera utan att påverka produktionsarbetsbelastningarna.
- Testa partitionsintervallet och inställningarna för parallellkopiering mot en representativ arbetsbelastning.
- Öka parallellismen gradvis medan du övervakar källa och destination.
Rekommenderad användning
Använd Data Factory-partitionering för stora faktatabeller när parallell extraktion förbättrar genomströmningen. Anpassa antalet batchar och partitionsintervallen utifrån källdatabasens resurser och nätverkskapaciteten.
Alternativ 3. Schemabaserad migration
För större databaser, separera schemamigrering från datamigrering:
- Konvertera och skapa tabellscheman i Fabric Data Warehouse.
- Extrahera källdata till Azure Data Lake Storage (ADLS) Gen2.
- Använd Data Factory eller kommandot COPY INTO för att importera den stegade datan till Fabric Data Warehouse.
Att separera dessa faser låter dig justera extraktion och intag oberoende av varandra.
Schemamigrering med Data Factory
Du kan använda en Fabric pipeline för att migrera tabellscheman från SQL Server till Fabric Data Warehouse utan att kopiera rader.
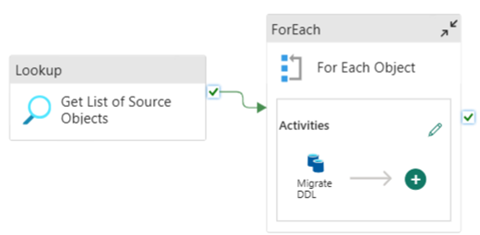
Konfigurera pipelineparametrar
Skapa en SchemaName parameter som specificerar vilka scheman som ska migreras. Använd dbo som standard, eller ange en kommaavgränsad lista såsom 'dbo','sales'.
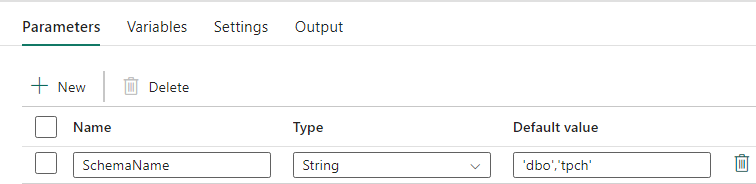
Konfigurera uppslagsaktiviteten
Skapa en uppslagsaktivitet och ställ in dess anslutning till källdatabasen SQL Server. På fliken Inställningar :
- Ange Datalagringstyp till Extern.
- Välj källanslutningen till SQL Server.
- Ställ in Använd fråga på Fråga.
- Lägg till en dynamisk fråga som returnerar källschemat och tabellnamnen.
Använd följande uttryck för att skapa frågan:
@concat('
SELECT s.name AS SchemaName,
t.name AS TableName
FROM sys.tables AS t
INNER JOIN sys.schemas AS s
ON t.type = ''U''
AND s.schema_id = t.schema_id
AND s.name in (',coalesce(pipeline().parameters.SchemaName, 'dbo'),')
')
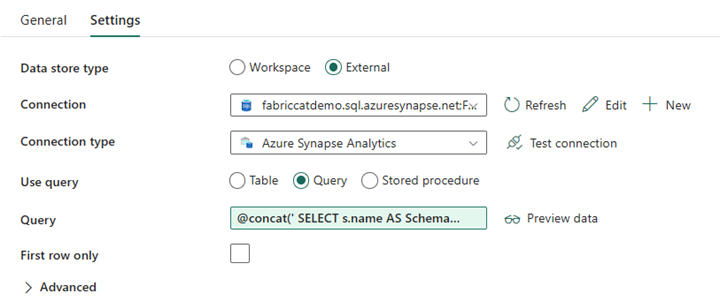
Konfigurera ForEach-aktiviteten
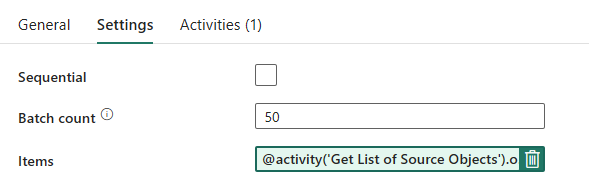
I fliken Inställningar för ForEach-aktiviteten:
- Inaktivera Sequential för att tillåta iterationer att köras samtidigt.
- Ställ in batchräkningen till ett värde som källdatabasen kan hantera. Börja med ett konservativt värde och testa det.
- Ställ in Objekt till
@activity('Get List of Source Objects').output.value.
Konfigurera aktiviteten Kopiera
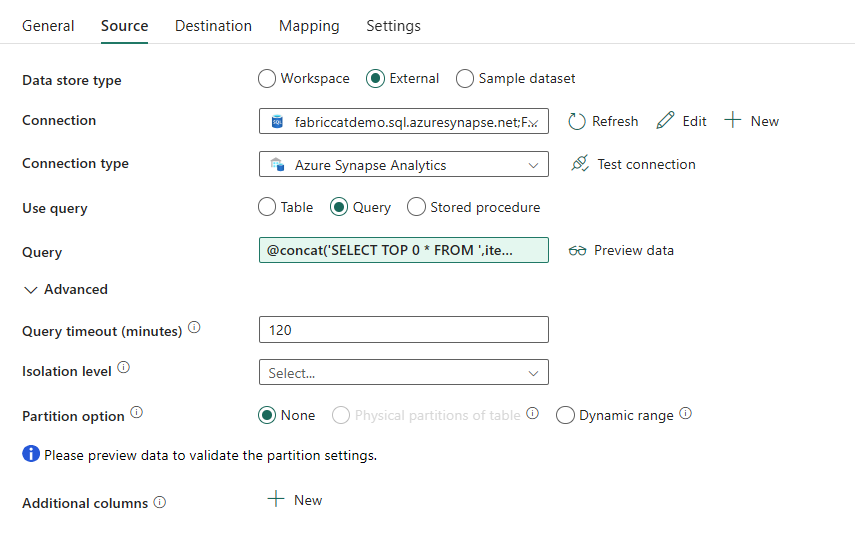
Inne i ForEach-aktiviteten lägger du till en kopieringsaktivitet. På fliken Källa :
- Ange Datalagringstyp till Extern.
- Välj källanslutningen till SQL Server.
- Ange Använd fråga till Fråga.
- Ställ in Query så
@concat('SELECT TOP 0 * FROM ',item().SchemaName,'.',item().TableName)att endast tabellmetadata migreras.
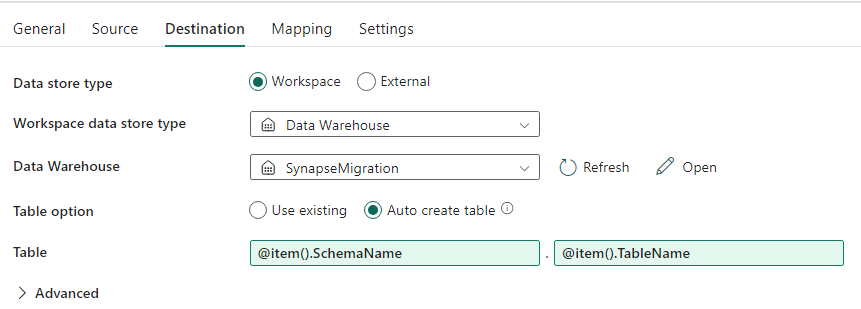
På fliken Mål :
- Ange Datalagertyp till Arbetsyta.
- Ställ in Workspace data store-typ till Data Warehouse och välj destinationslagret.
- Sätt destinationsschemat till
@item().SchemaName. - Sätt destinationstabellen till
@item().TableName.
Efter att du kört pipelinen, kontrollera att Fabric Data Warehouse innehåller varje vald tabell med det förväntade schemat.
Migrera med SQL-skript
Använd T-SQL- och PowerShell-migreringsskript när du vill ha detaljerad kontroll över schemakonvertering, datautvinning och kodbedömning.
Migrationsskript kan:
- Konvertera schema (DDL) till Fabric Data Warehouse syntax.
- Skapa schemaobjekt i Fabric Data Warehouse.
- Extrahera data från SQL Server till ADLS Gen2.
- Flagga icke-stödd T-SQL-syntax i lagrade procedurer, funktioner och vyer.
Microsoft Fabric CAT-teamet tillhandahåller migreringskodsexempel i fabric-migrationsarkivet.
Rekommenderad användning
Använd skript när du är bekant med T-SQL, föredrar en integrerad utvecklingsmiljö och behöver kontrollera individuella migreringsuppgifter. Använd COPY INTO Data Factory för att importera extraherad data till Fabric Data Warehouse.
Migrera med hjälp av SQL-databasprojekt
Fabric Data Warehouse stöds i SQL Database Projects-tillägget för Visual Studio Code.
Ett SQL-databasprojekt tillhandahåller versionshantering, databastestning, schemavalidering och distributionsmöjligheter. Det kan:
- Konvertera schema (DDL) till Fabric Data Warehouse syntax.
- Skapa schemaobjekt i Fabric Data Warehouse.
- Bedöm icke-stödd T-SQL-syntax i lagrade procedurer, funktioner och vyer.
För datamigrering använder du Data Factory för att kopiera direkt från SQL Server, eller extraherar data till ADLS Gen2 och matar in dem med COPY INTO eller med Data Factory.
För en genomgång av hur man använder SQL-databasprojekt med migrationsskript, se fabric-migration-arkivet.
För mer information, se Kom igång med SQL Database Projects-tillägget och Bygg ett databasprojekt från kommandoraden.
Migration med dbt
Om din SQL Server data warehouse använder dbt kan du använda dbt-adaptern för Fabric Data Warehouse för att konvertera schema- och databaskod genom att ändra målprofilen och adaptern.
DBT-ramverket genererar DDL- och DML-skript från modellfiler. Du måste migrera datan separat genom att använda Data Factory eller ett annat datamigreringsalternativ i denna artikel.
För att komma igång, se Tutorial: Sätt upp dbt för Fabric Data Warehouse.
Datainsamling i Fabric Data Warehouse
För mellanlagrade data använder du COPY INTO eller Fabric Data Factory för att mata in filer från ADLS Gen2 till Fabric Data Warehouse. Överväg följande vägledning:
- Extrahera stora tabeller parallellt när källdatabasen och nätverket har tillräcklig kapacitet.
- Föredra Parquet-filer för att minska lagring och nätverksanvändning samt förbättra intagningseffektiviteten.
- Ladda flera destinationstabeller samtidigt när din Fabric-kapacitet kan hantera arbetsbelastningen.
- Övervaka både källutvinning och Fabric-kapacitet för att hitta optimal grad av parallellism.