Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
Gäller för:✅ SQL-analysslutpunkt och lager i Microsoft Fabric
Viktigt!
Den här funktionen är i förhandsversion.
Datakluster i Fabric Data Warehouse organiserar data för snabbare frågeprestanda och minskad beräkningsanvändning. I den här självstudien går vi steg för steg igenom hur man skapar tabeller med dataklustrering, från att skapa klustrade datatabeller till att kontrollera deras effektivitet eller användbarhet.
Förutsättningar
- Ett Microsoft Fabric-klientkonto med en aktiv prenumeration.
- Kontrollera att du har en Microsoft Fabric-aktiverad arbetsyta: Skapa en arbetsyta.
- Kontrollera att du redan har skapat ett lager. Information om hur du skapar ett nytt lager finns i Skapa ett lager i Microsoft Fabric.
- Grundläggande förståelse för T-SQL och databegäranden.
Importera exempeldata
I den här handledningen används exempeldatauppsättningen NY Taxi. Importera NY Taxi-data till ditt lager. Använd självstudiekursen Ladda in exempeldata i datamagasin handledning.
Skapa en tabell med dataklustring
I den här självstudien behöver vi två kopior av NYTaxi-tabellen: den vanliga kopian av tabellen som importerats från självstudien och en kopia som använder datakluster. Använd följande kommando för att skapa en ny tabell med hjälp av CREATE TABLE AS SELECT (CTAS), baserat på den ursprungliga NYTaxi-tabellen:
CREATE TABLE nyctlc_With_DataClustering
WITH (CLUSTER BY (lpepPickupDatetime))
AS SELECT * FROM nyctlc
Anmärkning
Exemplet förutsätter tabellnamnet som ges till NY Taxi-datasetet i tutorialen 'Läs in exempeldata till datalager'. Om du har använt ett annat namn för tabellen justerar du kommandot så att det ersätts nyctlc med tabellnamnet.
Det här kommandot skapar en exakt kopia av den ursprungliga NYTaxi-tabellen, men med datakluster i lpepPickupDatetime kolumnen. Sedan använder vi den här kolumnen för att fråga.
Fråga efter data
Kör en fråga i TABELLEN NYTaxi och upprepa exakt samma fråga i tabellen NYTaxi_With_DataClustering för jämförelse.
Anmärkning
För den här analysen är det fördelaktigt att titta på prestandan för kall cache för båda körningarna, dvs. utan att använda cachelagringsfunktionerna i Fabric Data Warehouse. Kör därför varje fråga exakt en gång innan du tittar på resultaten i Query Insights.
Vi använder en fråga som ofta upprepas i datalagret. Den här frågan beräknar det genomsnittliga prisbeloppet per år mellan datumen 2008-12-31 och 2014-06-30:
SELECT
    YEAR(lpepPickupDatetime),
    AVG(fareAmount) as [Average Fare]
FROM
    NYTaxi
WHERE
    lpepPickupDatetime BETWEEN '2008-12-31' AND '2014-06-30'
GROUP BY
    YEAR(lpepPickupDatetime)
ORDER BY
    YEAR(lpepPickupDatetime) DESC
OPTION (LABEL = 'Regular');
Anmärkning
Etikettalternativet som används i den här frågan är användbart när vi jämför frågeinformationen i Regular tabellen med den som använder datakluster senare med hjälp av Query Insights-vyer.
Sedan upprepar vi exakt samma fråga, men på den version av tabellen som använder datakluster:
SELECT
    YEAR(lpepPickupDatetime),
    AVG(fareAmount) as [Average Fare]
FROM
    NYTaxi_With_DataClustering
WHERE
    lpepPickupDatetime BETWEEN '2008-12-31' AND '2014-06-30'
GROUP BY
    YEAR(lpepPickupDatetime)
ORDER BY
    YEAR(lpepPickupDatetime) DESC
OPTION (LABEL = 'Clustered');
Den andra frågan använder etiketten Clustered så att vi kan identifiera den här frågan senare med Query Insights.
Kontrollera effektiviteten i dataklustring
När du har konfigurerat klustring kan du utvärdera dess effektivitet med hjälp av Query Insights. Query Insights i Fabric Data Warehouse samlar in historiska frågekörningsdata och aggregerar dem till användbara insikter, till exempel att identifiera långvariga eller ofta körda frågor.
I det här fallet använder vi Query Insights för att jämföra skillnaden i data som skannas mellan de vanliga och klustrade fallen.
Använd följande fråga:
SELECT
    label,
    submit_time,
    row_count,
    total_elapsed_time_ms,
    allocated_cpu_time_ms,
    result_cache_hit,
    data_scanned_disk_mb,
    data_scanned_memory_mb,
    data_scanned_remote_storage_mb,
    command
FROM
    queryinsights.exec_requests_history
WHERE
    command LIKE '%NYTaxi%'
    AND label IN ('Regular','Clustered')
ORDER BY
    submit_time DESC;
Den här frågan hämtar information från exec_requests_history vyn. Mer information finns i queryinsights.exec_requests_history (Transact-SQL).
Frågan filtrerar resultatet på följande sätt:
- Hämtar endast rader som innehåller
NYTaxitexten i kommandonamnet (som användes i testfrågorna) - Hämtar endast rader där etikettvärdet antingen var vanligt eller grupperat
Anmärkning
Det kan ta några minuter innan frågeinformationen blir tillgänglig i Query Insights. Om frågan Query Insights inte returnerar några resultat kan du försöka igen efter några minuter.
När vi kör den här frågan ser vi följande resultat:

Båda frågorna har ett radantal på 6 och liknande sändningstider. Frågan Clustered visar total_elapsed_time_ms 1794, allocated_cpu_time_ms 1676 och data_scanned_remote_storage_mb 77 519. Frågan Regular visar total_elapsed_time_ms 2651, allocated_cpu_time_ms 2600 och data_scanned_remote_storage_mb 177,700. Dessa siffror visar att även om båda frågorna returnerade samma resultat, Clustered använde versionen cirka 36% mindre CPU-tid än Regular versionen och skannade cirka 56% mindre data på disken. Ingen cache användes i någon av frågekörningarna. Det här är viktiga resultat som bidrar till att minska frågorstjänstgöringens tid och resursförbrukning samt göra kolumnen lpepPickupDatetime till en stark kandidat för klustring av data.
Anmärkning
Det här är en liten tabell med cirka 76 miljoner rader och 2 GB datavolym. Även om den här frågan endast returnerar sex rader i sin sammansättning (en för varje år i intervallet) genomsöker den cirka 8,3 miljoner rader i det datumintervall som angavs innan resultaten sammanställs. Faktiska produktionsdata med större datavolymer kan ge mer betydande resultat. Dina resultat kan variera beroende på kapacitetsstorlek, cachelagrade resultat eller samtidighet under frågorna.
Välj klustringskolumner från din arbetsbelastning
För produktionstabeller, använd observerade frågemönster istället för att gissa vilka kolumner som ska klustras. Operationskapaciteten för sqldw-clifärdigheten analyserar Query Insights-historik, rangordnar återkommande frågemönster efter mängden genomsökta fjärrdata och identifierar kolumner som används i WHERE-predikat.
Innan du börjar, installera Skills for Fabric, se till att lagret har senaste frågeaktivitet och bekräfta att du har rollen Bidragande arbetsområde eller högre. Öppna sedan GitHub Copilot CLI och använd en prompt som denna:
Use the sqldw-cli skill to recommend clustering columns for
<workspace-name>/<warehouse-name> based on the last seven days of workload.
Rank candidates by total remote data scanned, consider columns used in WHERE
predicates, and explain each column's cardinality and data type suitability.
Use read-only diagnostics.
Funktionen identifierar de frågemönster som har störst påverkan på genomsökningen, extraherar tabellerna och filterkolumnerna från dessa frågor och rangordnar kandidaterna för klustring. Gå igenom rekommendationerna med dessa riktlinjer:
- Föredra kolumner som upprepade gånger filtrerar stora tabeller och använder mellan- till höga kardinalitetsvärden, såsom datum eller identifierare.
- Prioritera kolumner som används i selektiva intervall- eller likhetspredikat i satsen
WHERE. - Välj inte kolumner bara för att de visas i likhetssammanfogningsvillkor. Dessa förhållanden gynnas inte av dataklustring.
- Använd högst fyra klustringskolumner och lägg inte till fler kolumner än vad arbetsbelastningen kräver.
Till exempel, tänk på ett e-handelslager där Sales.SalesOrder innehåller 1,5 miljarder rader och Sales.OrderLine 6 miljarder rader. Efter att ha analyserat återkommande frågor kan färdigheten ge dessa rekommendationer:
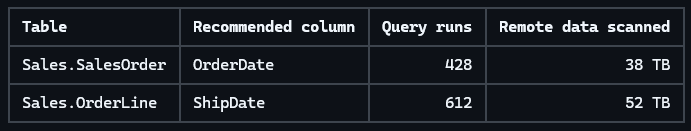
Datumkolumnerna är starka kandidater eftersom de filtrerar de största tabellerna, stöder predikat för gemensamma intervall och ger fler möjligheter att hoppa över filer än kolumner med låg kardinalitet, såsom OrderStatus eller SalesRegion.
Operationsfunktionen sqldw-cli är skrivskyddad. Den rekommenderar kolumner men skapar eller ersätter inte tabeller. Efter att du har granskat rekommendationen, använd CTAS för att skapa en klustrad kopia av tabellen:
CREATE TABLE Sales.SalesOrder_clustered
WITH (CLUSTER BY (OrderDate))
AS
SELECT * FROM Sales.SalesOrder;
Jämför klustrade och icke-klustrade arbetsbelastningar för att verifiera effekten. Efter att du validerat den klustrade tabellen, byt namn på den ursprungliga tabellen och byt sedan namn på den klustrade tabellen till det ursprungliga namnet:
EXEC sp_rename 'Sales.SalesOrder', 'SalesOrder_old';
EXEC sp_rename 'Sales.SalesOrder_clustered', 'SalesOrder';
Den ursprungliga tabellen finns fortfarande tillgänglig som Sales.SalesOrder_old för återställning. Verifiera beroende arbetsbelastningar och den nya tabellen innan du tar bort den ursprungliga tabellen. När du inte längre behöver rollback-kopian, släpp den:
DROP TABLE Sales.SalesOrder_old;