Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
Gäller för: SQL Server 2016 (13.x) och senare versioner Azure SQL DatabaseAzure SQL Managed InstanceSQL-databas i Microsoft Fabric
Du kan optimera dina frågor över JSON-dokument genom att använda standard B-trädindex. Databasindex förbättrar prestandan för filter- och sorteringsåtgärder. Utan index måste Database Engine utföra en fullständig tabellskanning varje gång du gör en fråga mot data.
Tip
Indexar fungerar på samma sätt på JSON-data i varchar/nvarchar eller den inbyggda JSON-datatypen.
Note
JSON-datatypen och JSON-indexen är generellt tillgängliga i SQL Server 2025 (17.x), Azure SQL Database, Azure SQL Managed Instance (med SQL Server 2025 eller Always-up-to-dateupdate policy), samt SQL-databasen i Microsoft Fabric.
Det finns två sätt att indexera JSON-data, beroende på hur du lagrar den:
| Indextyp | Description |
|---|---|
| JSON-index | När du lagrar JSON i en json-kolumn, skapa ett JSON-index på kolumnen. Ett enda JSON-index kan optimera många frågor som använder funktioner som JSON_VALUE, JSON_PATH_EXISTS, och JSON_CONTAINS för att söka värden i dokumentet. Denna metod rekommenderas för json-datatypen . |
| Beräknat kolumnindex | När du lagrar JSON som varchar- eller nvarchar-text, eller när du vill indexera en enskild JSON-egenskap som en starkt typad kolumn, skapa en beräknad kolumn med JSON_VALUE och bygg ett standardindex på den kolumnen. |
Indexera en JSON-kolumn med ett JSON-index
Gäller för: Azure SQL Database, Azure SQL Managed Instance, SQL Server 2025 (17.x) och SQL database i Microsoft Fabric
Du kan skapa ett JSON-index direkt på en json-kolumn. JSON-indexet indexerar sökvägarna inom JSON-dokumentet, så ett enda index kan optimera många sökningar över dokumentet utan en separat beräknad kolumn för varje egenskap.
Note
JSON-index stöds inte i SQL Server 2022 (16.x) och tidigare versioner.
Följande exempel skapar en tabell med en json-kolumn och ett JSON-index på den kolumnen:
CREATE TABLE Orders
(
    OrderID INT IDENTITY PRIMARY KEY,
    OrderDetails JSON NOT NULL
);

CREATE JSON INDEX IX_OrderDetails
    ON Orders (OrderDetails);
Med JSON-indexet på plats kan Database Engine använda det för att optimera frågor som använder JSON_VALUE, JSON_PATH_EXISTS, eller JSON_CONTAINS. Till exempel kan följande fråga använda JSON-indexet för att filtrera beställningar efter kundnamn:
SELECT OrderID
FROM Orders
WHERE JSON_VALUE(OrderDetails, '$.Customer.Name') = N'Aaron Campbell';
För fullständig syntax, indexalternativ och den kompletta listan över stödda predikat, se CREATE JSON INDEX.
Indexera JSON-egenskaper med hjälp av beräknade kolumner
Använd ett index på en beräknad kolumn när du lagrar JSON som varchar- eller nvarchar-text, eller när du vill exponera en enskild JSON-egenskap som en starkt typad kolumn för filtrering eller sortering. Vanligtvis vill du filtrera eller sortera frågeresultat efter en eller flera egenskaper hos JSON-dokumenten.
Example
Anta i det här exemplet att tabellen AdventureWorks.SalesOrderHeader har en Info kolumn som innehåller olika uppgifter i JSON-format om försäljningsorder. Den innehåller till exempel ostrukturerade data om kunder, säljare, leverans- och faktureringsadresser och så vidare. Du kan använda värden från kolumnen Info för att filtrera försäljningsorder för en kund.
Som standard finns inte den kolumn Info som används. Den kan skapas i AdventureWorks databasen med följande kod. Följande exempel gäller inte för AdventureWorksLT serien med exempeldatabaser.
IF NOT EXISTS (SELECT *
               FROM sys.columns
               WHERE object_id = OBJECT_ID('[Sales].[SalesOrderHeader]')
                     AND name = 'Info')
    ALTER TABLE [Sales].[SalesOrderHeader]
        ADD [Info] NVARCHAR (MAX) NULL;
GO

UPDATE h
SET [Info] =
(
    SELECT concat(p.FirstName, N' ', p.LastName) AS [Customer.Name],
            p.BusinessEntityID AS [Customer.ID],
            p.[PersonType] AS [Customer.Type],
            soh.SalesOrderID AS [Order.ID],
            soh.SalesOrderNumber AS [Order.Number],
            soh.OrderDate AS [Order.CreationDate],
            soh.TotalDue AS [Order.TotalDue]
    FROM [Sales].SalesOrderHeader AS soh
        INNER JOIN [Sales].[Customer] AS c
            ON c.CustomerID = soh.CustomerID
        INNER JOIN [Person].[Person] AS p
            ON p.BusinessEntityID = c.CustomerID
    WHERE soh.SalesOrderID = h.SalesOrderID
    FOR JSON PATH, WITHOUT_ARRAY_WRAPPER
)
FROM [Sales].SalesOrderHeader AS h;
Begäran för optimering
Här är ett exempel på den typ av fråga som du vill optimera med hjälp av ett index.
SELECT SalesOrderNumber,
       OrderDate,
       JSON_VALUE(Info, '$.Customer.Name') AS CustomerName
FROM Sales.SalesOrderHeader
WHERE JSON_VALUE(Info, '$.Customer.Name') = N'Aaron Campbell';
Exempelindex
Om du vill påskynda dina filter eller ORDER BY-satser över en egenskap i ett JSON-dokument kan du använda samma index som du redan använder i andra kolumner. Du kan dock inte direkt referera till egenskaper i JSON-dokumenten.
- Skapa först en "virtuell kolumn" som returnerar de värden som du vill använda för filtrering.
- Skapa sedan ett index för den virtuella kolumnen.
I följande exempel skapas en beräknad kolumn som kan användas för indexering. Sedan skapas ett index för den nya beräknade kolumnen. I det här exemplet skapas en kolumn som exponerar kundnamnet, som är lagrat i den $.Customer.Name-markerade sökvägen i JSON-data.
ALTER TABLE Sales.SalesOrderHeader
    ADD vCustomerName AS JSON_VALUE(Info, '$.Customer.Name');

CREATE INDEX idx_soh_json_CustomerName
    ON Sales.SalesOrderHeader(vCustomerName);
Det här uttalandet returnerar följande varning:
Warning! The maximum key length for a nonclustered index is 1700 bytes.
The index 'vCustomerName' has maximum length of 8000 bytes.
For some combination of large values, the insert/update operation will fail.
Funktionen JSON_VALUE kan returnera textvärden upp till 8 000 byte (till exempel som nvarchar(4000) typ). De värden som är längre än 1 700 byte kan dock inte indexeras. Om du försöker ange värdet i den indexerade beräknade kolumnen som är längre än 1 700 byte misslyckas åtgärden för datamanipuleringsspråk (DML).
För bättre prestanda kan du prova att omvandla det värde som du exponerar med hjälp av en beräknad kolumn till den minsta tillämpliga datatypen. Använd int och datetime2 typer i stället för strängtyper.
Mer information om den beräknade kolumnen
En beräknad kolumn är inte persistent. En beräknad kolumn beräknas bara när indexet behöver återskapas. Det upptar inte ytterligare utrymme i tabellen.
Det är viktigt att du skapar den beräknade kolumnen med samma uttryck som du planerar att använda i dina frågor . I det här exemplet är uttrycket JSON_VALUE(Info, '$.Customer.Name').
Du behöver inte skriva om dina frågor. Om du använder uttryck med funktionen JSON_VALUE, som du ser i föregående exempelfråga, ser SQL Server att det finns en motsvarande beräknad kolumn med samma uttryck och tillämpar ett index om möjligt.
Körningsplan för det här exemplet
Här är körningsplanen för frågan i det här exemplet.
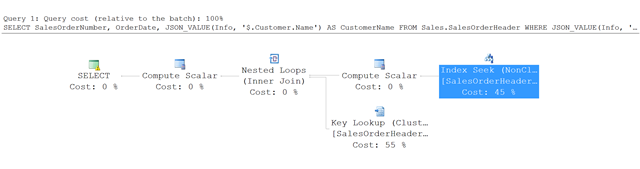
I stället för en fullständig tabellgenomsökning använder SQL Server en indexsökning i det icke-illustrerade indexet och hittar de rader som uppfyller de angivna villkoren. Sedan används en nyckelsökning i tabellen SalesOrderHeader för att hämta de andra kolumnerna som refereras i frågan – i det här exemplet SalesOrderNumber och OrderDate.
Optimera indexet ytterligare med inkluderade kolumner
Om du lägger till obligatoriska kolumner i indexet kan du undvika den här extra sökningen i tabellen. Du kan lägga till dessa kolumner som standard inkluderade kolumner, som du ser i följande exempel, vilket utökar föregående CREATE INDEX exempel.
CREATE INDEX idx_soh_json_CustomerName
    ON Sales.SalesOrderHeader(vCustomerName)
    INCLUDE(SalesOrderNumber, OrderDate);
I det här fallet behöver SQL Server inte läsa mer data från SalesOrderHeader tabellen eftersom allt som behövs ingår i det icke-illustrerade JSON-indexet. Den här typen av index är ett bra sätt att kombinera JSON- och kolumndata i frågor och skapa optimala index för din arbetsbelastning.
Beräknade kolumnindex är kollationsmedvetna
En viktig egenskap hos beräknade kolumnindex över JSON-data är att de är kollationsmedvetna. Resultatet av den JSON_VALUE funktion som du använder när du skapar den beräknade kolumnen är ett textvärde som ärver dess sortering från indatauttrycket. Därför sorteras värden i indexet med hjälp av sorteringsreglerna som definieras i källkolumnerna.
För att visa att indexen är sorteringsmedvetna skapar följande exempel en enkel samlingstabell med en primärnyckel och JSON-innehåll.
CREATE TABLE JsonCollection
(
    id INT IDENTITY CONSTRAINT PK_JSON_ID PRIMARY KEY,
    [json] NVARCHAR (MAX) COLLATE SERBIAN_CYRILLIC_100_CI_AI
        CONSTRAINT [Content should be formatted as JSON] CHECK (ISJSON(json) > 0)
);
Föregående kommando anger den serbiska kyrilliska sorteringen för kolumnen json. I följande exempel fylls tabellen i och ett index skapas för namnegenskapen.
INSERT INTO JsonCollection
VALUES (N'{"name":"Иво","surname":"Андрић"}'),
       (N'{"name":"Андрија","surname":"Герић"}'),
       (N'{"name":"Владе","surname":"Дивац"}'),
       (N'{"name":"Новак","surname":"Ђоковић"}'),
       (N'{"name":"Предраг","surname":"Стојаковић"}'),
       (N'{"name":"Михајло","surname":"Пупин"}'),
       (N'{"name":"Борислав","surname":"Станковић"}'),
       (N'{"name":"Владимир","surname":"Грбић"}'),
       (N'{"name":"Жарко","surname":"Паспаљ"}'),
       (N'{"name":"Дејан","surname":"Бодирога"}'),
       (N'{"name":"Ђорђе","surname":"Вајферт"}'),
       (N'{"name":"Горан","surname":"Бреговић"}'),
       (N'{"name":"Милутин","surname":"Миланковић"}'),
       (N'{"name":"Никола","surname":"Тесла"}');
GO

ALTER TABLE JsonCollection
    ADD vName AS JSON_VALUE(json, '$.name');

CREATE INDEX idx_name
    ON JsonCollection(vName);
Föregående kommandon skapar ett standardindex för den beräknade kolumnen vName, som representerar värdet från egenskapen JSON $.name. På den serbiska kyrilliska kodsidan är bokstävernas ordning А, Б, В, Г, Д, Ђ, Еosv. Ordningen på objekt i indexet är kompatibel med serbiska kyrilliska regler eftersom resultatet av funktionen JSON_VALUE ärver dess sortering från källkolumnen. Följande exempel frågar den här samlingen och sorterar resultatet efter namn.
SELECT JSON_VALUE(json, '$.name'),
       *
FROM JsonCollection
ORDER BY JSON_VALUE(json, '$.name');
Om du tittar på den faktiska körningsplanen ser du att den använder sorterade värden från det icke-klustrade indexet.

Även om förfrågan innehåller en ORDER BY-sats använder körningsplanen ingen sorteringsoperatör. JSON-indexet är redan ordnat enligt serbiska kyrilliska regler. Därför kan SQL Server använda det icke-klustrade indexet där resultaten redan är sorterade.
Men om du ändrar sorteringsordningen för ORDER BY-uttrycket, till exempel om du lägger till COLLATE French_100_CI_AS_SC efter funktionen JSON_VALUE, kommer du att få en annan frågekörningsplan.
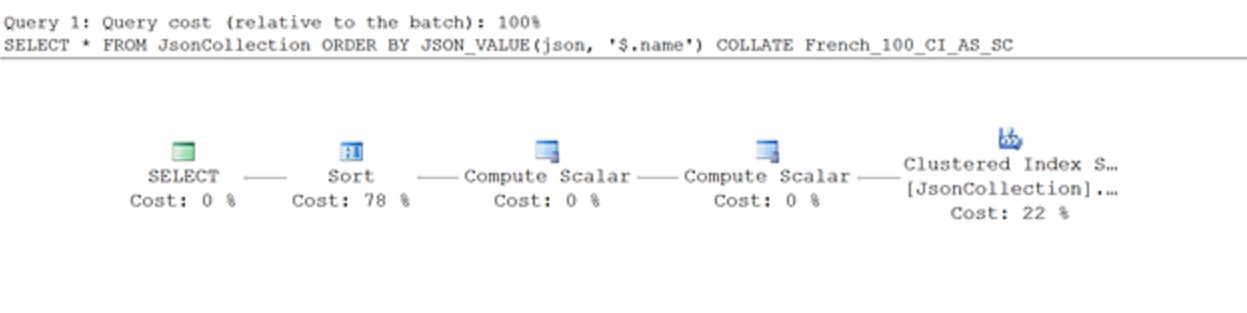
Eftersom ordningen på värden i indexet inte är kompatibel med franska sorteringsregler kan SQL Server inte använda indexet för att sortera resultat. Därför lägger den till en sorteringsoperator som sorterar resultat med hjälp av franska sorteringsregler.
Microsoft-videor
En visuell introduktion till det inbyggda JSON-stödet finns i följande video: