หมายเหตุ
การเข้าถึงหน้านี้ต้องได้รับการอนุญาต คุณสามารถลอง ลงชื่อเข้าใช้หรือเปลี่ยนไดเรกทอรีได้
การเข้าถึงหน้านี้ต้องได้รับการอนุญาต คุณสามารถลองเปลี่ยนไดเรกทอรีได้
นําไปใช้กับ: ✅ คลังสินค้าใน Microsoft Fabric
บทความนี้อธิบายวิธีการย้ายจากพูล SQL เฉพาะทาง Azure Synapse Analytics ไปยัง Microsoft Fabric คลังข้อมูล
เคล็ดลับ
สําหรับข้อมูลเพิ่มเติมเกี่ยวกับกลยุทธ์และการวางแผนการย้ายข้อมูล โปรดดูที่ การวางแผนการย้าย: Azure Synapse Analytics pool SQL เฉพาะเพื่อ Fabric คลังข้อมูล
ประสบการณ์อัตโนมัติสําหรับการโยกย้ายจากกลุ่ม SQL เฉพาะของ Azure Synapse Analytics สามารถใช้งานได้โดยใช้ Fabric Migration Assistant สําหรับ คลังข้อมูล ส่วนที่เหลือของบทความนี้ประกอบด้วยขั้นตอนการโยกย้ายข้อมูลด้วยตนเองเพิ่มเติม
ตารางต่อไปนี้สรุปวิธีการย้ายสคีมาข้อมูล (DDL), โค้ดฐานข้อมูล (DML) และข้อมูล คอลัมน์ ตัวเลือก จะลิงก์ไปยังรายละเอียดของแต่ละสถานการณ์
| หมายเลขออปชั่น | ตัวเลือก | สิ่งที่ทำ | ทักษะหรือความชอบ | บทภาพยนตร์ |
|---|---|---|---|---|
| 1 | โรงงานข้อมูล | การแปลงเค้าร่าง (DDL) การดึงข้อมูล การนำเข้าข้อมูล |
ADF/ไปป์ไลน์ | ทําให้ทุกอย่างง่ายขึ้นในสคีมาหนึ่ง (DDL) และการโยกย้ายข้อมูล แนะนําสําหรับ ตารางมิติ |
| 2 | Data Factory พร้อมพาร์ติชัน | การแปลงเค้าร่าง (DDL) การดึงข้อมูล การนำเข้าข้อมูล |
ADF/ไปป์ไลน์ | การใช้ตัวเลือกการแบ่งพาร์ติชันเพื่อเพิ่มการทํางานแบบขนานในการอ่าน/เขียน ซึ่งมีอัตราความเร็วเทียบกับตัวเลือกที่ 1 สิบครั้ง แนะนําสําหรับตารางข้อเท็จจริง |
| 3 | Data Factory ที่มีรหัสเร่ง | การแปลงเค้าร่าง (DDL) | ADF/ไปป์ไลน์ | แปลงและโยกย้าย Schema (DDL) ก่อน จากนั้นใช้ CETAS เพื่อแยกและคัดลอก/โรงงานข้อมูลไปยังการนําเข้าข้อมูลเพื่อประสิทธิภาพการนําเข้าโดยรวมที่ดีที่สุด |
| 4 | โค้ดเร่งขั้นตอนที่จัดเก็บไว้ | การแปลงเค้าร่าง (DDL) การดึงข้อมูล การประเมินโค้ด |
T-SQL | ผู้ใช้ SQL ที่ใช้ IDE ที่มีการควบคุมงานที่ละเอียดมากขึ้นซึ่งพวกเขาต้องการใช้งาน ใช้คัดลอก/โรงงานข้อมูลเพื่อนําเข้าข้อมูล |
| 5 | ส่วนขยายโครงการฐานข้อมูล SQL สําหรับ Visual Studio Code | การแปลงเค้าร่าง (DDL) การดึงข้อมูล การประเมินโค้ด |
โครงการ SQL | โครงการฐานข้อมูล SQL สําหรับการปรับใช้ด้วยการรวมกันของตัวเลือกที่ 4 ใช้คัดลอกหรือโรงงานข้อมูลเพื่อนําเข้าข้อมูล |
| 6 | สร้างตารางภายนอกเป็นการเลือก (CETAS) | การดึงข้อมูล | T-SQL | ค่าใช้จ่ายในการแยกข้อมูลที่มีประสิทธิภาพและประสิทธิภาพสูงลงใน Azure Data Lake Storage (ADLS) Gen2 ใช้คัดลอก/โรงงานข้อมูลเพื่อนําเข้าข้อมูล |
| 7 | โยกย้ายโดยใช้ dbt | การแปลงเค้าร่าง (DDL) การแปลงรหัสฐานข้อมูล (DML) |
dbt | ผู้ใช้ dbt ที่มีอยู่สามารถใช้ตัวปรับต่อ dbt Fabric เพื่อแปลง DDL และ DML ของพวกเขาได้ จากนั้นคุณต้องโยกย้ายข้อมูลโดยใช้ตัวเลือกอื่นในตารางนี้ |
เลือกปริมาณงานสําหรับการโยกย้ายเบื้องต้น
เมื่อตัดสินใจว่าจะเริ่มต้นจากจุดเริ่มต้นของพูล SQL เฉพาะของ Synapse เพื่อ Fabric คลังข้อมูล โครงการย้ายข้อมูล ให้เลือกพื้นที่งานที่คุณสามารถ:
- พิสูจน์ความเป็นไปได้ในการย้ายไปยัง Fabric คลังข้อมูล ด้วยการส่งมอบประโยชน์จากสภาพแวดล้อมใหม่อย่างรวดเร็ว เริ่มต้นจากสิ่งเล็ก ๆ เรียบง่าย และเตรียมรับมือกับการย้ายข้อมูลเล็ก ๆ หลายครั้ง
- ช่วยให้พนักงานด้านเทคนิคของคุณจะได้รับประสบการณ์ที่เกี่ยวข้องกับกระบวนการและเครื่องมือที่พวกเขาใช้เมื่อโยกย้ายข้อมูลไปยังพื้นที่อื่น ๆ
- สร้างเทมเพลตสําหรับการโยกย้ายเพิ่มเติมที่เฉพาะเจาะจงกับสภาพแวดล้อม Synapse ต้นทาง และเครื่องมือและกระบวนการเพื่อช่วย
เคล็ดลับ
สร้างรายการวัตถุที่จะย้าย และบันทึกกระบวนการย้ายตั้งแต่ต้นจนจบ เพื่อให้คุณสามารถทําซ้ํากับพูล SQL เฉพาะหรือเวิร์กโหลดอื่น ๆ ได้
ปริมาณข้อมูลที่ย้ายในครั้งแรกควรมีมากพอที่จะแสดงความสามารถและประโยชน์ของสภาพแวดล้อม Fabric คลังข้อมูล แต่ไม่ควรมากจนแสดงคุณค่าได้อย่างรวดเร็ว ขนาดในช่วง 1-10 เทราไบต์เป็นเรื่องปกติ
การย้ายข้อมูลด้วยโรงงานข้อมูล Fabric
ส่วนนี้อธิบายตัวเลือกของ Data Factory สําหรับผู้ใช้ที่คุ้นเคยกับ Azure Data Factory และ Synapse pipelines อินเทอร์เฟซแบบลากและวางเป็นวิธีที่ง่ายในการแปลง DDL และย้ายข้อมูล
โรงงานข้อมูลผ้าสามารถทํางานต่อไปนี้:
- แปลงสคีมา (DDL) เป็นไวยากรณ์ Fabric คลังข้อมูล
- สร้างสคีมา (DDL) บน Fabric คลังข้อมูล
- ย้ายข้อมูลไปยัง Fabric คลังข้อมูล
ตัวเลือกที่ 1 การย้ายสคีมาและการย้ายข้อมูล - ผู้ช่วยข้อมูลคัดลอกและกิจกรรม ForEach Copy
วิธีนี้ใช้ผู้ช่วยข้อมูล Data Factory Copy เพื่อเชื่อมต่อกับพูล SQL เฉพาะแหล่งที่มา แปลงไวยากรณ์ DDL ของพูล SQL เฉพาะเป็น Fabric และคัดลอกข้อมูลไปยัง Fabric คลังข้อมูล คุณสามารถเลือกตารางเป้าหมายอย่างน้อยหนึ่งตาราง (สําหรับ TPC-DS ชุดข้อมูลมี 22 ตาราง) จะสร้าง ForEach เพื่อวนรอบผ่านรายการของตารางที่เลือกใน UI และสร้างเธรดกิจกรรมการคัดลอกแบบขนาน 22 รายการ
- มีการสร้างและดําเนินการ query จํานวน 22
SELECTรายการ (หนึ่งชุดสําหรับแต่ละตารางที่เลือก) ในกลุ่ม SQL เฉพาะ - ตรวจสอบให้แน่ใจว่าคุณมี DWU และคลาสทรัพยากรที่เหมาะสมเพื่อให้คําสั่งค้นหาที่สร้างขึ้นสามารถทํางานได้ สําหรับกรณีนี้ คุณจําเป็นต้องมี DWU1000
staticrc10ขั้นต่ําเพื่อให้มีคิวรีได้สูงสุด 32 คิวรีสําหรับการจัดการ 22 คิวรีที่ส่ง - การคัดลอกข้อมูลโดยตรงจากพูล SQL เฉพาะไปยัง Fabric คลังข้อมูล กับ Data Factory จําเป็นต้องมีการจัดขั้นตอน กระบวนการรับเข้ามีสองขั้นตอน:
- เฟสแรกจะดึงข้อมูลจากพูล SQL เฉพาะเข้าสู่ ADLS ขั้นตอนนี้เรียกว่าการแบ่งระยะ
- เฟสที่สองจะรับข้อมูลแบบสเตจเข้าสู่ Fabric คลังข้อมูล เวลาส่วนใหญ่ที่ใช้ในการรับสารจะอยู่ในขั้นตอนการสเกลย ดังนั้นการสแตนมีผลอย่างมากต่อประสิทธิภาพ
การใช้งานที่แนะนำ
การใช้ผู้ช่วยคัดลอกเพื่อสร้างกิจกรรม ForEach มอบอินเทอร์เฟซที่เรียบง่ายสําหรับการแปลง DDL และนําเข้าตารางที่เลือกจากพูล SQL เฉพาะไปยัง Fabric คลังข้อมูล ในขั้นตอนเดียว
อย่างไรก็ตาม ตัวเลือกนี้ไม่ได้ให้ประสิทธิภาพโดยรวมที่ดีที่สุด การแบ่งขั้นตอนและความจําเป็นในการขนานการอ่านและเขียนในช่วงต้นทางสู่ขั้นตอนเป็นแหล่งหลักของความหน่วง ใช้ตัวเลือกนี้สําหรับตารางมิติเท่านั้น
ตัวเลือกที่ 2 DDL/การโยกย้ายข้อมูล - ไปป์ไลน์โดยใช้ตัวเลือกพาร์ติชัน
เพื่อเพิ่มอัตราการส่งข้อมูลเมื่อโหลดตารางข้อเท็จจริงขนาดใหญ่ด้วย Fabric pipeline ให้ใช้ Copy activity สําหรับแต่ละตารางข้อเท็จจริงและเปิดใช้งานการแบ่งพาร์ติชัน การกําหนดค่านี้ให้ประสิทธิภาพ Copy activity ที่ดีที่สุด
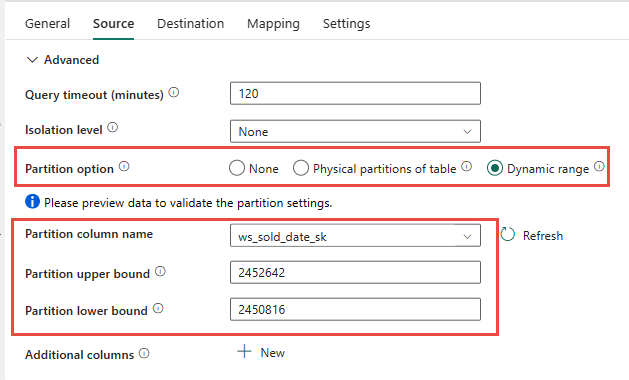
ใช้พาร์ติชันทางกายภาพของตารางต้นทางเมื่อมี หากตารางไม่ได้แบ่งพาร์ติชันทางกายภาพ ให้ระบุคอลัมน์พาร์ติชันและค่าขั้นต่ําและสูงสุดสําหรับการแบ่งพาร์ติชันแบบไดนามิก ในภาพหน้าจอต่อไปนี้ ตัวเลือก Pipeline Source จะระบุช่วงพาร์ติชันแบบไดนามิกตาม ws_sold_date_sk คอลัมน์
การแบ่งพาร์ติชันสามารถเพิ่มอัตราการผ่านขั้นตอนได้ โปรดพิจารณาคําแนะนําต่อไปนี้เมื่อคุณกําหนดค่า:
- ขึ้นอยู่กับช่วงพาร์ติชัน การดําเนินการอาจสร้างคําสั่งมากกว่า 128 คําและใช้ช่อง concurrency ทั้งหมดในพูล SQL เฉพาะ
- คุณต้องปรับขนาดให้น้อยที่สุด DWU6000 เพื่อให้สามารถดําเนินการคําสั่งทั้งหมดได้
- ตัวอย่างเช่น สําหรับตาราง TPC DS
web_salesคิวรี 163 รายการจะถูกส่งไปยังกลุ่ม SQL เฉพาะ ที่ DWU6000 มีคําสั่งค้นหา 128 รายการที่ดําเนินการ ขณะที่คิวมีคําสั่ง 35 รายการ - พาร์ติชันแบบไดนามิกจะเลือกพาร์ติชันช่วงโดยอัตโนมัติ ในกรณีนี้ เป็นช่วง 11 วันสําหรับแต่ละคิวรี SELECT ที่ส่งไปยังกลุ่ม SQL เฉพาะ ตัวอย่าง:
WHERE [ws_sold_date_sk] > '2451069' AND [ws_sold_date_sk] <= '2451080')
...
WHERE [ws_sold_date_sk] > '2451333' AND [ws_sold_date_sk] <= '2451344')
การใช้งานที่แนะนำ
สําหรับตารางข้อเท็จจริง ให้ใช้ Data Factory พร้อมตัวเลือกการแบ่งพาร์ติชันเพื่อเพิ่มอัตราการส่งข้อมูล
อย่างไรก็ตาม การอ่านแบบขนานต้องปรับขนาด SQL pool เฉพาะให้เป็น DWU ที่สูงขึ้นเพื่อให้สามารถดําเนินการ query การสกัดได้ การแบ่งพาร์ติชันช่วยเพิ่มอัตราการใช้ได้ถึงสิบเท่าเมื่อเทียบกับการไม่ใช้พาร์ติชัน คุณสามารถเพิ่ม DWU เพื่อเพิ่มปริมาณงานได้ แต่มีพูล SQL เฉพาะที่อนุญาตให้มีคําสั่งค้นหาที่ใช้งานได้สูงสุด 128 คําสั่ง
สําหรับข้อมูลเพิ่มเติมเกี่ยวกับการแมป Synapse DWU เป็น Fabric ดูที่ บล็อก: การแมปพูล SQL เฉพาะทาง Fabric คลังข้อมูล Azure Synapse compute
ตัวเลือกที่ 3 การย้ายข้อมูล DDL - ผู้ช่วยคัดลอกข้อมูลสําหรับแต่ละกิจกรรมคัดลอก
สองตัวเลือกก่อนหน้านี้เหมาะสําหรับฐานข้อมูลขนาดเล็ก หากคุณต้องการอัตราการส่งข้อมูลที่สูงขึ้น ให้ใช้ทางเลือกนี้:
- ดึงข้อมูลจากพูล SQL เฉพาะไปยัง ADLS เพื่อลดภาระการจัดเตรียม
- ใช้ Data Factory หรือคําสั่ง COPY เพื่อนําเข้าข้อมูลเข้าสู่คลังของคุณ
การใช้งานที่แนะนำ
คุณสามารถใช้ Data Factory เพื่อแปลง Schema (DDL) ของคุณได้ต่อไป โดยใช้ผู้ช่วยคัดลอกข้อมูล คุณสามารถเลือกตารางเฉพาะหรือ ตารางทั้งหมดได้ โดยการออกแบบ วิธีนี้จะย้ายสคีมาในขั้นตอนเดียว โดยดึงสคีมาโดยไม่มีแถวโดยใช้เงื่อนไข TOP 0 เท็จในคําสั่ง query
ตัวอย่างรหัสต่อไปนี้ครอบคลุมการโยกย้าย schema (DDL) ด้วย Data Factory
ตัวอย่างโค้ด: การย้าย Schema (DDL) ด้วย Data Factory
คุณสามารถใช้ Fabric Pipelines เพื่อย้าย DDL (schema) สําหรับวัตถุในตารางจากแหล่งที่มา Azure SQL Database หรือพูล SQL เฉพาะได้อย่างง่ายดาย ท่อนี้ย้ายสคีมา (DDL) สําหรับตารางพูล SQL เฉพาะแหล่งที่มาไปยัง Fabric คลังข้อมูล
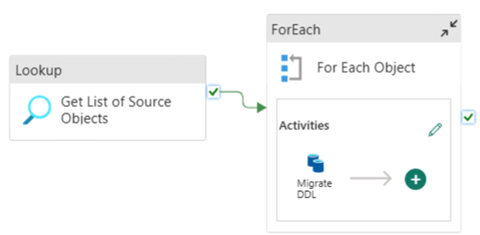
การออกแบบไปป์ไลน์: พารามิเตอร์
ท่อส่งนี้รับพารามิเตอร์ SchemaNameซึ่งคุณใช้เพื่อระบุว่าสคีมาใดจะย้าย สคีมาเริ่มต้นคือ dbo.
ในเขตข้อมูล ค่าเริ่มต้น ให้ใส่รายการแบบคั่นด้วยจุลภาคของ Schema ตารางที่ระบุว่า Schema ใดที่จะโยกย้าย: 'dbo','tpch' เพื่อให้สอง schema dbo และtpch
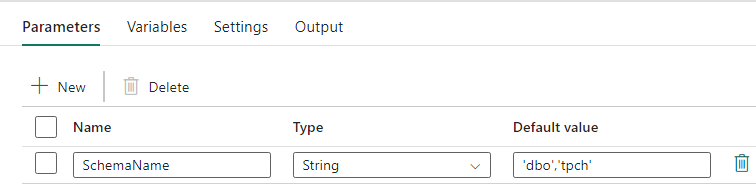
การออกแบบไปป์ไลน์: กิจกรรมการค้นหา
สร้างกิจกรรมการค้นหา และตั้งค่าการเชื่อมต่อเพื่อชี้ไปยังฐานข้อมูลต้นทางของคุณ
ในแท็บ การตั้งค่า :
ตั้งค่าชนิดที่เก็บข้อมูลเป็นภายนอก
การเชื่อมต่อ คือกลุ่ม SQL เฉพาะของ Azure Synapse ของคุณ ชนิดการเชื่อมต่อคือ Azure Synapse Analytics
ใช้คิวรีถูกตั้งค่าเป็นคิวรี
สร้างฟิลด์ Query โดยใช้นิพจน์แบบไดนามิก เพื่อให้คุณสามารถใช้พารามิเตอร์
SchemaNameนี้ในคําสั่งค้นหาที่คืนค่ารายการตารางต้นทางเป้าหมาย เลือก Query แล้วเลือก Add dynamic contentนิพจน์นี้ภายในกิจกรรม LookUp สร้างคําสั่ง SQL เพื่อคิวรีมุมมองระบบเพื่อเรียกใช้รายการของสคีมาและตาราง มันอ้างอิงพารามิเตอร์เพื่อ
SchemaNameอนุญาตให้กรองในสคีมา SQL ผลลัพธ์ของนิพจน์นี้คืออาร์เรย์ของสคีมา SQL และตารางที่กิจกรรม ForEach ใช้เป็นอินพุตใช้รหัสต่อไปนี้เพื่อแสดงรายการตารางผู้ใช้ทั้งหมดที่มีชื่อแผนการ
@concat('
SELECT s.name AS SchemaName,
t.name  AS TableName
FROM sys.tables AS t
INNER JOIN sys.schemas AS s
ON t.type = ''U''
AND s.schema_id = t.schema_id
AND s.name in (',coalesce(pipeline().parameters.SchemaName, 'dbo'),')
')
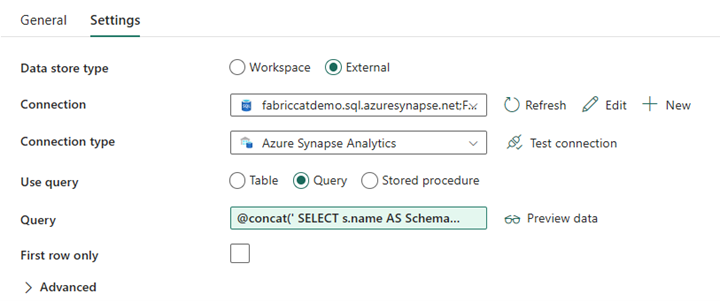
การออกแบบไปป์ไลน์: ForEach Loop
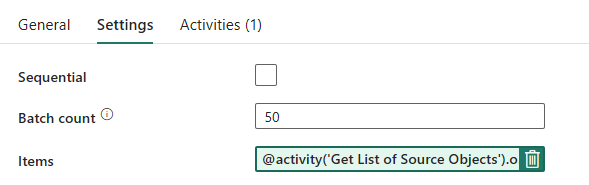
สําหรับ ForEach Loop ให้กําหนดค่าตัวเลือกต่อไปนี้ใน แท็บ การตั้งค่า :
- ปิดใช้งาน Sequential เพื่อให้สามารถทํางานหลายรอบพร้อมกันได้
- กําหนด จํานวน ชุดงานเป็น
50โดยจํากัดจํานวนสูงสุดของการทําซ้ําที่เกิดขึ้นพร้อมกัน - ใช้เนื้อหาแบบไดนามิกในช่อง รายการ เพื่ออ้างอิงผลลัพธ์ของกิจกรรม LookUp ใช้ส่วนย่อยของโค้ดต่อไปนี้:
@activity('Get List of Source Objects').output.value
การออกแบบไปป์ไลน์: คัดลอกกิจกรรมภายใน ForEach Loop
ภายในกิจกรรม ForEach เพิ่มกิจกรรมการคัดลอก เมธอดนี้ใช้ Dynamic Expression Language ภายใน pipeline เพื่อสร้าง SELECT TOP 0 * FROM <TABLE> คําสั่งเพื่อย้ายเฉพาะสคีมาที่ไม่มีข้อมูลไปยังคลังข้อมูล
ในแท็บ แหล่งข้อมูล :
- ตั้งค่าชนิดที่เก็บข้อมูลเป็นภายนอก
- การเชื่อมต่อ คือกลุ่ม SQL เฉพาะของ Azure Synapse ของคุณ ชนิดการเชื่อมต่อคือ Azure Synapse Analytics
- ตั้งค่า ใช้คิวรี เป็น คิวรี
- ในช่อง Query ให้วางคําสั่ง dynamic content query และใช้นิพจน์นี้ซึ่งจะคืนค่าเป็นศูนย์แถว แต่รวม schema ของตารางไว้ด้วย:
@concat('SELECT TOP 0 * FROM ',item().SchemaName,'.',item().TableName)

ใน แท็บปลายทาง :
- ตั้งค่าประเภทที่เก็บข้อมูลเป็นพื้นที่ทํางาน
- ตั้งค่าประเภทที่เก็บข้อมูล Workspace เป็น คลังข้อมูล และตั้งค่า คลังข้อมูล เป็นคลังข้อมูล
- สคีมาและชื่อของตารางปลายทางจะถูกกําหนดโดยใช้เนื้อหาแบบไดนามิก
- Schema หมายถึงฟิลด์
SchemaNameของรอบปัจจุบัน โดยมี snippet:@item().SchemaName - การอ้างอิง
TableNameตารางพร้อมสนิปเปต:@item().TableName
- Schema หมายถึงฟิลด์

การออกแบบไปป์ไลน์: จม
สําหรับอ่างล้างหน้า ให้ชี้ไปที่คลังสินค้าของคุณและอ้างอิง Schema ต้นทางและชื่อตาราง
เมื่อคุณรันท่อส่งนี้ คุณจะเห็นคลังสินค้าของคุณถูกเติมด้วยแต่ละตารางในแหล่งที่มา โดยใช้สคีมาที่ถูกต้อง
การย้ายข้อมูลโดยใช้ stored procedures ในพูล SQL เฉพาะของ Synapse
ตัวเลือกนี้ใช้ stored procedures เพื่อดําเนินการย้ายไปยัง Fabric คลังข้อมูล
คุณสามารถรับตัวอย่างโค้ดได้ที่ microsoft/fabric-migration บน GitHub.com โค้ดนี้ถูกแชร์เป็นโอเพนซอร์ส (Open Source) ดังนั้นอย่าลังเลที่จะมีส่วนร่วมในการทํางานร่วมกันและช่วยเหลือชุมชน
โปรซีเยอร์จัดเก็บของ Fabric Migration สามารถทําได้อะไรบ้าง:
- แปลงสคีมา (DDL) เป็นไวยากรณ์ Fabric คลังข้อมูล
- สร้างสคีมา (DDL) บน Fabric คลังข้อมูล
- แยกข้อมูลจากพูล SQL เฉพาะ Synapse ไปยัง ADLS
- แจ้งเตือนไวยากรณ์ Fabric ที่ไม่รองรับสําหรับโค้ด T-SQL (stored procedures, functions, views)
การใช้งานที่แนะนำ
ตัวเลือกนี้เหมาะสําหรับคุณหากคุณ:
- คุ้นเคยกับ T-SQL
- ต้องการใช้สภาพแวดล้อมการพัฒนาแบบบูรณาการสําหรับการพัฒนา T-SQL
- ต้องการควบคุมงานที่ละเอียดขึ้นว่าคุณทําอะไร
คุณสามารถดําเนินการกระบวนงานที่จัดเก็บเฉพาะสําหรับการแปลง Schema (DDL) การแยกข้อมูล หรือการประเมินรหัส T-SQL
สําหรับการย้ายข้อมูล ให้ใช้ COPY INTO หรือ Fabric Data Factory เพื่อนําเข้าข้อมูลเข้าสู่คลังข้อมูลของคุณ
โยกย้ายโดยใช้โครงการฐานข้อมูล SQL
Fabric คลังข้อมูล รองรับส่วนขยาย SQL Database Projects ที่มีให้ภายใน Visual Studio Code
ส่วนขยายนี้พร้อมใช้งานภายใน Visual Studio Code คุณลักษณะนี้ช่วยให้สามารถควบคุมแหล่งข้อมูล การทดสอบฐานข้อมูล และการตรวจสอบเค้าร่างได้
สําหรับข้อมูลเพิ่มเติมเกี่ยวกับการควบคุมซอร์สโค้ด ดูที่ ภาพรวมการพัฒนาและการปรับใช้
การใช้งานที่แนะนำ
ใช้ตัวเลือกนี้หากคุณต้องการใช้ SQL Database Project สําหรับการปรับใช้ของคุณ ตัวเลือกนี้ผสานรวมขั้นตอนการย้ายข้อมูล Fabric Migration เข้ากับโปรเจกต์ฐานข้อมูล SQL เพื่อมอบประสบการณ์การย้ายข้อมูลที่ราบรื่น
โครงการฐานข้อมูล SQL สามารถ:
- แปลงสคีมา (DDL) เป็นไวยากรณ์ Fabric คลังข้อมูล
- สร้างสคีมา (DDL) บน Fabric คลังข้อมูล
- แยกข้อมูลจากพูล SQL เฉพาะ Synapse ไปยัง ADLS
- ตั้งค่าสถานะไวยากรณ์ที่ไม่รองรับสําหรับรหัส T-SQL (กระบวนงานที่เก็บไว้ ฟังก์ชัน มุมมอง)
สําหรับการย้ายข้อมูล ให้ใช้ COPY INTO หรือ Data Factory เพื่อนําเข้าข้อมูลเข้าสู่คลังข้อมูลของคุณ
ทีม Microsoft Fabric CAT ให้บริการสคริปต์ PowerShell เพื่อสกัด สร้าง และปรับใช้สคีมา (DDL) และโค้ดฐานข้อมูล (DML) ผ่านโปรเจกต์ฐานข้อมูล SQL สําหรับคําแนะนํา ดูที่ microsoft/fabric-migration บน GitHub
สําหรับข้อมูลเพิ่มเติมเกี่ยวกับโครงการฐานข้อมูล SQL โปรดดู เริ่มต้นใช้งานส่วนขยายโครงการฐานข้อมูล SQL และ สร้างโครงการฐานข้อมูลจากบรรทัดคําสั่ง
การโยกย้ายข้อมูลด้วย CETAS
คําสั่ง T-SQL CREATE EXTERNAL TABLE AS SELECT (CETAS) เป็นวิธีที่คุ้มค่าและเหมาะสมที่สุดในการดึงข้อมูลจากพูล SQL เฉพาะของ Azure Synapse ไปยัง Azure Data Lake Storage (ADLS) Gen2
CETAS ทําอะไรได้บ้าง:
- แยกข้อมูลลงใน ADLS
- ตัวเลือกนี้ต้องสร้างสคีมา (DDL) ในคลังข้อมูลของคุณก่อนนําเข้าข้อมูล พิจารณาตัวเลือกในบทความนี้เพื่อโยกย้าย schema (DDL)
ข้อดีของตัวเลือกนี้คือ:
- การย้ายข้อมูลจะส่งเพียงคําค้นหาเดียวต่อตารางไปยังพูล SQL เฉพาะของ Synapse ต้นทาง คําสั่งนี้ไม่ได้ใช้ช่องการทํางานพร้อมกันทั้งหมด และไม่บล็อก ETL การผลิตของลูกค้าพร้อมกันหรือคําสั่งค้นหา
- คุณไม่จําเป็นต้องปรับขนาดให้ DWU6000 เพราะแต่ละโต๊ะใช้ช่องเล่นพร้อมกันเพียงช่องเดียว ดังนั้นคุณสามารถใช้ DWU ที่ต่ํากว่าได้
- การดึงข้อมูลจะทํางานแบบขนานกับทุกโหนดคํานวณ และฟีเจอร์นี้ช่วยปรับปรุงประสิทธิภาพ
การใช้งานที่แนะนำ
ใช้ CETAS เพื่อแยกข้อมูลไปยังไฟล์ ADLS เป็นไฟล์ Parquet ไฟล์ปาร์เก้มีข้อดีในการจัดเก็บข้อมูลที่มีประสิทธิภาพ พร้อมการบีบอัดแบบคอลัมน์ที่ใช้แบนด์วิดท์น้อยลงในการเคลื่อนย้ายข้ามเครือข่าย เนื่องจาก Fabric จัดเก็บข้อมูลในรูปแบบ Delta parquet การนําเข้าข้อมูลจึงเร็วกว่ารูปแบบไฟล์ข้อความถึง 2.5 เท่า เนื่องจากไม่มีภาระการแปลงเป็นรูปแบบ Delta ในระหว่างการนําเข้า
เมื่อต้องการเพิ่มปริมาณงาน CETAS:
- เพิ่มการดําเนินการ CETAS แบบขนาน เพิ่มการใช้ช่องสัญญาณพร้อมกัน แต่ให้ปริมาณงานเพิ่มขึ้น
- ปรับมาตราส่วน DWU บนพูล SQL เฉพาะ Synapse
การโยกย้ายผ่าน dbt
ส่วนนี้อธิบายตัวเลือก dbt สําหรับลูกค้าที่ใช้ dbt ในสภาพแวดล้อม SQL pool เฉพาะของ Synapse อยู่แล้ว
dbt ทําอะไรได้บ้าง:
- แปลงสคีมา (DDL) เป็นไวยากรณ์ Fabric คลังข้อมูล
- สร้างสคีมา (DDL) บน Fabric คลังข้อมูล
- แปลงรหัสฐานข้อมูล (DML) เป็นไวยากรณ์ Fabric
เฟรมเวิร์ก dbt สร้าง DDL และ DML (สคริปต์ SQL) ในระหว่างเดินทางพร้อมกับการดําเนินการแต่ละครั้ง โดยใช้ไฟล์โมเดลที่แสดงเป็นSELECTคําสั่ง dbt จะแปลง DDL/DML ไปยังแพลตฟอร์มเป้าหมายใดก็ได้ทันทีโดยเปลี่ยนโปรไฟล์ (สายอักขระการเชื่อมต่อ) และประเภทอะแดปเตอร์
การใช้งานที่แนะนำ
เฟรมเวิร์ก dbt ใช้แนวทางที่เน้นโค้ดเป็นหลัก ย้ายข้อมูลโดยใช้ตัวเลือกที่ระบุในเอกสารนี้ เช่น CETAS หรือ COPY/Data Factory
โดยใช้อะแดปเตอร์ dbt สําหรับ Microsoft Fabric คลังข้อมูล คุณสามารถย้ายโปรเจกต์ dbt ที่มีอยู่ซึ่งมุ่งเป้าไปยังแพลตฟอร์มต่าง ๆ เช่น Azure Synapse pool SQL เฉพาะ, Snowflake, Databricks, Google BigQuery หรือ Amazon Redshift ไปยังคลังสินค้าได้ด้วยการเปลี่ยนแปลงการตั้งค่าง่าย ๆ
หากต้องการเริ่มต้นโปรเจกต์ dbt ที่มุ่งเป้าไปที่ Fabric คลังข้อมูล ดูที่ Tutorial: Set up dbt for Fabric คลังข้อมูล เอกสารนี้ยังระบุตัวเลือกในการย้ายระหว่างคลังสินค้าและแพลตฟอร์มต่าง ๆ
การนําเข้าข้อมูลเข้าสู่ Fabric คลังข้อมูล
สําหรับการนําเข้าข้อมูลเข้าสู่ Fabric คลังข้อมูล ให้ใช้COPY INTOหรือ Fabric Data Factory ตามความชอบของคุณ ทั้งสองวิธีเป็นตัวเลือกที่แนะนําและมีประสิทธิภาพดีที่สุด เนื่องจากมีอัตราการส่งข้อมูลที่เท่าเทียมกัน โดยต้องแตกไฟล์ไปยัง Azure Data Lake Storage (ADLS) Gen2 แล้ว
ออกแบบกระบวนการของคุณเพื่อประสิทธิภาพสูงสุดโดยพิจารณาปัจจัยต่อไปนี้:
- ด้วย Fabric จะไม่มีการแย่งทรัพยากรเมื่อโหลดหลายตารางจาก ADLS ไปยัง Fabric คลังข้อมูล พร้อมกัน ผลที่ได้คือไม่มีประสิทธิภาพการทํางานลดลงเมื่อโหลดเธรดขนาน อัตราการนําเข้าข้อมูลสูงสุดถูกจํากัดโดยพลังการประมวลผลของความจุ Fabric ของคุณเท่านั้น
- การจัดการปริมาณงานผ้ามีการแยกทรัพยากรที่จัดสรรสําหรับการโหลดและคิวรี ไม่มีการแย่งชิงทรัพยากรในขณะที่คําสั่งค้นหาและการโหลดข้อมูลทํางานพร้อมกัน