Not
Bu sayfaya erişim yetkilendirme gerektiriyor. Oturum açmayı veya dizinleri değiştirmeyi deneyebilirsiniz.
Bu sayfaya erişim yetkilendirme gerektiriyor. Dizinleri değiştirmeyi deneyebilirsiniz.
Azure Veri Gezgini (ADX), büyük ölçekli telemetri ve günlük verilerinin gerçek zamanlı analizi için tam olarak yönetilen bir analiz platformudur. Bu makalede Alınan GB başına maliyetin Azure Veri Gezgini'nde nasıl hesaplandığı, hangi faktörlerin yönlendirebileceği ve kümenizi maliyet verimliliği için nasıl iyileştirebileceğiniz açıklanmaktadır. Büyük veri analizi platformları farklı fiyatlandırma modelleri kullanır. Birçok platformda fiyatlandırma, sorgu hacmi, veri alımı, depolama süresi ve işlem kaynakları gibi faktörler temel alınır. Bu karmaşıklık, ürünler arasında fiyatlandırmayı karşılaştırmayı zorlaştırır.
Azure Veri Gezgini'ni kullanmanın maliyetini anlamanıza yardımcı olmak için bu makalede aktarılmış her GB başına maliyet metriği kullanılır. Bu ölçüm, toplam küme maliyetidir (işlem, depolama, ağ ve hizmet işaretlemesi), bu süre boyunca alınan toplam özgün boyutlu veriye bölünür.
Örnek analizi temel almak için Haziran 2025'te ADX kümelerinin temsili anlık görüntüsü kullanılır. Aşağıdaki bölümlerde analizden elde edilen ana sonuçlar gösterilir, maliyet varyasyonlarını neyin yönlendireceğini ve kullanıcıların performanstan ödün vermeden alınan GB başına maliyeti nasıl iyileştirebileceği açıklanır.
Uyarı
- Bu makaledeki tüm maliyet rakamları liste fiyatlarını gösterir ve indirimleri veya taahhüte dayalı tasarrufları içermez.
- Bu örnek analizin amacı doğrultusunda GB başına maliyet, her SCU'nun genel bir maliyet birimini (örneğin, bir ABD sent) temsil ettiği Örnek Maliyet Birimleri (SCU) ile ifade edilir.
- Liste fiyatları ve bunların nasıl hesaplanması için bkz. Azure Veri Gezgini fiyatlandırma hesaplayıcısı.
Alınan GB başına maliyet analizi
Aşağıdaki grafikte, her maliyet grubu için özgün boyutta alınan ortanca günlük GB (Y ekseni) ile GB başına ortanca maliyet (X ekseni) gösterilmektedir. Kabarcık boyutu, hizmete alınan toplam veriden grubun payını temsil eder.
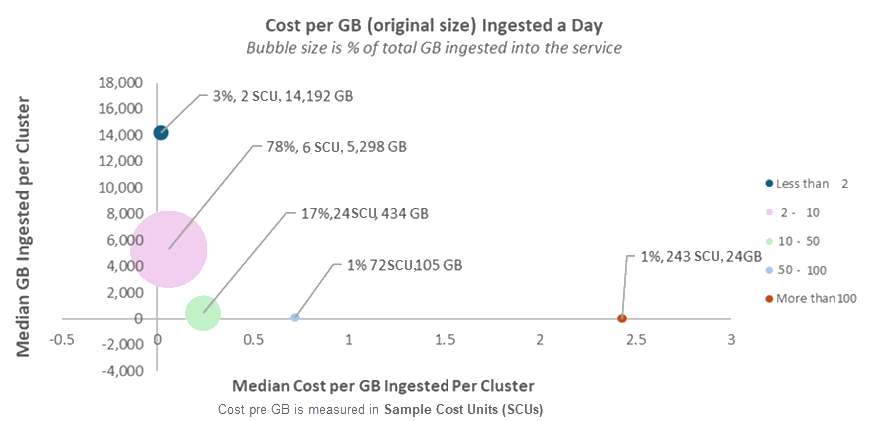
Alınan GB başına maliyet kümeler arasında farklılık gösterir, ancak birkaç örüntü göze çarpar.
Çoğu veri (>75%)GB başına 2 ile 10 SCU (indirimden önce) arasında bir maliyetle alınır.
Verilerin 5% azıGB başına 2 SCU'dan azdır.
Aynı kullanım kategorisi (veya "kabarcık") içinde bile önemli bir çeşitleme görürsünüz. Örneğin, en büyük kabarcığın içinde bir küme GB başına 2 SCU alırken, diğer küme GB başına 10 SCU'ya ulaşır. Bu 5 kat fark. Sonraki bölümlerde bu çeşitlemenin temel nedenleri açıklanmaktadır.
GB başına maliyeti daha yüksek olan kümeler daha az yaygındır ve genellikle daha düşük alım hacimlerine sahiptir. Genel olarak, daha küçük veri hacimleri GB başına daha yüksek maliyet anlamına gelir.
Önemli
Kabarcık grafiği alınan GB başına maliyetin kümeler arasında değiştiğini gösterir. Bu varyasyon iyi veya kötü uygulamaları göstermez. Hizmet için farklı senaryoları, yapılandırmaları ve kullanım desenlerini yansıtır.
Örneğin, bir küme uyumluluk için verileri daha uzun süre saklayabilir ve bu da depolama maliyetlerini artırır. Başka bir uygulama, veri alımı sırasında verileri işleyen güncelleştirme ilkelerini kullanabilir ve bu da işlem kullanımını yükseltir. Bu senaryolar, belirli hedeflerle uyumlu kasıtlı tasarım seçimleridir ve GB başına maliyeti doğal olarak etkiler.
Alınan GB başına maliyeti belirleyen faktörler
Küme başına alınan GB başına maliyet varyasyonlarının arkasında bu önemli faktörler vardır:
Depolama süresi: Verileri ne kadar uzun süre depolarsanız maliyet o kadar yüksek olur. Bkz. saklama politikası.
Yüksek CPU kullanımı: Yoğun sorgular, veri işleme veya dönüştürmeler gibi eylemler yüksek CPU kullanımına neden olur.
Önbellek ayarları: Daha fazla veri önbelleğe almak performansı artırır ancak maliyetleri artırabilir. Bkz. önbellek ilkesi.
Soğuk veri kullanımı: Soğuk verilere erişen sorgular okuma işlemlerini tetikler ve maliyete ekler. Bkz sıcak ve soğuk önbellek.
Veri dönüştürme ve iyileştirme: Güncelleştirme İlkeleri, Gerçekleştirilmiş Görünümler ve Bölümleme gibi özellikler CPU kaynaklarını kullanır ve maliyeti yükseltebilir. Güncelleme ilkeleri, gerçekleştirilmiş görünümler ve bölümler öğelerine bakın.
Alım hacmi: Kümeler daha yüksek alım hacimlerinde daha uygun maliyetli çalışır.
Akış ve Sıralı alım: Her birinin maliyet profili, kullanım durumuna göre farklılık gösterir. Bkz. Streaming ve Kuyrukta.
Şema tasarımı: Çok sütunlu geniş tabloların daha fazla işlem ve depolama kaynağına ihtiyacı vardır ve bu da maliyetleri yükseltir.
Gelişmiş özellikler: Takipçiler, özel uç noktalar ve Python korumalı alanları gibi seçenekler daha fazla kaynak tüketir ve maliyete eklenebilir.
Veri işlem hattı seçimi: Bazı alım yollarının maliyeti daha düşüktür. Örneğin, Event Grid alımı genellikle Event Hubs'dan daha ucuzdur.
Otomatik ölçeklendirme: Otomatik ölçeklendirmesi olmayan kümeler, boyutları isteğe bağlı olarak ayarlanmadığı için genellikle daha pahalıya mal olur.
Bu faktörlerin çoğunu hem performansı hem de maliyeti iyileştirmek için yapılandırabilirsiniz.
Önemli maliyet sürücülerine daha yakından bakış
Bu bölümde, Azure Veri Gezgini'nde alınan GB başına maliyeti etkileyen temel faktörler incelenmektedir ve bu maliyetleri nasıl yönetebileceğinize ve iyileştirebileceğinize ilişkin içgörüler sağlanır.
Veri saklamanın maliyet üzerindeki etkisi
ADX'te, alınan tüm veriler kalıcı depolama alanında depolanır. Her tablo ve gerçekleştirilmiş görünüm, verilerin ne kadar süreyle tutulduğunu tanımlayan bir bekletme ilkesine sahiptir. Veriler ne kadar uzun süre tutulursa Azure Depolama fiyatlandırması temelinde maliyet o kadar yüksek olur. Uyumluluk gibi uzun vadeli depolamaya ihtiyacınız olduğunda, sürekli depolama giderleri içerdiğinden alınan GB başına maliyet artar.
Küme tarafından bildirilen kapsam boyutuna ek olarak iki ek maliyet sürücüsü vardır:
- Bekletme arabelleği: Yanlışlıkla veri kaybına karşı koruma sağlamak için varsayılan olarak fazladan 7 günlük veriler depolanır.
- Kurtarılabilirlik yükü: Kurtarılabilirlik ayarının etkinleştirildiği tablolar için (varsayılan), veriler 14 gün daha saklanır. Bu, birleştirme ve yeniden derleme işlemleri sırasında oluşturulan ara blobları içerir.
Küme boyutu
Küme boyutu, kümedeki makine (düğüm) sayısıdır. Her makine türüne (SKU) bağlı olarak maliyet ekler. Otomatik ölçeklendirme , küme boyutunu CPU kullanımına göre ayarlar, böylece sistem boşta veya yedekli kaynaklardan kaçınarak maliyeti ve performansı iyileştirebilir.
Otomatik ölçeklendirme, önbelleğe alınan verilerin kullanılabilir SSD alanına sığdığından emin olmak için küme boyutunu ayarlar. Sonuç olarak, büyük bir önbellek küme boyutunu artırabilir ve CPU kullanımı düşükse bu, GB başına maliyetin artmasına neden olabilir. Önbellek boyutunu iyileştirme hakkında daha fazla bilgi için Bkz. Önbellek sekmesiKümeler İçgörüleri aracı .
Çok sayıda sorgu çalıştıran veya Gerçekleştirilmiş Görünümler, Güncelleştirme İlkeleri veya Bölümleme gibi yoğun CPU kullanan kümeler kümeyi ölçeklendirerek GB başına maliyeti yükseltebilir. Bu özelliklerin sorgu performansını önemli ölçüde artırabileceğini ve sorgu CPU kullanımını azaltabileceğini ve böylece genel verimliliği artırabileceğini unutmayın.
Alınan veri hacmi
Küme büyüdükçe daha fazla düğüm eklenir ve toplam maliyet artar. Bu maliyet alınan tüm verilere yayılır, bu nedenle ne kadar çok veri alırsanız GB başına maliyet o kadar düşük olur.
Soğuk veri kullanımı
Sorgular diskte depolanan soğuk verilere sık sık eriştiğinde, daha fazla kaynak kullanan okuma işlemlerine neden olur ve genel küme maliyetini artırabilir.
Akış ve Kuyruklu Alma Karşılaştırması
Her alım yönteminin farklı maliyet, gecikme süresi ve işlevsellik özellikleri vardır, bu nedenle her biri farklı senaryolar için daha iyidir. Maliyet açısından, sürekli veri akışıyla birçok küçük tabloyu alırken akışla veri alımı daha ucuzken, kuyrukta veri alımı büyük tablolar için daha uygun maliyetlidir.
Tavsiye
Alınan GB başına maliyeti iyileştirme
Önemli maliyet sürücülerinin yapılandırmalarını denetleerek kümenizin verimlilik gereksinimlerine ve hizmet gereksinimlerine uygun olduğundan emin olun. Özellikle:
- Okuma işlemlerini azaltmak için soğuk veriler üzerinden sorguları en aza indirin.
- Küme boyutunu taleple dinamik olarak eşleştirmek için otomatik ölçeklendirmeyi etkinleştirin.