Not
Bu sayfaya erişim yetkilendirme gerektiriyor. Oturum açmayı veya dizinleri değiştirmeyi deneyebilirsiniz.
Bu sayfaya erişim yetkilendirme gerektiriyor. Dizinleri değiştirmeyi deneyebilirsiniz.
Important
Bu özellik Beta sürümündedir.
Databricks'te Python birim testi hakkında genel bilgi için bkz. birim testi Python.
Lakeflow işlem hatları, web tabanlı Lakeflow Pipelines Düzenleyicisi'nde Python birim testleri yazmayı destekler. Bu, sahte verileri kullanarak Python veya SQL dönüştürme mantığını doğrulamanızı sağlar. İşlem hattı test çerçevesi ile uç durumları test edebilir, özel işlem hattı API'lerini (Otomatik CDC, akış tabloları, beklentiler, ekleme akışları) doğrulayabilir ve desteklenen tablo tanımlayıcı işlemleri için sahte girişler kullanarak yineleyebilirsiniz. Testleri çalıştırmadan önce yalıtım sınırlamalarını gözden geçirin.
- Yalıtılmış test yürütme: Çerçeve, tablo işlemlerini işlem hattının varsayılan kataloğundaki geçici bir test şemasına yönlendiren bir SparkSession sağlar, böylece üretim tablolarını etkilemeden giriş verileriyle dalga geçebilir ve test çıkışları yazabilirsiniz. Yalıtım, bir tabloya adıyla başvuran işlemler için geçerlidir; bkz. Sınırlamalar.
- Esnek test kapsamı: SparkSession testini kullanarak işlem hattının işlem hattında bir işlem hattının alt kümesini (tek tek tablolar, bağımlı tablo zincirleri veya tüm işlem hatları) yürütebilirsiniz.
- Sonuç doğrulama: Standart pytest onaylarını kullanarak bir testte oluşturulan yalıtılmış çıktı tablolarının sonuçlarını doğrulayın.
Birim testi ne zaman kullanılır?
Tipik kullanım örnekleri şunlardır:
- Yeni dönüştürme mantığını doğrulama: Üretim verilerine karşı çalıştırmadan önce dönüştürmenizin beklenen şemayı, satır sayılarını, toplamaları ve iş mantığını ürettiğini test edin.
- Auto CDC belirtimlerini test etme: Auto CDC akış tanımlarınızın, test verileri kullanarak değişiklik olaylarını; ekleme, güncelleme, silme ve SCD (Yavaş Değişen Boyut) türlerini doğru şekilde işlediğini doğrulayın.
- Beklentilerin ve veri kalitesi kurallarının test edilmesi: Beklentilerin gerektiğinde başarısız olduğunu ve veriler geçerli olduğunda karşılandığını doğrulayın.
- Bağımlı tablolarda test etme: Verilerin işlem hattı grafınız üzerinden doğru şekilde aktığını doğrulamak için dönüştürme zincirlerini (bronz, gümüş ve altın gibi) test edin.
Requirements
İşlem hattı
Ownerizni ve ayrıca işlem hattının varsayılan kataloğundaUSE CATALOGveCREATE SCHEMAayrıcalıkları. Çerçeve, testlerin çalıştığı geçici test şemasını oluşturmak için bu ayrıcalıklara ihtiyaç duyar.İşlem hattı iznini denetlemek veya ayarlamak için işlem hattını açın ve Paylaş'a tıklayın. Pipeline’ın
Owner(IS OWNER) olması gerekir;CAN RUNveCAN MANAGE, testleri çalıştırmak için yeterli değildir. Bkz. İşlem hattı izinlerini yapılandırma.Katalog ayrıcalıklarını denetlemek veya ayarlamak için kataloğu Katalog Gezgini'nde açın, İzinler sekmesini seçin ve ve
USE CATALOG'ye sahipCREATE SCHEMAolduğunuzu onaylayın. Bir katalog sahibi, bir metastore yöneticisi veyaMANAGEayrıcalığına sahip bir kullanıcı, bunları SQL ile de dahil olmak üzere verebilir:GRANT USE CATALOG, CREATE SCHEMA ON CATALOG <catalog_name> TO `<principal>`;Daha fazla bilgi için Unity Kataloğu ayrıcalıkları referansı bölümüne bakın.
İşlem hattı, tetiklemeli (sürekli olmayan) modda yapılandırılmalıdır.
Pipeline, Databricks Runtime 18.1 veya üzeri sürümlerde çalışmalıdır. Önceki çalışma zamanlarında birim test modülü yer almıyordu. Bir güncellemenin hangi çalışma zamanında sürümünde çalıştığını kontrol etmek için pipeline olay günlüğüne sorgu yapın. Bkz. Çalışma zamanı bilgileri.
Spark Connect desteklenmez.
Note
Test yalıtımı, bir tabloya adıyla başvuru yapan tablo işlemlerini kapsar. Yalıtımı atlayan işlemler hem test kodunuzda hem de geçişli bağımlılıkları da dahil olmak üzere seçtiğiniz çıkışlar tarafından yürütülen herhangi bir işlem hattı kodunda gerçekleşebilir. Güvenli görünen bir test dosyası, yine de yol ya da bağlayıcı üzerinden okuma veya yazma yapan ve üretim verileri üzerinde işlem gerçekleştiren bir işlem hattı akışını çalıştırabilir. Testlerin üretim verilerini veya meta verilerini etkilemesini korumak için şu kuralları izleyin:
- Her tabloya adıyla (
catalog.schema.table) başvurun ve tüm girdileri adıyla sahteleyin. Yola (/Volumes/...,dbfs:/..., ,s3://...abfss://...) göre okumayın veya yazmayın ve Kafka veya Otomatik Yükleyici gibi bağlayıcılardan okumayın. Bunlar yalıtımı atlar ve gerçek üretim sistemleri üzerinde işlem gerçekleştirir. -
GRANT,REVOKE,ALTER ... OWNER TO,SET/UNSET TAGSveyaCREATE/DROP POLICYgibi yönetişim veya sahiplik ifadelerini çalıştırmayın. Bunlar, gerçek üretim ortamındaki güvenliği sağlanabilir nesne üzerinde yürütülür. - Kataloglar veya şemalar oluşturmayın (
CREATE CATALOG,CREATE SCHEMA). Bunlar gerçek Unity Kataloğu meta veri deponuza ulaşır. - Grafiğinde yol tabanlı girdiler, bağlayıcılar, zorunlu yazma işlemleri veya diğer dış yan etkiler bulunuyorsa işlem hattının tamamını çalıştırmayın. Yalnızca bağımlılıkları desteklenen katalog tablosu işlemlerini kullanan ve sahte girişlerle değiştirilen çıkışları seçin.
Ayrıntılar için bkz. Sınırlamalar.
Sınırlamalar
Warning
Bazı işlemler test yalıtımını atlar ve gerçek üretim verileri veya meta veriler üzerinde işlem yapabilir. Testleri çalıştırmadan önce aşağıdaki sınırlamaları gözden geçirin.
Test izolasyonu yalnızca tablo adına göredir
Yol ya da bağlayıcı aracılığıyla okumayın veya yazmayın. Yalıtım, yalnızca bir tabloya adını kullanarak başvuran işlemleri yeniden yönlendirir (örneğin,
spark.read.table("catalog.schema.table")veyadf.write.saveAsTable("catalog.schema.table")). Bir yol veya bağlayıcı aracılığıyla ele alınan işlemler yalıtımı atlar ve doğrudan gerçek üretim sistemlerinde çalışır:-
Yol kullanarak yazma (örneğin,
df.write.save("/Volumes/..."),dbfs:/yolu veyas3://...ya daabfss://...gibi bir bulut ya da harici konum yolu) gerçek üretim depolamasına yazar ve üretim verilerinin üzerine yazabilir. -
Yola göre okuma (örneğin,
spark.read.load(path)veyaspark.read.format("delta").load(path)) sahteniz yerine gerçek üretim verilerini döndürür. -
Bağlayıcıdan okuma gerçek üretim kaynağına bağlanır. Buna Kafka (gerçek broker'lardan okur) ve Auto Loader (
cloudFiles, gerçek bulut depolama yolundan okur) dahildir. Hiçbiri sahte verilerinize yönlendirilmez.
-
Yol kullanarak yazma (örneğin,
İşlem hattı birim testinden
event_log()tablo değerli işlevini kullanmayın. Test modunda,event_log()test çalıştırmanızın olay günlüğüne yönlendirilmez. Üretim veya önceden kaydedilmiş olay günlüğünü döndürebilir; bu nedenle ona yönelik doğrulamalar üretim verilerini okuyabilir. Birim testlerinde olay günlüğü, ilgili çalıştırmaya göre zaten filtrelenmiş bir DataFrame olarak döndürülür. Sonuçlara erişmek için kullanınstatus.event_log. Test şeması kaldırıldıktan sonra da okunabilir kalır. OlabilirNone(örneğin, olay-logu tablo adı çözülemiyorsa), bu yüzden sorgulamadan önce kontrol edin:status = test_pipeline.run(test_spark, set(["catalog.schema.table"])) assert status.event_log is not None flow_progress = status.event_log.filter("event_type = 'flow_progress'")Testte tek bir çalıştırma yerine tüm çalıştırmalarda doğrulama yapmak için
test_pipeline.event_logkullanın. Bir çalıştırmanın döndürdüğü tüm özellikler için Test API'lerine bakınız.Amacınız başarısız olan bir güncelleştirmeyi tanılamaksa, olay günlüğünü okumadan önce
status.is_successifadesini ileri sürmeyin. Olay günlüğü genellikle bir güncelleştirmenin neden başarısız olduğunu anlamak için incelersiniz.
İdare ve DDL işlemleri
- Katalog, şema, izin, sahiplik, etiket ve ilke mutasyonları desteklenmez. Buna ,
CREATE/DROP/ALTER CATALOG(dahilCREATE),/DROP/ ,ALTER SCHEMA,SET MANAGED LOCATIONGRANT/veREVOKEALTER ... OWNER TOSETdahildir./UNSET TAGSCREATE/DROP POLICYaracılığıylatest_sparkyürütülen bazı SQL formları derinlemesine savunma olarak reddedilir; diğer formlar veya doğrudan API'ler aracılığıyla çağrılan aynı işlemler gerçek üretim nesnelerine ulaşabilir. Bu korumalara yalıtım sınırı olarak güvenmeyin. Bu ifadeleri test kodunuzda ve seçilen çıktılar tarafından yürütülen hiçbir işlem hattı kodunda kullanmayın.
operasyonel sınırlamalar
- Eşzamanlı yürütme desteklenmiyor: Test ve işlem hattı güncelleştirmesinin aynı anda çalıştırılması desteklenmez ve sistem bunu engellemez. İkisi arasında koordinasyon olmadığından, bunları eşzamanlı olarak çalıştırmak kaynaklar için çekişmeye neden olabilir; bu da üretim güncellemenizin performansını ciddi ölçüde düşürebilir veya testin başlatılamamasına yol açabilir. İşlem hattı bir güncelleştirme çalıştırırken test başlatmayın (veya bir test çalışırken bir güncelleştirme başlatın); testleri çalıştırmadan önce devam eden güncelleştirmelerin tamamlanmasını bekleyin.
-
Olağan dışı sonlandırmadan sonra geçici şemalar: Her test çalıştırması, işlem hattının varsayılan kataloğunda geçici bir şema (adlandırılmış
redirecting_<id>) oluşturur ve çalıştırma tamamlandığında otomatik olarak bırakır. Bir çalıştırma normal olmayan bir şekilde sona ererse (örneğin, hesaplama kaynağı çalıştırma sırasında kaybedilirse), geçici şema, çalıştırmanın mock ve çıktı tablolarını içerir şekilde geride kalabilir. Üretim verilerini etkilemez. Depolama alanını geri kazanmak için, işlem hattının varsayılan kataloğunda adıredirecting_ile başlayan kalan şemaları el ile silin. - Test çalıştırmaları işlem tüketir: Test çalıştırmaları işlem hattının işlem hattında yürütülür ve normal işlem hattı güncelleştirmeleri olarak faturalandırılır. Test çalıştırmaları için ayrı ölçüm yoktur.
-
Tam yenileme desteklenmiyor: Yalnızca seçmeli yenileme kullanılabilir.
test_pipeline.run()seçtiğiniz çıkışları (veya seçim geçirmediğinizde tüm çıkışları) yeniler; tam yenileme ve tam yenileme seçimi uygulanmaz.
Oluşturma ve aslına uygunluk sınırlamaları
- Yalnızca düzenleyici yürütme: Testler web tabanlı Lakeflow Pipelines Düzenleyicisi'nden çalıştırılmalıdır.
- Yalnızca Python testleri: Testler Python yazılmalıdır. SQL işlem hatlarını test edebilirsiniz, ancak testlerin kendileri Python yazılmalıdır.
- Yönetişim tutarlılığı: Yapay veriler, yerine geçtiği üretim tablolarında tanımlanan satır filtrelerini veya sütun maskelerini miras almaz. Test sonuçları, örnek girdileri tam olarak sağladığınız biçimde yansıtır ve aynı sorgunun yönetilen üretim verileri üzerinde nasıl davrandığından farklı olabilir.
1. Adım: İşlem hattı ayarlarını güncelleştirme
Boru hattını tetiklenmiş modda çalıştıracak şekilde yapılandırın.
- Arayüzde pipeline'ı açın ve Ayarlar'a tıklayın.
- Ardışık düzen modunuTetiklemeli olarak ayarlayın (Sürekli seçeneğini kullanmayın).
Alternatif olarak, JSON işlem hattı ayarlarını doğrudan düzenleyin:
"continuous": false
2. Adım: Test dosyası oluşturma
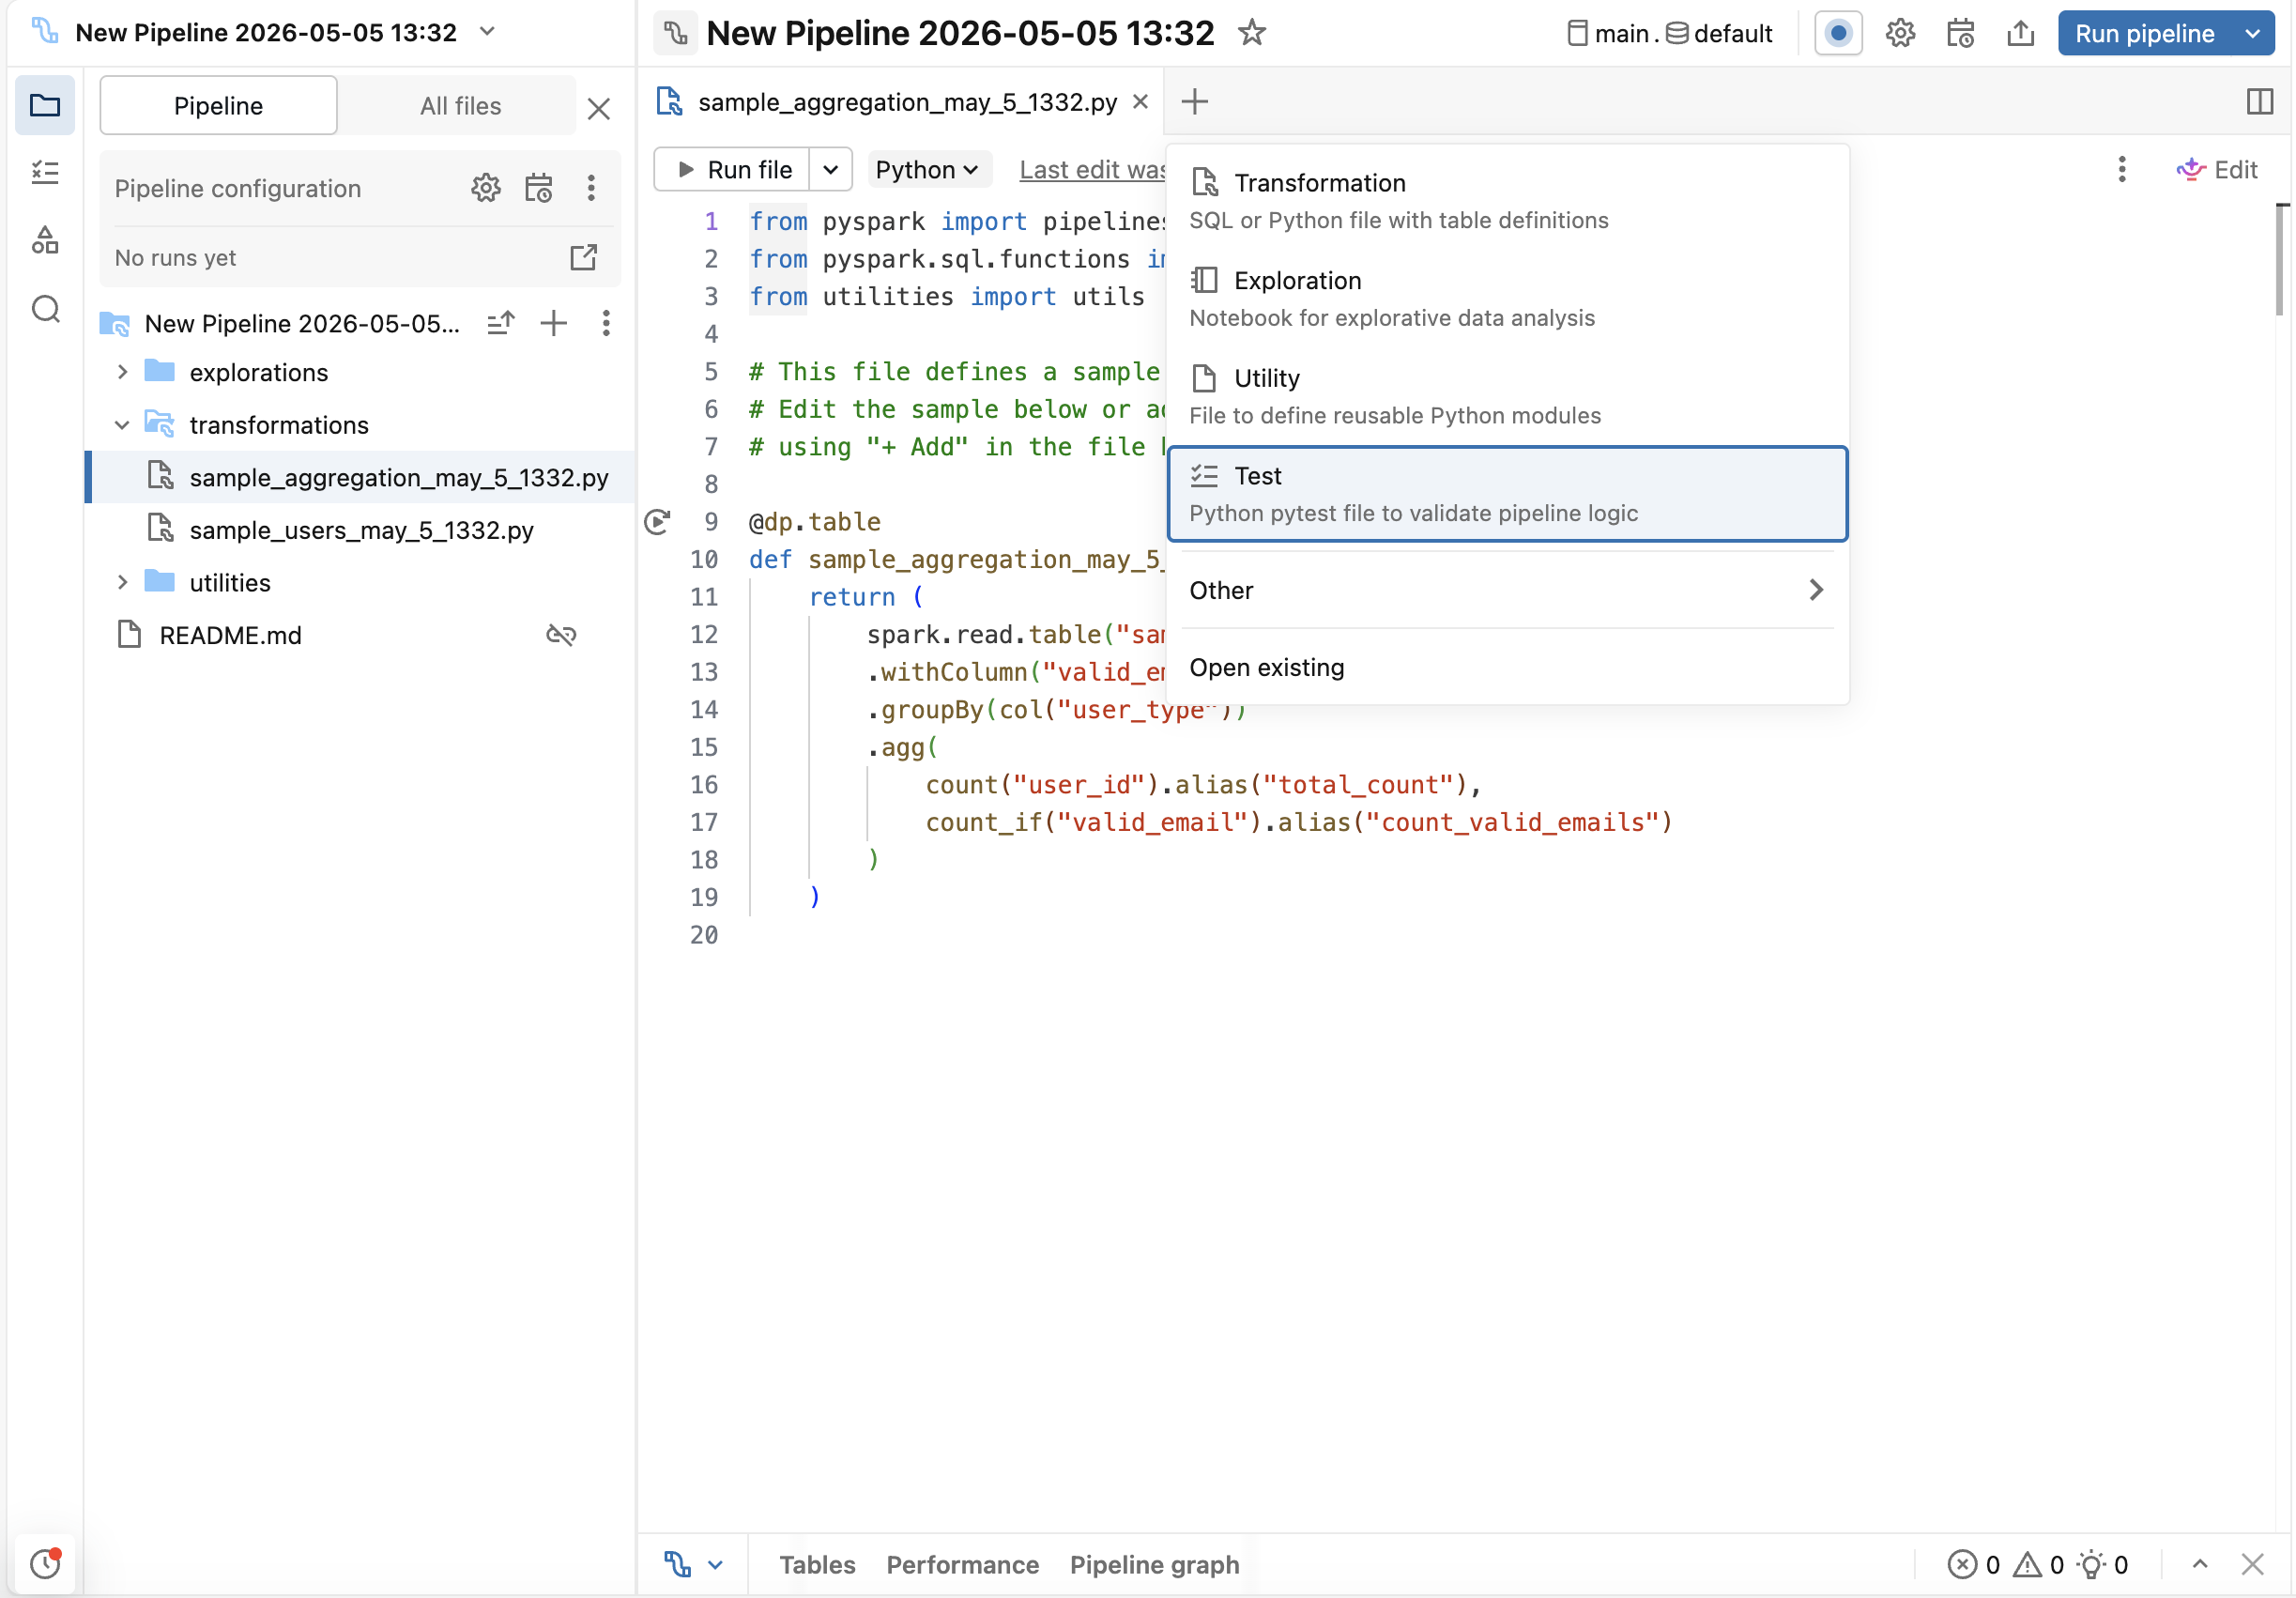
Lakeflow Pipelines Düzenleyicisi'nde (ekle) düğmesine tıklayın + ve Test'i seçin. Bu, işlem hattı kaynak kodunuza dahil olmayan bir test dosyası (ve zaten mevcut değilse tests klasörünü) oluşturur. Klasörü kendiniz oluşturmanız tests gerekmez.
3. Adım: Test oluşturma
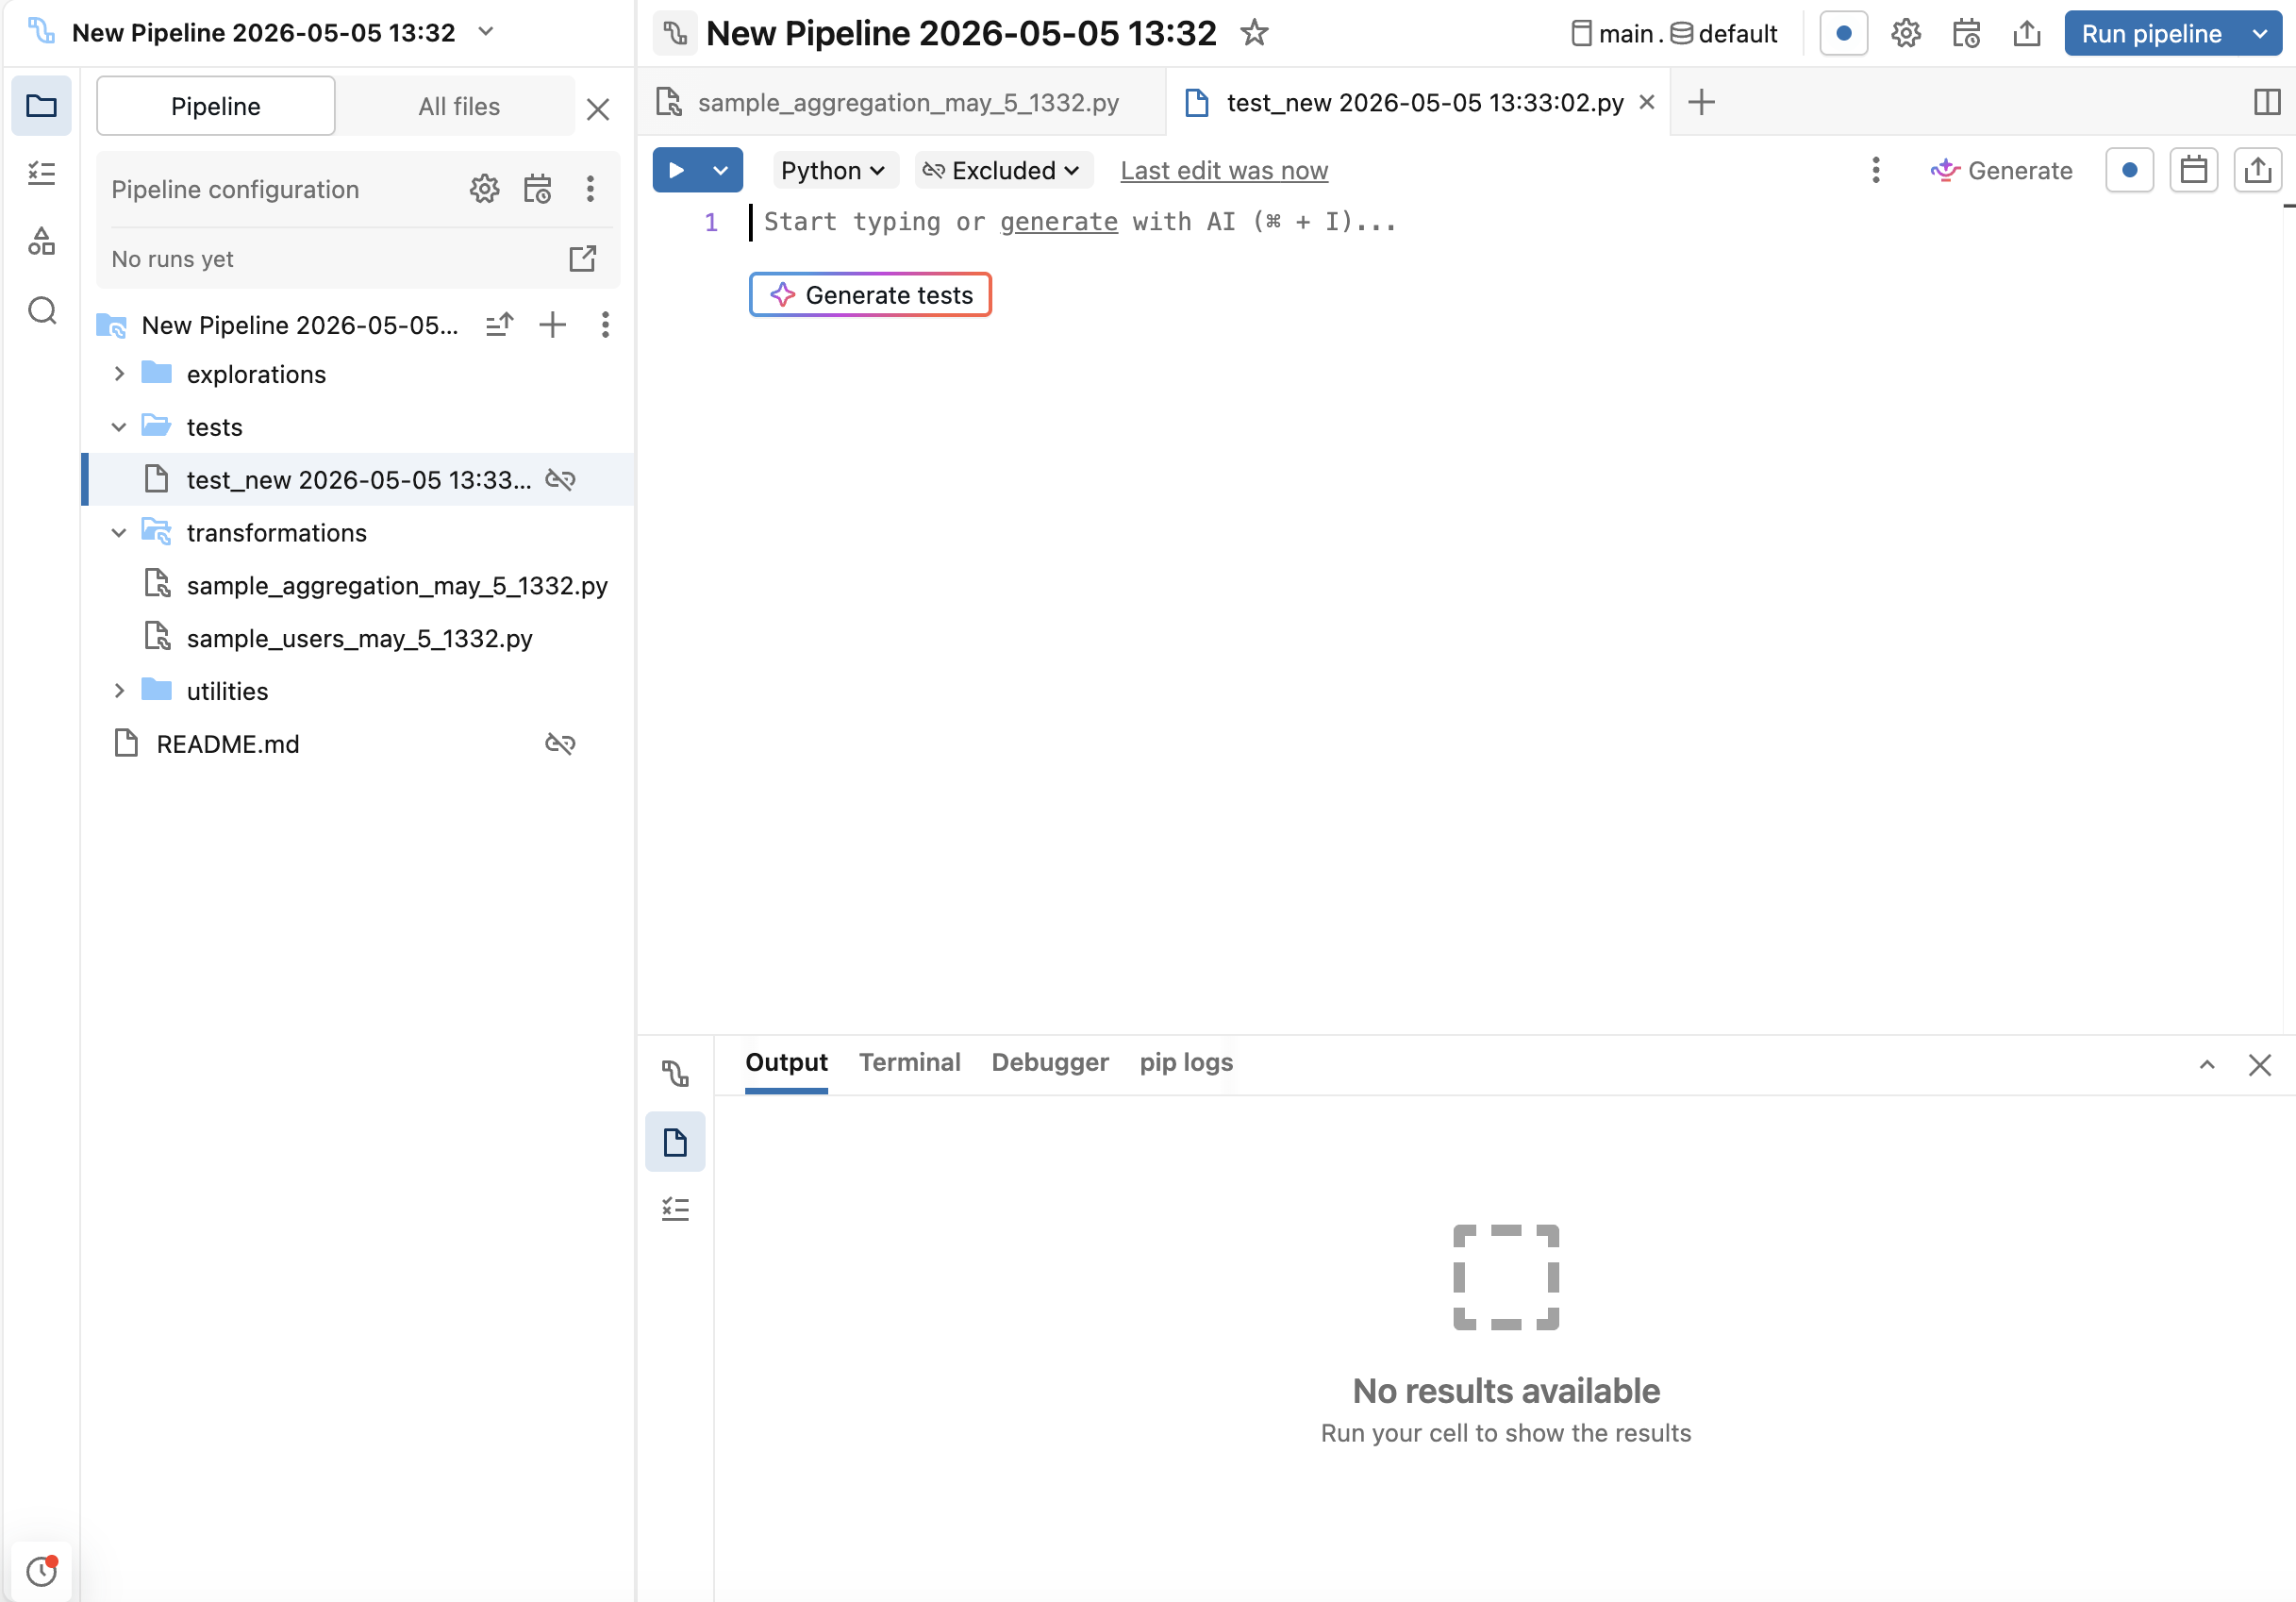
Genie Code, test iskelesi oluşturabilir:
Test dosyasının içinde Test oluştur düğmesine tıklayın.
Alternatif olarak Genie Code aracı modunun içinde kullanın
/tests.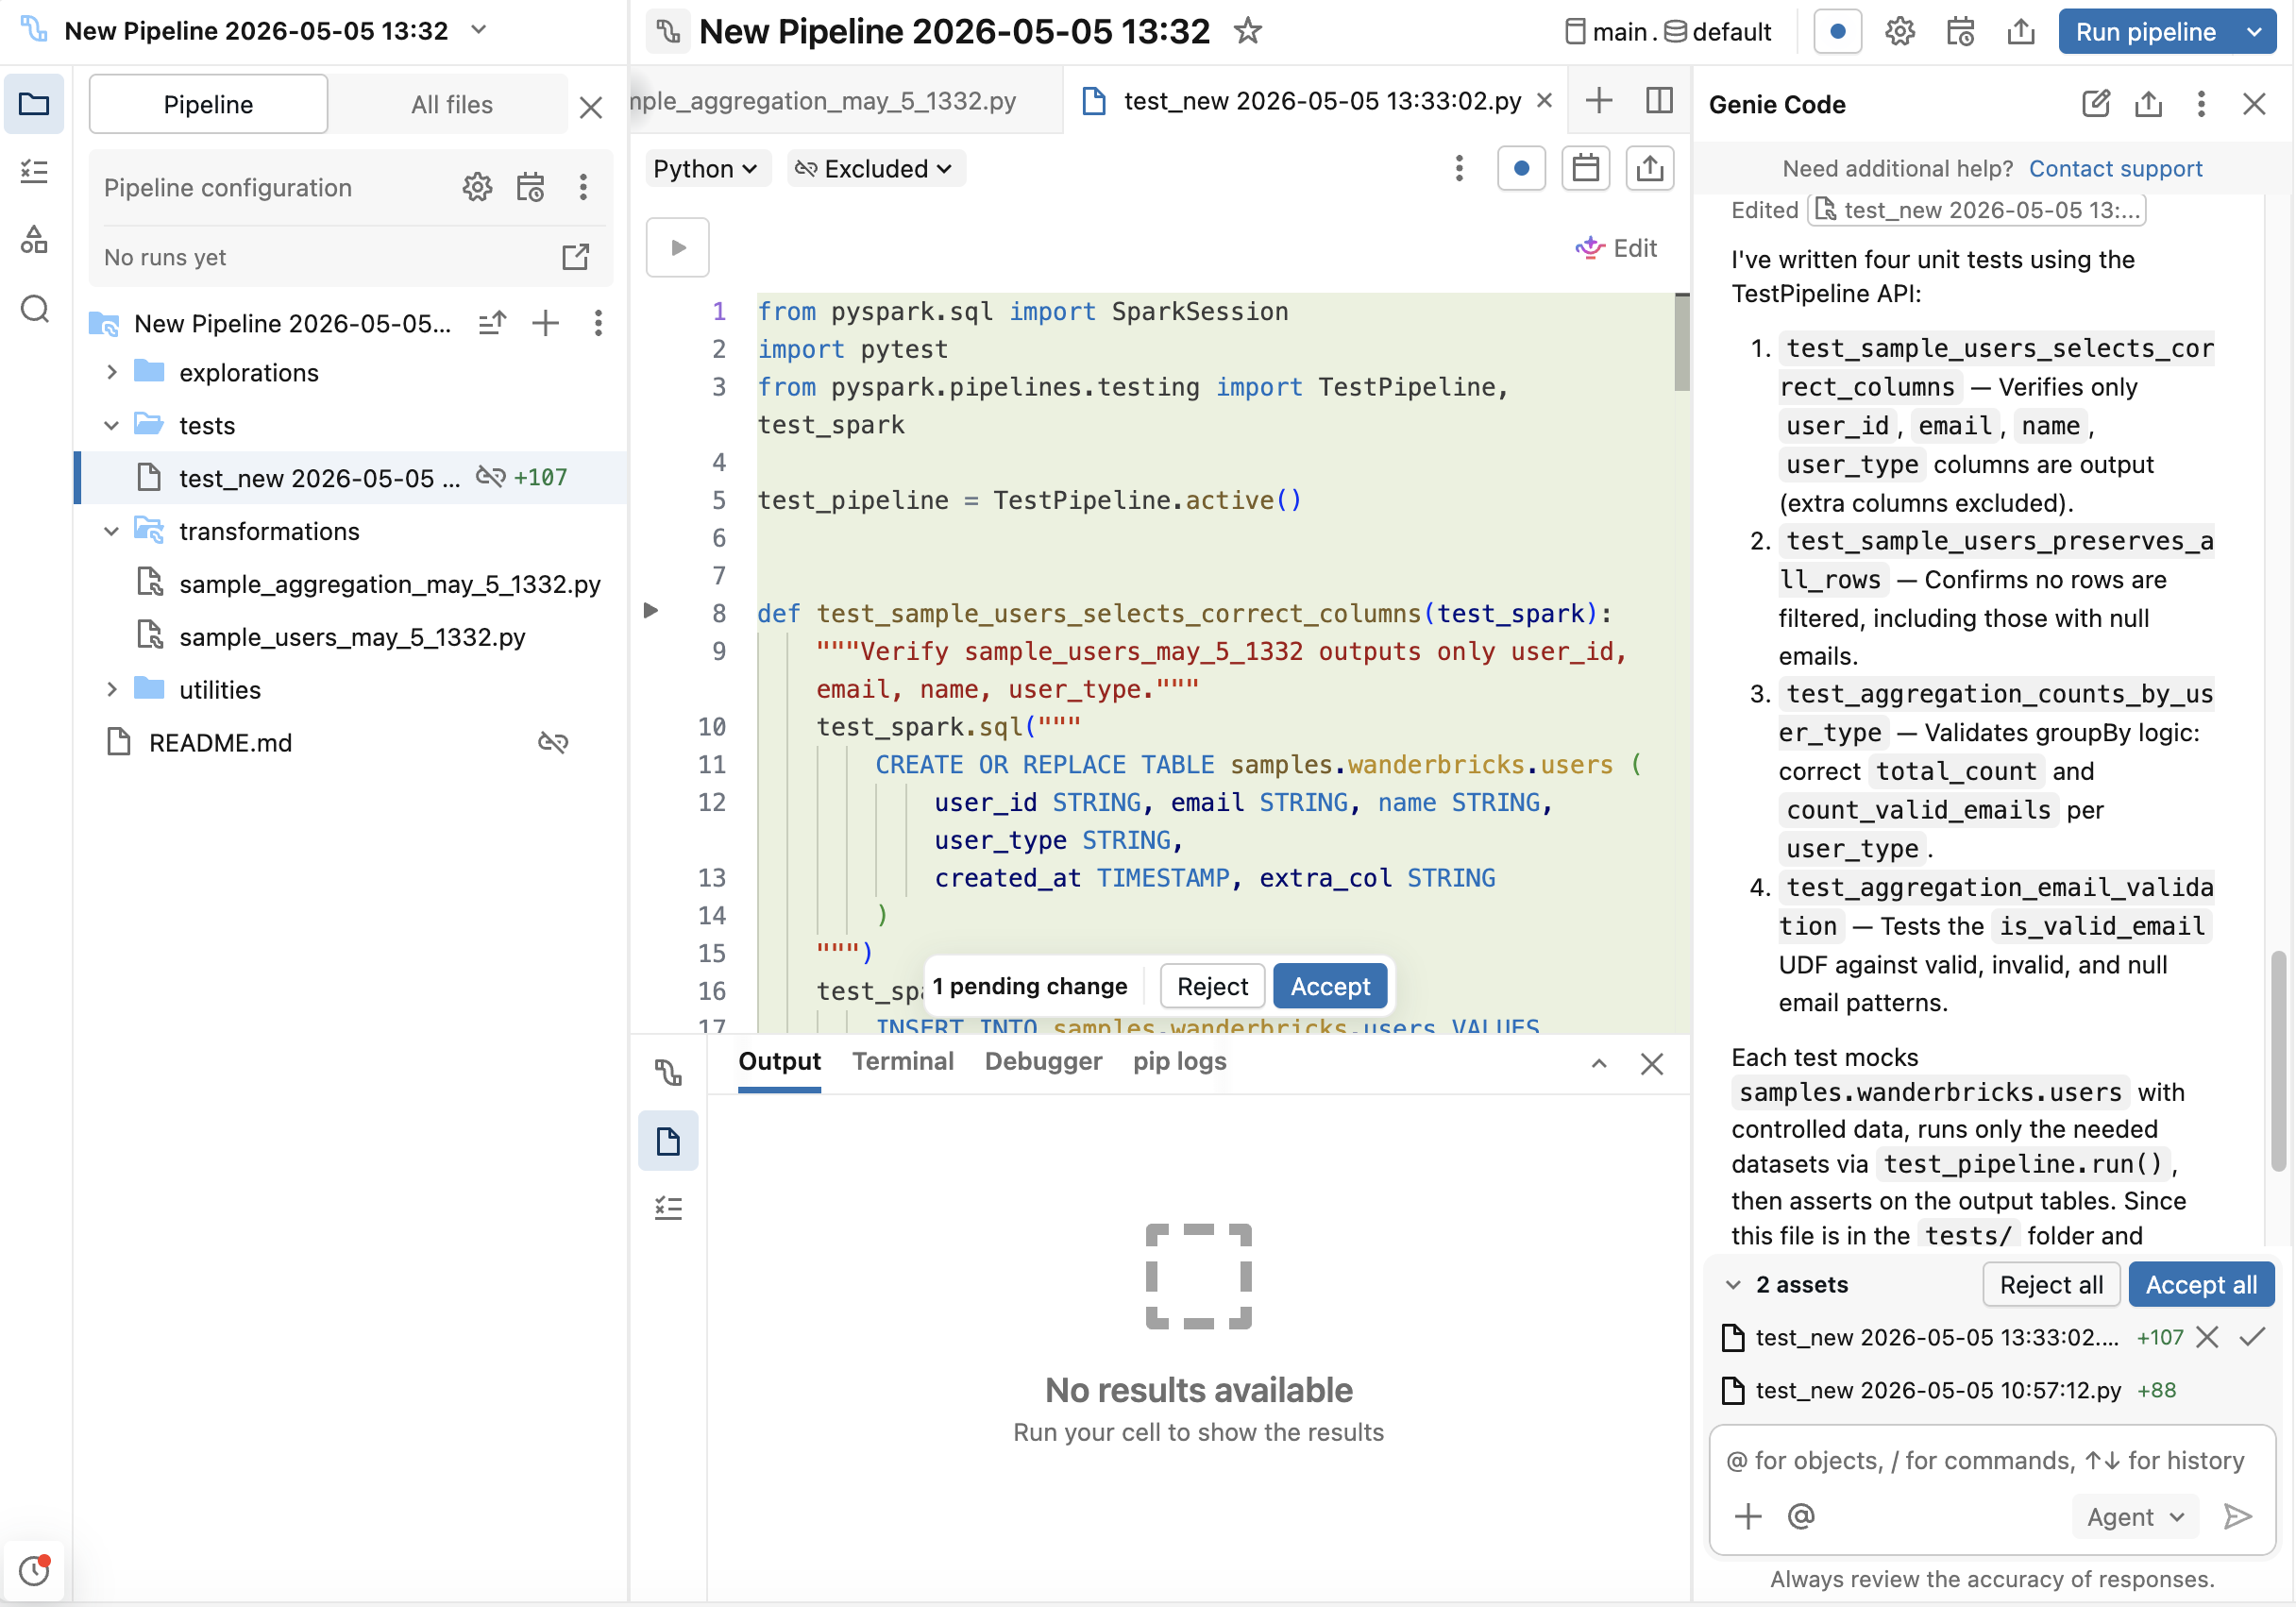
Genie Code'u kullanarak kalıp kod oluşturun, ardından istisnai durumlarınız için özelleştirin.
Alternatif olarak, test kodunu kendiniz yazabilirsiniz. Aşağıdaki import ifadelerini her test dosyasının en üstüne ekleyin:
import pytest
from pyspark.pipelines.testing import TestPipeline, test_spark

test_pipeline = TestPipeline.active()
4. Adım: Testleri çalıştırma
Testleri Lakeflow Pipelines Düzenleyicisi'nden çalıştırın:
- Tek bir testi çalıştırmak için, bir test işlevinin yanındaki olukta bulunan
 (oynat düğmesi) tıklayın.
- Bu dosyadaki tüm testleri çalıştırmak için test dosyasının üst kısmındaki Dosyada testleri çalıştır'a tıklayın.
Test sonuçları (başarı veya başarısızlık) Düzenleyici alt panelinde görünür. Başarısızlıkların nedenini ayıklamak için doğrulama hatalarını gözden geçirin.
API'leri test etme
| API | Description |
|---|---|
TestPipeline.active() |
Lakeflow Pipelines Düzenleyicisi'nde şu anda düzenlenen işlem hattını temsil eden bir TestPipeline nesnesi döndürür. Bu nesne, kaynak kodu, yapılandırmaları, varsayılan katalog/şema vb. dahil olmak üzere işlem hattına yönelik bir başvurudur. |
test_pipeline.run(test_spark, set([table_names])) |
Tablo adları belirtilirse seçmeli yenileme gerçekleştirerek işlem hattının güncelleştirmesini zaman uyumlu olarak yürütür. İşlem hattının yürütülmesi başarıyla tamamlandıktan veya bir özel durumla sonlandıktan sonra döndürür. Çalıştırmayı açıklayan bir TestUpdateStatus döndürür. |
status.is_success |
True Güncelleme başarıyla tamamlanırsa. Bir güncelleme başarısız olduğunda, status.error_message ve status.error_class başarısızlığı açıklar. |
status.event_log |
Bu çalıştırmaya ait etkinlik günlüğü, bu çalıştırmanın güncellemesine göre filtrelenmiş bir DataFrame olarak. Bunu, güncellemenin yayınladığı akış ilerlemesi veya veri kalitesi beklentileri gibi olayları doğrulamak için kullanın. Etkinlik günlüğü tablosu yoksa None olabilir.
details sütunu, event_log tablo değerli işleviyle eşleşen ham bir JSON dizesidir; bu nedenle iç içe alanlarda doğrulama yapmadan önce bunu ayrıştırın. |
test_pipeline.event_log |
Mevcut testteki her çalıştırmanın olay günlüğü, bir DataFrame olarak. Çalıştırmalar, testteki her run() çağrısı arasında birikir; bu nedenle bunu birden fazla çalıştırma boyunca doğrulama yapmak için, status.event_log ise tek bir çalıştırmayı doğrulamak için kullanın. Olay günlüğü tablosu yoksa None olabilir. |
status.flow_info |
Çalıştırmanın yürüttüğü görünüm olmayan her akış için bir FlowInfo girişi içeren, akış adına göre anahtarlanmış bir sözlük. Her biri FlowInfo bu akışın ne yaptığını raporlar: records_written (toplam çıkış satırları), duration (duvar saati çalışma süresi) ve recompute_type ("incremental" veya "full_recompute"). Bir alan, söz konusu akış için belirlenemediğinde None olur. Bunu, olay günlüğünü kendiniz ayrıştırmanıza gerek kalmadan bir akışın sonucunu doğrulamak için kullanın. |
test_spark fikstür |
Adıyla başvurulan bir tabloya by name (örneğin, spark.read.table("catalog.schema.table") veya df.write.saveAsTable("catalog.schema.table")) başvuran tablo okuma ve yazma işlemlerini otomatik olarak geçici bir test şemasına yeniden yönlendiren katalog-tablo yeniden yönlendirmesi içeren bir test SparkSession oluşturur. Yeniden yönlendirme yalnızca ad tabanlı tablo işlemleri için geçerlidir; gerçek sistem üzerinde doğrudan işlem yapan, yola göre adreslenen veya bir bağlayıcı üzerinden gerçekleştirilen okuma ya da yazmaları kapsamaz. Bkz. Sınırlamalar. |
Sahte veri oluşturma
SQL veya createDataFramekullanarak giriş verileriyle dalga geçebilirsiniz:
# Option 1: Using SQL
test_spark.sql("""
    CREATE TABLE catalog.schema.table_name AS
    SELECT * FROM VALUES
        (1, 'value1'),
        (2, 'value2')
    AS t(id, name)
""")

# Option 2: Using createDataFrame
df = test_spark.createDataFrame(
    [(1, 'value1'), (2, 'value2')],
    schema=["id", "name"]
)
df.write.saveAsTable("catalog.schema.table_name")
Daha büyük hacimlerde gerçekçi yapay veri oluşturmak için Faker kitaplığını kullanabilirsiniz. önce işlem hattınızda çalıştırın %pip install faker , ardından Faker destekli UDF'lerden bir DataFrame oluşturun:
# Option 3: Using Faker for synthetic data
from pyspark.sql import functions as F
from faker import Faker

fake = Faker()
fake_firstname = F.udf(fake.first_name)
fake_lastname = F.udf(fake.last_name)
fake_email = F.udf(fake.ascii_company_email)

df = (
    test_spark.range(0, 100)
    .withColumn("firstname", fake_firstname())
    .withColumn("lastname", fake_lastname())
    .withColumn("email", fake_email())
)
df.write.saveAsTable("catalog.schema.table_name")
İşlem hattını veya belirli tabloları çalıştırma
# Run specific tables
test_pipeline.run(test_spark, set(["catalog.schema.table1", "catalog.schema.table2"]))

# Run all tables in the pipeline
test_pipeline.run(test_spark)
Examples
Örnek 1: Toplamaları satır sayısı, şema ve null işleme ile test etme
Hedef: Kullanıcı gruplamasının, kullanıcıları türe göre doğru şekilde saydığını, boş (null) e-posta değerlerini işlediğini ve beklenen şemayı ürettiğini doğrulamak.
İşlem hattı dönüştürmeleri:
Bu dönüşümler basit bir iki tablolu işlem hattı oluşturur: users kullanıcı verilerini seçer ve counts kullanıcıları türe göre gruplandırır ve toplam kullanıcıları ve geçerli e-postaları sayar.
from pyspark import pipelines as dp
from pyspark.sql.functions import col, count, count_if

@dp.table
def users():
    return (
        spark.read.table("catalog.schema.wanderbricks_users")
        .select("user_id", "email", "name", "user_type")
    )

@dp.table
def counts():
    return (
        spark.read.table("catalog.schema.users")
        .withColumn("valid_email", col("email").isNotNull())
        .groupBy("user_type")
        .agg(
            count("user_id").alias("total_count"),
            count_if("valid_email").alias("count_valid_emails")
        )
    )
Testler:
Bu testler, kasıtlı null değerler içeren sahte kullanıcı verileri oluşturarak ve işlem hattını izole bir ortamda çalıştırarak satır sayılarını, şema yapısını, null değerlerin işlenmesini ve agregasyon mantığını doğrular.
import pytest
from pyspark.pipelines.testing import TestPipeline, test_spark
from pyspark.testing import assertDataFrameEqual

test_pipeline = TestPipeline.active()

# Mock data fixture
def mock_users(session):
    session.sql("""
        CREATE TABLE catalog.schema.wanderbricks_users AS
        SELECT * FROM VALUES
            (1, 'alice@example.com', 'Alice', 'admin'),
            (2, NULL, 'Bob', 'user'),
            (3, 'charlie@example.com', 'Charlie', 'user'),
            (4, NULL, 'Dana', 'admin')
        AS t(user_id, email, name, user_type)
    """)

# Test 1: Row count
def test_users_row_count(test_spark):
    mock_users(test_spark)
    status = test_pipeline.run(test_spark, set(["catalog.schema.users"]))
    assert status.is_success
    result = test_spark.table("catalog.schema.users")
    assert result.count() == 4

# Test 2: Schema validation
def test_users_schema(test_spark):
    mock_users(test_spark)
    status = test_pipeline.run(test_spark, set(["catalog.schema.users"]))
    assert status.is_success
    result = test_spark.table("catalog.schema.users")
    expected_fields = {"user_id", "email", "name", "user_type"}
    actual_fields = set(f.name for f in result.schema.fields)
    assert expected_fields == actual_fields

# Test 3: Null handling
def test_users_null_handling(test_spark):
    mock_users(test_spark)
    status = test_pipeline.run(test_spark, set(["catalog.schema.users"]))
    assert status.is_success
    result = test_spark.table("catalog.schema.users")
    null_emails = result.filter("email IS NULL").count()
    assert null_emails == 2

# Test 4: Aggregation
def test_counts(test_spark):
    mock_users(test_spark)
    # Run both tables since counts depends on users
    status = test_pipeline.run(test_spark, set(["catalog.schema.users", "catalog.schema.counts"]))
    assert status.is_success
    result = test_spark.table("catalog.schema.counts")
    # Check counts for each user_type
    admin_row = result.filter("user_type = 'admin'").collect()[0]
    user_row = result.filter("user_type = 'user'").collect()[0]
    assert admin_row["total_count"] == 2
    assert admin_row["count_valid_emails"] == 1
    assert user_row["total_count"] == 2
    assert user_row["count_valid_emails"] == 1

# Test 5: Full DataFrame comparison with assertDataFrameEqual
def test_counts_full_dataframe(test_spark):
    mock_users(test_spark)
    status = test_pipeline.run(test_spark, set(["catalog.schema.users", "catalog.schema.counts"]))
    assert status.is_success
    result = test_spark.table("catalog.schema.counts")
    expected = test_spark.createDataFrame(
        [("admin", 2, 1), ("user", 2, 1)],
        schema=["user_type", "total_count", "count_valid_emails"]
    )
    assertDataFrameEqual(result, expected)
Örnek 2: Otomatik CDC'yi Test Etme
Hedef: Otomatik CDC'nin eklemeler ve güncelleştirmelerle değişiklik akışını doğru işlediğini doğrulayın.
İşlem hattı dönüşümü:
Bu dönüştürme, bir değişiklik akışından gelen akış halindeki değişiklikleri okuyup bunları hedef tabloya SCD Tür 1 olarak uygular (yalnızca en son sürümü tutar) ve Auto CDC'yi yapılandırır.
from pyspark import pipelines as dp
from pyspark.sql.functions import col

@dp.view
def users():
    return spark.readStream.table("catalog.schema.change_feed")

dp.create_streaming_table("target_autocdc")
dp.create_auto_cdc_flow(
    target="target_autocdc",
    source="users",
    keys=["userId"],
    sequence_by=col("ts"),
    stored_as_scd_type=1
)
Testler:
İlk test, aynı userId kayıt için birden çok kayıt içeren bir sahte değişiklik akışı oluşturur (bir güncelleştirme benzetimi) ve hedefte yalnızca en son kaydın korunduğunu doğrular. İkinci test işlem hattını çalıştırarak, değişiklik akışına daha fazla olay ekleyerek ve işlem hattını yeniden çalıştırarak geç gelen ve sıra dışı olayların benzetimini gerçekleştirir.
import pytest
from pyspark.pipelines.testing import TestPipeline, test_spark

test_pipeline = TestPipeline.active()

# Test 1: Standard inserts and updates
def test_auto_cdc_flow(test_spark):
    # Create a mock change feed table
    test_spark.sql("""
        CREATE TABLE catalog.schema.change_feed AS
        SELECT * FROM VALUES
            (1, 'Alice', 1000),
            (2, 'Bob', 1001),
            (1, 'Alice Updated', 1002)
        AS t(userId, name, ts)
    """)
    # Run the pipeline
    status = test_pipeline.run(test_spark, set(["catalog.schema.target_autocdc"]))
    assert status.is_success
    # Read the output
    result = test_spark.table("catalog.schema.target_autocdc")
    # Verify two users exist
    user_ids = set(row["userId"] for row in result.collect())
    assert user_ids == {1, 2}
    # Verify latest record for userId=1 has ts=1002
    latest_user1 = result.filter("userId = 1").collect()[0]
    assert latest_user1["ts"] == 1002
    assert latest_user1["name"] == "Alice Updated"
    # Verify userId=2 has ts=1001
    user2 = result.filter("userId = 2").collect()[0]
    assert user2["ts"] == 1001

# Test 2: Late-arriving and out-of-order events
def test_auto_cdc_late_arriving(test_spark):
    # First batch of change events
    test_spark.sql("""
        CREATE TABLE catalog.schema.change_feed AS
        SELECT * FROM VALUES
            (1, 'Alice', 1000),
            (2, 'Bob', 1001)
        AS t(userId, name, ts)
    """)
    # Run the pipeline with the initial batch
    status = test_pipeline.run(test_spark, set(["catalog.schema.target_autocdc"]))
    assert status.is_success

    # Append late-arriving events to the change feed:
    # - A newer event for userId=1 (ts=1003) that arrived after the first run
    # - A stale event for userId=2 (ts=999) with a timestamp older than what is already applied
    test_spark.sql("""
        INSERT INTO catalog.schema.change_feed VALUES
            (1, 'Alice Updated', 1003),
            (2, 'Bob (stale)', 999)
    """)
    # Re-run the pipeline. sequence_by=ts ensures stale events do not overwrite newer state.
    status = test_pipeline.run(test_spark, set(["catalog.schema.target_autocdc"]))
    assert status.is_success

    result = test_spark.table("catalog.schema.target_autocdc")
    # userId=1 should reflect the newer late-arriving event
    alice = result.filter("userId = 1").collect()[0]
    assert alice["ts"] == 1003
    assert alice["name"] == "Alice Updated"
    # userId=2 should be unchanged: the stale event with an older ts is ignored
    bob = result.filter("userId = 2").collect()[0]
    assert bob["ts"] == 1001
    assert bob["name"] == "Bob"
Örnek 3: Otomatik CDC'yi anlık görüntüden test etme
Hedef: CDC'nin eklemeler, güncelleştirmeler ve silmeler dahil anlık görüntü değişikliklerini doğru işlediğini doğrulayın.
İşlem hattı dönüşümü:
Bu dönüştürme, anlık görüntüden Auto CDC’yi yapılandırır; anlık görüntü tablosundan okur ve zaman içindeki değişiklikleri SCD Type 2 olarak izler (tam geçmişi korur).
from pyspark import pipelines as dp

@dp.view(name="source")
def source():
    return spark.read.table("catalog.schema.snapshot")

dp.create_streaming_table("catalog.schema.target")
dp.create_auto_cdc_from_snapshot_flow(
    target="target",
    source="source",
    keys=["userId"],
    stored_as_scd_type=2
)
Test:
Bu test bir ilk anlık görüntü oluşturur, işlem hattını çalıştırır, ardından CDC'nin tüm değişiklikleri yakaladığını doğrulamak için yeni verileri keserek ve ekleyerek anlık görüntü güncelleştirmesinin benzetimini oluşturur.
import pytest
from pyspark.pipelines.testing import TestPipeline, test_spark

test_pipeline = TestPipeline.active()

def test_auto_cdc_from_snapshot_flow(test_spark):
    # Create initial snapshot
    test_spark.sql("""
        CREATE TABLE catalog.schema.snapshot AS
        SELECT * FROM VALUES
            (1, 'Alice', '2024-01-01'),
            (2, 'Bob', '2024-01-02')
        AS t(userId, name, created_at)
    """)
    # Run the pipeline
    status = test_pipeline.run(test_spark, set(["catalog.schema.target"]))
    assert status.is_success
    # Simulate a new snapshot by truncating and inserting updated data
    test_spark.sql("TRUNCATE TABLE catalog.schema.snapshot")
    test_spark.sql("INSERT INTO catalog.schema.snapshot VALUES (2, 'Bob', '2024-01-03')")
    status = test_pipeline.run(test_spark, set(["catalog.schema.target"]))
    assert status.is_success
    # Verify SCD Type 2: should have 3 rows (original Alice, original Bob, updated Bob)
    result = test_spark.table("catalog.schema.target")
    assert result.count() == 3
    user_ids = [row["userId"] for row in result.collect()]
    assert set(user_ids) == {1, 2}
Örnek 4: Join işlemlerini ve beklentileri test etme
Hedef: Birleştirmelerin düzgün çalıştığını ve beklentilerin geçersiz verileri filtrelediğini doğrulayın.
İşlem hattı dönüşümü:
Bu dönüşüm, mülk görsellerini olanaklarla birleştirir ve Ocak 2024'ten önce yüklenen görselleri filtrelemek için bir koşul uygular.
from pyspark import pipelines as dp

@dp.table
@dp.expect_or_drop("uploaded after Jan 2024", "uploaded_at > '2024-01-01'")
def property_images_amenities_join():
    return (
        spark.read.table("catalog.schema.property_images")
        .join(
            spark.read.table("catalog.schema.property_amenities"),
            on="property_id",
            how="inner"
        )
    )
Testler:
Bu testler, birleştirmenin doğru sayıda satır ürettiğini ve beklentinin geçersiz yükleme tarihleri içeren kayıtları başarıyla filtrelediğini doğrular.
import pytest
from pyspark.pipelines.testing import TestPipeline, test_spark

test_pipeline = TestPipeline.active()

# Mock property datasets
def mock_properties(session):
    session.sql("""
        CREATE TABLE catalog.schema.property_images AS
        SELECT * FROM VALUES
            (101, 'img1.jpg', '2024-02-01'),
            (102, 'img2.jpg', '2024-01-15'),
            (103, 'img3.jpg', '2024-12-20')
        AS t(property_id, image_url, uploaded_at)
    """)
    session.sql("""
        CREATE TABLE catalog.schema.property_amenities AS
        SELECT * FROM VALUES
            (101, 'wifi'),
            (102, 'pool'),
            (103, 'parking')
        AS t(property_id, amenity)
    """)

# Test 1: Join
def test_property_join(test_spark):
    mock_properties(test_spark)
    status = test_pipeline.run(test_spark, set(["catalog.schema.property_images_amenities_join"]))
    assert status.is_success
    result = test_spark.table("catalog.schema.property_images_amenities_join")
    # Should have 3 rows after join
    assert result.count() == 3
    # Check all property_ids are present
    property_ids = set(row["property_id"] for row in result.collect())
    assert property_ids == {101, 102, 103}

# Test 2: Expectation
def test_property_expectation(test_spark):
    mock_properties(test_spark)
    # Add a row with uploaded_at before Jan 2024
    test_spark.sql("""
        INSERT INTO catalog.schema.property_images VALUES (104, 'img4.jpg', '2023-12-31')
    """)
    # Add a matching row in the amenities table for the join
    test_spark.sql("""
        INSERT INTO catalog.schema.property_amenities VALUES (104, 'gym')
    """)
    status = test_pipeline.run(test_spark, set(["catalog.schema.property_images_amenities_join"]))
    assert status.is_success
    result = test_spark.table("catalog.schema.property_images_amenities_join")
    # Only property_ids with uploaded_at > '2024-01-01' should be present
    valid_ids = set(row["property_id"] for row in result.collect())
    assert 104 not in valid_ids
    assert valid_ids == {101, 102, 103}
Örnek 5: flow_info ile bir akış üzerinde doğrulama yapma
Amaç: Bir akışın kaç satır yazdığını, çıkış tablosu yerine akış başına yapılan sonuçları kullanarak doğrulamak.
status.flow_info her akışın çalışma sırasında ne yaptığını rapor eder ve akış adıyla anahtarlanır. Her girdi records_written, , durationve recompute_type, gösterir, böylece bir akışın sonucunu olay günlüğünü ayrıştırmadan belirtebilirsiniz. Alt seviyeli olaylar üzerinde doğrulama yapmak için ham status.event_log DataFrame'i doğrudan okuyun.
Bkz. Test API'leri.
Bu örnek, Ocak 2024'ten önce yüklenmiş görüntüleri filtreleyen Örnek 4'teki@dp.expect_or_drop boru hattı ve mock_properties fikstürü yeniden kullanıyor.
Test:
records_written akışın yazdığı sıraları sayar, bu yüzden rekor düşme beklentisini yansıtır.
import pytest
from pyspark.pipelines.testing import TestPipeline, test_spark

test_pipeline = TestPipeline.active()

def test_flow_wrote_expected_row_count(test_spark):
    mock_properties(test_spark)
    # A fourth image uploaded before Jan 2024, which the expectation drops, plus a
    # matching amenities row so it survives the join and reaches the expectation.
    test_spark.sql("""
        INSERT INTO catalog.schema.property_images VALUES (104, 'img4.jpg', '2023-12-31')
    """)
    test_spark.sql("""
        INSERT INTO catalog.schema.property_amenities VALUES (104, 'gym')
    """)
    status = test_pipeline.run(test_spark, set(["catalog.schema.property_images_amenities_join"]))
    assert status.is_success
    # Four images are joined, but the expectation drops the one uploaded before Jan 2024,
    # so the flow reports three rows written.
    assert status.flow_info["property_images_amenities_join"].records_written == 3