Not
Bu sayfaya erişim yetkilendirme gerektiriyor. Oturum açmayı veya dizinleri değiştirmeyi deneyebilirsiniz.
Bu sayfaya erişim yetkilendirme gerektiriyor. Dizinleri değiştirmeyi deneyebilirsiniz.
Erişim denetimi
Özellikler yönetilebilir Unity Kataloğu nesneleridir. Bir özelliğe erişim, , CREATE FEATUREve READ FEATURE Unity Kataloğu ayrıcalıkları tarafından MANAGEdenetlenmektedir. Tam açıklamalar için bkz. Unity Kataloğu ayrıcalık başvurusu.
-
CREATE FEATURE: Bir şemada bir özellik oluşturmak için gereklidir.create_featureveregister_featureebeveyn şemasında zorunlu kalırCREATE FEATURE. En az ayrıcalık ilkesine uyarak şema düzeyinde verinCREATE FEATURE; ayrıca bu kataloğa bir katalogdaki herhangi bir şemada özellik oluşturmaya izin vermek için bunu bir katalogda da vekleyebilirsiniz. -
READ FEATURE: Özellik meta verilerini okumak için gereklidir.get_feature,create_training_set, velist_materialized_featuresözelliği gerektiriyorREAD FEATURE. Bu ayrıcalık, kaynak veya maddeleştirilmiş çıktı tablolarındaki özellik verilerine erişim sağlamaz. Eğitim veya hizmet için bu verileri okumak için, ilgili tablolarda da bulunmalısınızSELECT.READ FEATUREBir şema veya katalogda verilen bu bilgiler, içerdiği tüm mevcut ve gelecekteki özellikler için geçerlidir. -
MANAGE: Bir özelliğin yaşam döngüsünü ve hibelerini yönetmek için gereklidir. Bir özelliği silmekdelete_featureve ,materialize_featuresile bir özelliği maddeleştirmek için bu özellik gereklidirMANAGE. Maddeleşmiş bir özelliğin sililmesidelete_materialized_featureşu ileMANAGEyönetilmez : yalnızca maddeleştirilmiş özelliğin yaratıcısı onu silebilir.
Tüm özellik işlemleri üst katalogda ve USE CATALOG üst şemada da gereklidirUSE SCHEMA. Gerçekleştirmenin nasıl MANAGE ve READ FEATURE uygulanacağı için bkz. İzinler.
Özellik Görünümü API'si
Feature konstruktör ve register_feature()
Önerilen yaklaşım, yerel olarak bir Feature nesne oluşturmak ve bunu Unity Kataloğu'na kalıcı hale getirmek için kullanmaktır register_feature . Bu iki adımlı iş akışı, kaydetmeden önce özellikleri (dahil create_training_set) denemenize olanak tanır.
Feature(
    source: DataSource,                                    # Required: DeltaTableSource, StreamSource, RequestSource, or FeatureViewSource
    function: Union[AggregationFunction, ColumnSelection, CustomUDF], # Required for all features
    entity: Optional[List[str]] = None,                    # Required for DeltaTableSource and StreamSource
    timeseries_column: Optional[str] = None,               # Required for DeltaTableSource and StreamSource
    name: Optional[str] = None,                            # Optional: Feature name (auto-generated if omitted)
    description: Optional[str] = None,                     # Optional: Feature description
)
FeatureEngineeringClient.register_feature() Unity Kataloğunda yerel olarak oluşturulmuş Feature bir belgeyi kaydeder.
FeatureEngineeringClient.register_feature(
    feature: Feature,       # Required: A Feature instance (not already registered)
    catalog_name: str,      # Required: UC catalog name
    schema_name: str,       # Required: UC schema name
) -> Feature
from databricks.feature_engineering.entities import Feature, DeltaTableSource, AggregationFunction, Sum, RollingWindow
from datetime import timedelta

# Step 1: Construct the feature locally
feature = Feature(
    source=DeltaTableSource(catalog_name="main", schema_name="store", table_name="transactions"),
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)

# Step 2: Register in Unity Catalog
fe = FeatureEngineeringClient()
registered_feature = fe.register_feature(
    feature=feature,
    catalog_name="main",
    schema_name="store",
)
create_feature()
FeatureEngineeringClient.create_feature() Unity Kataloğu'nda bir özelliği tek adımda doğrular, oluşturur ve hemen kaydeder. İlk olarak özelliği yerel olarak denemeniz gerekmeyen durumlarda bunu kullanın.
FeatureEngineeringClient.create_feature(
    source: DataSource,                                    # Required: DeltaTableSource, StreamSource, RequestSource, or FeatureViewSource
    function: Union[AggregationFunction, ColumnSelection, CustomUDF], # Required for all features
    catalog_name: str,                                     # Required: The catalog name for the feature
    schema_name: str,                                      # Required: The schema name for the feature
    entity: Optional[List[str]] = None,                    # Required for DeltaTableSource and StreamSource
    timeseries_column: Optional[str] = None,               # Required for DeltaTableSource and StreamSource
    name: Optional[str] = None,                            # Optional: Feature name (auto-generated if omitted)
    description: Optional[str] = None,                     # Optional: Feature description
) -> Feature
Parametreler:
-
source: Özellik hesaplamada kullanılan veri kaynağı (DeltaTableSource,StreamSource,RequestSource, veyaFeatureViewSource). -
function: AnAggregationFunctionbir operatör ve zaman penceresini paketleyerek,ColumnSelection("column_name")geçiş özellikleri veyaCustomUDFsatır dönüşümleri için kullanır. Uyumlu kaynak türleri için Desteklenen fonksiyonlar sayfasına bakınız. -
catalog_name: Özellik için Unity Kataloğu kataloğunun adı. -
schema_name: Özellik için Unity Kataloğu şema adı. -
entity: Toplama veya arama anahtarlarını (birincil anahtarları) tanımlayan sütun adlarının listesi.DeltaTableSourceveStreamSourceiçin gereklidir. Örneğin,["user_id"]kullanıcı başına toplar veya arar. ve içinRequestSourceFeatureViewSourceatlayın. -
timeseries_column: Zaman penceresi toplama veya en son değer seçimi için kullanılan zaman damgası sütunu.DeltaTableSourceveStreamSourceiçin gereklidir. ve içinRequestSourceFeatureViewSourceatlayın. -
name: İsteğe bağlı özellik adı. Atlanırsa, giriş sütunu, işlevi ve penceresinden (örneğin,amount_avg_rolling_7d) otomatik olarak oluşturulur. -
description: Özelliğin isteğe bağlı açıklaması.
Dönüşler: Doğrulanmış bir Özellik örneği
Artırır: Herhangi bir doğrulama başarısız olursa ValueError
delete_feature()
Unity Kataloğu'ndan bir özelliği tam adıyla siler.
FeatureEngineeringClient.delete_feature(
    full_name: str,  # Required: '<catalog>.<schema>.<feature_name>'
) -> None
fe.delete_feature(full_name="main.store.amount_sum_rolling_7d")
Bir özelliği silmeden önce, bu özelliğe başvuran modelleri veya özellik belirtimlerini kaldırın veya güncelleştirin. Bir özellik, hâlâ ortaya çıkmış özelliklere sahip olduğu sürece silinemez. Önce maddeleşen özellikleri silin, sonra özelliği silin. Bkz. Gerçekleştirilmiş bir özelliği silme.
Otomatik oluşturulan adlar
Atlandığında name , otomatik olarak bir ad oluşturulur. Oluşturulan adlar şu desene uyar: {column}_{function}_{window}. Örneğin:
-
price_avg_rolling_1h(1 saatlik ortalama fiyat) -
transaction_count_rolling_30d_1d(Etkinlik zaman damgasından 1d gecikmeli 30 günlük işlem sayısı)
Desteklenen fonksiyonlar
Toplama işlevleri
Note
Toplama işlevleri, zaman AggregationFunction açıklandığı gibi bir zaman penceresiyle birlikte sarmalanmıştır. Her işlev, toplanması gereken kaynak sütunu belirten bir input parametre alır.
| Function | Description | Örnek kullanım örneği |
|---|---|---|
Sum(input="column") |
Değerlerin toplamı | Dakika cinsinden kullanıcı başına günlük uygulama kullanımı |
Avg(input="column") |
Değerlerin ortalaması | Ortalama işlem tutarı |
Count(input="column") |
Kayıt sayısı | Kullanıcı başına oturum açma sayısı |
Min(input="column") |
En düşük değer | Giyilebilir bir cihaz tarafından kaydedilen en düşük kalp atış hızı |
Max(input="column") |
Maksimum değer | Oturum başına en yüksek işlem miktarı |
StddevPop(input="column") |
Popülasyon standart sapması | Tüm müşteriler arasında günlük işlem miktarı değişkenliği |
StddevSamp(input="column") |
Örnek standart sapma | Reklam kampanyası tıklama oranlarının değişkenliği |
VarPop(input="column") |
Popülasyon varyansı | Bir fabrikadaki IoT cihazları için sensör okumalarının yayılması |
VarSamp(input="column") |
Örnek varyans | Film derecelendirmelerinin örneklenen bir gruba yayılması |
ApproxCountDistinct(input="column", relativeSD=0.05) |
Benzersiz yaklaşık sayı | Satın alınan farklı öğelerin sayısı |
ApproxPercentile(input="column", percentile=0.95, accuracy=100) |
Yaklaşık persentil | p95 yanıt gecikme süresi |
First(input="column") |
İlk değer | İlk oturum açma zaman damgası |
Last(input="column") |
Son değer | En son satın alma tutarı |
FirstN(input="column", n=3) |
Dizi olarak ilk n değerler |
İlk üç ürün bir oturumda görüntülendi |
LastN(input="column", n=3) |
n Son değerler bir dizi olarak |
En son üç destek davası durumu |
FirstDistinct(input="column", n=3) |
Dizi olarak ilk n belirgin değerler |
İlk üç farklı ürün kategorisi görüntülendi |
LastDistinct(input="column", n=3) |
Dizi olarak son n belirgin değerler |
En son üç farklı tüccar kategorisi |
Note
First, , , , , ve LastDistinct desteklenen skaler değerleri ve ARRAY, MAP, , ve STRUCT değerleri, iç içe birleşikler dahil olmak üzere kabul eder. FirstDistinctLastNFirstNLast Varsayılan olarak null değerler içerirler. Null değerleri atlamak için, null olan giriş sütunlarını açıkça dışlayan bir filter_condition ekleyin.
FirstN, LastN, , ve LastDistinct giriş satırlarını sıralamak için özellikleri timeseries_column kullanarak en fazla değer içeren bir dizi nFirstDistinctdöndürür. Parametre n pozitif bir tam sayı olmalıdır.
FirstN ve FirstDistinct en erkenden en gesine kadar değerleri seçebilir.
LastN ve LastDistinct değerleri en yenisinden en erkeğe doğru seçip sonra seçilen değerleri zaman damgası sırasına göre döndürür.
FirstDistinct ve LastDistinct o yönde değerler seçerken tekrarlanan değerleri kaldırır.
Örneğin, bir varlığın kaynak satırları şu event_time["A", "A", "B", "C", "B", "B"]şekilde sıralanırsa, aşağıdaki fonksiyonlar döner:
| Function | Result |
|---|---|
FirstN(input="event_type", n=3) |
["A", "A", "B"] |
LastN(input="event_type", n=3) |
["C", "B", "B"] |
FirstDistinct(input="event_type", n=3) |
["A", "B", "C"] |
LastDistinct(input="event_type", n=3) |
["A", "C", "B"] |
FirstN, LastN, , ve LastDistinct 0.17.0 veya daha yeni sürüm gerektirir databricks-feature-engineeringFirstDistinct.
CustomUDF
CustomUDFher satıra kayıtlı bir Unity Kataloğu Python kullanıcı tanımlı fonksiyonu (UDF) uygular. İstek girdilerini dönüştürmek veya özellik değerlerini birleştirmek için kullanın. Satır toplamaz veya zaman penceresi tanımlamaz (satırları toplamaz) değildir.
CustomUDF(
    function_name="main.ecommerce.log_amount_udf",
    input_bindings={"amount": "transaction_amount"},
)
input_bindings her UDF parametre adını bir girdiye eşler. İçinde RequestSource, girdi bir kaynak sütun adıdır. Çünkü FeatureViewSource, yukarı akış özelliği referansıdır. Tüm UDF parametrelerini, varsayılan parametreler dahil olmak üzere bağlayın. Giriş türleri, örtük sayısal dökümler olmadan UDF parametre tipleriyle tam olarak eşleşmelidir. Skaler ve karmaşık (ARRAY, MAP, ve STRUCT) giriş ve dönüş türlerini, iç içe içe kombinasyonlar dahil olmak üzere kullanabilirsiniz.
| Source | Behavior |
|---|---|
RequestSource |
Eğitim DataFrame veya çıkarım talebinden sütunları dönüştürür. |
FeatureViewSource |
Yukarı akış özellik değerlerini birleştirir. FeatureViewSource'a bakınız. |
Delta destekli CustomUDF özellikler çevrimiçi olarak sunulamaz veya gerçekleştirilemez. Eğitim ve hizmet için tablo destekli özellik değerlerini dönüştürmek için, Delta destekli bir toplama veya sütun seçimi özelliği tanımlayın ve buna referans verin FeatureViewSource.
CustomUDF ile desteklenmez StreamSource. Bir akış özelliğinin çıktısını dönüştürmek için, o özelliği üzerinden FeatureViewSourcereferans alın.
CustomUDF 0.17.0 RequestSource veya daha yeni sürüm gerektirir databricks-feature-engineering .
Bir CustomUDF'yi kullanmak için, UDF'deki ayrıcalık, USE CATALOG ana kataloğundaki ayrıcalık ve USE SCHEMA ana şemadaki ayrıcalık gereklidirEXECUTE.
Aşağıdaki örnek, büyük işlem miktarlarının ölçeğini azaltarak hesaplamak için NumPy log(1 + amount)kullanır. Özel UDF bağımlılıkları etkin bir şekilde sunucusuz hesaplamada çalıştırın. Şema main.ecommerce olmalı.
spark.sql("""
CREATE OR REPLACE FUNCTION main.ecommerce.log_amount_udf(amount DOUBLE)
RETURNS DOUBLE
LANGUAGE PYTHON
ENVIRONMENT (
  dependencies = '["numpy==1.26.4"]',
  environment_version = '6'
)
AS $$
import numpy as np

if amount is None or not np.isfinite(amount) or amount < 0:
    return None
return float(np.log1p(amount))
$$
""")
İstek sütununu transaction_amount UDF parametresine amountbağlayan bir özelliği kaydedin :
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import (
    CustomUDF, FieldDefinition, RequestSource, ScalarDataType,
)

fe = FeatureEngineeringClient()

log_transaction_amount = fe.create_feature(
    source=RequestSource(
        schema=[
            FieldDefinition(name="transaction_amount", data_type=ScalarDataType.DOUBLE),
        ]
    ),
    function=CustomUDF(
        function_name="main.ecommerce.log_amount_udf",
        input_bindings={"amount": "transaction_amount"},
    ),
    catalog_name="main",
    schema_name="ecommerce",
    name="log_transaction_amount",
)
UDF'ler, ENVIRONMENT çevrimdışı hesaplama için bağımlılıkları yapılandırır. Çevrimiçi servis için paketleri veya create_feature_spec(extra_pip_requirements=...)log_model(extra_pip_requirements=...)içinde de belirtin. UDF'den otomatik olarak kopyalanmıyorlar.
Bkz. Özellik Hizmeti bağımlılıkları ve model bağımlılıkları.
CustomUDF özellikler ortaya çıkamaz. İstek destekli ve özellik destekli UDF'ler, eğitim ve hizmet sırasında talep üzerine çalışır. Bir bağımlılık zincirindeki her UDF hesaplama ekliyor, bu yüzden fonksiyonları ve zincirleri küçük tutun. UDF'ler, çevrimdışı veya NaN çevrimiçi olabilecek eksik girişleri None yönetmek zorundadır.
Eksik değerleri yönetme konusunda rehberlik için bkz. Eksik özellik değerlerini nasıl ele alınır.
ColumnSelection (geçiş)
ColumnSelection bir kaynaktan tek bir sütun seçer ve herhangi bir toplama uygulamadan yapılır. Doğrudan parametresinde function (içinde AggregationFunctiondeğil) sarmalanır. İç içe ARRAY, MAP, ve STRUCT türler dahil olmak üzere dönüş türü, özellik oluşturulduğunda kaynak şemadan çıkarılır. Özellik oluşturulduktan sonra kaynak sütunun türünün değiştirilmesi desteklenmemektedir.
| Function | Description | Örnek kullanım örneği |
|---|---|---|
ColumnSelection("col") |
Sütunun en son değeri (toplama yok) | En son satıcı kategorisi, istek alanının geçişi |
ColumnSelection Aşağıdaki veri kaynaklarını destekler:
-
DeltaTableSource: Bir nokta-zaman birleşimi yoluyla (geri bakma penceresi toplama yok) en son değeri varlık anahtarı başına döndürür. -
SdpSource: Pipeline'ın çıkış tablosundan varlık anahtarı başına en son değeri döndürür, aynıDeltaTableSourcedeğer ile aynı. -
StreamSource: Akıştan en son varlık anahtarı değerini döndürür (geri bakma penceresi toplama yok). -
RequestSource: Çıkarım zamanında sağlanan değerden geçer (veya eğitim zamanında etiketli DataFrame'den çıkarılır).
A DeltaTableSourceiçin, ColumnSelection özellikler desteği filter_condition ve transformation_sql, en son değer seçiminden önce uygulanır, bu da toplama özellikleriyle aynıdır.
from databricks.feature_engineering.entities import (
    ColumnSelection, DeltaTableSource, Feature, FieldDefinition,
    RequestSource, ScalarDataType,
)

delta_source = DeltaTableSource(
    catalog_name="main", schema_name="feature_store", table_name="transactions",
)

request_source = RequestSource(
    schema=[
        FieldDefinition(name="session_duration", data_type=ScalarDataType.DOUBLE),
    ]
)

# ColumnSelection from a Delta table
latest_amount = Feature(
    source=delta_source,
    function=ColumnSelection("amount"),
    entity=["user_id"],
    timeseries_column="transaction_time",
    name="latest_transaction_amount",
)

# ColumnSelection from a RequestSource
session_feature = Feature(
    source=request_source,
    function=ColumnSelection("session_duration"),
    name="session_duration",
)
Örnek: toplama ve sütun seçimi özellikleri
Aşağıdaki örnek, aynı veri kaynağı üzerinde tanımlanan özellikleri gösterir.
from databricks.feature_engineering.entities import (
    AggregationFunction, Feature, Sum, Avg, ApproxCountDistinct,
    ColumnSelection, RollingWindow,
)
from datetime import timedelta

window = RollingWindow(window_duration=timedelta(days=7))

sum_feature = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(Sum(input="amount"), window),
)

avg_feature = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(Avg(input="amount"), window),
)

distinct_count = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(ApproxCountDistinct(input="product_id", relativeSD=0.01), window),
)

# Column selection (no aggregation, no time window)
latest_amount = Feature(
    source=source,
    function=ColumnSelection("amount"),
    entity=["user_id"],
    timeseries_column="event_time",
    name="latest_amount",
)
Filtre koşulları içeren özellikler
Parametre filter_condition , toplama hesaplamadan veya en son sütun değerini seçmeden önce kaynak tablodan satır filtrelemenize olanak tanır. Bu, verileri gruplandırma ve toplamadan önce uygulanan bir SQL WHERE yan tümcesi olarak işlev görür.
Note
Toplama özellikleri için, filter_condition toplama öncesi satırları filtreler; örneğin bir SQL WHERE cümlesi gibi .GROUP BY Her zaman özellik tanımında tarafından entity tanımlanan ayrıntı düzeyini değiştirmez.
Filtreler, özellik hesaplaması için gereken verilerin üst kümesini içeren büyük kaynak tablolarla çalışırken kullanışlıdır ve bu tabloların üzerinde ayrı görünümler oluşturma gereksinimini en aza indirir.
from databricks.feature_engineering.entities import AggregationFunction, Sum, Count, RollingWindow, DeltaTableSource
from datetime import timedelta

# Source with filter applied at the source level
high_value_transactions = DeltaTableSource(
    catalog_name="main",
    schema_name="ecommerce",
    table_name="transactions",
    filter_condition="amount > 100",  # Only transactions over $100
)

high_value_sales = Feature(
    source=high_value_transactions,
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=30))),
)

# Multiple conditions
completed_orders_source = DeltaTableSource(
    catalog_name="main",
    schema_name="ecommerce",
    table_name="orders",
    filter_condition="status = 'completed' AND payment_method = 'credit_card'",
)

completed_orders = Feature(
    source=completed_orders_source,
    entity=["user_id"],
    timeseries_column="order_time",
    function=AggregationFunction(Count(input="order_id"), RollingWindow(window_duration=timedelta(days=7))),
)

# Filter on a StreamSource
from databricks.feature_engineering.entities import StreamSource

purchase_stream = StreamSource(
    full_name="main.ecommerce.transactions_stream",
    filter_condition="value.event_type = 'purchase'",
)

purchase_total = Feature(
    source=purchase_stream,
    entity=["value.user_id"],
    timeseries_column="value.event_time",
    function=AggregationFunction(Sum(input="value.amount"), RollingWindow(window_duration=timedelta(hours=1))),
)
Veri kaynakları
DeltaTableSource
DeltaTableSourcekaynak tablodan özelliklerin nasıl hesaplandığını tanımlamak için kullanılan geçici bir Python nesnedir. Yeni bir tablo oluşturmaz. Verileri okumak ve özellikleri toplamak için yapılandırmayı belirtir.
DeltaTableSource(
    catalog_name: str,                              # Required: Catalog name
    schema_name: str,                               # Required: Schema name
    table_name: str,                                # Required: Table name
    filter_condition: Optional[str] = None,         # Optional: SQL WHERE clause to filter source data
    transformation_sql: Optional[str] = None,       # Optional: SQL SELECT expression for column transformations
    dataframe_schema: Optional[str] = None,         # Required if transformation_sql is set: schema of the resulting DataFrame
    lateness: Optional[SourceLateness] = None,       # Optional: Expected source settling time
)
Parametreler:
-
catalog_name,schema_name,table_name: Unity Kataloğunda kaynak Delta tablosunu belirleyin. -
filter_condition: Toplama veya sütun seçimi öncesinde uygulanan bir SQLWHEREmaddesi. Örnek:"status = 'completed'". -
transformation_sql: Kaynak tabloya uygulanan bir SQLSELECTifadesi. Bunu, toplama veya sütun seçiminden önce sütunları yeniden adlandırmak, döküm türlerini veya türevleri hesaplamak için kullanın. Atlanırsa, tüm sütunlar seçilir (*). Örnek:"user_id, CAST(amount AS DOUBLE) AS amount, event_time". -
dataframe_schema: Dönüşümlerden sonra ortaya çıkan DataFrame'in şeması, Spark StructType JSON formatında (fromdf.schema.json()). Sağlanmışsatransformation_sqlgereklidir. Bu, sisteme dönüştürmenizin sonucu olan sütun adlarını ve türlerini bildirir. -
lateness:SourceLatenessKaynağın olay zamanında tamamlanmasının normalde ne kadar sürdüğünü açıklayan bir nesne. Eğer atlanırsa, kaynak hemen tamamlanmış sayılır.
Hem hem de filter_conditiontransformation_sql ayarlandığında, sonuçta elde edilen sorgu şöyledir: SELECT {transformation_sql} FROM {table} WHERE {filter_condition}.
SourceLateness.settling_delay Eğitim sırasında çevrimiçi maddeleşmeyi etkileyen tutarlı bir ETL gecikmesini simüle etmenin önerilen yoludur. Azure Databricks, uygun eğitim değerlendirme süresini bu süre boyunca geriye kaydırır; böylece bir eğitim örneği hâlâ çevrimiçi geçişte olan verileri kullanmaz. Maddeleştirme sırasında, Azure Databricks tamamlanmış bir pencereyi yayınlamadan önce aynı süre bekler ve aradaki süre boyunca son tamamlanmış pencereyi sunar.
Örneğin, günlük bir ETL işi, gece yarısı 07:00 UTC'ye karşılık gelen yerel bir saat diliminde gece yarısından 8 saat sonra tamamlanıyor. 8 saatlik yerleşme gecikmesi ve 7 saatlik bir pencere ofseti kullanın:
from datetime import timedelta
from databricks.feature_engineering.entities import (
    DeltaTableSource,
    SourceLateness,
    TumblingWindow,
)

source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    lateness=SourceLateness(settling_delay=timedelta(hours=8)),
)

window = TumblingWindow(
    window_duration=timedelta(days=1),
    offset=timedelta(hours=7),
)
Note
Türde timeseries_columnTimestampType olmalı veya TimestampNTZType.
DateType zaman serileri için desteklenmez; sütunu ilk sıraya TimestampType atır (örneğin, ile transformation_sql).
Örnek: Sütun dönüşümleri için kullanım transformation_sql
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="raw_events",
    transformation_sql="user_id, CAST(price_cents AS DOUBLE) / 100 AS price, event_time",
    filter_condition="event_type = 'purchase'",
    dataframe_schema=spark.sql(
        "SELECT user_id, CAST(price_cents AS DOUBLE) / 100 AS price, event_time FROM main.analytics.raw_events LIMIT 0"
    ).schema.json(),
)
Örnek: Bir PySpark DataFrame'den transformation_sql ve dataframe_schema türetilme
Dönüştürmenizi PySpark sorgusu olarak yazabilir ve ardından sonuçta elde edilen DataFrame'den şemayı ayıklayabilirsiniz:
df = spark.sql(f"""
  SELECT user_id, CAST(amount AS DOUBLE) / 100 AS amount_dollars, event_time
  FROM main.analytics.events
  WHERE event_date >= date_sub(current_date(), 7)
  LIMIT 0
""")

# Use df.schema.json() as the dataframe_schema
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    transformation_sql="user_id, CAST(amount AS DOUBLE) / 100 AS amount_dollars, event_time",
    filter_condition="event_date >= date_sub(current_date(), 7)",
    dataframe_schema=df.schema.json(),
)
Desteklenen transformation_sql ifadeler
Aynı kurallar üzerinde DeltaTableSource ve StreamSourceüzerinde transformation_sql de geçerlidir.
transformation_sql herhangi bir satır ifadesini destekler; her satır için bağımsız olarak değerlendirilen işlemler. Satır sayısını veya kaynakla bire bir uyumu değiştirmezler. Satır-bazında ifadeler arasında sütun yeniden adlandırmaları, dökümler, aritmetik işlemler ve daha fazlası bulunur.
Şekli veya satır sayısını değiştiren işlemler, örneğin veya COUNT()veya toplamalar SUM() desteklenmez. Bunun yerine özellik tanımında kullanın AggregationFunction .
DeltaTableSource.from_sql()
Kolaylık sağlamak için SQL sorgusundan bir DeltaTableSource oluşturabilirsiniz. yöntemi sorguyu ayrıştırarak tablo adını transformation_sql, ve filter_condition'yi otomatik olarak ayıklar.
DeltaTableSource.from_sql(
    sql: str,                           # Required: SQL SELECT query
    spark: SparkSession,                # Required: active SparkSession (for schema inference)
) -> DeltaTableSource
Yalnızca basit SELECT ... FROM ... [WHERE ...] sorgular desteklenir. Karmaşık SQL (JOIN'ler, alt sorgular, CTEs, UNION'lar) reddedilir. Karmaşık sorgular için doğrudan ve DeltaTableSourceile transformation_sql oluşturmafilter_condition.
from databricks.feature_engineering.entities import (
    AggregationFunction,
    DeltaTableSource,
    Feature,
    Sum,
    TumblingWindow,
)

source = DeltaTableSource.from_sql(
    spark=spark,
    sql=f"SELECT customer_id, event_ts, amount * 2 AS doubled_amount, amount FROM {CATALOG}.{SCHEMA}.{TABLE}",
)

feature = Feature(
    source=source,
    function=AggregationFunction(Sum(input="doubled_amount"), time_window=TumblingWindow(window_duration=timedelta(days=7))),
    entity=["customer_id"], timeseries_column="event_ts",
)
ile yinele to_dataframe()
Özellik hesaplaması için kullanılacak verilerin önizlemesini görüntülemek için kullanın source.to_dataframe() . Bu, beklenen sonuçları elde edene kadar ve filter_condition üzerinde transformation_sql yineleme yapmak için yararlıdır.
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    filter_condition="event_type = 'purchase'",
)

# Preview the filtered source data
source.to_dataframe().display()
Varlıkları anlama
Varlık sütunları, özelliklerinizin toplama düzeyini tanımlar. Bunlar tanımda Feature belirtilir, üzerinde DeltaTableSourcebelirtilmez. Varlıklar aşağıdakileri belirler:
-
Veri nasıl gruplanır: Özellikler, varlık değerlerinin benzersiz kombinasyonuna göre (SQL'deki gibi
GROUP BY) toplanır - Ana anahtar yapısı: Her benzersiz varlık kombinasyonu, hesaplanan özelliklerden oluşan bir satırla sonuçlanır
Örnek: Müşteri düzeyindeki özellikler
Aşağıdaki kod, müşteri düzeyindeki özellikleri toplar (müşteri başına bir satır):
from databricks.feature_engineering.entities import DeltaTableSource

source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="user_events",
)

Feature(
    source=source,
    entity=["user_id"],                # Features aggregated per user
    timeseries_column="event_time",    # Timestamp for time windows
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)
Örnek: Müşteri-Mağaza düzeyindeki özellikler
Özellikleri daha ayrıntılı bir düzeyde (müşteri-mağaza birleşimi başına bir satır) toplamak için birden çok varlık sütunu kullanın:
source = DeltaTableSource(
    catalog_name="main",
    schema_name="retail",
    table_name="transactions",
)

Feature(
    source=source,
    entity=["user_id", "store_id"],  # Features aggregated per user-store pair
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)
Farklı toplama düzeylerinde (örneğin, müşteri düzeyinde ve müşteri-mağaza düzeyinde) özelliklere ihtiyacınız olduğunda, özellik tanımlarınızda farklı entity değerler kullanın.
DeltaTableSource Aynı durum farklı varlık yapılandırmalarına sahip özellikler arasında paylaşılabilir.
StreamSource
StreamSource
Bir Akışa referans veriyor. Stream, akış kaynağı için bağlantı, kimlik doğrulaması, şema ve alma yapılandırması içerir. Kafka için özellik tanımlarındaki sütun başvuruları, iletinin hangi bölümünün okunması gerektiğini belirtmek için veya value. ön ekine key. eklenmelidir.
StreamSource(
    full_name: str,                       # Required: Three-part Stream name (catalog.schema.stream)
    filter_condition: Optional[str] = None,      # Optional: SQL WHERE clause applied before aggregation
    transformation_sql: Optional[str] = None,    # Optional: SQL SELECT expression for column transformations
    dataframe_schema: Optional[str] = None,      # Required if transformation_sql is set: schema of the resulting DataFrame
    lateness: Optional[SourceLateness] = None,    # Optional: Expected source settling time
)
Parametreler:
-
full_name: Bir Akarsuyun tam üç bölümlü adı (örneğin,"my_catalog.my_schema.my_stream"). -
filter_condition(isteğe bağlı): Toplama öncesi akış verilerine uygulanan bir SQLWHEREmaddesi, nokta ön ekli sütun referansları kullanılarak (örneğin,"value.event_type = 'purchase'"). -
transformation_sql(isteğe bağlı): Toplama veya sütun seçimi öncesi olarak uygulanan, vevalueyapılarına nokta ön ekli referanslarkeykullanılarak uygulanan bir SQLSELECTifadesi. Aynı satır ifadelerini destekler.DeltaTableSourceEğer atlanırsa, kaynak tüm sütunları (*) kullanır. -
dataframe_schema: Projeksiyon çıktısının SparkStructTypeJSON şeması. Eğer ayarladıysanıztransformation_sqlgereklidir. -
lateness:SourceLatenessAkışın olay zamanında tamamlanmasının normalde ne kadar sürdüğünü açıklayan bir nesne. Bkz.SourceLateness.settling_delay.
from databricks.feature_engineering.entities import StreamSource

stream_source = StreamSource(
    full_name="my_catalog.my_schema.my_stream",
    filter_condition="value.event_type = 'purchase'",
)
dataframe_schema Projeksiyonu Akış'ın yutma tablosuna karşı çalıştırarak türetilir; bu tablo ve value yapıları key ortaya çıkarır.
transformation_sql = (
    "value.amount * value.conversion_rate AS converted_amount, "
    "struct(value.user_id AS user_id, value.event_time AS time) AS event"
)

ingestion_table = "my_catalog.my_schema.events_ingestion"
dataframe_schema = spark.sql(
    f"SELECT {transformation_sql} FROM {ingestion_table} LIMIT 0"
).schema.json()

stream_source = StreamSource(
    full_name="my_catalog.my_schema.my_stream",
    transformation_sql=transformation_sql,
    dataframe_schema=dataframe_schema,
)
SdpSource
SdpSource tetiklenen bir Lakeflow boru hattının çıktı tablosunda özellikleri tanımlar. Feature Store, her maddeleştirme ve geri doldurmadan önce boru hattını çalıştırır ve ardından çıkış tablosunu DeltaTableSourcebir 'a okuduğu gibi) okur. Uçtan uca iş akışı için bkz. Özellik kaynağı olarak Lakeflow boru hattı kullanın.
SdpSource(
    pipeline_id: str,                            # Required: ID of the pipeline that produces the output table
    output_table: str,                           # Required: Three-part name of the pipeline output table to read
    input_tables: Optional[List[str]] = None,    # Optional: Three-part names of the tables the pipeline reads from
    filter_condition: Optional[str] = None,      # Optional: SQL WHERE clause to filter the output table
    transformation_sql: Optional[str] = None,    # Optional: SQL SELECT expression for column transformations
    dataframe_schema: Optional[str] = None,      # Required if transformation_sql is set: schema of the resulting DataFrame
)
Parametreler:
-
pipeline_id: Mevcut tetiklenen bir boru hattının kimliği. Boru hattının henüz çalışmış olması gerekmiyor. Bunun için ÇALIŞTIRABILIR, YÖNETEBILIR veya SAHİB İZNİ almanız gerekir. Sürekli boru hatları reddedilir. -
output_table: Pipeline çıkış tablosunun üç bölümlü adı (catalog.schema.table) okunacak. Tablo, boru hattı ilk çalıştırılana kadar var olmak zorunda değil. Varsa, boru hattının bir çıkışı olmalı ve üzerinde olmanSELECTgerekiyor. -
input_tables: Boru hattının okunduğu tabloların üç parçalı isimleri. BirTableTriggerile maddeleşmesi gerekir, bu da bu tablolar güncellendiğinde bir çalışma başlatır.ColumnSelectionözellikler bir tablo tetikleyicisinde ortaya çıkar, bu yüzden gerekirinput_tables. En fazla 25 tablo listeleyebilirsiniz, hiçbir kopya yoktur ve her tablo özelliği oluştururken orada olmalıdır. A,TableTriggeryalnızca her izlenen tabloda dosya olayları etkinleştirildiğinde 10'dan fazla tabloyu izler. -
filter_condition,transformation_sql,dataframe_schema: Çıkış tablosuna bir 'deDeltaTableSourceuygulandığı şekilde 'de uygulanır.dataframe_schemaEğer ayarlıyorsanıztransformation_sqlgereklidir.
SdpSource Destek ColumnSelection ve toplama fonksiyonlarını içerir. Desteklemiyorlar CustomUDF.
Bir özellik oluşturduktan sonra, kaynağı yalnızca okunur pipeline_stateşeklinde bir mesaj verir:
-
PENDING: Boru hattı henüz çalışmadı, bu yüzden çıktı tablosu mevcut değil. -
RESOLVED: Çıktı tablosu vardır ve özelliğin sütunları ona karşı doğrulanır. -
ERROR: Boru hattı çalıştırması veya çıktı tablosu doğrulaması başarısız oldu.
Aşağıdaki örnek şunu SdpSourcetanımlar:
from databricks.feature_engineering.entities import SdpSource

source = SdpSource(
    pipeline_id="1234abcd-5678-90ef-1234-567890abcdef",
    output_table="main.features.tutor_review_stats",
    input_tables=["main.raw.reviews", "main.raw.tutors"],
)
refresh_sdp_source()
refresh_sdp_source verilen özelliklerin arkasındaki boru hatlarını çalıştırır. Her pipeline için bir güncelleme başlatır veya zaten çalışan bir güncellemeye eklenir.
FeatureEngineeringClient.refresh_sdp_source(
    *,                                  # Arguments are keyword-only
    features: List[Feature],            # Features with an SdpSource
    wait: bool = True,                  # Wait for the updates to finish
) -> Dict[str, str]                     # Pipeline ID to update ID
Ile wait=True, çağrı her güncellemenin bitmesini bekler, zaman aşımına girmez ve ardından özelliklerin pipeline_state' sorununu çözer. Bir güncelleme başarısız olursa veya iptal edilirse ya da bir özellik çözülmediğinde bu durum yükseliyor ValueError .
wait=FalseGüncelleme başlar başlamaz arama geri gelir.
Bir özelliğin pipeline'ını eğitimden önce çalıştırmak için aşağıdakileri çalıştırın:
fe.refresh_sdp_source(features=[fe.get_feature(full_name="main.features.tutor_avg_score_7d")], wait=True)
RequestSource
RequestSource Önceden maddeleştirilmiş bir tablodan bakılmayan istek yükündeki çıkarım zamanında sağlanan veri şemasını tanımlar. Eğitim sırasında, bu sütunlar etiketli DataFrame'den ayıklanır ve öğesine create_training_setgeçirilir. Model sunma sırasında çağıranın bunları HTTP isteği yüküne dahil etmesi gerekir.
RequestSource
CustomUDF veya ColumnSelection Feature View fonksiyonlarıyla birlikte kullanılabilir. Toplama işlevlerini veya zaman pencerelerini desteklemez.
Şemayı tanımlama
Şemayı, her biri FieldDefinition bir sütun adı ve ScalarDataTypebir belirten nesnelerin listesi olarak tanımlayın:
from databricks.feature_engineering.entities import (
    FieldDefinition, RequestSource, ScalarDataType,
)

request_source = RequestSource(
    schema=[
        FieldDefinition(name="transaction_amount", data_type=ScalarDataType.DOUBLE),
        FieldDefinition(name="vendor_id", data_type=ScalarDataType.STRING),
        FieldDefinition(name="transaction_id", data_type=ScalarDataType.STRING),
        FieldDefinition(name="transaction_time", data_type=ScalarDataType.DATE),
    ]
)
Diziler, haritalar veya yapılar içeren şemalar için, dataframe_schema (Spark StructType JSON'undan) df.schema.json()yerine schemageçin veya şemayı bir DataFrame'den şu RequestSource.from_dataframeşekilde çıkarabilirsiniz:
from databricks.feature_engineering.entities import RequestSource

request_source = RequestSource.from_dataframe(dataframe=labeled_df.select("cart_items", "device_info"))
Desteklenen veri türleri
RequestSource
ScalarDataType
INTEGER: , FLOAT, BOOLEAN, STRING, DOUBLE, BINARYLONGTIMESTAMPDATESHORT. . Ayrıca, şemayı veya from_dataframeile tanımladığınızda, bu türlerden oluşturulan sütunları STRUCTMAPda desteklerARRAYdataframe_schema.
MAP anahtarlar olmalı STRING.
İstek verileri nasıl sulanır?
| Bağlam | Behavior |
|---|---|
Eğitim (create_training_set) |
Sütunlar Etiketli DataFrame'den ayıklanır. Türler bildirilen şemaya göre doğrulanır. Uyuşmazlıklar bir hata oluşturur (örtük atama yoktur). |
| Hizmet (model uç nokta) | Sütunlar HTTP isteğinden dataframe_records veya dataframe_split isteğinden çekilir. JSON değerleri bildirilen türlere (örneğin, JSON numarası → DOUBLE) türe değiştirilir. |
Model imzası
Bir model, özellikler içeren log_model bir eğitim kümesi kullanılarak RequestSource günlüğe kaydedildiğinde, RequestSource sütunlar MLflow modeli imzasına gerekli girişler olarak eklenir. Bu, hizmet veren uç noktanın API şemasının, çıkarım zamanında hangi alanları çağıranların sağlaması gerektiğini yansıtdığı anlamına gelir.
FeatureViewSource
FeatureViewSource diğer Özellik Görünümlerinin çıktılarını bir 'a CustomUDFgiriş olarak kullanır. Özelliklerin zincirlenmesi, yönlendirilmiş bir asiklik grafik (DAG) oluşturur. Örneğin, bir marj özelliği gelir ve maliyet toplamlarını birleştirebilirken, başka bir özellik marjı dönüştürebilir.
için 0.18.0 veya daha yeni FeatureViewSourcesürümleri databricks-feature-engineering kullanın.
Bir nesne Feature listesini , featuresözellik adı dizileri değil, iletin. Kayıtlı özellikleri ile get_featurealın. İçinde input_bindings, her kayıtlı özelliğin full_name. Yerel, kayıtsız bir özellik için onun yerine onu name kullanın.
Aşağıdaki örnek, nokta-zaman hesaplama için değerleri döndüren DOUBLEevent_time ve kullanan iki kayıtlı özelliği revenue_sum_7d ve cost_sum_7dcustomer_id , varsayar:
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import CustomUDF, FeatureViewSource

fe = FeatureEngineeringClient()
revenue = fe.get_feature(full_name="main.ecommerce.revenue_sum_7d")
cost = fe.get_feature(full_name="main.ecommerce.cost_sum_7d")

spark.sql("""
CREATE OR REPLACE FUNCTION main.ecommerce.margin_udf(revenue DOUBLE, cost DOUBLE)
RETURNS DOUBLE
LANGUAGE PYTHON
AS $$
import math

if revenue is None or cost is None:
    return None
if not math.isfinite(revenue) or not math.isfinite(cost) or revenue <= 0:
    return None
return (revenue - cost) / revenue
$$
""")

margin = fe.create_feature(
    source=FeatureViewSource(features=[revenue, cost]),
    function=CustomUDF(
        function_name="main.ecommerce.margin_udf",
        input_bindings={"revenue": revenue.full_name, "cost": cost.full_name},
    ),
    catalog_name="main",
    schema_name="ecommerce",
    name="margin",
)
Aşağıdaki kısıtlamalar geçerlidir:
- Sadece
CustomUDFfonksiyon olarak desteklenir. Yukarı akış özellikleri ise toplamalar, sütun seçimleri veya diğerCustomUDFözellikler olabilir. - Çıkar
entityvetimeseries_columntüretilmiş özellik üzerine de. Her üst akış özelliği kendi varlığını, zaman damgasını ve pencere tanımını korur. - Bir özelliğin tek bir kaynağı vardır. Bir istek değerini tablo destekli bir özellikle birleştirmek için, bir
RequestSourceözellik tanımlayın ve her ikisine de referans verin.FeatureViewSource - Her ilan edilen yukarı akış özelliği içinde
input_bindingskullanılmalıdır. Döngülere izin verilmiyor. - Türetilmiş özelliği kaydetmeden önce yukarı akış özelliklerini kaydedin. Yerel, kayıtsız grafikler deney için kullanılabilir
create_training_set. - Eğitim veya hizmet için, türetilmiş özellik ve onun geçişli yukarı akış özellikleri üzerinde veya
MANAGEayrıcalığına ihtiyacınızREAD FEATUREvardır. Kayıt ve hizmet için grafik boyunca farklı özellik isimleri kullanın, hatta kataloglar veya şemalar arasında bile. - Bir özellik, 20'ye kadar doğrudan yukarı akış özelliğine atıfta bulunabilir. Kayıtlı grafikler, temel özellik dahil olmak üzere bağımlılık yolu boyunca maksimum beş özelliğin derinliğini destekler.
- Eğitim sorguları, tüm bağımlılık grafiği boyunca sayılan beş Unity Catalog UDF çağrısı sınırına tabidir. Bunu aşmak için, Databricks Runtime 18.1 veya üzeri kullanan klasik hesaplama kullanın. Sunucusuz hesaplamada ve pro ile sunucusuz SQL depolarında, her UDF tanımında veya
6üzerinde ayarlanmıştırenvironment_version. -
FeatureViewSourceözellikler ilecompute_featuresmaddileştirilemez veya değerlendirilemez. Onları çevrimdışı değerlendirmek için kullanıncreate_training_set. Çevrimiçi servis için, desteklenen tablo destekli upstream özelliklerini gerçekleştirin.
Bağımlılık değerlendirmesi ve çıktı seçimi için bkz. Feature ViewSource özellikleriyle Train (Özellik Görünümü Kaynağı özellikleriyle) bölümünü ziyaret edin. Dağıtım için bkz. Serve türeden özellikler.
Eğitim ve çıkarım API'si
create_training_set ve score_batch kaynak veriden talep üzerine doğru özellik değerlerini hesaplamak. Delta tablo kaynaklarında kayan pencere toplamaları gibi çevrimdışı gerçekleştirmeyi destekleyen özellikler için, özelliklerin önce çevrimdışı bir depoya gerçekleştirilmesi her iki işlemin de performansını artırır. Gerçekleştirilmiş çevrimdışı özellikler kullanılabilir olduğunda, işlemler kaynaktan özellik değerlerini yeniden derlemek yerine önceden derlenmiş çevrimdışı verileri okur. Özellikleri çevrimdışı bir depoda gerçekleştirmek için bkz. Özellik Görünümlerini Gerçekleştirme.
create_training_set()
Belirli bir noktaya doğru özellik hesaplaması ile bir eğitim veri kümesi oluşturur. Ayrıntılar için bkz. Özellik Görünümleri ile modelleri eğitma.
FeatureEngineeringClient.create_training_set(
    df: DataFrame,                                # DataFrame with training data
    features: Optional[List[Feature]],            # List of Feature objects
    label: Union[str, List[str], None],           # Label column name(s)
    exclude_columns: Optional[List[str]] = None,  # Optional: columns to exclude
) -> TrainingSet
log_model()
Çıkarım sırasında köken izleme ve otomatik özellik araması için özellik meta verilerine sahip bir modeli günlüğe kaydeder. Ayrıntılar için bkz. Özellik Görünümleri ile modelleri eğitma.
FeatureEngineeringClient.log_model(
    model,                                    # Trained model object
    artifact_path: str,                       # Path to store model artifact
    flavor: ModuleType,                       # MLflow flavor module (e.g., mlflow.sklearn)
    training_set: TrainingSet,                # TrainingSet used for training
    registered_model_name: Optional[str],     # Optional: register model in Unity Catalog
)
score_batch()
Otomatik özellik arama ile çevrimdışı toplu çıkarım gerçekleştirir. Belirli bir noktaya doğru özellikleri hesaplamak ve eğitimle tutarlılık sağlamak için modelle birlikte depolanan özellik meta verilerini kullanır.
FeatureEngineeringClient.score_batch(
    model_uri: str,                           # URI of logged model (e.g., "models:/catalog.schema.model/1")
    df: DataFrame,                            # DataFrame with entity keys and timestamps
) -> DataFrame
Giriş DataFrame'i eğitim sırasında kullanılan varlık ve zaman aralıkları sütunlarını içermelidir. Özellikler kaynak verilerden otomatik olarak hesaplanır.
fe = FeatureEngineeringClient()

# Batch scoring with automatic feature lookup
predictions = fe.score_batch(
    model_uri="models:/main.ecommerce.fraud_model/1",
    df=inference_df,
)
predictions.display()
Zaman aralıkları
Özellik Görünümleri, zaman penceresi tabanlı toplamalar için geri dönüş davranışını kontrol etmek amacıyla dört pencere tipini destekler. Mevcut pencere türleri özelliğin kaynağına bağlıdır: akış kaynaklı özellikler yuvarlanan ve testere dişli pencereler kullanabilirken, toplu kaynak özellikler rulo, yuvarlanan ve kaydırma pencereler kullanabilir.
- Sıralı pencereler olay zamanından geriye bakar. Süre ve gecikme açıkça tanımlanır.
- Atlayan pencereler sabit, örtüşmeyen zaman pencereleridir. Her veri noktası tam olarak bir pencereye aittir.
- Kayan pencereler çakışıyor, sıralı zaman pencereleri yapılandırılabilir bir slayt aralığıyla.
- Sawtooth pencereleri, hibrit toplu ve akış yolu kullanarak uzun bir geri dönüş penceresini taze tutar. Bkz. Sawtooth penceresi.
Aşağıdaki çizim, yuvarlanan, kayan, yuvarlanan ve testere dişli pencere tiplerini göstermektedir.

Zaman aralığı zamanlaması
Daha erken bir analitik noktada bir pencereyi değerlendirmek için kullanılır delay . Örneğin, 7 günlük gecikmeli 30 günlük bir pencere, değerlendirme zamanından bir hafta önce 30 günlük bir değer hesaplar.
delay kaynağın varış zamanından bağımsızdır. Kaynak verinin ulaşma süresini modellemek için yapılandırma SourceLateness.settling_delay yapın.
Her iki ayar da bulunduğunda, onlar yazıyor. Azure Databricks, kaynak yerleşim gecikmesinden sonra pencereyi tamamlanmış olarak ele alır ve analitik gecikme kullanarak değerlendirir.
Sabit pencere sınırlarının hizalanmasını değiştirmek için kullanılır offset . Varsayılan olarak, yuvarlanan pencereler ve kaydıran pencereler gece yarısı UTC'ye hizalanır. Örneğin, 22 saatlik bir ofset günlük sınırı 22:00 UTC'ye hizalar. Yerel bir saat dilimindeki sınırları yaklaşık olarak belirlemek için, UTC'ye göre statik bir ofset yapılandırın. Ofset, yaz saatine göre ayarlamaz, değerlendirme zamanını kaydırmaz veya geç gelen verileri modellemez.
Aşağıdaki tablo bu alanların desteğini özetlemektedir:
| Veri Alanı | Desteklenen pencereler | Kısıtlama |
|---|---|---|
delay |
Yuvarlanma, yuvarlanma ve kayma | Negatif olmayan olmalı datetime.timedelta |
offset |
Yuvarlanma ve kayma | Negatif olmayan ve dönemden kısa olmalı* |
SourceLateness.settling_delay |
Yuvarlanan, yuvarlanan ve kayan özellikler | Negatif olmayan olmalı datetime.timedelta |
start_time |
Yuvarlanma, yuvarlanma, kayma ve testere dişi | Olmalı ki bir datetime.datetime. Testere dişi için, özellik oluşturulma zamanından daha geç olmamalıdır. |
*Nokta: Dönen pencere için, kaymanın daha kısa olması gerekir window_duration. Kaydırmalı pencere için, pencerenin daha kısa slide_durationolması gerekir.
Başlangıç zamanı
UTC'de bir özelliğin çıktı yayabileceği en erken olay-zaman sınırını belirlemek için kullanılır start_time . Sınır kapsayıcıdır.
start_time Gates çıkışları. Bir pencerenin okuyabileceği tarihsel kaynak satırlarını sınırlamaz ve pencere hizasını değiştirmez. Eğer start_time iki hizalanmış sınır arasında yer alırsa, ilk uygun sabit pencere çıktısı sonraki sınırdır.
Sabit süreli pencereler, start_timekaynak içinde tam bir pencere süresi geçmeden önce yayımlanabilir. Bu erken çıktılar, mevcut olan kaynak geçmişini kullanır. Örneğin, verileri 1 Ocak 2024'te başlayan bir kaynak üzerinde bir yıl window_duration ve bir günlük slide_durationkaydırma penceresi düşünün:
- Yoksa
start_time, özellik ilk olarak 1 Ocak 2025'te, tam bir yıllık bir pencere oluşturulabildiğinde yayımlanıyor. -
start_time21 Ağustos 2024'te planlanan bu özellik, ilk olarak 21 Ağustos 2024'te yayınlanacak. Bu çıktı, yalnızca 1 Ocak 2024 tarihinden itibaren mevcut olan kaynak geçmişini kapsamaktadır. Bu dönem 1 Ocak 2025'te tam bir yıllık dönemine ulaşır ve o tarihten itibaren tam çıktılar üretir.
Pencere hizasını değiştirmediği start_time için, iki hizalanmış sınır arasındaki bir değer yeni bir sınır oluşturmaz. Gece yarısı UTC'de günlük sınırları olan bir dönme penceresi için, start_time bir sonraki gece yarısı sınırında ilk olarak 06:00 UTC yayımlanır. Tam olarak bir sınıra inen A start_time , o sınırda yayımlanır, çünkü sınır kapsayıcıdır.
Eğer start_time belirlenmemişse, yuvarlanan pencereler ve sabit süreli kaydırma pencereler tam bir pencere oluşturulduktan sonra hizalanmış bir sınırda yayılır. Ömür boyu süren ve yuvarlanan pencereler, uygun kaynak veri bulunduğunda hemen yayımlanır.
Note
start_time testere dişli pencereler için ve toplu özelliklerde DeltaTableSourceyuvarlanan, yuvarlanan ve kaydırılmış pencereler için desteklenir.
RollingWindow
StreamSourceile desteklenmiyor.
Bkz. Sawtooth penceresi.
Örneğin:
from datetime import datetime, timedelta
from databricks.feature_engineering.entities import SlidingWindow

window = SlidingWindow(
    window_duration=timedelta(days=365),
    slide_duration=timedelta(days=1),
    start_time=datetime(2024, 8, 21),
)
Yuvarlanan pencere
Note
RollingWindow daha önce adı ContinuousWindowverilmişti. Önceki bir SDK sürümünden geçiş gerçekleştiriyorsanız, içeri aktarmalarınızı uygun şekilde güncelleştirin.
Sıralı pencereler, genellikle akış verileri üzerinde kullanılan up-totarih ve gerçek zamanlı toplamalardır. Akış işlem hatlarında, sıralı pencere yalnızca sabit uzunluktaki pencerenin içeriği değiştiğinde (örneğin, bir olay girdiğinde veya ayrıldığında) yeni bir satır yayar. Eğitim işlem hatlarında sıralı pencere özelliği kullanıldığında, belirli bir olayın zaman damgasından hemen önce sabit uzunluktaki pencere süresi kullanılarak kaynak verilerde doğru bir zaman noktası özellik hesaplaması gerçekleştirilir. Bu, çevrimiçi çevrimdışı dengesizliği veya veri sızıntısını önlemeye yardımcı olur. Zamandaki özellikler, [T − süre, T) aralığındaki olayları T birleştirir.
class RollingWindow(TimeWindow):
    window_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
Aşağıdaki tabloda sıralı pencere parametreleri listelemektedir. Pencere başlangıç ve bitiş saatleri aşağıdaki parametreleri temel alır:
- Başlangıç saati:
evaluation_time - window_duration - delay(dahil) - Bitiş saati:
evaluation_time - delay(özel)
| Parametre | Sınırlamalar |
|---|---|
delay (isteğe bağlı) |
Kesinlikle ≥ 0 olmalı. Analitik pencereyi değerlendirme zaman damgasından geriye kaydırır. Akışınızda kaynak varış gecikmesi için tutarlı bir temel modeli oluşturmak için kullanın SourceLateness.settling_delay . |
window_duration |
0 olmalıdır > |
start_time (isteğe bağlı) |
Özelliğin çıktı yayabileceği en erken olay-zaman sınırı. |
from databricks.feature_engineering.entities import RollingWindow
from datetime import timedelta

# Look back 7 days from evaluation time
window = RollingWindow(window_duration=timedelta(days=7))
Aşağıdaki kodu kullanarak gecikmeli bir sıralı pencere tanımlayın.
# Compute a 7-day value as of one day before the evaluation time
window = RollingWindow(
    window_duration=timedelta(days=7),
    delay=timedelta(days=1)
)
Sıralı pencere örnekleri
window_duration=timedelta(days=7): Bu, mevcut değerlendirme zamanında biten 7 günlük bir geri dönüş penceresi oluşturur. 7. Gün 14:00'teki bir etkinlik için, 0. Gün 14:00'ten başlayarak (ancak 7. Gün 14:00 dahil olmamak üzere) 7. Gün 14:00'e kadar olan tüm etkinlikler buna dahildir.window_duration=timedelta(hours=1), delay=timedelta(minutes=30): Bu, değerlendirme süresinden 30 dakika önce biten 1 saatlik bir geri dönüş penceresi oluşturur. Saat 15:00'te gerçekleşen bir etkinlik için, 13:30'dan 14:30'a kadar (14:30 dahil olmadan) tüm etkinlikleri içerir.
En yeni bir değerin tazeliğini sınırlamak için kullanın Last
En son değerin sadece sınırlı bir süre için geçerli olduğu zaman ile birleştirin LastRollingWindow . Bir değerlendirme zamanında, özellik bu aralıktaki en son zaman damgasına sahip satırdan değeri döndürür:
[evaluation_time - delay - window_duration, evaluation_time - delay)
Aralıktaki en son satırda null değer varsa, özellik null döner. Null giriş değerlerini hariç tutmak istiyorsanız, kaynağa a filter_condition ayarlayın.
Bu kombinasyon 'dan farklıdır ColumnSelection.
ColumnSelection yaşa bağlı olarak son gözlemlenen null olmayan değeri süresi dolmadan döndürür.
Toplu özellikler için, bu kombinasyonun özel bir çevrimiçi materyalizasyon modu vardır. Yalnızca DeltaTableSource, Last, RollingWindow, ve TableTrigger.
Bkz. Tazelik sınırlı en son değerleri Maddeleştir.
Atlayan pencere
Sabit pencereler kullanılarak tanımlanan özellikler için toplamalar, bir kaydırma aralığı ile ilerlerken, zamanı tam olarak bölen ve örtüşmeyen pencereler üreten, önceden belirlenmiş sabit uzunluklu bir pencere üzerinden hesaplanır. Sonuç olarak, kaynaktaki her olay tam olarak bir pencereye katkıda bulunur.
t zamanındaki özellikler, t veya öncesinde biten pencerelerden gelen verileri (hariç) toplar. Windows, Unix dönemiyle başlar.
class TumblingWindow(TimeWindow):
    window_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    offset: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
Aşağıdaki tabloda dönmeli pencerenin parametreleri listeleniyor.
| Parametre | Sınırlamalar |
|---|---|
window_duration |
0 olmalıdır > |
delay (isteğe bağlı) |
Kesinlikle ≥ 0 olmalı. Analitik pencereyi değerlendirme zaman damgasından geriye kaydırır. |
offset (isteğe bağlı) |
0 ≥ ve daha kısa window_durationolmalı. Pencere sınırlarını gece yarısından itibaren UTC'den itibaren değiştiriyor. |
start_time (isteğe bağlı) |
Özelliğin çıktı yayabileceği en erken olay-zaman sınırı. |
from databricks.feature_engineering.entities import TumblingWindow
from datetime import timedelta

window = TumblingWindow(
    window_duration=timedelta(days=1),
    delay=timedelta(hours=2),
    offset=timedelta(hours=22),
)
Atlayan pencere örneği
-
window_duration=timedelta(days=5): Bu, her biri 5 günlük önceden belirlenmiş sabit uzunluklu pencereler oluşturur. Örnek: Pencere #1, 0. Günü 4. Güne, Pencere #2 5. Günü 9. Güne, Pencere #3 ise 10. Günü 14. Güne yayıyor vb. Özellikle, Pencere #1, 0. Gün'de00:00:00.00zaman damgasıyla başlayan ve 5. Gün'de00:00:00.00zaman damgasına kadar olan (ancak bu00:00:00.00damgasına sahip olanlar hariç) tüm olayları içerir. Her olay tam olarak bir pencereye aittir.
Kayan pencere
Kaydıran pencereler kullanılarak tanımlanan özellikler için, toplamalar bir slayt aralığı ilerleyen bir pencere üzerinde hesaplanır. Bir kaydırma pencere sabit bir süreye veya ömür boyu olabilir. Sabit süreli pencereler örtüşüyor, bu yüzden her kaynak olay birden fazla pencere için özellik toplamaya katkıda bulunabilir. Ömür boyu bir pencere, pencere bitmeden önceki tüm kaynak olayları içerir.
t zamanındaki özellikler, t veya öncesinde biten pencerelerden gelen verileri (hariç) toplar. Windows, Unix dönemine hizalanmıştır.
class SlidingWindow(TimeWindow):
    window_duration: Optional[datetime.timedelta]
    slide_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    offset: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
Aşağıdaki tabloda kayan pencere için parametreler listelemektedir.
| Parametre | Sınırlamalar |
|---|---|
window_duration |
Sabit süreli bir pencere için pozitif olmalı. Ömür boyu bir süre için ayarlandı None . |
slide_duration |
Pozitif olmalı. Sabit süreli bir pencere için ayrıca daha kısa window_durationolmalıdır. |
delay (isteğe bağlı) |
Kesinlikle ≥ 0 olmalı. Analitik pencereyi değerlendirme zaman damgasından geriye kaydırır. |
offset (isteğe bağlı) |
0 ≥ ve daha kısa slide_durationolmalı. Pencere sınırlarını gece yarısından itibaren UTC'den itibaren değiştiriyor. |
start_time (isteğe bağlı) |
Özelliğin çıktı yayabileceği en erken olay-zaman sınırı. |
from databricks.feature_engineering.entities import SlidingWindow
from datetime import timedelta

window = SlidingWindow(
    window_duration=timedelta(days=7),
    slide_duration=timedelta(days=1),
    delay=timedelta(hours=2),
    offset=timedelta(hours=22),
)
Kayan pencere örneği
-
window_duration=timedelta(days=5), slide_duration=timedelta(days=1): Bu, her seferinde 1 gün ilerleyen örtüşen 5 günlük pencereler oluşturur. Örnek: Pencere #1, 0. Günü 4. Güne, Pencere #2 1. Günü 5. Güne, Pencere #3 ise 2. Günü 6. Güne yayıyor vb. Her bir pencerede başlangıç gününden bitiş günü hariç olmak üzere00:00:00.00'dan00:00:00.00'e kadar olan olaylar bulunur. Pencereler çakıştığı için tek bir olay birden çok pencereye ait olabilir (bu örnekte, her olay en fazla 5 farklı pencereye aittir).
Yaşam süresi aralığı
Ömür boyu bir pencere yaratmak için ayarlandı window_duration=None . Her slayt sınırında, özellik, varlık için tüm kaynak olayları ve bu sınırdan önceki zaman damgaları ile toplar. Örneğin, bir günlük bir slayt günde bir kez kümülatif değer üretir.
Ömür pencereleri yalnızca .SlidingWindow
RollingWindow ve TumblingWindow sonlu bir window_duration. gerektirir.
Note
Ömür boyu pencereler, çalışma alanı etkinleştirmesini destekleyen window_duration=None bir databricks-feature-engineering istemci sürümü gerektirir. Önceki istemci sürümleri bu sözdizimi desteklemez.
from datetime import timedelta
from databricks.feature_engineering.entities import (
    AggregationFunction,
    DeltaTableSource,
    Feature,
    SlidingWindow,
    Sum,
)

lifetime_spend = Feature(
    source=DeltaTableSource(
        catalog_name="main",
        schema_name="store",
        table_name="transactions",
    ),
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(
        Sum(input="amount"),
        SlidingWindow(
            window_duration=None,
            slide_duration=timedelta(days=1),
        ),
    ),
    name="lifetime_spend",
)
Testere dişi pencere
Testere dişi penceresi, güncel olaylar için son derece taze güncellemeleri ve tarihsel verilerin günlük sıkıştırmasını destekleyen bir topluluktur. Arka (eski) kenarı sabit, günlük adımlarla ilerlerken, öndeki (son) kenar en güncel olaylarla güncel kalır, böylece etkili pencere uzunluğu her gün boyunca "testere" alır. Pencerenin çoğu Akış'ın alım tablosundaki verilerden sağlanır ve sadece en son iki gün canlı yayından gelir. Bu, uzun süreli pencereleri (yıllara ölçeklendirme) verimli bir şekilde hesaplayan ve taze güncellemelere duyarlı kalan bir uzlaşmadır.
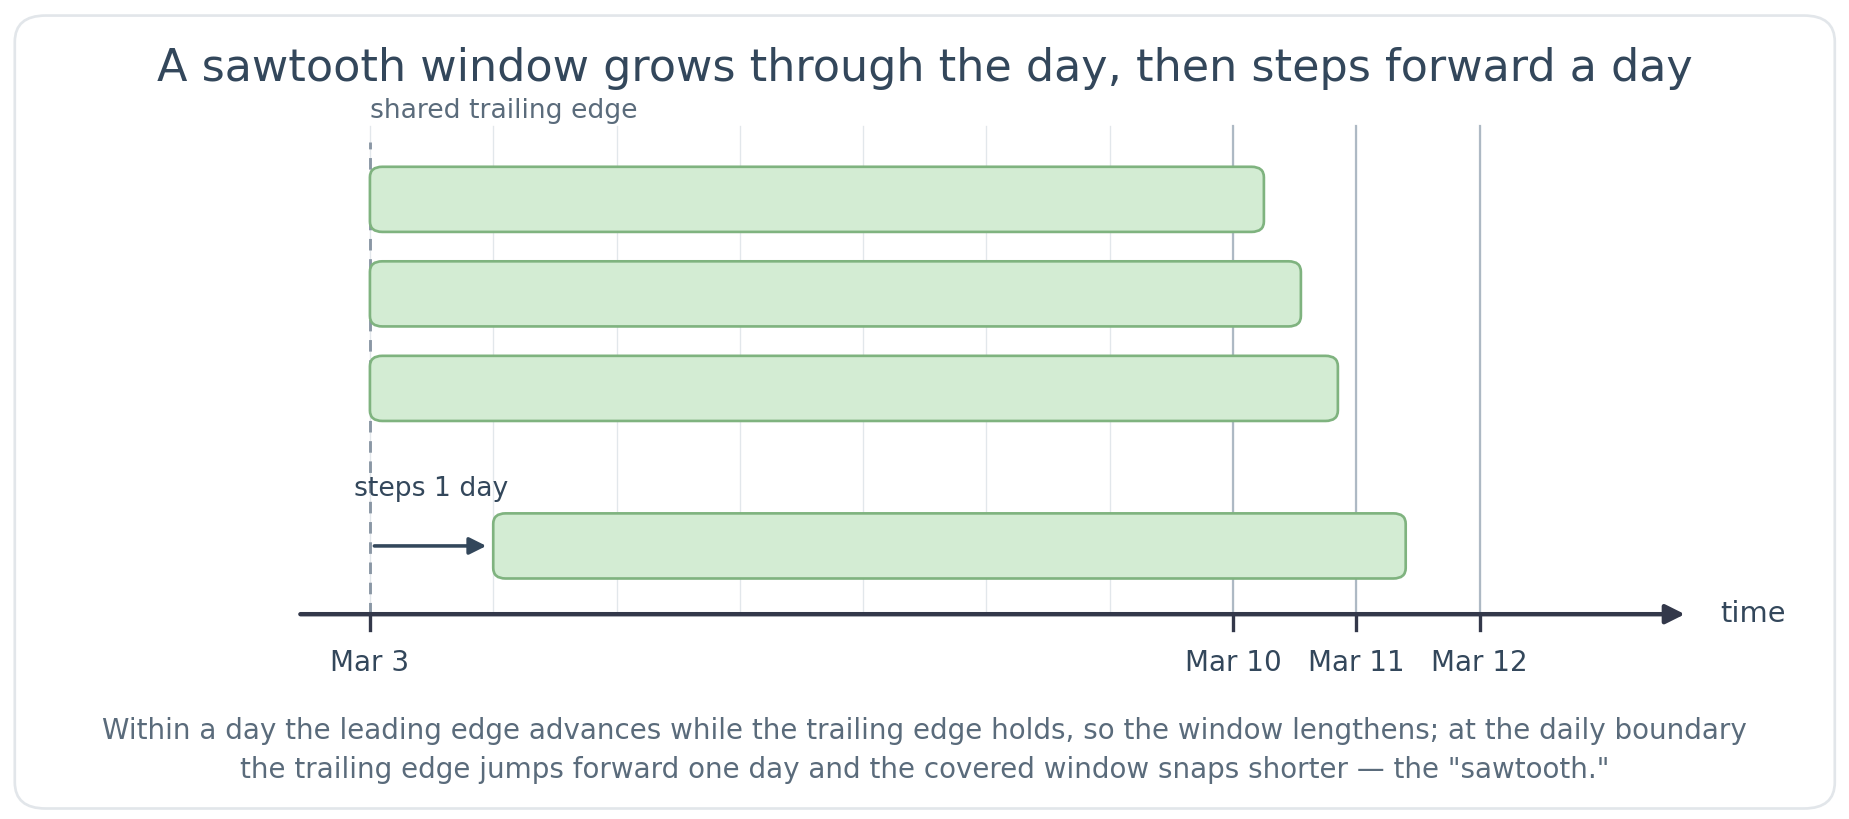
Testere dişi pencereler, hibrit parti ve akış yolu üzerinde ortaya çıkar. Bir toplu boru hattı pencerenin büyük kısmını korurken, akış boru hattı en güncel verileri gerçek zamanlı taze tutar. İkisi okuma sırasında birleştirilir, yani model veya hizmet veren tüketici için tek bir özelliktir.
Pencerenin tarihi kısmı parti boru hattı tarafından hesaplandığı için, testere dişli bir özellik, pencere aylar veya yıllar sürse bile, materyalleşme başladıktan kısa bir süre sonra hizmet vermeye hazırdır. Bir yuvarlanan pencere, ancak tam pencere süresi dolduktan sonra tamamlanır. Minimum window_duration süre iki günden (zorunlu alt sınır) fazla olmalıdır. Databricks, 7 günden uzun süreler için testere dişli pencere öneriyor. İki günden uzun ve yedi güne kadar olan pencereler için, yuvarlama pencerenin sabit uzunluktaki hassasiyeti ile testere dişi pencerenin daha hızlı üretim hazırlığı arasında seçim yapabilirsiniz.
Note
Bir testere dişi özelliği, zaten var olan tarihe dayanır. Akış'ın alım tablosu en azından tam pencere süresini kapsayan verileri içermelidir, aksi takdirde hesaplanan pencere eksik olur. Eğer olmazsa, start_time özelliğin değer sunmasını istediğiniz en erken zamana, yani özelliği oluşturduğunuz zamana kadar ayarlayın. Değerler start_time o noktadaki mevcut geçmişi kapsar. İki tam gün geçmeden önce, özellik sadece şimdiye kadar gerçekleşen verileri yansıtıyor. Filmi 2 tam gün geçene kadar yapımda gösterme. Boş bir pencere üzerinde yapılan bir agregasyon, ve için Sum 0, , , First, StddevPopVarSampVarPopLast, , ve StddevSampiçin null AvgMaxMindöner.Count
Bir testere dişi özelliğinin hazır olup olmadığını anlamak için Katalog Gezgin'de Özellik Görünümü'nü açın. Maddeleştirilmiş özellikler bölümünde, özelliğin son maddeleştirme süresi geçtikten ve durumu başarı gösterdiğinde toplu geri doldurma işlemi tamamlanır. Akış kısmı, Lakeflow deklaratif boru hattı ile gerçekleşir. Özellik Görünümü doğrulamadan geçtikten sonra, maddeleşen özellik o boru hattına bağlanır ve burada çalışma durumunu izleyebilirsiniz.
Testere dişli pencereler için bir StreamSource gereklidir ve .StreamingMode
class SawtoothWindow(TimeWindow):
    window_duration: datetime.timedelta
    start_time: Optional[datetime.datetime] = None
Testere dişli pencerenin kenarları, yuvarlanan pencereden farklı hareket eder: ön kenar en son olayı takip ederken, arka kenar sürekli değil, günde bir kez ilerler. Her gün sabit 18:00 UTC sınırında, arka kenar o günün UTC-gece yarısı sınırına doğru ilerler. Sonuç olarak, etkili pencere biraz daha uzun window_duration olur ve gün boyunca büyür, ardından bir sonraki sınırda tekrar kırılır. Eğitim ve servis aynı 18:00 UTC sınırını kullanıyor, bu yüzden çevrimdışı eğitim ve çevrimiçi servis tutarlı kalıyor.
| Parametre | Sınırlamalar |
|---|---|
window_duration |
İki günden fazla olmalı. Tam gün sayısı olmayan bir süre (örneğin, timedelta(days=3, minutes=15)) izin verilir, ancak pencere günlük ayrıntı aralığında güncellenir. |
start_time (isteğe bağlı) |
Özellik oluşturulma zamanından daha geç olmamalıdır. |
Akışın tüketim tablosunun tarih sayısından window_durationdaha az olduğu zamanlarda start_time ayarlanır. Onsuz, toplu üretim hattı tam bir tarih penceresi olana kadar bekler. Özelliğin değerlere hizmet etmesini en erken zamana ayarlayın. Değer, pencerede zaten bulunan verilere bağlı değildir. Bu özellik, kısmi pencere değerlerini ve start_time yeterince tarih biriktikten sonra tam pencere süresine ulaşır.
Testere dişi penceresini start_time , özelliği oluşturduğunuz zamandan daha geç ayarlayamazsınız.
start_time Pencerenin sadece parti kısmını kaplar, bu yüzden daha sonraki bir değer, akış kısmının değerlerini öncesine start_timeservis etmesine izin verir.
Testere dişli pencereler, , Avg, Count, MinFirstNLastMaxLastNStddevPopFirstDistinctLastDistinctVarPopFirstVarSampveStddevSamp agregasyon fonksiyonlarını destekler.Sum
Testere dişi pencere örneği
Aşağıdaki örnek, bir kullanıcının işlemlerinin 7 günlük sayısını göstermektedir. Öndeki kenar mevcut olayı takip ederken, arka kenar gün bir gün ileri adım atıyor. 10 Mart'taki etkinlikler için bu pencere yaklaşık 3 Mart'a kadar uzanıyor. 10 Mart ilerledikçe, ön kenar ilerlemeye devam ederken arka kenar tutar, böylece kapalı açıklık büyür. Sonra, 11 Mart başında, arka kenar yaklaşık 4 Mart'a kadar ilerler. Etkili pencere her zaman yedi günden biraz daha uzun olur. Son iki gün canlı yayından servis edilirken, önceki günler ise Stream'in tüketim masasından servis edilir.
from databricks.feature_engineering.entities import SawtoothWindow
from datetime import timedelta

# 7-day window kept continuously fresh with streaming data
window = SawtoothWindow(window_duration=timedelta(days=7))
Aşağıdaki örnek, verileri 1 Ocak 2026'da başlayan bir tüketim tablosu üzerinden 365 günlük bir toplamdır.
start_time 1 Ocak 2026 olarak belirlenen bu özellik, o günden itibaren kısmi pencere değerlerini sunar ve 1 Ocak 2027'den itibaren tam bir yılı kapsar:
from datetime import datetime, timedelta
from databricks.feature_engineering.entities import SawtoothWindow

window = SawtoothWindow(
    window_duration=timedelta(days=365),
    start_time=datetime(2026, 1, 1),
)
Testere dişi pencere sınırlamaları
-
delayparametresi desteklenmiyor. -
SourceLateness.settling_delaydesteklenmiyor. - Özelliği oluşturduğunuz zamandan daha geç
start_timebir süre ayarlayamazsınız. - ,
Avg,Count,Min,Max,LastFirstFirstNVarPopStddevPopFirstDistinctLastDistinctVarSampLastNveStddevSampdışındaki toplama fonksiyonlarıSumdesteklenmez (örneğin,ApproxCountDistinctve ).ApproxPercentile - Testere dişi pencereler için bir
StreamSource. ADeltaTableSourcedesteklenmiyor.
Gerçekleştirme tetikleyicileri
Bir gerçekleştirme işlem hattı çalıştırıldığında denetimi tetikler. Tetikleyici türü özellik türüne bağlıdır.
CronSchedule
Toplu toplama özellikleri için kullanım CronSchedule . Varsayılan olarak, Azure Databricks bir zaman çizelgesini toplama penceresinden türetir. Türetilmiş bir zamanlama, pencere periyotu, pencere delay ve offset, ve kaynağı settling_delay hesaba katır; böylece bir çalıştırma penceresi kaynak verisi tamamlanmadan önce yayınlanmaz. Türetilen programlar yuvarlanan ve kaydırmalı pencereleri destekler.
Türetilmiş bir zaman çizelgesi talep etmek için cron ifadesini çıkarın.
CronSchedule() ve açık CronSchedule(mode=CronScheduleMode.DERIVED) biçim eşdeğerdir:
from databricks.feature_engineering.entities import (
    CronSchedule,
    CronScheduleMode,
)

trigger = CronSchedule(mode=CronScheduleMode.DERIVED)
Ayarlarla CronScheduleMode.DERIVEDayarlamayınquartz_cron_expression. Elde edilen özelliği aldığınızda, geri dönen zamanlama Azure Databricks'in hesapladığı cron ifadesini içerebilir.
Programı doğrudan kontrol etmek için bir Quartz cron ifadesi sağlayın.
CronScheduleMode.MANUAL bir ifade verdiğinizde çıkarıldığı bir ifade:
from databricks.feature_engineering.entities import CronSchedule

trigger = CronSchedule(
    quartz_cron_expression="0 0 * * * ?",  # Hourly
    timezone_id="UTC",
)
TableTrigger
TableTrigger
ColumnSelection Özellikler veya toplama özellikleri için kullanımAggregationFunction () a DeltaTableSource veya bir SdpSourceile desteklenen. Bir DeltaTableSourceiçin , boru hattı yukarı akış Delta tablosu yeni bir commit aldığında çalışır.
Toplama özellikleri için, pipeline her commit'te çalışmaması için kısıtlanmıştır. Varsayılan olarak, çalışma arasındaki süre, özelliğin pencere uzunluğunun ( slide_duration kayan pencere veya window_duration yuvarlanan pencere uzunluğu) en az yarısıdır ve 5 dakika ile 1 saat arasında tutulur. Örneğin, 1 saatlik yuvarlama penceresi olan bir özellik en fazla her 30 dakikada bir çalışırken, 8 saatlik pencereli bir özellik en fazla her saat başlar. Bunu değiştirmek için min_time_between_triggersayarlayın. 5 dakikalık kat, pencerenin yarısı bundan küçük olduğunda geçerlidir, yani 10 dakika veya daha kısa pencereler en fazla her 5 dakikada bir açılır. Penceresi 5 dakikadan TableTriggerkısa olan toplama özellikleri için , bir akış tetikleyicisi kullanılır.
from databricks.feature_engineering.entities import TableTrigger

trigger = TableTrigger()
Bir SdpSourceözellik ile desteklenen durumlarda, TableTrigger çıktı tablosu yerine kaynağı input_tables izler. Aynı çıkış tablosunda ve tek bir çağrıda ortaya çıkardığınız tetikleyici özellikler, hepsini izleyen bir işi input_tables paylaşır, toplamda 25 tabloya kadar. 10'dan fazla tabloyu izlemek için, izlenen her tabloda dosya olaylarını etkinleştirin.
Tabloların tetik limitine nasıl dahil edildiğine bakınız. Her çalışma, pipeline'ı özellikler ortaya çıkmadan önce güncelliyor.
Çalışmaların ne zaman başladığını kontrol etmek için aşağıdaki isteğe bağlı parametreleri ayarlayın:
TableTrigger(
    min_time_between_triggers: Optional[timedelta] = None,     # Optional: Shortest gap between two runs
    wait_after_last_change: Optional[timedelta] = None,        # Optional: Quiet period after the last update before a run starts
    condition: Optional[TableTriggerCondition] = None,         # Optional: Which table updates start a run
)
-
min_time_between_triggers: İki koşu arasında izin verilen en kısa süre. En az 5 dakika olmalı. Ayarlanmadıysa, kaydıran pencere özelliklerislide_durationyarısını kullanırken, yuvarlanan pencere özellikleri ise 5 dakika ile 1 saat arasında tutulan yarısınıwindow_durationkullanır. Diğer özelliklerin minimum özelliği yok. -
wait_after_last_change: Bir çalışma başlamadan önce kaynak tabloların güncelleme olmadan ne kadar süre kalması gerektiği, böylece bir dizi güncelleme önce gelir. Sıfır ya da en az 60 saniye olmalı. Ayarlanmadıysa veya sıfır değilse, bir kaynak tablo güncellenir güncellenmez bir çalışma başlar. -
condition:TableTriggerCondition.TABLE_TRIGGER_CONDITION_ANY_UPDATED(varsayılan) herhangi bir kaynak tablo güncellendiğinde bir çalışma başlatır.TableTriggerCondition.TABLE_TRIGGER_CONDITION_ALL_UPDATEDBir çalışma sadece her kaynak tablo güncellendikten sonra başlatılır.
Aşağıdaki örnek, tüm giriş tablolarının güncellenmesini bekler, ardından ek güncellemeler için 10 dakika bekler ve en fazla her saat çalıştırılır:
from datetime import timedelta
from databricks.feature_engineering.entities import TableTrigger, TableTriggerCondition

trigger = TableTrigger(
    condition=TableTriggerCondition.TABLE_TRIGGER_CONDITION_ALL_UPDATED,
    wait_after_last_change=timedelta(minutes=10),
    min_time_between_triggers=timedelta(hours=1),
)
StreamingMode
Sonuçları doğrudan çevrimiçi mağazaya yazan sürekli Yapılandırılmış Akış boru hattıyla özellikleri hesaplamak için kullanılır StreamingMode . Bir StreamSourceile desteklenen özellikler için gereklidir ve ayrıca bir DeltaTableSourceile desteklenen özellikler için de kullanılabilir.
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import (
    StreamSource, Feature, AggregationFunction, Sum,
    RollingWindow, OnlineStoreConfig, StreamingMode,
)
from datetime import timedelta

fe = FeatureEngineeringClient()

stream_source = StreamSource(full_name="my_catalog.my_schema.my_stream")

streaming_feature = fe.create_feature(
    source=stream_source,
    entity=["value.user_id"],
    timeseries_column="value.event_time",
    function=AggregationFunction(
        operator=Sum(input="value.amount"),
        time_window=RollingWindow(window_duration=timedelta(hours=1)),
    ),
    catalog_name="my_catalog",
    schema_name="my_schema",
    name="user_purchase_sum",
)

fe.materialize_features(
    features=[streaming_feature],
    online_config=OnlineStoreConfig(
        catalog_name="my_catalog",
        schema_name="my_schema",
        table_name_prefix="streaming_features_serving",
        online_store_name="feature_store_online",
    ),
    trigger=StreamingMode(),
)
Bir DeltaTableSource
StreamingMode() Bir DeltaTableSourceözellik için desteklendiğinde, boru hattı tablonun değişiklik veri akışını planlanmış toplu iş olarak çalışmak yerine akış kaynağı olarak okur. Mikro-toplu modda çalışır; yeni commit'leri küçük partiler halinde işliyor. Örneğin, DeltaTableSource kullanarak bir akış özelliğini tanımla.
Aşağıdaki gereksinimler ve davranışlar geçerlidir:
- Kaynak tabloda Change Data Feed'in etkin (
delta.enableChangeDataFeed = true) olması gerekir. Boru hattı bu özelliği başlattığında kontrol eder ve ayarlanmamışsa başarısız olur. -
ColumnSelectionARollingWindowile Awindow_durationkullanan özellikler ve toplama özellikleri desteklenir. Yayın özellikleri için yuvarlanma, kayma ve testere dişli pencereler desteklenmemektedirDeltaTableSource. - Maddeleştirme, tablonun en son sürümünden başlar ve tabloda zaten var olan satırları işlemez. Tam bir yeni veri penceresi gelene kadar,
RollingWindowdeğerler yalnızca boru hattı başladıktan sonra taahhüt edilen verileri yansıtır. - Eklenen ve güncellenen satırlar özellik değerlerine katkıda bulunur. Kaynak tablodan satır silmek, onları zaten toplanmış değerlerden kaldırmaz.
- Bir
online_configsağlamalısınız. Yayın özellikleri yalnızca çevrimiçi mağazada sunuluyor.
Tetikleyici seçme
Her özellik bir tetikleyici kullanır; Özellik türüne göre seçenekler şunlardır:
| Özellik türü | Trigger | Çalıştığında |
|---|---|---|
Toplama (AggregationFunction) DeltaTableSource |
CronSchedule |
Türevli veya manuel bir programda |
Toplama (AggregationFunction) DeltaTableSource |
TableTrigger |
Her kaynak tablo işlemesinde |
ColumnSelection (from DeltaTableSource) |
TableTrigger |
Her kaynak tablo işlemesinde |
Toplama (AggregationFunction) SdpSource |
CronSchedule |
Türevli veya manuel bir programda |
Toplama veya ColumnSelectionSdpSource |
TableTrigger |
Güncellemeler hakkında input_tables |
Özellikler: StreamSource |
StreamingMode |
Sürekli akış |
RollingWindowtoplama veya ColumnSelectionDeltaTableSource |
StreamingMode |
Sürekli akış (mikro-parti) |
Bir materialize_features çağrı, SdpSource farklı tetikleyicilere sahip toplu özellikler, DeltaTableSource farklı boru hatlarından özellikler ve SdpSource özellikler içerebilir. Her kaynak, boru hattı ve program kendi işini üstlenir. Kullanan StreamingMode özellikler ayrı bir çağrı gerektirir.