Değerlendirme, aracınız için bir kalite temeli oluşturur ve kullanıcılara değişiklik yayınlamadan önce görev bağlılık geçirme oranı gibi kabul eşiklerini ayarlamanıza olanak tanır.
Her adım beş yol sunar. Hangisini tercih ederseniz onu kullanın:
Değerlendirme, dağıtılmış ve çağrılabilir bir ajana karşı çalıştırılır. Değerlendirmeyi yapılandırmadan önce aracınızın dağıtıldığını ve kullanıma hazır olduğunu doğrulayın.
Proje dizininizden azd aracının dağıtıldığından ve çağrılanabildiğinden emin olun:
azd ai agent show
Bir test istemi gönderin:
azd ai agent invoke "Write a haiku about deploying cloud applications."
Birkaç saniye içinde bir yanıt görmeniz gerekir.
-
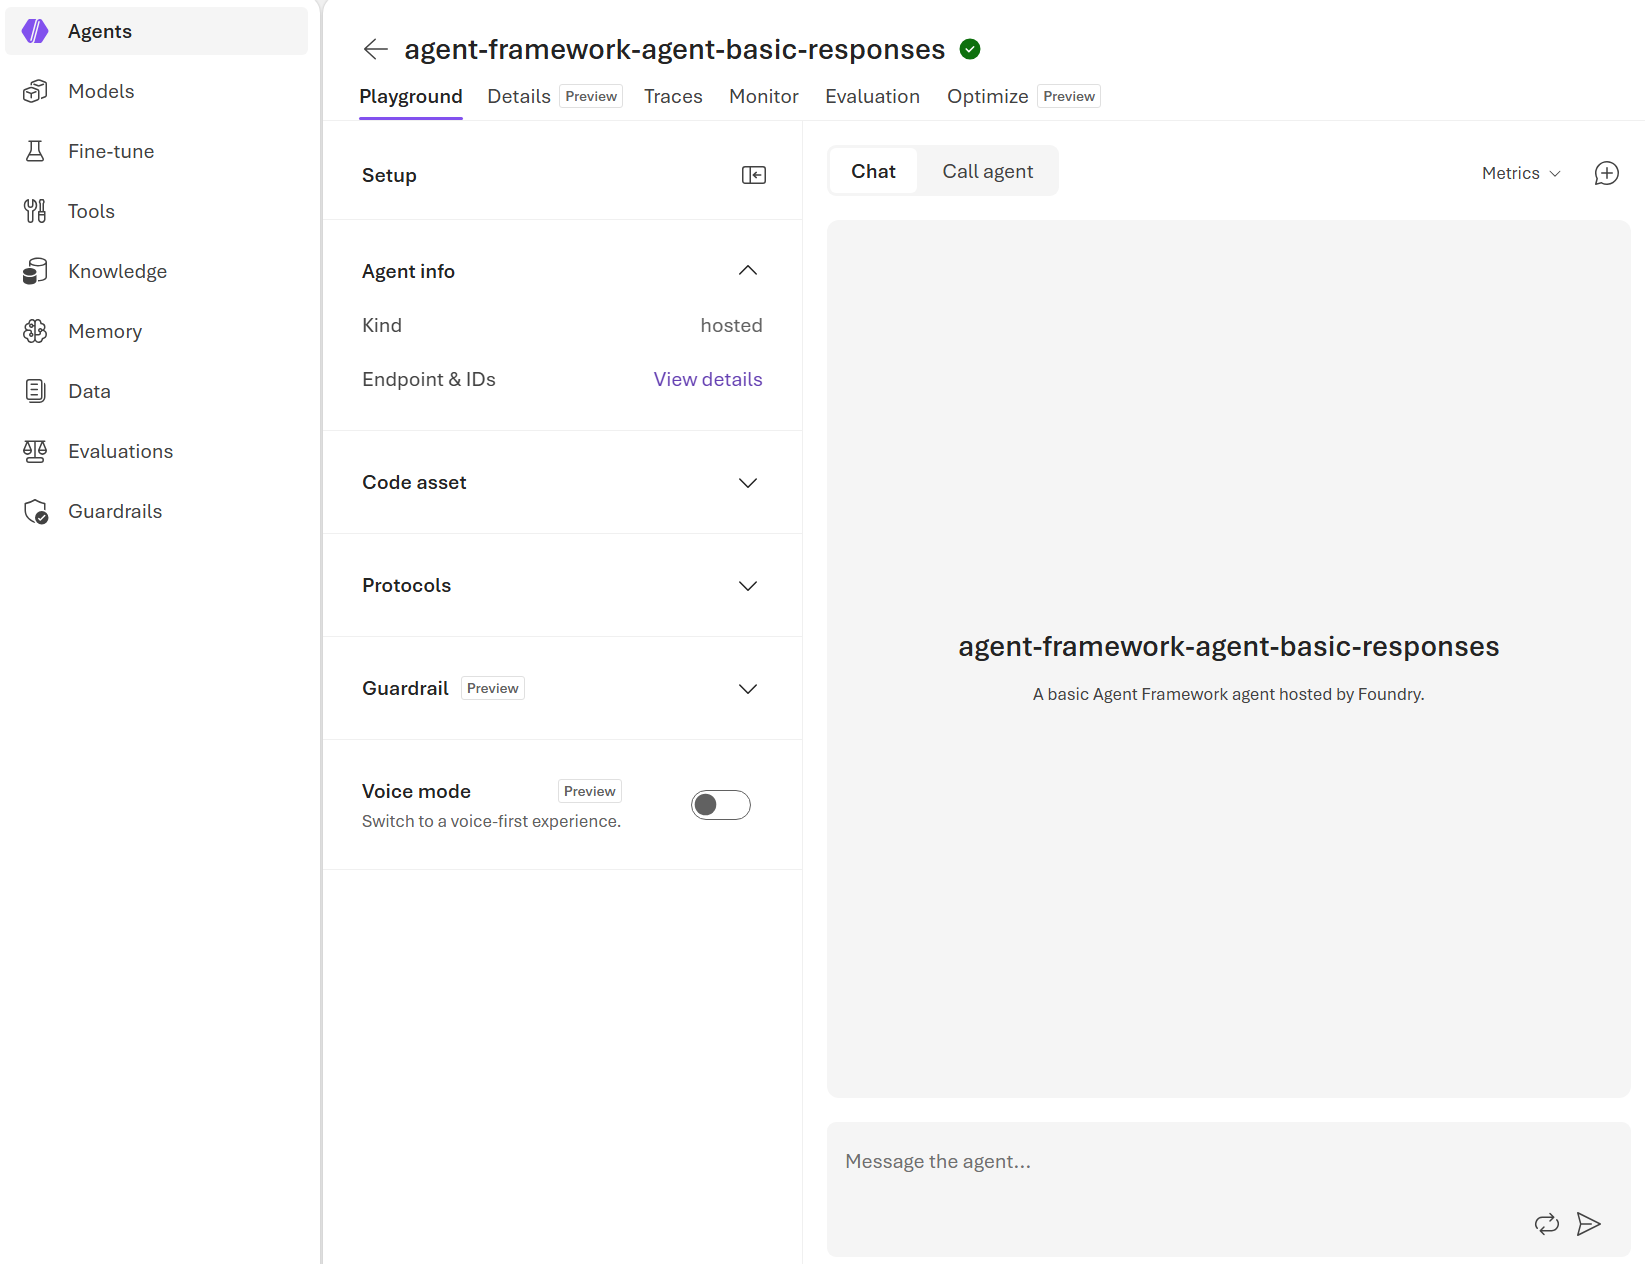
Foundry portalını açın ve projenize gidin.
- Temsilcinizi seçin ve ardından Oyun Alanı sekmesini seçin.
- Örneğin, bir test istemi gönderme
Write a haiku about deploying cloud applications.
Birkaç saniye içinde bir yanıt görmeniz gerekir.
Foundry SDK'sını yükleyin:
pip install "azure-ai-projects>=2.0.0" azure-identity
İki ortam değişkeni ayarlayın ve proje istemcisini oluşturun.
FOUNDRY_PROJECT_ENDPOINT değerini proje uç noktanıza, FOUNDRY_MODEL_NAME değerini ise yargıç model olarak kullanılacak bir sohbet tamamlama dağıtımına ayarlayın. Aşağıdaki kod örnekleri, bunları bu bağlamda çalıştırdığınızı varsayar:
import os
from azure.identity import DefaultAzureCredential
from azure.ai.projects import AIProjectClient

endpoint = os.environ["FOUNDRY_PROJECT_ENDPOINT"]
model_deployment = os.environ["FOUNDRY_MODEL_NAME"]

credential = DefaultAzureCredential()
project_client = AIProjectClient(endpoint=endpoint, credential=credential)
client = project_client.get_openai_client()
Dağıtılan aracınızın kayıtlı ve kullanılabilir olduğunu onaylayın.
<your-agent-name> öğesini barındırdığınız aracının adıyla değiştirin:
agent = project_client.agents.get("<your-agent-name>")
print(f"Found agent: {agent.name}")
Çağrı, varsa ajanı döndürür; ad geçersizse veya ajan dağıtıma alınmamışsa hata verir.
Foundry SDK'sını ve OpenAI değerlendirmeleri istemcisini yükleyin:
dotnet add package Azure.AI.Projects --prerelease
dotnet add package OpenAI
dotnet add package Azure.Identity
İki ortam değişkeni ayarlayın ve ardından istemcileri oluşturun.
FOUNDRY_PROJECT_ENDPOINT değerini proje uç noktanıza, FOUNDRY_MODEL_NAME değerini ise yargıç model olarak kullanılacak bir sohbet tamamlama dağıtımına ayarlayın. Aşağıdaki kod örnekleri, bunları bu bağlamda çalıştırdığınızı varsayar:
using System.ClientModel;
using System.Text.Json;
using Azure.AI.Projects;
using Azure.AI.Projects.Agents;
using Azure.Core;
using Azure.Identity;
using OpenAI;
using OpenAI.Evals;

#pragma warning disable AAIP001, OPENAI001

var endpoint = Environment.GetEnvironmentVariable("FOUNDRY_PROJECT_ENDPOINT")!;
var modelDeployment = Environment.GetEnvironmentVariable("FOUNDRY_MODEL_NAME")!;

var credential = new DefaultAzureCredential();
AIProjectClient projectClient = new(new Uri(endpoint), credential);

// OpenAI-compatible evals client bound to the Foundry project endpoint.
// A Microsoft Entra token works as the credential because both use "Authorization: Bearer".
var token = credential.GetToken(new TokenRequestContext(["https://ai.azure.com/.default"])).Token;
EvaluationClient evalClient = new(
    new ApiKeyCredential(token),
    new OpenAIClientOptions { Endpoint = new Uri($"{endpoint}/openai/v1") });
Dağıtılan aracınızın kayıtlı ve kullanılabilir olduğunu onaylayın.
<your-agent-name> öğesini barındırdığınız aracının adıyla değiştirin:
ProjectsAgentRecord agent = projectClient.AgentAdministrationClient.GetAgent("<your-agent-name>");
Console.WriteLine($"Found agent: {agent.Name}");
Çağrı, varsa ajanı döndürür; ad geçersizse veya ajan dağıtıma alınmamışsa hata verir.
Foundry SDK'sını yükleyin:
npm install @azure/ai-projects @azure/identity dotenv
İki ortam değişkeni ayarlayın ve proje istemcisini oluşturun.
FOUNDRY_PROJECT_ENDPOINT değerini proje uç noktanıza, FOUNDRY_MODEL_NAME değerini ise yargıç model olarak kullanılacak bir sohbet tamamlama dağıtımına ayarlayın. Aşağıdaki kod örnekleri, bunları bu bağlamda çalıştırdığınızı varsayar:
import { DefaultAzureCredential } from "@azure/identity";
import { AIProjectClient } from "@azure/ai-projects";
import "dotenv/config";

const endpoint = process.env["FOUNDRY_PROJECT_ENDPOINT"] || "";
const modelDeployment = process.env["FOUNDRY_MODEL_NAME"] || "";

const projectClient = new AIProjectClient(
  endpoint,
  new DefaultAzureCredential(),
);
const client = projectClient.getOpenAIClient();
Dağıtılan aracınızın kayıtlı ve kullanılabilir olduğunu onaylayın.
<your-agent-name> öğesini barındırdığınız aracının adıyla değiştirin:
const agent = await projectClient.agents.get("<your-agent-name>");
console.log(`Found agent: ${agent.name}`);
Çağrı, varsa ajanı döndürür; ad geçersizse veya ajan dağıtıma alınmamışsa hata verir.
Referans: AIProjectClient sınıfı
Ajanınızı bir test veri kümesine karşı puanlamak için yerleşik değerlendiricilerle başlayın.
İlk olarak, aracınız için test sorgularından oluşan bir JSONL dosyası oluşturun. Her satır, alanı olan bir query JSON nesnesidir. Ajanınızın kaynak klasörüne, src/<your-agent-name>/tests/queries.jsonl olarak kaydedin:
{"query": "Write a haiku about deploying cloud applications."}
Ardından, eval.yamlile aynı aracı kaynak klasöründe bir src/<your-agent-name>/eval.yaml dosya oluşturun. Veri kümenize işaret eder ve uygulanacak yerleşik değerlendiricileri listeler.
dataset.local_uri yolu bu klasöre görelidir.
<your-agent-name> öğesini barındırılan aracınızın adıyla ve <your-chat-completion-deployment> öğesini yargıç modeli dağıtımıyla değiştirin:
name: agent-eval
agent:
  name: <your-agent-name>
  kind: hosted
dataset:
  local_uri: tests/queries.jsonl
evaluators:
  - builtin.intent_resolution
  - builtin.task_adherence
options:
  eval_model: <your-chat-completion-deployment>
max_samples: 15
eval_model değeri, yanıtları puanlayan yargıç modelidir; aracınızın zaten kullandığı dağıtımı yeniden kullanabilirsiniz.
-
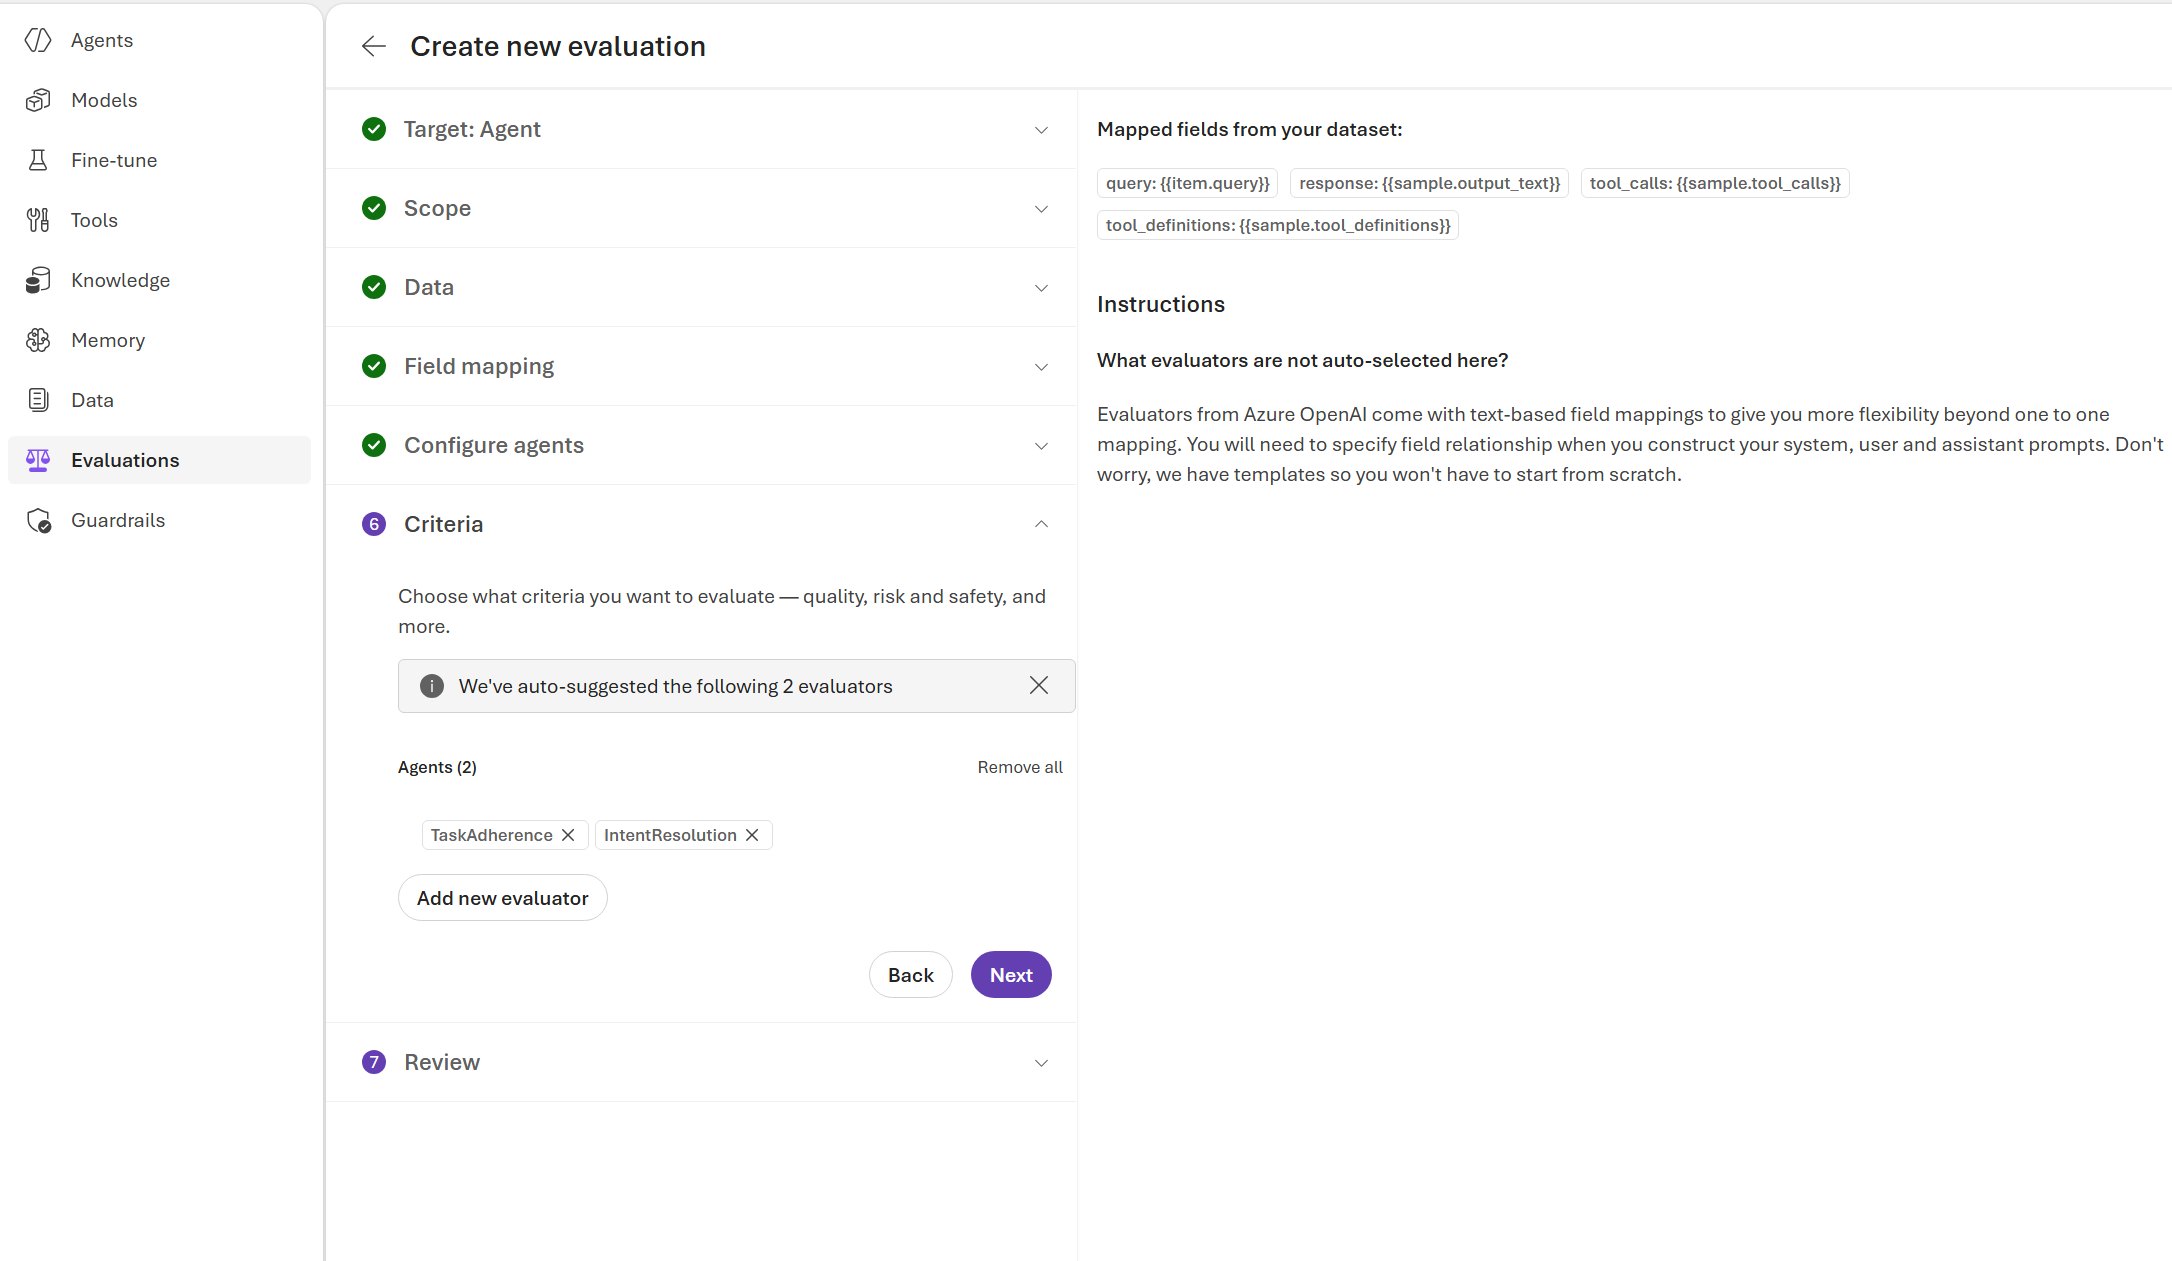
Foundry portalında ajanınızı açın ve Değerlendirme sekmesini seçin, ardından Oluştur'u seçin.
-
Değerlendirme hedefi seçin için Aracı'yı seçin.
-
Değerlendirme kapsamını seçin için Tek tek dönüşler seçeneğini belirleyin.
-
Veri kaynağı seç için Mevcut veri kümesi'ni seçin ve projenizin veri varlıklarından bir CSV veya JSONL test sorgusu dosyası seçin.
-
Aracıları yapılandır adımı görüntülenirse aracıyı gözden geçirin ve varsayılan kullanıcı istemini kabul edin.
{{item.query}} Yalnızca aracınız farklı bir giriş biçimi bekliyorsa ayarlayın.
-
Test ölçütlerini seçin içinGörev Bağlılığı ve Amaç Çözümlemesi gibi bir veya daha fazla aracı değerlendiricisini seçin.
Sihirbazı açık tutun. Değerlendirmeyi sonraki adımda gönderirsiniz.
İlk olarak, aracınız için test sorgularından oluşan bir JSONL dosyası oluşturun. Her satır, alanı olan bir query JSON nesnesidir.
queries.jsonl olarak kaydedin:
{"query": "Write a haiku about deploying cloud applications."}
Dosyayı projenizde veri kümesi olarak karşıya yükleyin:
dataset = project_client.datasets.upload_file(
    name="agent-test-queries",
    version="1",
    file_path="./queries.jsonl",
)
Ardından yerleşik değerlendiricileri seçin ve girişlerini eşleyin.
data_mapping parametresi her değerlendiriciye sorguyu ve aracı yanıtını nerede bulacağını söyler. Yapay zeka destekli değerlendiriciler, initialization_parameters içinde bir yargıç modeline ihtiyaç duyar; bu değer, projenizdeki bir sohbet tamamlama dağıtımı olmalıdır.
from azure.ai.projects.models import TestingCriterionAzureAIEvaluator

testing_criteria = [
    TestingCriterionAzureAIEvaluator(
        type="azure_ai_evaluator",
        name="Intent Resolution",
        evaluator_name="builtin.intent_resolution",
        initialization_parameters={"model": model_deployment},
        data_mapping={
            "query": "{{item.query}}",
            "response": "{{sample.output_items}}",
        },
    ),
    TestingCriterionAzureAIEvaluator(
        type="azure_ai_evaluator",
        name="Task Adherence",
        evaluator_name="builtin.task_adherence",
        initialization_parameters={"model": model_deployment},
        data_mapping={
            "query": "{{item.query}}",
            "response": "{{sample.output_items}}",
        },
    ),
]
Değerlendirmeyi oluşturun. Test verileri şemasını ve test ölçütlerini tanımlar ve bir veya daha fazla çalıştırma için kapsayıcı görevi görür:
from openai.types.eval_create_params import DataSourceConfigCustom

data_source_config = DataSourceConfigCustom(
    type="custom",
    item_schema={
        "type": "object",
        "properties": {"query": {"type": "string"}},
        "required": ["query"],
    },
    include_sample_schema=True,
)

evaluation = client.evals.create(
    name="Agent Quality Evaluation",
    data_source_config=data_source_config,
    testing_criteria=testing_criteria,
)
print(f"Evaluation created: {evaluation.id}")
İlk olarak, aracınız için test sorgularından oluşan bir JSONL dosyası oluşturun. Her satır, alanı olan bir query JSON nesnesidir.
queries.jsonl olarak kaydedin:
{"query": "Write a haiku about deploying cloud applications."}
Dosyayı projenizde veri kümesi olarak karşıya yükleyin:
AIProjectDataset dataset = projectClient.Datasets.UploadFile(
    name: "agent-test-queries",
    version: "1",
    filePath: "./queries.jsonl");
Ardından yerleşik değerlendiricileri seçin ve girişlerini eşleyin.
data_mapping parametresi her değerlendiriciye sorguyu ve aracı yanıtını nerede bulacağını söyler. Yapay zeka destekli değerlendiriciler, initialization_parameters içinde bir yargıç modeline ihtiyaç duyar; bu değer, projenizdeki bir sohbet tamamlama dağıtımı olmalıdır.
var testingCriteria = new object[]
{
    new
    {
        type = "azure_ai_evaluator",
        name = "Intent Resolution",
        evaluator_name = "builtin.intent_resolution",
        initialization_parameters = new { model = modelDeployment },
        data_mapping = new { query = "{{item.query}}", response = "{{sample.output_items}}" },
    },
    new
    {
        type = "azure_ai_evaluator",
        name = "Task Adherence",
        evaluator_name = "builtin.task_adherence",
        initialization_parameters = new { model = modelDeployment },
        data_mapping = new { query = "{{item.query}}", response = "{{sample.output_items}}" },
    },
};
Değerlendirmeyi oluşturun. Test verileri şemasını ve test ölçütlerini tanımlar ve bir veya daha fazla çalıştırma için kapsayıcı görevi görür:
var createEvaluation = new
{
    name = "Agent Quality Evaluation",
    data_source_config = new
    {
        type = "custom",
        item_schema = new
        {
            type = "object",
            properties = new { query = new { type = "string" } },
            required = new[] { "query" },
        },
        include_sample_schema = true,
    },
    testing_criteria = testingCriteria,
};

ClientResult evaluationResult = evalClient.CreateEvaluation(
    BinaryContent.Create(BinaryData.FromObjectAsJson(createEvaluation)));
string evaluationId = JsonDocument.Parse(evaluationResult.GetRawResponse().Content.ToString())
    .RootElement.GetProperty("id").GetString()!;
Console.WriteLine($"Evaluation created: {evaluationId}");
İlk olarak, aracınız için test sorgularından oluşan bir JSONL dosyası oluşturun. Her satır, alanı olan bir query JSON nesnesidir.
queries.jsonl olarak kaydedin:
{"query": "Write a haiku about deploying cloud applications."}
Dosyayı projenizde veri kümesi olarak karşıya yükleyin:
const dataset = await projectClient.datasets.uploadFile(
  "agent-test-queries",
  "1",
  "./queries.jsonl",
);
Ardından yerleşik değerlendiricileri seçin ve girişlerini eşleyin.
data_mapping parametresi her değerlendiriciye sorguyu ve aracı yanıtını nerede bulacağını söyler. Yapay zeka destekli değerlendiriciler, initialization_parameters içinde bir yargıç modeline ihtiyaç duyar; bu değer, projenizdeki bir sohbet tamamlama dağıtımı olmalıdır.
const testingCriteria = [
  {
    type: "azure_ai_evaluator",
    name: "Intent Resolution",
    evaluator_name: "builtin.intent_resolution",
    initialization_parameters: { model: modelDeployment },
    data_mapping: {
      query: "{{item.query}}",
      response: "{{sample.output_items}}",
    },
  },
  {
    type: "azure_ai_evaluator",
    name: "Task Adherence",
    evaluator_name: "builtin.task_adherence",
    initialization_parameters: { model: modelDeployment },
    data_mapping: {
      query: "{{item.query}}",
      response: "{{sample.output_items}}",
    },
  },
];
Değerlendirmeyi oluşturun. Test verileri şemasını ve test ölçütlerini tanımlar ve bir veya daha fazla çalıştırma için kapsayıcı görevi görür:
const dataSourceConfig = {
  type: "custom",
  item_schema: {
    type: "object",
    properties: { query: { type: "string" } },
    required: ["query"],
  },
  include_sample_schema: true,
};

const evaluation = await client.evals.create({
  name: "Agent Quality Evaluation",
  data_source_config: dataSourceConfig,
  testing_criteria: testingCriteria,
});
console.log(`Evaluation created: ${evaluation.id}`);
Test paketini dağıtıma alınmış aracınıza karşı çalıştırın. Hizmet her test sorgusunu aracıya gönderir, yanıtı yakalar ve seçtiğiniz değerlendiricilerle puanlar.
Değerlendirmeyi azd çalışma alanı kökünden çalıştırın:
azd ai agent eval run --config eval.yaml
Note
azd ai agent eval run, yolu geçerli dizine göre değil, --config altındaki aracınızın kaynak klasörüne göre çözümler (örneğin, src/).
eval.yaml öğesini ve local_uri’in işaret ettiği veri kümesini o klasörün içinde tutun.
komutu okur eval.yaml, her sorguyu aracınıza gönderir, yanıtları puanlar ve tamamlandığında bir özet yazdırır:
Eval run started
   Eval: eval_b36748dede424e4ba3f8e6c99ca2cf27
   Run:  evalrun_5f72ef189ad24790a32128e6f230b131
   (✓) Done  Eval run

Results:    1 total, 1 passed, 0 failed, 0 errored

Per-criteria results:
  intent_resolution: 1 passed, 0 failed, 0 errored
  task_adherence: 1 passed, 0 failed, 0 errored
-
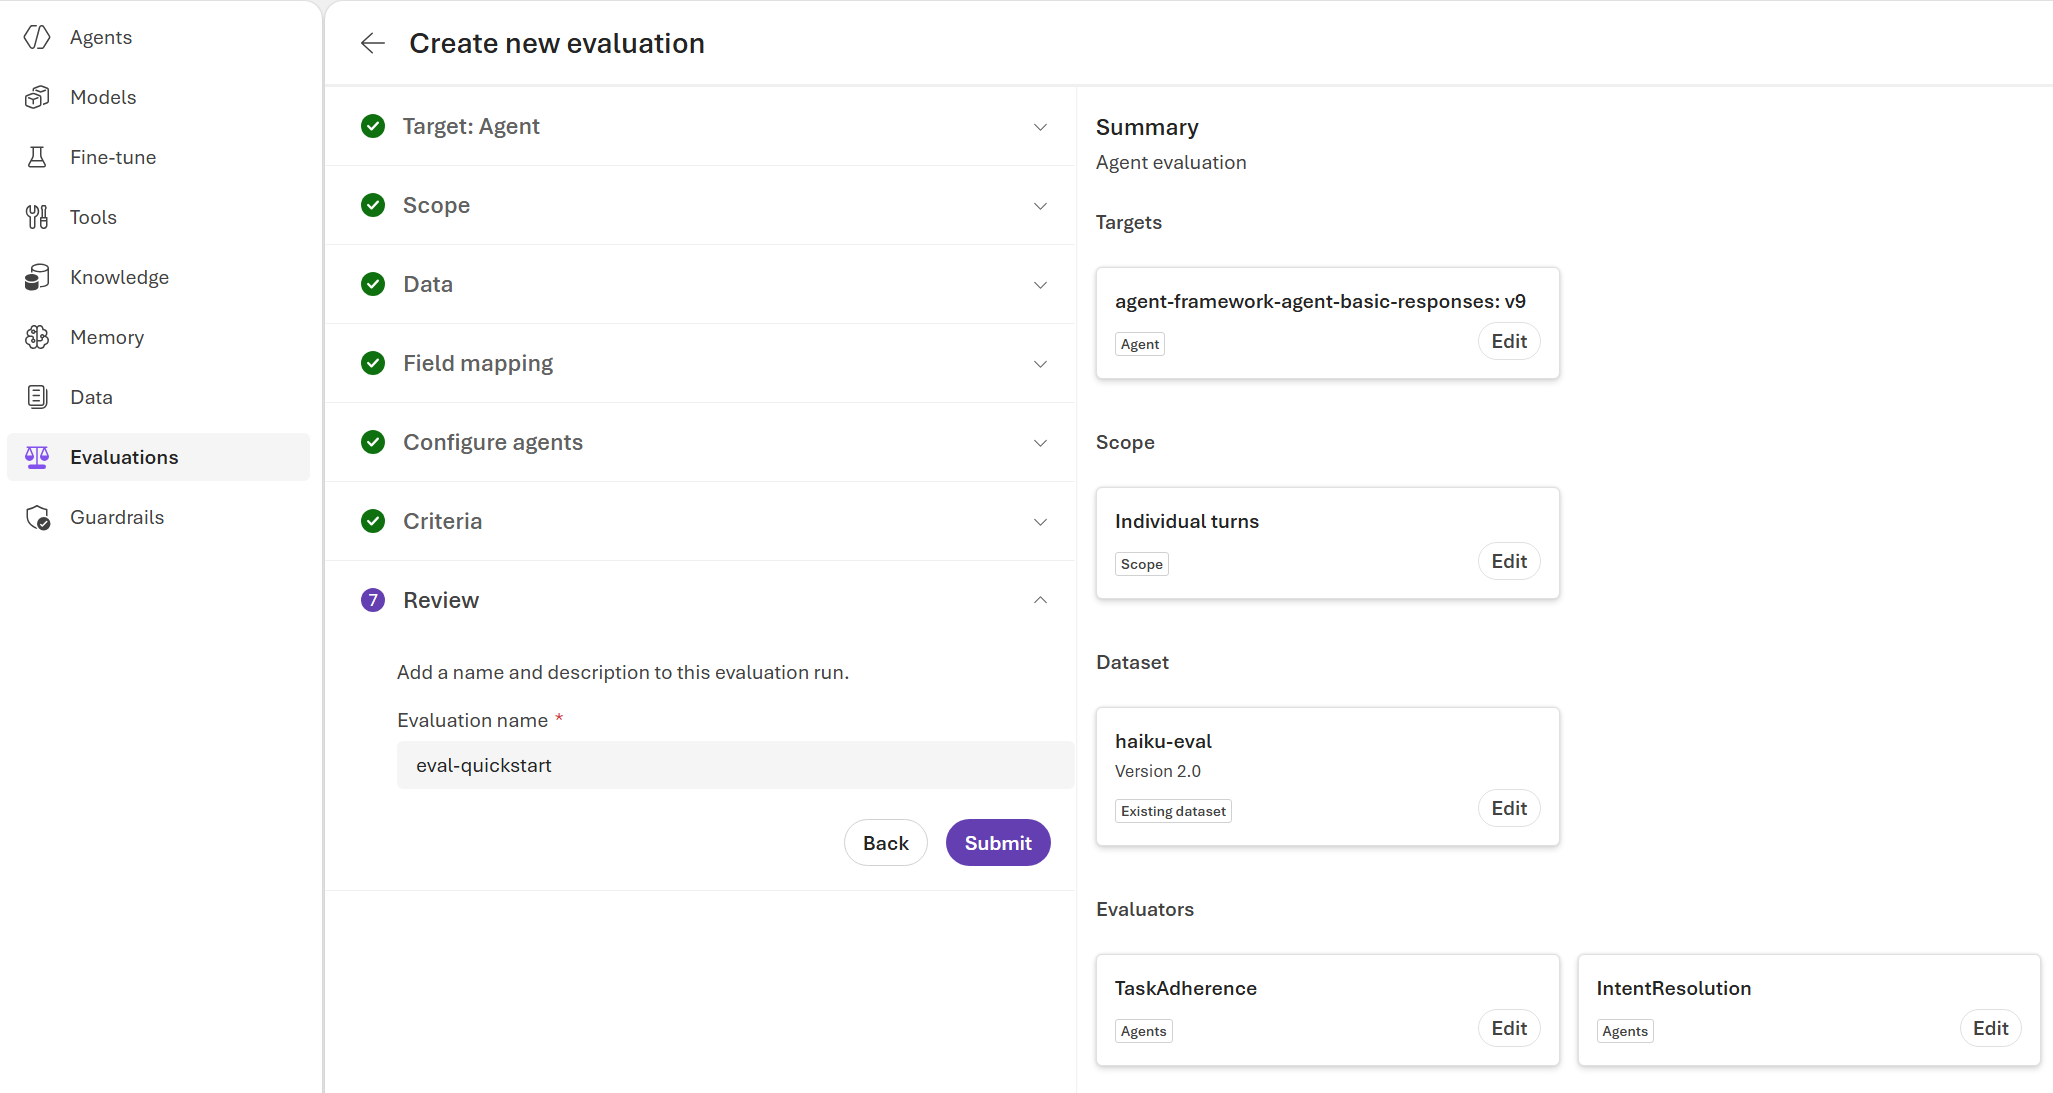
Gözden geçir ve gönder adımında değerlendirme için bir ad girin.
- Hedefi, kapsamı, veri kaynağını ve seçili değerlendiricileri gözden geçirin.
- Çalıştırmayı başlatmak için Gönder'i seçin.
Her test sorgusunu aracınıza gönderen ve değerlendiricileri uygulayan bir çalıştırma oluşturun.
<your-agent-name> öğesini barındırdığınız aracının adıyla değiştirin:
eval_run = client.evals.runs.create(
    eval_id=evaluation.id,
    name="Agent Evaluation Run",
    data_source={
        "type": "azure_ai_target_completions",
        "source": {"type": "file_id", "id": dataset.id},
        "input_messages": {
            "type": "template",
            "template": [
                {
                    "type": "message",
                    "role": "user",
                    "content": {"type": "input_text", "text": "{{item.query}}"},
                }
            ],
        },
        "target": {
            "type": "azure_ai_agent",
            "name": "<your-agent-name>",
            # "version": "1",  # Optional; omit to use the latest version
        },
    },
)

print(f"Evaluation run started: {eval_run.id}")
Her test sorgusunu aracınıza gönderen ve değerlendiricileri uygulayan bir çalıştırma oluşturun.
<your-agent-name> öğesini barındırdığınız aracının adıyla değiştirin:
var createRun = new
{
    name = "Agent Evaluation Run",
    data_source = new
    {
        type = "azure_ai_target_completions",
        source = new { type = "file_id", id = dataset.Id },
        input_messages = new
        {
            type = "template",
            template = new object[]
            {
                new { type = "message", role = "user", content = new { type = "input_text", text = "{{item.query}}" } },
            },
        },
        // Add a "version" property to the target to pin a specific agent version; omit to use the latest.
        target = new { type = "azure_ai_agent", name = "<your-agent-name>" },
    },
};

ClientResult runResult = evalClient.CreateEvaluationRun(
    evaluationId, BinaryContent.Create(BinaryData.FromObjectAsJson(createRun)));
string runId = JsonDocument.Parse(runResult.GetRawResponse().Content.ToString())
    .RootElement.GetProperty("id").GetString()!;
Console.WriteLine($"Evaluation run started: {runId}");
Her test sorgusunu aracınıza gönderen ve değerlendiricileri uygulayan bir çalıştırma oluşturun.
<your-agent-name> öğesini barındırdığınız aracının adıyla değiştirin:
const evalRun = await client.evals.runs.create(evaluation.id, {
  name: "Agent Evaluation Run",
  data_source: {
    type: "azure_ai_target_completions",
    source: { type: "file_id", id: dataset.id },
    input_messages: {
      type: "template",
      template: [
        {
          type: "message",
          role: "user",
          content: { type: "input_text", text: "{{item.query}}" },
        },
      ],
    },
    target: {
      type: "azure_ai_agent",
      name: "<your-agent-name>",
      // version: "1", // Optional; omit to use the latest version
    },
  },
});

console.log(`Evaluation run started: ${evalRun.id}`);
Değerlendirmeler genellikle sorgu sayısına bağlı olarak birkaç dakika içinde tamamlar.
Son değerlendirmeleri listeleyin:
azd ai agent eval list
    Eval ID                                Name        Status of last run  Runs
    -------                                ----        ------------------  ----
*   eval_b36748dede424e4ba3f8e6c99ca2cf27  agent-eval  Completed           1

* = active eval in current environment
En son değerlendirmeyi ve buna ait çalıştırmaları gösterin:
azd ai agent eval show
Eval:   eval_b36748dede424e4ba3f8e6c99ca2cf27
Name:   agent-eval
Agent:  <your-agent-name>
Runs:   1

Recent runs:
  Run ID                                    Status     Passed  Failed  Created
  ------                                    ------     ------  ------  -------
  evalrun_5f72ef189ad24790a32128e6f230b131  Completed  1/1     0       2026-06-17 14:52 UTC
Hangi aracı sürümünün değerlendirildiğini ve hangi değerlendirici puanlarının üretildiğini onaylamak için sonuçları kullanın. Değerlendirici başına ayrıntıları ve Foundry portalındaki rapor bağlantısını görmek için azd ai agent eval show <eval-id> --eval-run-id <run-id> komutunu çalıştırın.
- Ayrıntılar sayfasında hedef, veri kümesi, durum, belirteç kullanımı ve her değerlendirici için toplam puan gösterilir.
- Satır düzeyi sonuçları görüntülemek için çalıştırma adını seçin: her sorgu, aracı yanıtı, değerlendirici puanı ve puan açıklaması.
Tamamlanma anketi yapın, ardından sonuçları Dökümhane portalında açan durumu ve rapor URL'sini yazdırın:
import time

while True:
    run = client.evals.runs.retrieve(run_id=eval_run.id, eval_id=evaluation.id)
    if run.status in ["completed", "failed"]:
        break
    time.sleep(5)

print(f"Status: {run.status}")
print(f"Report URL: {run.report_url}")
Çalıştırma düzeyinde, her değerlendirici için toplam başarılı ve başarısız sayılarını görebilirsiniz:
print(run.result_counts)
for criteria in run.per_testing_criteria_results:
    print(criteria.testing_criteria, "passed:", criteria.passed, "failed:", criteria.failed)
ResultCounts(errored=0, failed=0, passed=1, total=1, skipped=0)
Intent Resolution passed: 1 failed: 0
Task Adherence passed: 1 failed: 0
Satır düzeyi ayrıntısı için çıkış öğelerini listeleyin. Her sonuç, değerlendiricinin adını, geçti veya kaldı durumunu ve bir puanı içerir:
for item in client.evals.runs.output_items.list(run_id=eval_run.id, eval_id=evaluation.id):
    for result in item.results:
        print(item.id, result.name, "passed:", result.passed, "score:", result.score)
Tamamlanma durumunu sorgulayın ve ardından durumu ve sonuçları Foundry portalında açan rapor URL'sini yazdırın:
JsonElement run = default;
while (true)
{
    ClientResult runStatus = evalClient.GetEvaluationRun(evaluationId, runId, options: null);
    run = JsonDocument.Parse(runStatus.GetRawResponse().Content.ToString()).RootElement;
    string status = run.GetProperty("status").GetString()!;
    if (status is "completed" or "failed") break;
    Thread.Sleep(TimeSpan.FromSeconds(5));
}

Console.WriteLine($"Status: {run.GetProperty("status").GetString()}");
Console.WriteLine($"Report URL: {run.GetProperty("report_url").GetString()}");
Çalıştırma düzeyinde, her değerlendirici için toplam başarılı ve başarısız sayılarını görebilirsiniz:
Console.WriteLine(run.GetProperty("result_counts").GetRawText());
foreach (JsonElement criteria in run.GetProperty("per_testing_criteria_results").EnumerateArray())
{
    Console.WriteLine(
        $"{criteria.GetProperty("testing_criteria").GetString()} " +
        $"passed: {criteria.GetProperty("passed").GetInt32()} " +
        $"failed: {criteria.GetProperty("failed").GetInt32()}");
}
Satır düzeyi ayrıntısı için çıkış öğelerini listeleyin. Her sonuç, değerlendiricinin adını, geçti veya kaldı durumunu ve bir puanı içerir:
ClientResult outputItems = evalClient.GetEvaluationRunOutputItems(
    evaluationId, runId, limit: 100, order: null, after: null, outputItemStatus: null, options: null);
foreach (JsonElement item in JsonDocument.Parse(outputItems.GetRawResponse().Content.ToString())
    .RootElement.GetProperty("data").EnumerateArray())
{
    foreach (JsonElement result in item.GetProperty("results").EnumerateArray())
    {
        Console.WriteLine(
            $"{item.GetProperty("id").GetString()} {result.GetProperty("name").GetString()} " +
            $"passed: {result.GetProperty("passed")} score: {result.GetProperty("score")}");
    }
}
Tamamlanma durumunu sorgulayın ve ardından durumu ve sonuçları Foundry portalında açan rapor URL'sini yazdırın:
let run = evalRun;
while (!["completed", "failed"].includes(run.status)) {
  run = await client.evals.runs.retrieve(run.id, {
    eval_id: evaluation.id,
  });
  await new Promise((resolve) => setTimeout(resolve, 5000));
}

console.log(`Status: ${run.status}`);
console.log(`Report URL: ${run.report_url}`);
Çalıştırma düzeyinde, her değerlendirici için toplam başarılı ve başarısız sayılarını görebilirsiniz:
console.log(JSON.stringify(run.result_counts));
for (const criteria of run.per_testing_criteria_results) {
  console.log(
    criteria.testing_criteria,
    "passed:",
    criteria.passed,
    "failed:",
    criteria.failed,
  );
}
{"errored":0,"failed":0,"passed":1,"total":1,"skipped":0}
Intent Resolution passed: 1 failed: 0
Task Adherence passed: 1 failed: 0
Satır düzeyi ayrıntısı için çıkış öğelerini listeleyin. Her sonuç, değerlendiricinin adını, geçti veya kaldı durumunu ve bir puanı içerir:
for await (const item of client.evals.runs.outputItems.list(run.id, {
  eval_id: evaluation.id,
})) {
  for (const result of item.results) {
    console.log(item.id, result.name, "passed:", result.passed, "score:", result.score);
  }
}
Bu hızlı başlangıçta Foundry projenize bir veri kümesi, değerlendirme ve çalıştırma geçmişi kaydedilmektedir. Bu varlıklar çok az maliyetlidir veya devam eden bir maliyet doğurmaz.
