Not
Bu sayfaya erişim yetkilendirme gerektiriyor. Oturum açmayı veya dizinleri değiştirmeyi deneyebilirsiniz.
Bu sayfaya erişim yetkilendirme gerektiriyor. Dizinleri değiştirmeyi deneyebilirsiniz.
ŞUNLAR IÇIN GEÇERLIDIR:  Python SDK'sı azure-ai-ml v2 (geçerli)
Makine öğrenmesi projesi genellikle keşif veri analizi (EDA) ve veri ön işleme (temizleme, özellik mühendisliği) ile başlar. Ayrıca hipotezleri doğrulamak için makine öğrenmesi modeli prototipleri derlemeyi de içerir. Bu prototip proje aşaması son derece etkileşimlidir ve bir Jupyter not defterinde veya Python etkileşimli konsollu bir IDE'de geliştirme için uygundur. Bu makalede şunları öğreneceksiniz:
- Azure Machine Learning veri deposu URI'sinden verilere bir dosya sistemiymiş gibi erişin.
- Python kitaplığını kullanarak Azure Machine Learning veri varlıklarını Pandas ile materyalleştirin
mltable. - Doğrudan bir indirme yoluyla verileri elde etmek için
azcopyyardımcı programını kullanın.
Önkoşullar
- Azure Machine Learning çalışma alanı. Daha fazla bilgi için bkz. Portalda veya Python SDK'sı (v2) ile Azure Machine Learning çalışma alanlarını yönetme.
- Azure Machine Learning veri deposu. Daha fazla bilgi için bkz . Veri depoları oluşturma.
İpucu
Bu makaledeki kılavuzda etkileşimli geliştirme sırasında veri erişimi açıklanmaktadır. Python oturumu çalıştırabilen tüm konaklar için geçerlidir. Bu konak yerel makineniz, bulut VM'niz, GitHub Codespace veya başka bir konak olabilir. Tam olarak yönetilen ve önceden yapılandırılmış bir bulut iş istasyonu olan Azure Machine Learning işlem örneğini kullanın. Daha fazla bilgi için bkz . Azure Machine Learning işlem örneği oluşturma.
Önemli
Python ortamınızda en son azure-fsspec, mltableve azure-ai-ml Python kitaplıklarının yüklü olduğundan emin olun:
pip install -U azureml-fsspec==1.3.1 mltable azure-ai-ml
En son azure-fsspec paket sürümü zaman içinde değişebilir. Paket hakkında azure-fsspec daha fazla bilgi için bkz. azureml-fsspec 1.3.1.
Veri deposu URI'sinden verilere dosya sisteminden yaptığınız gibi erişme
Azure Machine Learning veri deposu, mevcut bir Azure depolama hesabına başvurudur. Veri depoları oluşturmanın ve kullanmanın avantajları şunlardır:
- Farklı depolama türleriyle (blob, dosya, Azure Data Lake Storage) etkileşime geçmek için yaygın, kullanımı kolay bir API.
- Ekip işlemlerinde kullanışlı veri depolarının kolay bulunması.
- Verilere hem kimlik bilgisi tabanlı (örneğin SAS belirteci) hem de kimlik tabanlı (Microsoft Entra Kimliği veya yönetilen kimlik) erişimi desteği.
- Kimlik bilgisi tabanlı erişim için bağlantı bilgileri, betiklerde anahtarın ifşa edilmesini önlemek amacıyla güvence altına alınır.
- Azure Machine Learning studio kullanıcı arabiriminde verilere göz atabilir ve veri deposu URI'lerini kopyalayıp yapıştırabilirsiniz.
Veri deposu URI'si, Azure depolama hesabınızdaki bir depolama konumuna (yol) başvuru olan Tekdüzen Kaynak Tanımlayıcısı'dır. Veri deposu URI'sinde şu biçim vardır:
# Azure Machine Learning workspace details:
subscription = '<subscription_ID>'
resource_group = '<resource_group>'
workspace = '<workspace>'
datastore_name = '<datastore>'
path_on_datastore = '<path>'

# Long-form datastore URI format:
uri = f'azureml://subscriptions/{subscription}/resourcegroups/{resource_group}/workspaces/{workspace}/datastores/{datastore_name}/paths/{path_on_datastore}'.
Bu veri deposu URI'leri , Dosya Sistemi belirtiminin (fsspec): yerel, uzak ve katıştırılmış dosya sistemlerine ve bayt depolamaya yönelik birleşik bir Python arabiriminin bilinen bir uygulamasıdır. İlk olarak, paketi ve bağımlılık azureml-fsspec paketini yüklemek azureml-dataprep için pip kullanın. Ardından Azure Machine Learning veri deposu fsspec uygulamasını kullanabilirsiniz.
Azure Machine Learning veri deposu fsspec uygulaması, Azure Machine Learning veri deposunun kimlik bilgileri/kimlik geçişini otomatik olarak ele alır. Betiklerinizde hem hesap anahtarının açıkta kalmasını hem de işlem örneğinde ek oturum açma yordamlarını önleyebilirsiniz.
Örneğin, Pandas'ta veri deposu URI'lerini doğrudan kullanabilirsiniz. Bu örnekte CSV dosyasının nasıl okunduğu gösterilmektedir:
import pandas as pd

df = pd.read_csv("azureml://subscriptions/<subscription_ID>/resourcegroups/<resource_group_name>/workspaces/<workspace_name>/datastores/<datastore_name>/paths/<folder>/<filename>.csv")
df.head()
İpucu
Veri deposu URI biçimini anımsama gereğini önlemek için aşağıdaki adımları uygulayarak veri deposu URI'sini kopyalayıp stüdyo kullanıcı arabirimine yapıştırabilirsiniz:
- Soldaki menüden Veri'yi ve ardından Veri Depoları sekmesini seçin.
- Veri deposu adını seçip Gözat'ı tıklayın.
- Pandas'a okumak istediğiniz dosya veya klasörü bulun, yanındaki üç noktayı (...) ve ardından URI Kopyala'yı seçin. Ardından not defterinize veya betiğinize kopyalamak için veri deposu URI'sini seçebilirsiniz.
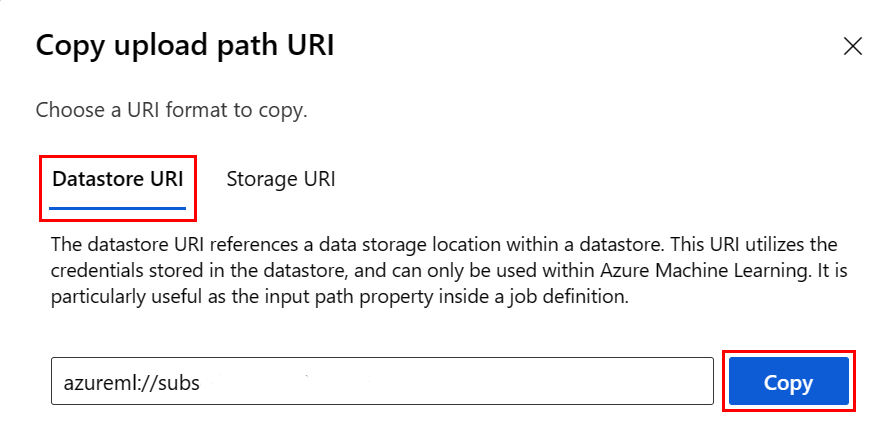
Ayrıca, , ls, globve existsgibi dosya sistemi benzeri openkomutları işlemek için bir Azure Machine Learning dosya sistemi örneği de oluşturabilirsiniz.
- yöntemi belirli
ls()bir dizindeki dosyaları listeler. Dosyaları listelemek için ,ls()vels(.)kullanabilirsinizls (<folder_level_1>/<folder_level_2>). Hem.hem de..göreli yollarda desteklenir. -
glob()yöntemi,*ve**globbing'i destekler. - yöntemi,
exists()belirtilen bir dosyanın geçerli kök dizinde var olup olmadığını gösteren bir Boole değeri döndürür. -
open()yöntemi, Python dosyalarıyla çalışmayı bekleyen herhangi bir başka kütüphaneye verilebilecek dosyaya benzer bir nesne döndürür. Kodunuz bu nesneyi normal bir Python dosya nesnesiymiş gibi de kullanabilir. Bu dosya benzeri nesneler, bu örnekte gösterildiği gibi bağlamlarınwithkullanımına saygı gösterir:
from azureml.fsspec import AzureMachineLearningFileSystem

# Instantiate the filesystem by using the following URI.
fs = AzureMachineLearningFileSystem('azureml://subscriptions/<subscriptionID>/resourcegroups/<resource_group_name>/workspaces/<workspace_name>/datastores/<datastore_name>')

fs.ls() # List folders and files in datastore datastorename.

# Output example:
# folder1
# folder2
# file3.csv

# Use an open context.
with fs.open('./folder1/file1.csv') as f:
    # Do some process.
    process_file(f)
AzureMachineLearningFileSystem'i kullanarak dosyaları yükleme
from azureml.fsspec import AzureMachineLearningFileSystem
# Instantiate the filesystem by using the following URI.
fs = AzureMachineLearningFileSystem('azureml://subscriptions/<subscriptionID>/resourcegroups/<resource_group_name>/workspaces/<workspace_name>/datastores/<datastore_name>/paths/')

# You can set recursive to False to upload a file.
fs.upload(lpath='data/upload_files/crime-spring.csv', rpath='data/fsspec', recursive=False, **{'overwrite': 'MERGE_WITH_OVERWRITE'})

# You need to set recursive to True to upload a folder.
fs.upload(lpath='data/upload_folder/', rpath='data/fsspec_folder', recursive=True, **{'overwrite': 'MERGE_WITH_OVERWRITE'})
lpath yerel yoldur ve rpath uzak yoldur.
içinde belirttiğiniz rpath klasörler yoksa, yöntemi klasörleri sizin için oluşturur.
yöntemi üç overwrite modu destekler:
- EKLEME. Aynı ada sahip bir dosya hedef yolunda varsa, APPEND orijinal dosyayı korur.
- Dosya Çatışmasında Başarısız Ol. Hedef yolda aynı ada sahip bir dosya varsa, FAIL_ON_FILE_CONFLICT bir hata oluşturur.
- BİRLEŞTİR_VE_ÜZERİNE_YAZ. Hedef yolda aynı ada sahip bir dosya varsa, MERGE_WITH_OVERWRITE varolan dosyanın üzerine yeni dosyayla yazar.
AzureMachineLearningFileSystem kullanarak dosyaları indirme
# You can set recursive to False to download a file.
# The downloading overwrite option is determined by the local system. It's MERGE_WITH_OVERWRITE.
fs.download(rpath='data/fsspec/crime-spring.csv', lpath='data/download_files/', recursive=False)

# You need to set recursive to True to download a folder.
fs.download(rpath='data/fsspec_folder', lpath='data/download_folder/', recursive=True)
Örnekler
Bu örneklerde, yaygın senaryolarda dosya sistemi belirtiminin nasıl kullanılacağı gösterilmektedir.
Pandas'ta tek bir CSV dosyasını okuma
Şu kodu kullanarak Pandas'ta tek bir CSV dosyasını okuyabilirsiniz:
import pandas as pd

df = pd.read_csv("azureml://subscriptions/<subscription_ID>/resourcegroups/<resource_group_name>/workspaces/<workspace_name>/datastores/<datastore_name>/paths/<folder>/<file_name>.csv")
Csv dosyalarının bir klasörünü Pandas'a okuma
Pandas read_csv() yöntemi, CSV dosyalarının bir klasörünü okumayı desteklemez. Bu sınırlamayı işlemek için glob kullanarak CSV yollarını alın ve bunları Pandas concat() yöntemiyle bir veri çerçevesine birleştirin. Sonraki kod örneğinde, Azure Machine Learning dosya sistemini kullanarak bu birleştirmenin nasıl gerçekleştirilmesi gösterilmektedir:
import pandas as pd
from azureml.fsspec import AzureMachineLearningFileSystem

# Define the URI. Update <> placeholders.
uri = 'azureml://subscriptions/<subscription_ID>/resourcegroups/<resource_group_name>/workspaces/<workspace_name>/datastores/<datastore_name>'

# Create the filesystem.
fs = AzureMachineLearningFileSystem(uri)

# Append .csv files in the folder to a list.
dflist = []
for path in fs.glob('/<folder>/*.csv'):
    with fs.open(path) as f:
        dflist.append(pd.read_csv(f))

# Concatenate data frames.
df = pd.concat(dflist)
df.head()
CSV dosyalarını Dask'a okuma
Bu örnekte CSV dosyasının Dask veri çerçevesine nasıl okunduğu gösterilmektedir:
import dask.dd as dd

df = dd.read_csv("azureml://subscriptions/<subscription_ID>/resourcegroups/<resource_group_name>/workspaces/<workspace_name>/datastores/<datastore_name>/paths/<folder>/<file_name>.csv")
df.head()
Pandas'ta parquet dosyalarının bir klasörünü okuma
EtL işlemi sırasında Parquet dosyaları genellikle bir klasöre yazılır. İşlem daha sonra ilerleme, commitler ve diğer meta veriler gibi ETL ile ilgili dosyaları yayabilir. Bu örnekte, bir ETL işleminden oluşturulan dosyalar (ile _başlayan dosyalar) gösterilir ve bu dosyalar bir Parquet veri dosyası oluşturur.
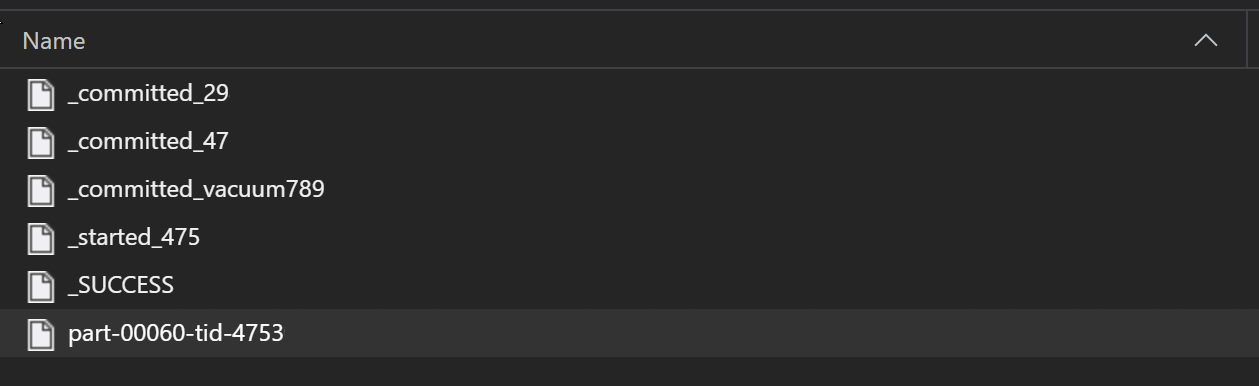
Bu senaryolarda, yalnızca klasördeki Parquet dosyalarını okursunuz. ETL süreç dosyalarını yoksayarsınız. Bu kod örneği, glob desenlerinin bir klasördeki yalnızca Parquet dosyalarını nasıl okuyabildiğini gösterir:
import pandas as pd
from azureml.fsspec import AzureMachineLearningFileSystem

# Define the URI. Update <> placeholders.
uri = 'azureml://subscriptions/<subscription_ID>/resourcegroups/<resource_group_name>/workspaces/<workspace_name>/datastores/<datastore_name>'

# Create the filesystem.
fs = AzureMachineLearningFileSystem(uri)

# Append Parquet files in folder to a list.
dflist = []
for path in fs.glob('/<folder>/*.parquet'):
    with fs.open(path) as f:
        dflist.append(pd.read_parquet(f))

# Concatenate data frames.
df = pd.concat(dflist)
df.head()
Azure Databricks dosya sisteminizden verilere erişme
Dosya Sistemi belirtimi (), Databricks Dosya Sistemi (fsspec) dahil olmak üzere bilinen bir dizi uygulamaya sahiptirdbfs.
Kaynaktan dbfs verilere erişmek için şunları yapmanız gerekir:
- Örnek adı,
adb-<number>.<number>.azuredatabricks.netbiçiminde. Bu değeri Azure Databricks çalışma alanınızın URL'sinde bulabilirsiniz. - Kişisel erişim jetonu. Kişisel erişim belirteci oluşturma hakkında daha fazla bilgi için bkz. Azure Databricks kişisel erişim belirteçleri (eski) ile kimlik doğrulama.
Bu değerlerle, işlem örneğinizde PAT belirteci için bir ortam değişkeni oluşturun:
export ADB_PAT=<personal_access_token>
Bu örnekte gösterildiği gibi Pandas'taki verilere erişebilirsiniz:
import os
import pandas as pd

pat = os.getenv(ADB_PAT)
path_on_dbfs = '<absolute_path_on_dbfs>' # e.g. /folder/subfolder/file.csv

storage_options = {
    'instance':'adb-<number>.<number>.azuredatabricks.net',
    'token': pat
}

df = pd.read_csv(f'dbfs://{path_on_dbfs}', storage_options=storage_options)
Ile resim okuma pillow
from PIL import Image
from azureml.fsspec import AzureMachineLearningFileSystem

# Define the URI. Update <> placeholders.
uri = 'azureml://subscriptions/<subscription_ID>/resourcegroups/<resource_group_name>/workspaces/<workspace_name>/datastores/<datastore_name>'

# Create the filesystem.
fs = AzureMachineLearningFileSystem(uri)

with fs.open('/<folder>/<image.jpeg>') as f:
    img = Image.open(f)
    img.show()
PyTorch özel veri kümesi örneği
Bu örnekte, görüntüleri işlemek için bir PyTorch özel veri kümesi oluşturacaksınız. Bu senaryoda, şu genel yapıya sahip bir ek açıklama dosyası (CSV biçiminde) vardır:
image_path, label
0/image0.png, label0
0/image1.png, label0
1/image2.png, label1
1/image3.png, label1
2/image4.png, label2
2/image5.png, label2
Alt klasörler bu görüntüleri etiketlerine göre depolar:
/
└── 📁images
    ├── 📁0
    │   ├── 📷image0.png
    │   └── 📷image1.png
    ├── 📁1
    │   ├── 📷image2.png
    │   └── 📷image3.png
    └── 📁2
        ├── 📷image4.png
        └── 📷image5.png
Özel bir PyTorch Veri Kümesi sınıfı, burada gösterildiği gibi , __init__ve __len__olmak üzere üç işlev __getitem__uygulamalıdır:
import os
import pandas as pd
from PIL import Image
from torch.utils.data import Dataset

class CustomImageDataset(Dataset):
    def __init__(self, filesystem, annotations_file, img_dir, transform=None, target_transform=None):
        self.fs = filesystem
        f = filesystem.open(annotations_file)
        self.img_labels = pd.read_csv(f)
        f.close()
        self.img_dir = img_dir
        self.transform = transform
        self.target_transform = target_transform

    def __len__(self):
        return len(self.img_labels)

    def __getitem__(self, idx):
        img_path = os.path.join(self.img_dir, self.img_labels.iloc[idx, 0])
        f = self.fs.open(img_path)
        image = Image.open(f)
        f.close()
        label = self.img_labels.iloc[idx, 1]
        if self.transform:
            image = self.transform(image)
        if self.target_transform:
            label = self.target_transform(label)
        return image, label
Daha sonra burada gösterildiği gibi veri kümesinin örneğini oluşturabilirsiniz:
from azureml.fsspec import AzureMachineLearningFileSystem
from torch.utils.data import DataLoader

# Define the URI. Update <> placeholders.
uri = 'azureml://subscriptions/<subscription_ID>/resourcegroups/<resource_group_name>/workspaces/<workspace_name>/datastores/<datastore_name>'

# Create the filesystem.
fs = AzureMachineLearningFileSystem(uri)

# Create the dataset.
training_data = CustomImageDataset(
    filesystem=fs,
    annotations_file='/annotations.csv',
    img_dir='/<path_to_images>/'
)

# Prepare your data for training with DataLoaders.
train_dataloader = DataLoader(training_data, batch_size=64, shuffle=True)
mltable kütüphanesini kullanarak veriyi Pandas'ta dönüştürme
Kitaplık, mltable bulut depolamadaki verilere erişmenize de yardımcı olabilir. Pandas'a veri okumak için mltable kullanarak aşağıdaki genel biçimi kullanın:
import mltable

# Define a path, folder, or pattern.
path = {
    'file': '<supported_path>'
    # alternatives
    # 'folder': '<supported_path>'
    # 'pattern': '<supported_path>'
}

# Create an mltable from paths.
tbl = mltable.from_delimited_files(paths=[path])
# alternatives
# tbl = mltable.from_parquet_files(paths=[path])
# tbl = mltable.from_json_lines_files(paths=[path])
# tbl = mltable.from_delta_lake(paths=[path])

# Materialize to Pandas.
df = tbl.to_pandas_dataframe()
df.head()
Desteklenen yollar
Kitaplık, mltable farklı yol türlerinden tablo verilerinin okunmasını destekler:
| Konum | Örnekler |
|---|---|
| Yerel bilgisayarınızdaki bir yol | ./home/username/data/my_data |
| Açık HTTP(S) sunucusundaki bir yol | https://raw.githubusercontent.com/pandas-dev/pandas/main/doc/data/titanic.csv |
| Azure Depolama'da bir yol | wasbs://<container_name>@<account_name>.blob.core.windows.net/<path> abfss://<file_system>@<account_name>.dfs.core.windows.net/<path> |
| Uzun formlu bir Azure Machine Learning veri deposu | azureml://subscriptions/<subscription_ID>/resourcegroups/<resource_group_name>/workspaces/<workspace_name>/datastores/<name>/paths/<path> |
Not
Azure Depolama ve Azure Machine Learning veri depoları mltable üzerindeki yollar için kimlik bilgisi geçiş bilgilerini kullanır. Temel depolama birimindeki verilere erişim izniniz yoksa verilere erişemezsiniz.
Dosyalar, klasörler ve globlar
mltable şu kaynaklardan okumayı destekler:
- Dosyalar. Örneğin,
abfss://<file_system>@<account_name>.dfs.core.windows.net/my-csv.csv. - Klasörler Örneğin,
abfss://<file_system>@<account_name>.dfs.core.windows.net/my-folder/. -
glob desenleri. Örneğin,
abfss://<file_system>@<account_name>.dfs.core.windows.net/my-folder/*.csv. - Dosya, klasör ve/veya glob desenlerinin birleşimi.
mltable yerel ve bulut depolama kaynaklarının bir bileşiminden ve dosya, klasör ve glob birleşimlerinden tek bir veri çerçevesine veri gerçekleştirmeyi etkinleştirir. Örneğin:
path1 = {
    'file': 'abfss://filesystem@account1.dfs.core.windows.net/my-csv.csv'
}

path2 = {
    'folder': './home/username/data/my_data'
}

path3 = {
    'pattern': 'abfss://filesystem@account2.dfs.core.windows.net/folder/*.csv'
}

tbl = mltable.from_delimited_files(paths=[path1, path2, path3])
Desteklenen dosya biçimleri
mltable aşağıdaki dosya biçimlerini destekler.
- Sınırlandırılmış metin (örneğin, CSV dosyaları):
mltable.from_delimited_files(paths=[path]) - Parke:
mltable.from_parquet_files(paths=[path]) - Delta:
mltable.from_delta_lake(paths=[path]) - JSON Çizgileri biçimi:
mltable.from_json_lines_files(paths=[path])
Örnekler
CSV dosyasını okuma
-
Data Lake Storage
- Blob Depolama
- Azure Machine Learning Veri Deposu
- HTTP sunucusu
Bu kod parçacığındaki yer tutucuları (<>) değerlerinizle değiştirin:
import mltable

path = {
    'file': 'abfss://<filesystem>@<account>.dfs.core.windows.net/<folder>/<file_name>.csv'
}

tbl = mltable.from_delimited_files(paths=[path])
df = tbl.to_pandas_dataframe()
df.head()
Klasördeki Parquet dosyalarını okuma
Bu örnek, yalnızca Parquet dosyalarının okunmasını sağlamak için joker karakterler gibi glob desenlerinin mltable nasıl kullanılabileceğini göstermektedir.
-
Data Lake Storage
- Blob Depolama
- Azure Machine Learning Veri Deposu
- HTTP sunucusu
Bu kod parçacığındaki yer tutucuları (<>) değerlerinizle değiştirin:
import mltable

path = {
    'pattern': 'abfss://<filesystem>@<account>.dfs.core.windows.net/<folder>/*.parquet'
}

tbl = mltable.from_parquet_files(paths=[path])
df = tbl.to_pandas_dataframe()
df.head()
Veri varlıklarını okuma
Bu bölümde, Pandas'taki Azure Machine Learning veri varlıklarınıza nasıl erişin olduğu gösterilmektedir.
Tablo varlığı
Daha önce Azure Machine Learning'de (bir mltable veya V1 TabularDataset) bir tablo varlığı oluşturduysanız, şu kodu kullanarak bu tablo varlığını Pandas'a yükleyebilirsiniz:
import mltable
from azure.ai.ml import MLClient
from azure.identity import DefaultAzureCredential

ml_client = MLClient.from_config(credential=DefaultAzureCredential())
data_asset = ml_client.data.get(name="<name_of_asset>", version="<version>")

tbl = mltable.load(f'azureml:/{data_asset.id}')
df = tbl.to_pandas_dataframe()
df.head()
Dosya varlığı
Bir dosya varlığı (örneğin csv dosyası) kaydettiyseniz, bu kodu kullanarak bu varlığı pandas veri çerçevesinde okuyabilirsiniz:
import mltable
from azure.ai.ml import MLClient
from azure.identity import DefaultAzureCredential

ml_client = MLClient.from_config(credential=DefaultAzureCredential())
data_asset = ml_client.data.get(name="<name_of_asset>", version="<version>")

path = {
    'file': data_asset.path
}

tbl = mltable.from_delimited_files(paths=[path])
df = tbl.to_pandas_dataframe()
df.head()
Klasör varlığı
Örneğin, CSV dosyası içeren bir klasör gibi bir klasör varlığı (uri_folder veya V1 FileDataset) kaydettiyseniz, bu kodu kullanarak bu varlığı Pandas veri çerçevesinde okuyabilirsiniz:
import mltable
from azure.ai.ml import MLClient
from azure.identity import DefaultAzureCredential

ml_client = MLClient.from_config(credential=DefaultAzureCredential())
data_asset = ml_client.data.get(name="<name_of_asset>", version="<version>")

path = {
    'folder': data_asset.path
}

tbl = mltable.from_delimited_files(paths=[path])
df = tbl.to_pandas_dataframe()
df.head()
Pandas kullanarak büyük veri hacimlerini okuma ve işleme
İpucu
Pandas, büyük veri kümelerini işlemek için tasarlanmamıştır. Pandas yalnızca işlem örneğinin belleğine uyan verileri işleyebilir.
Büyük veri kümeleri için Azure Machine Learning tarafından yönetilen Spark'ı kullanın. Bu hizmet PySpark Pandas API'sini sağlar.
Uzak zaman uyumsuz bir işe ölçeklendirmeden önce büyük bir veri kümesinin daha küçük bir alt kümesinde hızla yineleme yapmak isteyebilirsiniz.
mltable
take_random_sample yöntemi aracılığıyla büyük veri örnekleri almak için işlevsellik sağlar:
import mltable

path = {
    'file': 'https://raw.githubusercontent.com/pandas-dev/pandas/main/doc/data/titanic.csv'
}

tbl = mltable.from_delimited_files(paths=[path])
# Take a random 30% sample of the data.
tbl = tbl.take_random_sample(probability=.3)
df = tbl.to_pandas_dataframe()
df.head()
Aşağıdaki işlemleri kullanarak büyük verilerin alt kümelerini de alabilirsiniz:
Verileri indirmek için azcopy yardımcı programını kullanma
Ana bilgisayarınızın azcopy SSD'sinin yerel dosya sistemine (yerel makine, bulut VM, Azure Machine Learning işlem örneği vb.) veri indirmek için yardımcı programını kullanın.
azcopy Azure Machine Learning işlem örneğine önceden yüklenmiş olan yardımcı program, veri indirme işlemini işler. Azure Machine Learning işlem örneği veya Veri Bilimi Sanal Makinesi (DSVM) kullanmıyorsanız yüklemeniz azcopygerekebilir. Daha fazla bilgi için bkz. azcopy.
Dikkat
İşlem örneğindeki /home/azureuser/cloudfiles/code konuma veri indirmeyin. Bu konum, verileri değil not defterini ve kod yapıtlarını depolamak için tasarlanmıştır. Bu konumdan veri okumak, eğitim sırasında önemli bir performans yüküne neden olabilir. Bunun yerine, verileri işlem düğümünün home/azureuser yerel SSD'si olan konumda depolayın.
Bir terminal açın ve yeni bir dizin oluşturun, örneğin:
mkdir /home/azureuser/data
azcopy oturum açın.
azcopy login
Artık bir depolama URI'si kullanarak verileri kopyalayabilirsiniz:
SOURCE=https://<account_name>.blob.core.windows.net/<container>/<path>
DEST=/home/azureuser/data
azcopy cp $SOURCE $DEST