Not
Bu sayfaya erişim yetkilendirme gerektiriyor. Oturum açmayı veya dizinleri değiştirmeyi deneyebilirsiniz.
Bu sayfaya erişim yetkilendirme gerektiriyor. Dizinleri değiştirmeyi deneyebilirsiniz.
Şunlar için geçerlidir: ✅ Microsoft Fabric'te SQL analiz uç noktası ve Ambarı
Özel SQL havuzları, yöneticilerin istekleri işlemek için kaynakların nasıl ayrıldığı konusunda daha fazla denetim sahibi olmasını sağlar. Bu hızlı başlangıçta, Özel SQL havuzlarını yapılandıracak ve Doku REST API'sini kullanarak sınıflandırıcı değerlerini gözlemleyeceksiniz.
Çalışma alanı yöneticileri, istekleri farklı işlem havuzlarına yönlendirmek için bağlantı dizesinden uygulama adını (veya program adını) kullanabilir. Çalışma alanı yöneticileri, çalışma alanı kapasitesinin dinamik ölçek sınırına göre her veritabanı SQL havuzunun erişebileceği kaynakların yüzdesini de kontrol edebiliyor.
Doku REST API'si işlemler için birleşik bir uç nokta tanımlar.
Önkoşullar
- Çalışma alanında Bir Ambar öğesine erişim. Yönetici rolünün üyesi olmanız gerekir.
Geçerli yapılandırmayı alma
Geçerli yapılandırmayı almak için aşağıdaki API'yi kullanın.
Fabric Not Defteri Örneği
Fabric Spark not defteri ortamında aşağıdaki örnek Python kodunu çalıştırabilirsiniz.
- Kod, özel SQL havuzu yapılandırma API'sine bir
GETistek gönderir ve çalışma alanı için özel SQL havuzu yapılandırmasını döndürür. -
workspace_idalanı, not defterinin çalıştığı çalışma alanı GUID'sini almak içinmssparkutils.runtime.contextöğesini kullanır. Farklı bir çalışma alanında özel bir SQL havuzu yapılandırmak için, özel SQL havuzlarını yapılandırmak istediğiniz çalışma alanının GUID'si ileworkspace_idöğesini güncelleyin.
import requests
import json
from notebookutils import mssparkutils

# This will get the workspace_id where this notebook is running.
# Update to the workspace_id (guid) if running this notebook outside of the workspace where the warehouse exists.
workspaceId = mssparkutils.runtime.context.get('currentWorkspaceId')

url = f'https://api.fabric.microsoft.com/v1/workspaces/{workspaceId}/warehouses/sqlPoolsConfiguration?beta=true'
response = requests.request(method='get', url=url, headers={'Authorization': f'Bearer {mssparkutils.credentials.getToken("pbi")}'})

if response.status_code == 200:
    print(json.dumps(response.json(), indent=4))
else:
    print(response.text)
Özel SQL havuzlarını yapılandırma
Aşağıdaki Python örneği özel SQL havuzlarını etkinleştirir ve yapılandırılır. Bu Python kodunu bir Fabric Spark not defterinde çalıştırabilirsiniz.
- Özel SQL havuzları yapılandırması yalnızca öznitelik true olarak ayarlandığında etkindir
customSQLPoolsEnabled. Nesne tanımındacustomSQLPoolsbir yük tanımlayabilirsiniz, ancak customSQLPoolsEnabled değerini true olarak ayarlamazsanız yük yoksayılır ve otonom iş yükü yönetimi kullanılır. - Kod,
ContosoSQLPoolveAdhocPoololmak üzere iki özel SQL havuzu yapılandırıyor.-
ContosoSQLPool, kullanılabilir kaynakların 70% alacak şekilde ayarlanır. Uygulama Adı sınıflandırıcısınınMyContosoAppdeğeri vardır. - Bağlantı dizesinde
MyContosoAppuygulama adını belirten tüm SQL sorguları, özel SQL havuzuContosoSQLPool'ye sınıflandırılır ve toplam serileştirilebilir kapasitenin %70'ine erişebilir. - Bağlantı dizesinin uygulama adında yer
MyContosoAppalmayan tüm SQL sorguları, varsayılan havuz olarak tanımlanan özel SQL havuzuna gönderilirAdhoc. Bu istekler, patlatılabilir kapasitenin toplam düğümlerinin %30'una erişim hakkı elde eder.
-
- Tüm özel SQL havuzu yapılandırmalarında özniteliği true olarak ayarlanarak
isDefaulttanımlanan bir varsayılan SQL Havuzu olmalıdır. - Tüm
maxResourcePercentagedeğerlerin toplamı 100%değerinden küçük veya buna eşit olmalıdır. -
workspace_idalanı, not defterinin çalıştığı çalışma alanı GUID'sini almak içinmssparkutils.runtime.contextöğesini kullanır. Farklı bir çalışma alanında özel bir SQL havuzu yapılandırmak için, özel SQL havuzlarını yapılandırmak istediğiniz çalışma alanının GUID'si ileworkspace_idöğesini güncelleyin.
import requests
import json
from notebookutils import mssparkutils

body = {
  "customSQLPoolsEnabled": True,
  "customSQLPools": [
    {
      "name": "ContosoSQLPool",
      "isDefault": False,
      "maxResourcePercentage": 70,
      "optimizeForReads": False,
      "classifier": {
        "type": "Application Name",
        "value": [
          "MyContosoApp"
        ]
      }
    },
    {
      "name": "AdhocPool",
      "isDefault": True,
      "maxResourcePercentage": 30,
      "optimizeForReads": True
    }
  ]
}

# This will get the workspaceId where this notebook is running.
# Update to the workspace_id (guid) if running this notebook outside of the workspace where the warehouse exists.
workspace_id = mssparkutils.runtime.context.get('currentWorkspaceId')

url = f'https://api.fabric.microsoft.com/v1/workspaces/{workspace_id}/warehouses/sqlPoolsConfiguration?beta=true'
response = requests.request(method='patch', url=url, json=body, headers={'Authorization': f'Bearer {mssparkutils.credentials.getToken("pbi")}'})

if response.status_code == 200:
    print("SQL Custom Pools configured successfully.")
else:
    print(response.text)
Tip
Fabric'den gelen trafik için şu yararlı Uygulama Adı (regex) sınıflandırıcı değerlerini kullanın:
- Fabric işlem hatlarından sorguları sınıflandırmak için
^Data Integration-to[0-9a-fA-F]{8}-[0-9a-fA-F]{4}-[1-5][0-9a-fA-F]{3}-[89abAB][0-9a-fA-F]{3}-[0-9a-fA-F]{12}$kullanın. - Power BI'dan sorguları sınıflandırmak için kullanın
^(PowerBIPremium-DirectQuery|Mashup Engine(?: \(PowerBIPremium-Import\))?). -
Fabric portal SQL sorgu düzenleyicisinden sorguları sınıflandırmak için
DMS_userkullanın.
SQL Server Management Studio'da (SSMS) uygulama adını ayarlama
Özel SQL havuzları için sınıflandırıcı, ortak bağlantı dizelerinin uygulama adı veya program adı parametresini kullanır.
SQL Server Management Studio'da (SSMS), ambar için sunucu adını belirtin ve kimlik doğrulaması sağlayın. Microsoft Entra MFA önerilir.
Gelişmiş düğmesini seçin.
Gelişmiş Özellikler sayfasındaki Bağlam'ın altında Uygulama Adı değerini olarak
MyContosoAppdeğiştirin.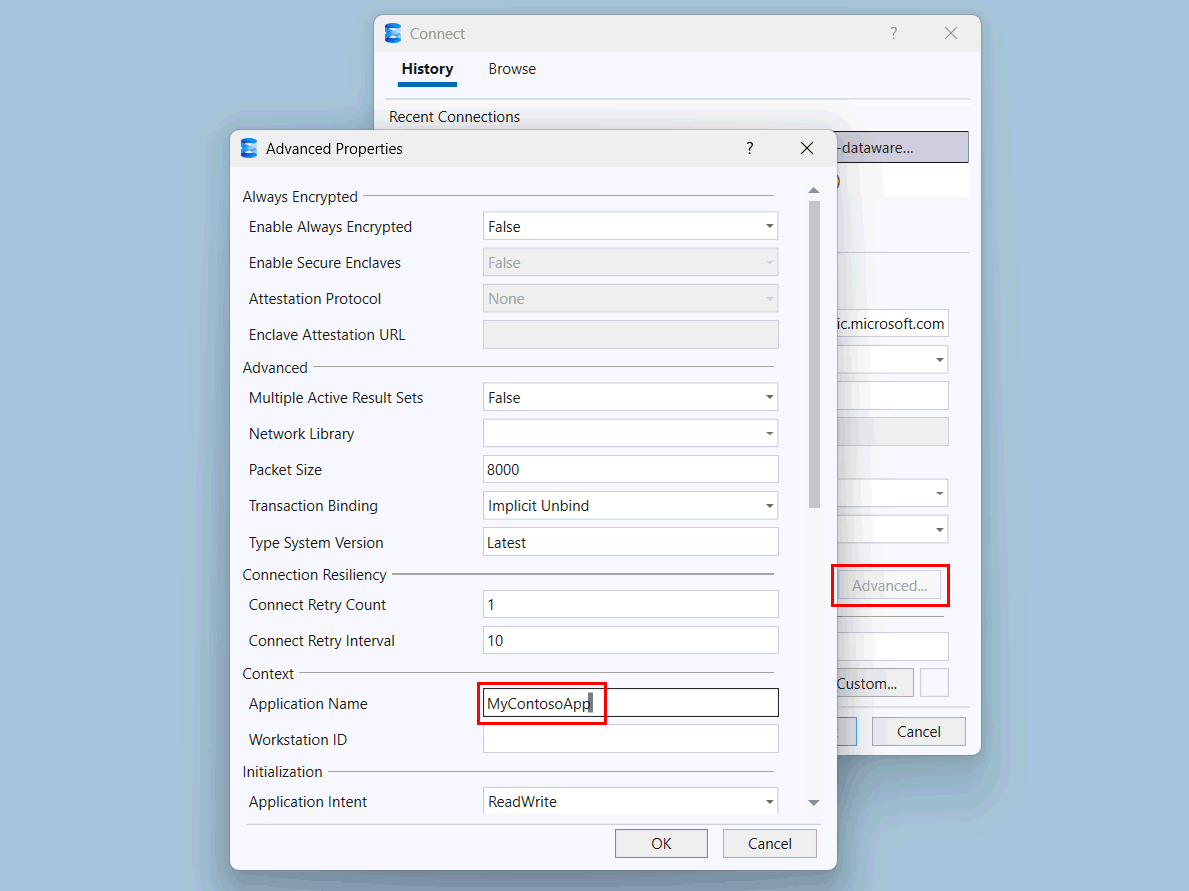
Tamam'ı seçin.
Bağlan seçeneğini seçin.
Bazı örnek etkinlikler oluşturmak için SSMS'de bu bağlantıyı kullanarak ambarınızda basit bir sorgu çalıştırın, örneğin:
SELECT *
FROM dbo.DimDate;
Özel SQL havuzu için sorgu içgörülerini gözlemleme
SSMS'den SQL altyapısına geçirilen uygulama adının
sys.dm_exec_sessionsolarak tanındığını görmek amacıylaMyContosoAppdinamik yönetim görünümünü gözden geçirin.SELECT session_id, program_name FROM sys.dm_exec_sessions WHERE program_name = 'MyContosoApp';Örneğin:
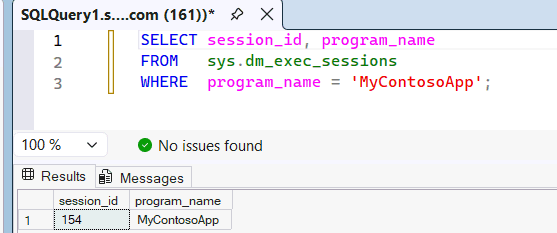
program_nameözel SQL havuzundaki uygulama adıyla eşleştiğindenMyContosoApp, bu sorgu bu havuzdaki kaynakları kullanır. Sorgunun hangi özel SQL havuzunu kullandığını kanıtlamak için queryinsights.exec_requests_history sistem görünümünü sorgulayabilirsiniz. Sorgu içgörülerinin doldurulmasını 10-15 dakika bekleyin ve ardından aşağıdaki sorguyu çalıştırın.SELECT distributed_statement_id, submit_time, program_name, sql_pool_name, start_time, end_time FROM queryinsights.exec_requests_history WHERE program_name = 'MyContosoApp';Sorgunun havuzunu, Statement ID veya İfade Kimliği'ne göre de tanımlayabilirsiniz. Fabric portalı SQL sorgu düzenleyicisinde, ambarınıza veya SQL analiz uç noktasına karşı bir sorgu çalıştırın.
SELECT *
FROM dbo.DimDate;
İletiler sekmesini seçin ve sorgu yürütme için Deyim Kimliğini kaydedin. SQL sorgu düzenleyicisinde,
program_nameDMS_userşeklindedir, ki daha önceMyContosoAppözel SQL havuzunu kullanmak üzere yapılandırdığınız.Sorgu içgörülerinin doldurulmasını 10-15 dakika bekleyin.
Uygun özel SQL havuzunun kullanıldığını doğrulamak için
sql_pool_nameve diğer bilgileri alın.SELECT distributed_statement_id, submit_time, program_name, sql_pool_name, start_time, end_time FROM queryinsights.exec_requests_history WHERE distributed_statement_id = '<Statement ID>';
Özel SQL havuzları yapılandırmasını geri alma
Çalışma alanını özgün durumuna döndürmek için customSQLPoolsEnabled özelliğini False olarak değiştirin. Özel SQL havuzları yapılandırmasını korumak istiyorsanız, her havuz adını listede olduğu gibi customSQLPools geçirmeniz gerekir.
Bu örnek Python kodu özel SQL havuzlarını devre dışı bırakır ve SELECT ve özel olmayan SELECT havuzların otonom iş yükü yönetimi yapılandırmasına geri döner.
PATCH isteği, customSQLPoolsEnabled özelliği False olarak ayarlanmış bir şekilde çağrılır.
import requests
import json
from notebookutils import mssparkutils

body = {
  "customSQLPoolsEnabled": False,
  "customSQLPools": []
}

# This will get the workspaceId where this notebook is running.
# Update to the workspace_id (guid) if running this notebook outside of the workspace where the warehouse exists.
workspace_id = mssparkutils.runtime.context.get('currentWorkspaceId')

url = f'https://api.fabric.microsoft.com/v1/workspaces/{workspace_id}/warehouses/sqlPoolsConfiguration?beta=true'
response = requests.request(method='patch', url=url, json=body, headers={'Authorization': f'Bearer {mssparkutils.credentials.getToken("pbi")}'})

if response.status_code == 200:
    print("SQL Custom Pools successfully disabled.")
else:
    print(response.text)