你当前正在访问 Microsoft Azure Global Edition 技术文档网站。 如果需要访问由世纪互联运营的 Microsoft Azure 中国技术文档网站,请访问 https://docs.azure.cn。
适用于: Azure 数据工厂 Azure Synapse Analytics
提示
Microsoft Fabric 中的 Data Factory 是下一代 Azure 数据工厂,具有更加简化的架构、内置人工智能和新功能。 如果不熟悉数据集成,请从Fabric数据工厂开始。 现有 ADF 工作负载可以升级到 Fabric,以跨数据科学、实时分析和报告访问新功能。
如果要分析Excel文件,请遵循本文。 该服务支持“.xls”和“.xlsx”。
以下连接器支持Excel格式:Amazon S3、Amazon S3 兼容存储、Azure Blob、Azure Data Lake Storage Gen1、Azure Data Lake Storage Gen2、Azure 文件存储、File System、FTP、Google Cloud Storage、HDFS、HTTP、Oracle Cloud Storage 和 SFTP。 它可以作为源,但不可作为接收器。
注意
使用 HTTP 时不支持“.xls”格式。
数据集属性
有关可用于定义数据集的各部分和属性的完整列表,请参阅数据集一文。 本部分提供Excel数据集支持的属性列表。
| 属性 | 描述 | 必需 |
|---|---|---|
| 类型 | 数据集的 type 属性必须设置为 Excel。 | 是 |
| 位置 | 文件的位置配置。 每个基于文件的连接器在 location 下都有其自己的位置类型和支持的属性。 |
是 |
| sheetName | 要读取数据的Excel工作表名称。 | 指定 sheetName 或 sheetIndex |
| sheetIndex | 要读取数据的Excel工作表索引,从 0 开始。 | 指定 sheetName 或 sheetIndex |
| 范围 | 给定工作表中用于定位选择性数据的单元格范围,例如: - 未指定:以表的形式从第一个非空行和列读取整个工作表 - A3:读取从给定单元格开始的表,动态检测下面的所有行和右侧的所有列- A3:H5:以表的形式读取此固定范围- A3:A3:读取此单个单元格 |
否 |
| firstRowAsHeader | 指定是否要将给定工作表/范围内的第一行视为带有列名的标题行。 允许的值为 true 和 true(默认值)。 |
否 |
| 空值 | 指定 null 值的字符串表示形式。 默认值为空字符串。 |
否 |
| 压缩 | 用来配置文件压缩的属性组。 如果需要在活动执行期间进行压缩/解压缩,请配置此部分。 | 否 |
| 类型 (在 compression 下) |
用来读取/写入 JSON 文件的压缩编解码器。 允许的值为 bzip2、gzip、deflate、ZipDeflate、TarGzip、Tar、snappy 或 lz4 。 默认设置是不压缩。 Note当前复制活动不支持“snappy”和“lz4”,映射数据流不支持“ZipDeflate”、“TarGzip”和“Tar”。 注意,使用复制活动来解压缩 ZipDeflate 文件并写入到基于文件的目标数据存储时,会将文件提取到以下文件夹:。 |
否。 |
| 水平仪 (在 compression 下) |
压缩率。 允许的值为 Optimal 或 Fastest。 - 最快:压缩操作应尽可能快地完成,即使生成的文件未能达到最佳压缩效果。 - 最佳:压缩操作应以最佳方式进行,甚至当操作需要更长时间完成时。 有关详细信息,请参阅 Compression Level(压缩级别)主题。 |
否 |
下面是Azure Blob 存储上Excel数据集的示例:
{
    "name": "ExcelDataset",
    "properties": {
        "type": "Excel",
        "linkedServiceName": {
            "referenceName": "<Azure Blob Storage linked service name>",
            "type": "LinkedServiceReference"
        },
        "schema": [ < physical schema, optional, retrievable during authoring > ],
        "typeProperties": {
            "location": {
                "type": "AzureBlobStorageLocation",
                "container": "containername",
                "folderPath": "folder/subfolder",
            },
            "sheetName": "MyWorksheet",
            "range": "A3:H5",
            "firstRowAsHeader": true
        }
    }
}
复制活动属性
有关可用于定义活动的各部分和属性的完整列表,请参阅管道一文。 本部分提供Excel源支持的属性列表。
Excel 作为数据源
在复制活动的*source*部分支持以下属性。
| 属性 | 描述 | 必需 |
|---|---|---|
| 类型 | 复制活动源的 type 属性必须设置为“ExcelSource”。 | 是 |
| 存储设置 | 有关如何从数据存储读取数据的一组属性。 每个基于文件的连接器在 storeSettings 下都有其自己支持的读取设置。 |
否 |
"activities": [
    {
        "name": "CopyFromExcel",
        "type": "Copy",
        "typeProperties": {
            "source": {
                "type": "ExcelSource",
                "storeSettings": {
                    "type": "AzureBlobStorageReadSettings",
                    "recursive": true
                }
            },
            ...
        }
        ...
    }
]
映射数据流属性
在映射数据流中,可以读取以下数据存储中的Excel格式:Azure Blob 存储、Azure Data Lake Storage Gen1、Azure Data Lake Storage Gen2、Amazon S3和SFTP。 可以使用Excel数据集或内联数据集来指向Excel文件。
源属性
下表列出了Excel源支持的属性。 可以在“源选项”选项卡中编辑这些属性。在使用内联数据集时,你会看到其他文件设置,这些设置与数据集属性部分描述的属性相同。
| 名称 | 描述 | 必需 | 允许的值 | 数据流脚本属性 |
|---|---|---|---|---|
| 通配符路径 | 将处理与通配符路径匹配的所有文件。 重写数据集中设置的文件夹和文件路径。 | 否 | String[] | 通配符路径 |
| 分区根路径 | 对于已分区的文件数据,可以输入分区根路径,以便将已分区的文件夹读取为列 | 否 | 字符串 | partitionRootPath |
| 文件列表 | 源是否指向某个列出待处理文件的文本文件 | 否 |
true 或 false |
文件列表 |
| 用于存储文件名的列 | 使用源文件名称和路径创建新列 | 否 | 字符串 | rowUrlColumn |
| 完成后 | 在处理后删除或移动文件。 文件路径从容器根开始 | 否 | 删除:true 或 false Move: ['<from>', '<to>'] |
purgeFiles moveFiles |
| 按上次修改时间筛选 | 选择根据上次更改时间筛选文件 | 否 | 时间戳 | modifiedAfter modifiedBefore |
| 允许找不到文件 | 如果为 true,则找不到文件时不会引发错误 | 否 |
true 或 false |
忽略未找到文件 |
源示例
下图是使用数据集模式映射数据流中的Excel源配置的示例。
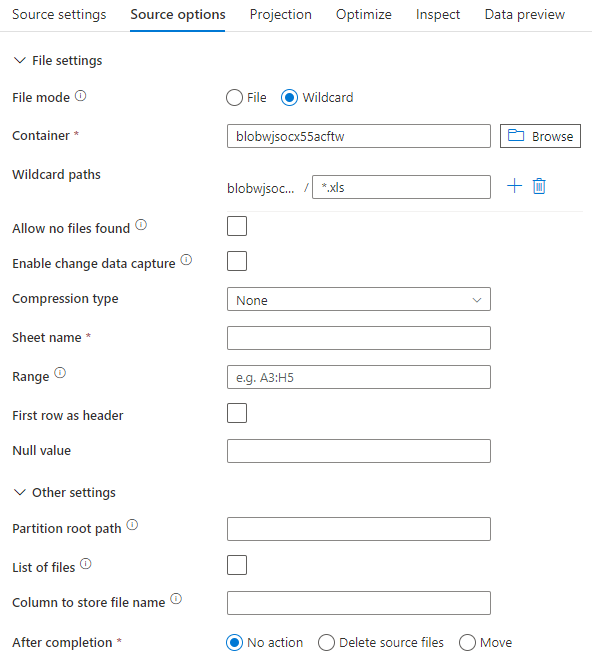
关联的数据流脚本为:
source(allowSchemaDrift: true,
    validateSchema: false,
    wildcardPaths:['*.xls']) ~> ExcelSource
如果你使用内联数据集,则会在映射数据流中看到以下源选项。
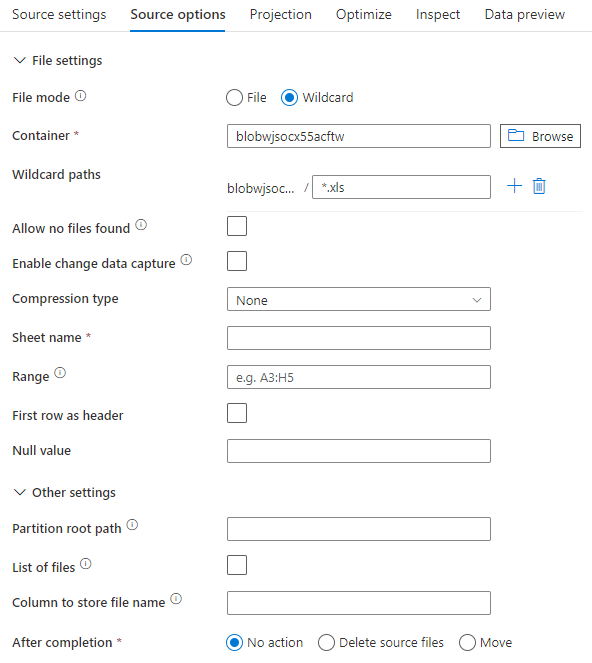
关联的数据流脚本为:
source(allowSchemaDrift: true,
    validateSchema: false,
    format: 'excel',
    fileSystem: 'container',
    folderPath: 'path',
    fileName: 'sample.xls',
    sheetName: 'worksheet',
    firstRowAsHeader: true) ~> ExcelSourceInlineDataset
注意
映射数据流不支持读取受保护的Excel文件,因为这些文件可能包含机密性通知,或强制实施限制其内容访问的特定访问限制。
处理非常大的Excel文件
Excel连接器不支持对复制活动进行流式传输读取,并且必须先将整个文件加载到内存中,然后才能读取数据。 若要导入架构、预览数据或刷新Excel数据集,必须在 http 请求超时(100 秒)之前返回数据。 对于大型Excel文件,这些操作可能不会在该时间范围内完成,从而导致超时错误。 如果要将大型Excel文件(>100MB)移到另一个数据存储中,可以使用以下选项之一来解决此限制:
- 使用自承载集成运行时(SHIR),然后使用复制活动将大型Excel文件移动到 SHIR 的另一个数据存储中。
- 将大型Excel文件拆分为几个较小的文件,然后使用复制活动移动包含文件的文件夹。
- 使用数据流活动将大型Excel文件移到另一个数据存储中。 数据流支持对Excel进行流式传输读取,并且可以快速移动/传输大型文件。
- 手动将大型Excel文件转换为 CSV 格式,然后使用复制活动移动文件。