你当前正在访问 Microsoft Azure Global Edition 技术文档网站。 如果需要访问由世纪互联运营的 Microsoft Azure 中国技术文档网站,请访问 https://docs.azure.cn。
✔️ 适用于: 使用 Microsoft.Storage 资源提供程序创建的经典 SMB 和 NFS 文件共享
✔️ 适用于:使用 Microsoft.FileShares 资源提供程序创建的文件共享
Azure 文件存储可满足大多数应用程序和用例的性能要求。 本文介绍影响文件共享性能的不同因素,以及如何优化工作负荷Azure 文件存储的性能。
存储性能术语表
在阅读本文之前,了解与存储性能相关的一些关键术语会很有帮助:
每秒 IO 操作次数 (IOPS)
IOPS(每秒输入/输出操作数)衡量的是每秒进行的文件系统操作数。 在Azure 文件存储文档中,术语“IO”与术语“操作”和“事务”可互换。
I/O 大小
I/O 大小(有时称为块大小)是指应用程序用于对存储执行单个输入/输出 (I/O) 操作的请求大小。 根据应用程序的不同,I/O 尺寸的范围可以从较小的 4 KiB 到更大尺寸。 I/O 大小在可实现的吞吐量中起着重要作用。
吞吐量
吞吐量衡量每秒从存储读取或写入存储的位数,以每秒兆字节(MiB/秒)度量。 若要计算吞吐量,请将 IOPS 和 I/O 大小相乘。 例如,10,000 IOPS × 1 MiB I/O 大小 = 10 GiB/s,而 10,000 IOPS × 4 KiB I/O 大小 = 38 MiB/s。
延迟
延迟是延迟的同义词,以毫秒为单位(ms)。 有两种类型的延迟:端到端延迟和服务延迟。 有关详细信息,请参阅延迟。
队列深度
队列深度是存储资源在任何时间可处理的挂起 I/O 请求数。 有关详细信息,请参阅队列深度。
根据使用模式选择媒体层
Azure 文件存储提供了两个存储媒体层,可用于平衡性能和价格:SSD 和 HDD。 在存储帐户级别为文件共享选择媒体层。 在特定媒体层中创建存储帐户后,无法在 不手动迁移到新文件共享的情况下移动到其他媒体层。
在 SSD 和 HDD 文件共享之间进行选择时,请考虑计划Azure 文件存储上运行的预期使用模式的要求。 如果需要大量的 IOPS、快速数据传输速度或低延迟,请选择 SSD 文件共享。
下表汇总了 SSD 和 HDD 文件共享之间的预期性能目标。 有关详细信息,请参阅 Azure 文件存储可伸缩性和性能目标。
| 使用模式要求 | SSD | HDD |
|---|---|---|
| 写入延迟(个位数毫秒) | 是 | 是 |
| 读取延迟(个位数毫秒) | 是 | 否 |
SSD 文件共享采用预配模型,可根据共享大小保证以下性能指标。 有关详细信息,请参阅预配的 v1 模型。
性能最佳做法
无论是评估新工作负荷还是现有工作负荷的性能要求,了解使用模式都有助于实现可预测的性能。
延迟敏感度: 对读取延迟敏感且对最终用户具有较高可见性的工作负荷更适用于 SSD 文件共享,这可以为读取和写入操作提供单毫秒延迟(对于较小的 I/O 大小小于 2 毫秒)。
IOPS 和吞吐量要求: SSD 文件共享支持比 HDD 文件共享更大的 IOPS 和吞吐量限制。 有关详细信息,请参阅 文件共享缩放目标。
工作负荷持续时间和频率: 与长时间运行的频繁工作负荷相比,短(分钟)和不频繁(每小时)工作负荷不太可能达到 HDD 文件共享的上限。 在 SSD 文件共享上,工作负荷持续时间有助于根据预配的存储、IOPS 和吞吐量确定要使用的正确性能配置文件。 一个常见的错误是仅运行几分钟的性能测试,这通常是误导性的。 为了获得真实的性能,确保测试频率和持续时间足够高。 对于预配的文件共享,短测试可以测量基于信用的突发 IOPS,而不是预配 IOPS。 更多信息请参见 Bursting。
工作负荷并行化: 对于并行执行作的工作负荷(例如,在同一客户端上通过多个线程、进程或应用程序实例),SSD 文件共享比 HDD 文件共享具有明显的优势:SMB 多通道。 有关详细信息,请参阅改进 SMB Azure文件共享性能。
API 操作分布:元数据密集型工作负荷(例如针对大量文件执行读取操作的工作负荷)更适合 SSD 文件共享。 有关详细信息,请参阅 元数据或命名空间密集型工作负荷。
区域放置:使用 区域放置 选择存储帐户所在的特定可用性区域。 此功能允许将 VM 放置在与存储相同的可用性区域中,这可以减少高达 30% 的延迟。 此功能目前仅适用于 支持区域中使用本地冗余存储(LRS)的 SSD 存储帐户。
突发
使用配置 v2 或 provisioned v1 计费模型的文件共享支持基于信用的 IOPS 突发。 基于额度的突发功能允许文件共享在有限时间内使用超出其预配值的 IOPS。 基于额度的突发是文件共享的一项功能。 突发流量是一种工作负载模式,伴随着IOPS或吞吐量的短暂峰值。 基于额度的突发机制可以吸收突发流量带来的短暂 IOPS 峰值。
基于额度的突发包含在预配文件共享的费用内,不会产生额外帐单费用。 基于信用的突发能力仅适用于IOPS。 它不会让吞吐量超过配置吞吐量。
按需付费的文件共享不支持突发性能。 启用了突发的经典文件共享仍受存储帐户的 IOPS 限制约束。 欲了解更多信息,请参见 经典文件共享数据平面限制。 有关突发如何影响成本的信息,请参见“了解 Azure 文件存储 计费”。
预配 v2 突发
基于额度的 IOPS 突发提供更高的 IOPS 使用灵活性。 将此灵活性用作针对意外 IO 峰值的缓冲区。 对于固定的 I/O 模式,请为 I/O 峰值预留资源。
每当文件共享的流量低于预配(基线)IOPS 时,就会累积突发 IOPS 额度。 每当文件共享的 IOPS 使用率超过预配的 IOPS,并且有可用的突发 IOPS 积分时,文件共享可以达到允许的最大突发 IOPS 限制。 只要还有剩余额度,文件共享就可以基于累积的突发额度数量继续突发。 超出预配 IOPS 的每个 IO 都会消耗一个信用额度。 所有积分用尽后,该份额将恢复为预配置的 IOPS。 针对文件共享的 IOPS 无需采取任何特殊措施即可使用突发。 突发是按照尽力而为的原则进行的。
共享额度具有三种状态:
- 累积,当文件共享使用的 IOPS 少于预配的 IOPS 时将进入此状态。
- 下降,当文件共享使用的 IOPS 超过预配的 IOPS 且处于突发模式时,将进入此状态。
- 常量,当文件共享完全使用预配的 IOPS 且没有累积或使用的信用额度时。
新文件共享最初在其突发桶中包含所有额度。 如果由于服务器限制导致共享 IOPS 低于预配的限制,则不会累积突发额度。 以下公式用于确定突发 IOPS 限制和文件共享可用的额度数量:
| Item | SSD 公式 | HDD 公式 |
|---|---|---|
| 突发 IOPS 限制 | MIN(MAX(3 * ProvisionedIOPS, 10000), 102400) |
MIN(MAX(3 * ProvisionedIOPS, 5000), 50000) |
| 突发 IOPS 额度 | (BurstLimit - ProvisionedIOPS) * 3600 |
(BurstLimit - ProvisionedIOPS) * 3600 |
下表演示了这些适用于各种预配 IOPS 量的公式的几个示例:
| 预配的 IOPS | SSD 突发 IOPS 限制 | SSD 突发额度 | HDD 突发 IOPS 限制 | HDD 突发额度 |
|---|---|---|---|---|
| 500 | -- | -- | 最多 5,000 | 16,200,000 |
| 1,000 | -- | -- | 最多 5,000 | 14,400,000 |
| 3,000 | 最高 10,000 | 25,200,000 | 最多 9,000 | 21,600,000 |
| 5,000 | 最多 15,000 人 | 36,000,000 | 最多 15,000 人 | 36,000,000 |
| 10,000 | 最多 30,000 | 72,000,000 | 最多 30,000 | 72,000,000 |
| 25,000 | 最多 75,000 | 180,000,000 | 最多 50,000 | 90,000,000 |
| 50,000 | 最大 102,400 | 188,640,000 | 最多 50,000 | 0 |
| 75,000 | 最大 102,400 | 98,640,000 | -- | -- |
| 102,400 | 最大 102,400 | 0 | -- | -- |
预配 v1 突发
配置型 v1 版本支持两种突发方式:基于信用的突发,无需额外费用;以及付费突发,您可以选择启用,以便按使用量付费使用超过预配量的 IOPS 和吞吐量。
预配 v1 基于额度的突发
基于额度的 IOPS 突发提供更高的 IOPS 使用灵活性。 将此灵活性用作针对意外 IO 峰值的缓冲区。 对于固定的 I/O 模式,请为 I/O 峰值预留资源。
每当经典文件共享的流量低于预配(基线)IOPS 时,就会累积突发 IOPS 额度。 每当经典文件共享的 IOPS 使用率超过预配的 IOPS 并且存在可用的突发 IOPS 额度时,经典文件共享可以突发到允许的最大突发 IOPS 限制。 只要还有剩余额度,经典文件共享就可以基于累积的突发额度数量继续突发。 超出预配 IOPS 的每个 IO 都会消耗一个信用额度。 所有信用额度用尽后,经典文件共享会回到配置后的IOPS。 针对经典文件共享的 IOPS 无需执行任何特殊操作即可使用突发。 突发是按照尽力而为的原则进行的。
共享额度具有三种状态:
- 当经典文件共享使用的 IOPS 小于预配的 IOPS 时,会进行积累。
- 下降,当经典文件共享使用的 IOPS 超过预配的 IOPS 且处于突发模式时,将进入此状态。
- 常量,当经典文件共享完全使用预配的 IOPS 并且没有累积或使用的信用额度时。
新经典文件共享最初在其突发桶中包含所有额度。 如果由于服务器限制导致共享 IOPS 低于预配的限制,则不会累积突发额度。 以下公式用于计算经典文件共享的突发 IOPS 限制和可能的积分数:
| Item | Formula |
|---|---|
| 突增限制 | MIN(MAX(3 * ProvisionedStorageGiB, 10000), 102400) |
| 突发额度 | (BurstLimit - BaselineIOPS) * 3600 |
下表说明了预配大小的这些公式的几个示例:
| 容量(GiB) | 基准 IOPS | 突发 IOPS | 突发额度 | 吞吐量(MiB/秒) |
|---|---|---|---|---|
| 100 | 3,100 | 最高 10,000 | 24,840,000 | 110 |
| 500 | 3,500 | 最高 10,000 | 23,400,000 | 150 |
| 1,024 | 4,024 | 最高 10,000 | 21,513,600 | 203 |
| 5,120 | 8,120 | 最大 15,360 | 26,064,000 | 613 |
| 10,240 | 13,240 | 最大 30,720 | 62,928,000 | 1,125 |
| 33,792 | 36,792 | 最多达到101,376 | 232,502,400 | 3,480 |
| 51,200 | 54,200 | 最大 102,400 | 173,520,000 | 5,220 |
| 102,400 | 102,400 | 最大 102,400 | 0 | 10,340 |
预配 v1 付费突发
付费突发是预配 v1 模型的一项高级功能,旨在为不希望受到限制的客户提供支持。 付费突发会对超过预配存储的任何 IOPS 或吞吐量添加额外的基于使用量的计费。 此功能与基于信用的突发功能不同,后者作为已配置存储的一部分免费提供。 虽然付费突发可为预配经典文件共享的方式提高强大的灵活性,但如果使用不当,也可能导致意外计费。
与基于额度的突发一样,付费突发不能替代预配正确数量的 IOPS 和吞吐量的做法。 相反,如果你有意外的需求,它可以进一步防止出现限制。 如果您对 IOPS 或吞吐量的使用量保持稳定,通过存储预配置来预留足够的 IOPS 和吞吐量以满足需求,比依赖付费突发功能更为经济。
默认情况下,付费突发处于禁用状态,但可按照更改预配 v1 经典文件共享的成本和性能特征的说明将其启用(仅限 PowerShell 和 CLI)。 如果您启用了付费突发功能,请通过 Azure Monitor 中的以下指标监控 IOPS 和吞吐量使用情况:
- 文件共享预配的 IOPS
- 文件共享预配带宽 MiB/s (吞吐量)
- 事务(最大 IOPS)
- 带宽(最大 MiB/秒)(吞吐量)
- IOPS 的突发额度(基于额度的突发)
- 付费突发 IOS (IO)
- 付费突发带宽
延迟
考虑延迟时,首先了解Azure 文件存储如何确定延迟。 最常见的度量是与端到端延迟和服务延迟指标关联的延迟。 使用这些 事务指标 ,通过显示应用程序流量在传入和传出客户端时花费的时间,有助于识别客户端延迟和网络问题。
端到端延迟 (SuccessE2ELatency) 是指事务执行完整往返所花费的总时间(完整往返从客户端开始,跨网络,传到 Azure 文件存储服务,然后返回客户端的)。
服务延迟(SuccessServerLatency)是事务仅在Azure 文件存储内往返所需的时间。 此度量不包括任何客户端或网络延迟。
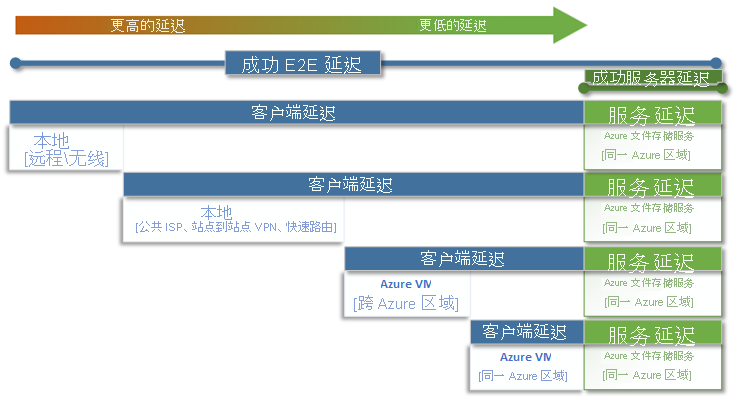
SuccessE2ELatency 的值和 SuccessServerLatency 的值之间的差异就是可能由网络或客户端引起的延迟。
将客户端延迟与服务延迟(在此情况下,是 Azure 文件存储性能)相混淆的情况很常见。 例如,如果服务延迟报告为低延迟,而端到端延迟显示请求延迟非常高,则全部耗时都花在往返客户端的传输过程中,而不是耗费在 Azure 文件存储 服务中。
此外,如图所示,你离服务越远,延迟体验越慢,实现任何云服务的性能缩放限制就越困难。 从本地访问Azure 文件存储时,这种情况尤其如此。 虽然Azure ExpressRoute等选项非常适合本地,但它们仍然与在同一Azure区域中完全运行的应用程序(计算 + 存储)的性能不匹配。
提示
要对到 Azure 连接的网络功能进行基线化,一种有效且实用的方法是使用 Azure 中的 VM 来测试本地与 Azure 之间的性能。 线路尺寸不足或未正确路由的 ExpressRoute 或 VPN 网关可能会显著降低在 Azure 文件上运行的工作负荷的效率。
队列深度
队列深度是存储资源可处理的未完成 I/O 请求数。 随着存储系统使用的磁盘从 HDD 轴(IDE、SATA、SAS)演变为固态设备(SSD、NVMe),它们也演变为支持更高的队列深度。 队列深度较低的示例是这样一种情况:有一个由单个客户端组成的工作负载,它与大型数据集中的单个文件进行串行交互。 相比之下,支持多个线程和多个文件的并行的工作负载可以轻松实现高队列深度。 由于Azure 文件存储是一种分布式文件服务,它跨越数千个Azure群集节点,旨在大规模运行工作负荷、生成和测试具有高队列深度的工作负荷。
可以通过多种不同的方式实现高队列深度。 若要确定工作负荷的队列深度,请将客户端数乘以线程数(客户端×文件×线程 = 队列深度)。
下表说明了可用于实现更高队列深度的各种组合。 虽然队列深度可以超过 64 这一最佳值,但不建议这样做。 如果这样做,你将看不到更多性能提升,并且由于 TCP 饱和,延迟可能会增加。
| 客户 | 文件 | 线程 | 队列深度 |
|---|---|---|---|
| 1 | 1 | 1 | 1 |
| 1 | 1 | 2 | 2 |
| 1 | 2 | 2 | 4 |
| 2 | 2 | 2 | 8 |
| 2 | 2 | 4 | 16 |
| 2 | 4 | 4 | 32 |
| 1 | 8 | 8 | 64 |
| 4 | 4 | 2 | 32 |
提示
若要达到较高的性能限制,请确保工作负荷或基准测试使用多个文件进行多线程处理。
单线程与多线程应用程序
Azure 文件存储最适合多线程应用程序。 了解多线程对工作负荷的性能影响的最简单方法是按 I/O 演练方案。 在以下示例中,你有一项工作负载,需要尽可能快地将 10,000 个小文件复制到 Azure 文件共享,或从 Azure 文件共享中复制出来。
此表根据按 4 KiB 块大小写入的单线程应用程序,细分在 Azure 文件共享上创建单个 16 KiB 文件所需的时间(以毫秒为单位)。
| I/O 操作 | 创建 | 4 KiB 写入 | 4 KiB 写入 | 4 KiB 写入 | 4 KiB 写入 | 关闭 | 总计 |
|---|---|---|---|---|---|---|---|
| 线程 1 | 3 毫秒 | 2 毫秒 | 2 毫秒 | 2 毫秒 | 2 毫秒 | 3 毫秒 | 14 ms |
在此示例中,从六个操作创建单个 16 KiB 文件大约需要 14 毫秒。 如果单线程应用程序要将 10,000 个文件移动到 Azure 文件共享,该操作耗时为 140,000 毫秒(14 毫秒 × 10,000),即 140 秒,因为这些文件是逐个按顺序移动的。 每个请求的服务时间主要取决于计算和存储彼此之间的距离,如上一部分所述。
通过使用八个线程而不是一个线程,可以将上述工作负荷从 140,000 毫秒(140 秒)减少到 17,500 毫秒(17.5 秒)。 如下表所示,与每次只移动 1 个文件相比,并行移动 8 个文件时,移动相同数量的数据所需时间可减少 87.5%。
| I/O 操作 | 创建 | 4 KiB 写入 | 4 KiB 写入 | 4 KiB 写入 | 4 KiB 写入 | 关闭 | 总计 |
|---|---|---|---|---|---|---|---|
| 线程 1 | 3 毫秒 | 2 毫秒 | 2 毫秒 | 2 毫秒 | 2 毫秒 | 3 毫秒 | 14 ms |
| 线程 2 | 3 毫秒 | 2 毫秒 | 2 毫秒 | 2 毫秒 | 2 毫秒 | 3 毫秒 | 14 ms |
| 线程 3 | 3 毫秒 | 2 毫秒 | 2 毫秒 | 2 毫秒 | 2 毫秒 | 3 毫秒 | 14 ms |
| 线程 4 | 3 毫秒 | 2 毫秒 | 2 毫秒 | 2 毫秒 | 2 毫秒 | 3 毫秒 | 14 ms |
| 线程 5 | 3 毫秒 | 2 毫秒 | 2 毫秒 | 2 毫秒 | 2 毫秒 | 3 毫秒 | 14 ms |
| 线程 6 | 3 毫秒 | 2 毫秒 | 2 毫秒 | 2 毫秒 | 2 毫秒 | 3 毫秒 | 14 ms |
| 线程 7 | 3 毫秒 | 2 毫秒 | 2 毫秒 | 2 毫秒 | 2 毫秒 | 3 毫秒 | 14 ms |
| 线程 8 | 3 毫秒 | 2 毫秒 | 2 毫秒 | 2 毫秒 | 2 毫秒 | 3 毫秒 | 14 ms |