适用于: SQL Server 2016 (13.x) 及以后版本 Azure SQL 数据库Azure SQL 托管实例Microsoft Fabric 中的 SQL 数据库
系统版本化的时序表会在其历史表中保留每一行的每个前版本。 在以下条件下,历史表可能会比普通表更大地增加你的数据库大小:
- 你可以长时间保存历史数据。
- 你采用的是以大量更新或删除操作为主的数据修改模式。
庞大且不断增长的历史表可能会成为问题,既因为存储成本,也因为它对时间查询施加的性能负担。 为历史表制定数据保留策略是规划和管理每个时序表生命周期的重要部分。
制定数据保留政策
要管理时间表数据保留,首先确定每个时表所需的保留时间。 在大多数情况下,你的保留策略应成为使用时序表应用的业务逻辑的一部分。 例如,数据审计和时间旅行场景中的应用,对历史数据必须可供在线查询的时长有严格要求。
确定数据保留期后,制定管理历史数据的计划。 必须确定存储历史数据的方式和位置,以及如何删除超过保留要求的历史数据。
本文中的每个方法都作用于当前表格中对应周期末的列,即 ValidTo 以下示例中的该列。 每一行的周期结束值决定了该行版本何时变为关闭,也就是何时进入历史记录表。 例如,条件 ValidTo < DATEADD (DAY, -30, SYSUTCDATETIME()) 匹配超过 30 天前的历史数据。
选择以下方法之一来处理这些行:
| Approach | 工作原理 | 何时使用它 |
|---|---|---|
| 时间历史保留政策 | 你为每个表格设置保留期,后台任务会自动删除过时的行。 | 最简单的办法是直接删除过时的历史。 |
| 表分区 | 滑动窗口会把历史表中最早的分区切换出来,这样你可以归档或丢弃它。 | 当你想在移除之前归档历史数据,或者想要消除分区以进行时间查询时。 |
| 自定义清理脚本 | 定时脚本会禁用系统版本控制,将旧行分段删除,然后重新启用系统版本控制。 | 当表不支持保留策略,且无法进行分区时。 |
本文中的分区和自定义清理示例使用了 “创建系统版本化时序表 ”条目的样本。
使用时间历史保留策略
适用于:SQL Server 2017(14.x)及以后版本,Azure SQL 数据库、Azure SQL 托管实例 以及 Microsoft Fabric 中的 SQL 数据库。
你可以在单个表层面配置时间历史保留,这样可以创建灵活的老化策略。 为了实现时间保留,可以在表创建或模式变更时设置 HISTORY_RETENTION_PERIOD 。
定义保留策略后,数据库引擎会运行一项计划的后台任务,查找并自动删除期末值早于保留期限的历史行。
如何配置保留策略
配置时态表的保留策略之前,请检查是否已在数据库级别启用时态历史记录保留:
SELECT is_temporal_history_retention_enabled,
       name
FROM sys.databases;
数据库标志 is_temporal_history_retention_enabled 默认为 ON,但你可以通过 语 ALTER DATABASE 句来更改它。 数据库引擎还会在执行时间点还原 (PITR) 操作后自动将其设置为 OFF,如 时间点还原注意事项 中所述。 若要为数据库启用时态历史记录保留清理,请运行以下语句。 用你想修改的数据库替换 <myDB> :
ALTER DATABASE [<myDB>]
    SET TEMPORAL_HISTORY_RETENTION ON;
Important
即使is_temporal_history_retention_enabled是 OFF,你也可以配置时序表的保留,但在这种情况下,数据库引擎 不会自动触发过时行的清理。
你可以在创建表时通过指定参数值 HISTORY_RETENTION_PERIOD 来配置保留策略:
CREATE TABLE dbo.WebsiteUserInfo
(
    UserID INT NOT NULL PRIMARY KEY CLUSTERED,
    UserName NVARCHAR (100) NOT NULL,
    PagesVisited INT NOT NULL,
    ValidFrom DATETIME2 (0) GENERATED ALWAYS AS ROW START,
    ValidTo DATETIME2 (0) GENERATED ALWAYS AS ROW END,
    PERIOD FOR SYSTEM_TIME (ValidFrom, ValidTo)
)
WITH (
    SYSTEM_VERSIONING = ON (
        HISTORY_TABLE = dbo.WebsiteUserInfoHistory,
        HISTORY_RETENTION_PERIOD = 6 MONTHS
    )
);
在实施该策略后,dbo.WebsiteUserInfoHistory 中的行在满足以下条件时即可被清理:
ValidTo < DATEADD (MONTH, -6, SYSUTCDATETIME())
你可以在 、 WEEKS、 MONTHS或 YEARS中指定保留期DAYS。 如果省略 HISTORY_RETENTION_PERIOD,保留时间默认为 INFINITE。 也可以显式使用 INFINITE 关键字。
在某些情况下,你可能想在创建表后配置保留值,或者更改之前配置的值。 在这种情况下,请使用 ALTER TABLE 语句:
ALTER TABLE dbo.WebsiteUserInfo
    SET (SYSTEM_VERSIONING = ON (HISTORY_RETENTION_PERIOD = 9 MONTHS));
Important
将 SYSTEM_VERSIONING 设置为 OFF 不会保留保留期值。 将 SYSTEM_VERSIONING 设置为 ON 而未显式指定 HISTORY_RETENTION_PERIOD 会导致保留 INFINITE。
要查看保留策略的当前状态,请使用以下示例。 该查询将数据库级别的时态保留启用标志与单个表的保留期相联接:
SELECT DB.is_temporal_history_retention_enabled,
       SCHEMA_NAME(T1.schema_id) AS TemporalTableSchema,
       T1.name AS TemporalTableName,
       SCHEMA_NAME(T2.schema_id) AS HistoryTableSchema,
       T2.name AS HistoryTableName,
       T1.history_retention_period,
       T1.history_retention_period_unit_desc
FROM sys.tables AS T1
    OUTER APPLY (
        SELECT is_temporal_history_retention_enabled
        FROM sys.databases
        WHERE name = DB_NAME()
) AS DB
    LEFT OUTER JOIN sys.tables AS T2
        ON T1.history_table_id = T2.object_id
WHERE T1.temporal_type = 2;
数据库引擎如何删除陈旧行
清理过程具体取决于历史记录表的索引布局。 你可以只在拥有集群行存储(B树)或集群列存储索引的历史表上配置有限保留策略。 后台任务对所有具有有限保留期的时序表进行老化数据清理。
注释
文档在提到索引时一般使用 B 树这个术语。 在行存储索引中,数据库引擎实现了 B+ 树。 这不适用于列存储索引或内存优化表上的索引。 有关详细信息,请参阅 SQL Server 以及 Azure SQL 索引体系结构和设计指南。
B 树行存储索引
行存储聚集索引必须以对应于 SYSTEM_TIME 周期结束时间的列开头。 如果没有这样的索引,你就无法配置有限的保留期:
Msg 13765, Level 16, State 1
Setting finite retention period failed on system-versioned temporal table
'dbo.WebsiteUserInfo' because the history table 'dbo.WebsiteUserInfoHistory'
does not contain required clustered index. Consider creating a clustered
columnstore or B-tree index starting with the column that matches end of
SYSTEM_TIME period, on the history table.
默认历史表已经有一个合规的集群索引。 如果你尝试将该索引丢弃到具有有限保留期的历史表上,操作会因以下错误而失败:
Msg 13766, Level 16, State 1
Cannot drop the clustered index 'WebsiteUserInfoHistory.IX_WebsiteUserInfoHistory'
because it is being used for automatic cleanup of aged data. Consider setting HISTORY_RETENTION_PERIOD to INFINITE on the corresponding system-versioned
temporal table if you need to drop this index.
行存储集群索引的清理逻辑会将旧行分成更小的块(最多10,000块)删除,最大限度地减少对数据库日志和I/O子系统的压力。 虽然清理逻辑使用了所需的 B 树索引,但它无法保证超过保留期的行的删除顺序。 因此,请不要对应用程序中的清理顺序有任何依赖。
聚集列存储索引
集群列存储的清理任务是一次性移除整个 行组 。 每个行组通常包含一百万行。 这种方法更高效,尤其是在工作负载生成历史数据速度很快时。
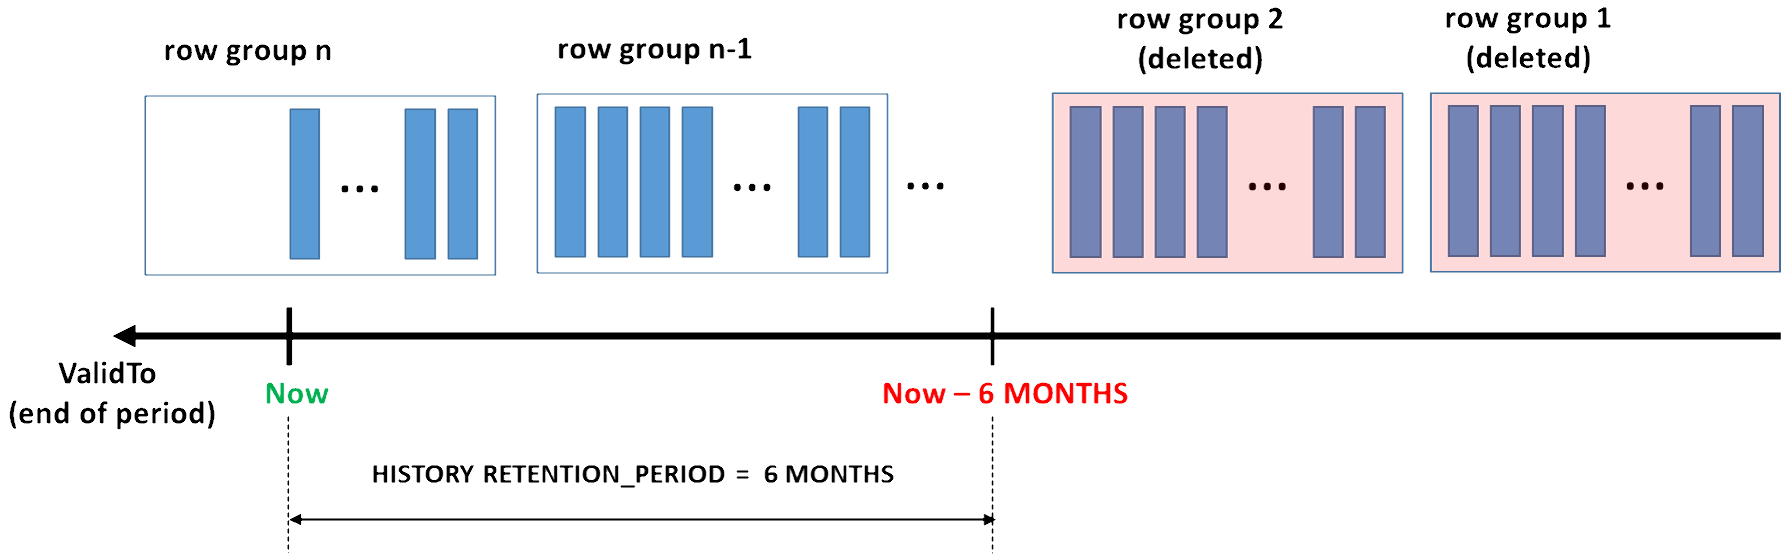
当工作负载快速生成大量的历史数据时,数据压缩和保留数据清理使得聚集列存储索引成为绝佳的选择。 这种模式在使用时序表进行变更跟踪和审计、趋势分析或物联网(IoT)数据摄取的密集 交易处理工作负载 中很常见。
当历史行以升序(按期末列排序)写入时,聚集列存储索引的清理操作效果最佳。 当只有 SYSTEM_VERSIONING 机制填充历史表时,这种条件总是成立。 如果历史表中的行没有按周期结束列排序(迁移现有历史数据时可能出现这种情况),请在正确排序的B树行存储索引上重新创建聚类列存储索引,以实现最佳性能。
避免在具有有限保留期的历史表上重建集群列存储索引,因为重建可能会改变系统版本管理操作自然施加的行组排序。 如果需要重建历史表上的聚集列存储索引,请在符合要求的 B 树索引之上将其重新创建,以保留定期数据清理所必需的行组顺序。 如果要基于现有历史表创建临时表,而该历史表具有不能保证数据顺序的聚集列存储索引,请采用相同的方法:
/* Create B-tree ordered by the end-of-period column */
CREATE CLUSTERED INDEX IX_WebsiteUserInfoHistory
    ON WebsiteUserInfoHistory(ValidTo) WITH (DROP_EXISTING = ON);
GO

/* Re-create the clustered columnstore index */
CREATE CLUSTERED COLUMNSTORE INDEX IX_WebsiteUserInfoHistory
    ON WebsiteUserInfoHistory WITH (DROP_EXISTING = ON);
当你为带有集群列存储索引的历史表配置有限保留期时,你无法在该表上创建额外的非集群B树索引:
CREATE NONCLUSTERED INDEX IX_WebHistNCI
    ON WebsiteUserInfoHistory(UserName);
之前的陈述因以下错误而失败:
Msg 13772, Level 16, State 1
Cannot create non-clustered index on a temporal history table 'WebsiteUserInfoHistory' since it has finite retention period and clustered columnstore index defined.
包含保留策略的查询表
时间表上的所有查询都会自动过滤掉与有限保留策略匹配的历史行,以避免不可预测和不一致的结果。 清理任务会在任何 时间点、任意顺序删除过时的行。
以下截图展示了基本查询的查询计划。 此示例假设 WebsiteUserInfo 表的保留期为一个 MONTH:
SELECT *
FROM dbo.WebsiteUserInfo FOR SYSTEM_TIME ALL;
查询计划在历史表的聚集索引扫描操作符(在下图中高亮显示)中,对期末列 (ValidTo) 添加了一个额外的筛选器。

如果你直接查询历史表,可能会看到比指定保留期更早的行,但无法保证查询结果的可重复性。 以下截图展示了历史表查询的查询计划,没有额外筛选:

不要依赖那些在保留期之后读取历史表的业务逻辑,因为你可能会得到不一致或意想不到的结果。 使用带有 子 FOR SYSTEM_TIME 句的时序查询来分析时间表中的数据。
时间点还原注意事项
当你将数据库恢复到某个特定时间点时,新数据库在数据库层面会被禁用时间保留(is_temporal_history_retention_enabled 设置为 OFF)。 此行为使你能够在清理任务删除历史行之前,检查保留期之前的历史行。 要在已还原的数据库上恢复自动清理,请将 TEMPORAL_HISTORY_RETENTION 重新设置为 ON。
注释
在 Azure SQL 数据库 的高级层创建的数据库可以保留最多 35 天的备份,因此你可以将其恢复到该窗口内的任何时间点。 对于保留期为一个月的临时表,这使你能够通过直接查询恢复数据库中的历史表,来检查最多 65 天前的历史行。
使用表分区
已分区表和索引可以使大型表更易于管理和扩展。 通过使用表分区方法,你可以基于时间条件实现自定义数据清理或离线归档。 在使用分区消除查询数据历史记录子集中的临时表时,表分区还可带来性能优势。
使用表分区实现滑动窗口,将历史表中最早的部分移出,并保持保留部分大小与年龄不变。 滑动窗口在历史表中保留等同于所需保留期的数据。 历史表支持在 ON 为 SYSTEM_VERSIONING 时切换出数据,这意味着你可以清理部分历史数据,而无需引入维护窗口或阻塞常规工作负载。
注释
要执行分区切换,历史表上的集群索引必须与分区模式对齐(必须包含 ValidTo)。 默认历史表包含包含 ValidTo 和 ValidFrom 的聚类索引,这对于分区、插入新历史数据和典型的时序查询来说最为优越。 有关详细信息,请参阅临时表。
滑动窗口需要两组任务:
- 分区配置任务
- 重复性分区维护任务
在这个例子中,假设你想保留历史数据六个月,并且每个月的数据都放在一个独立分区。 另外,假设你在2023年9月激活了系统版本控制。
分区配置任务将为历史记录表创建初始分区配置。 在这个例子中,你创建的分区数量与滑动窗口大小相同,按月份计算,加上一个额外的空分区。 这种配置确保系统在你开始定期分区维护任务时能够正确存储新数据。 它还确保你永远不会拆分包含数据的分区,避免了昂贵的数据流动。 将配分函数定义为 RANGE LEFT,而不是 RANGE RIGHT。 更多信息请参见本文后面 关于表分区的性能考虑 。
下图显示了初始分区配置,以保留六个月的数据。
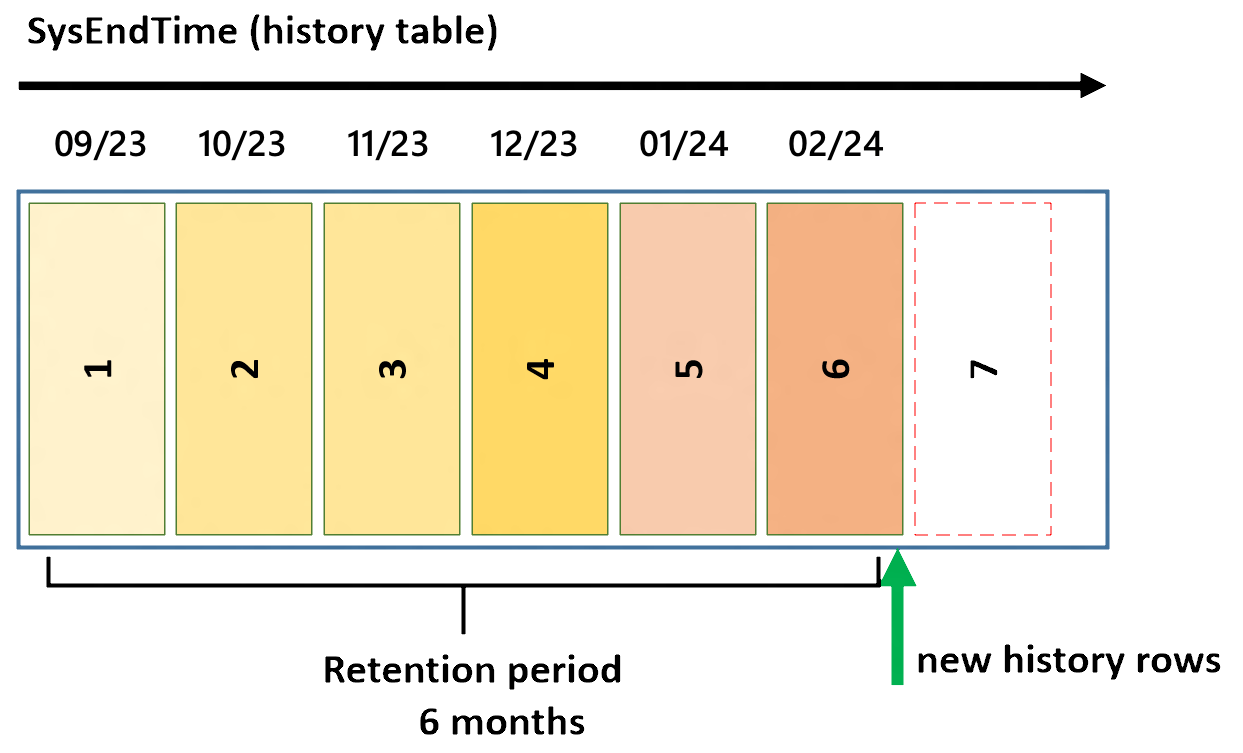
第一个分区和最后一个分区分别在下边界和上边界处为开区间,以确保每个新行都能有对应的目标分区,而不管分区列中的值是什么。 随着时间推移,历史表中的新行会进入更高的分区。 当第六个分区被填满时,就达到了目标保留期。 此时,首次开始定期的分区维护任务。 把它定时运行一次,比如这个例子里每月一次。
下图展示了定期进行的分区维护任务。
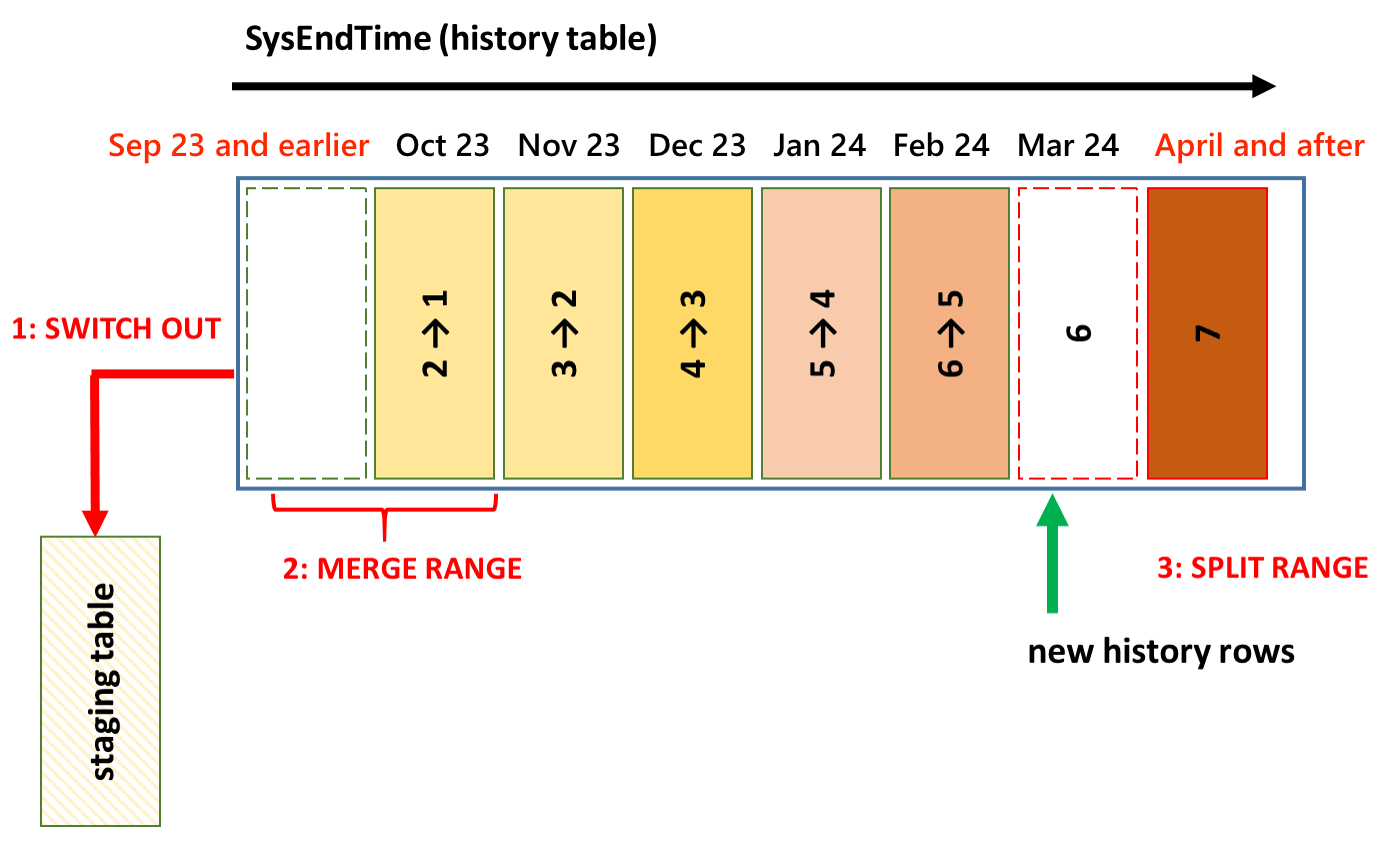
每次运行定期维护任务时,都会执行以下步骤:
SWITCH OUT:创建一个暂存表,然后使用带有SWITCH PARTITION参数的ALTER TABLE语句在历史表和暂存表之间切换一个分区。ALTER TABLE [<history table>] SWITCH PARTITION 1 TO [<staging table>];分区切换后,你可以选择归档分区表中的数据,然后丢弃或截断分区表,为下一个维护周期做准备。
MERGE RANGE:使用带有MERGE RANGE的 ALTER PARTITION FUNCTION 语句,将空分区1与分区2合并。 当你使用该函数去除最低边界时,实际上是将空划分1与前划分2合并,形成一个新的划分1。 其他分区的序号实际上也会发生变化。SPLIT RANGE:使用带有7的SPLIT RANGE语句创建一个新的空分区ALTER PARTITION FUNCTION。 当你用这个函数添加新的上边界时,实际上是在为下个月创建一个独立的分区。
使用 Transact-SQL 在历史记录表中创建分区
使用以下 Transact-SQL 脚本创建分区函数、分区模式,并重新创建与模式分区对齐的聚类索引。 在本示例中,你将创建一个为期六个月、从 2023 年 9 月开始并按月分区的滑动窗口。
BEGIN TRANSACTION;

/*Create partition function*/
CREATE PARTITION FUNCTION [fn_Partition_DepartmentHistory_By_ValidTo](DATETIME2 (7))
    AS RANGE LEFT FOR VALUES (
        N'2023-09-30T23:59:59.999',
        N'2023-10-31T23:59:59.999',
        N'2023-11-30T23:59:59.999',
        N'2023-12-31T23:59:59.999',
        N'2024-01-31T23:59:59.999',
        N'2024-02-29T23:59:59.999'
    );

/*Create partition scheme*/
CREATE PARTITION SCHEME [sch_Partition_DepartmentHistory_By_ValidTo]
    AS PARTITION [fn_Partition_DepartmentHistory_By_ValidTo]
    TO (
        [PRIMARY],
        [PRIMARY],
        [PRIMARY],
        [PRIMARY],
        [PRIMARY],
        [PRIMARY],
        [PRIMARY]
    );

/*Re-create index to be partition-aligned with the partitioning schema*/
CREATE CLUSTERED INDEX [ix_DepartmentHistory] ON [dbo].[DepartmentHistory] (
    ValidTo ASC,
    ValidFrom ASC
)
WITH (
    PAD_INDEX = OFF,
    STATISTICS_NORECOMPUTE = OFF,
    SORT_IN_TEMPDB = OFF,
    DROP_EXISTING = ON,
    ONLINE = OFF,
    ALLOW_ROW_LOCKS = ON,
    ALLOW_PAGE_LOCKS = ON,
    DATA_COMPRESSION = PAGE
)
ON [sch_Partition_DepartmentHistory_By_ValidTo] (ValidTo);

COMMIT TRANSACTION;
使用 Transact-SQL 来维护滑动窗口方案中的分区
使用以下 Transact-SQL 脚本来维护滑动窗口方案中的分区。 在这个示例中,你使用 MERGE RANGE 替换 2023 年 9 月的分区,然后使用 SPLIT RANGE 添加 2024 年 3 月的新分区。
BEGIN TRANSACTION;

/* (1) Create staging table */
CREATE TABLE [dbo].[staging_DepartmentHistory_September_2023]
(
    DeptID INT NOT NULL,
    DeptName VARCHAR (50) COLLATE SQL_Latin1_General_CP1_CI_AS NOT NULL,
    ManagerID INT NULL,
    ParentDeptID INT NULL,
    ValidFrom DATETIME2 (7) NOT NULL,
    ValidTo DATETIME2 (7) NOT NULL
) ON [PRIMARY]
WITH (DATA_COMPRESSION = PAGE);

/* (2) Create index on the same filegroups as the partition to switch out */
CREATE CLUSTERED INDEX [ix_staging_DepartmentHistory_September_2023]
ON [dbo].[staging_DepartmentHistory_September_2023](
    ValidTo ASC,
    ValidFrom ASC
)
WITH (
    PAD_INDEX = OFF,
    SORT_IN_TEMPDB = OFF,
    DROP_EXISTING = OFF,
    ONLINE = OFF,
    ALLOW_ROW_LOCKS = ON,
    ALLOW_PAGE_LOCKS = ON
)
ON [PRIMARY];

/* (3) Create constraints matching the partition to switch out */
ALTER TABLE [dbo].[staging_DepartmentHistory_September_2023] WITH CHECK
    ADD CONSTRAINT [chk_staging_DepartmentHistory_September_2023_partition_1]
            CHECK (ValidTo <= N'2023-09-30T23:59:59.999');

ALTER TABLE [dbo].[staging_DepartmentHistory_September_2023]
    CHECK CONSTRAINT [chk_staging_DepartmentHistory_September_2023_partition_1];

/* (4) Switch partition to staging table */
ALTER TABLE [dbo].[DepartmentHistory]
    SWITCH PARTITION 1 TO [dbo].[staging_DepartmentHistory_September_2023]
    WITH (
        WAIT_AT_LOW_PRIORITY (
            MAX_DURATION = 0 MINUTES, ABORT_AFTER_WAIT = NONE
        )
    );

/* (5) [Commented out] Optionally archive the data and drop staging table
      INSERT INTO [ArchiveDB].[dbo].[DepartmentHistory]
      SELECT * FROM [dbo].[staging_DepartmentHistory_September_2023];
      DROP TABLE [dbo].[staging_DepartmentHIstory_September_2023];
*/

/* (6) merge range to move lower boundary one month ahead */
ALTER PARTITION FUNCTION [fn_Partition_DepartmentHistory_By_ValidTo]()
    MERGE RANGE (N'2023-09-30T23:59:59.999');

/* (7) Create new empty partition for "April and after"
by creating new boundary point and specifying NEXT USED file group*/
ALTER PARTITION SCHEME [sch_Partition_DepartmentHistory_By_ValidTo]
    NEXT USED [PRIMARY];

ALTER PARTITION FUNCTION [fn_Partition_DepartmentHistory_By_ValidTo]()
    SPLIT RANGE (N'2024-03-31T23:59:59.999');

COMMIT TRANSACTION;
然而,最优的解决方案是每月定期运行一个通用的 Transact-SQL 脚本,且不作修改。 你可以推广之前的脚本,去处理你提供的参数(需要合并的下边界,以及分区拆分后创建的新边界)。 为了避免每月都创建一个预备表,建议提前创建一个,并通过修改检查约束来重复使用,使其与你更换的分区相匹配。欲了解更多信息,请参阅 如何完全自动化滑动窗口场景。
表分区的性能注意事项
以避免数据移动的方式执行 SPLIT RANGE 和 MERGE RANGE 操作,因为数据移动会带来显著的性能开销。 有关详细信息,请参阅修改分区函数。
当创建分区函数为RANGE LEFT时,指定的值是各分区的上边界。 使用 RANGE RIGHT 时,指定的值为分区的下限。 使用 MERGE RANGE 操作从分区函数定义中删除边界时,底层实现也会删除包含边界的分区。 如果该分区不是空的,就 MERGE RANGE 把数据移动到生成的分区。
下图描述了 RANGE LEFT 和 RANGE RIGHT 选项:
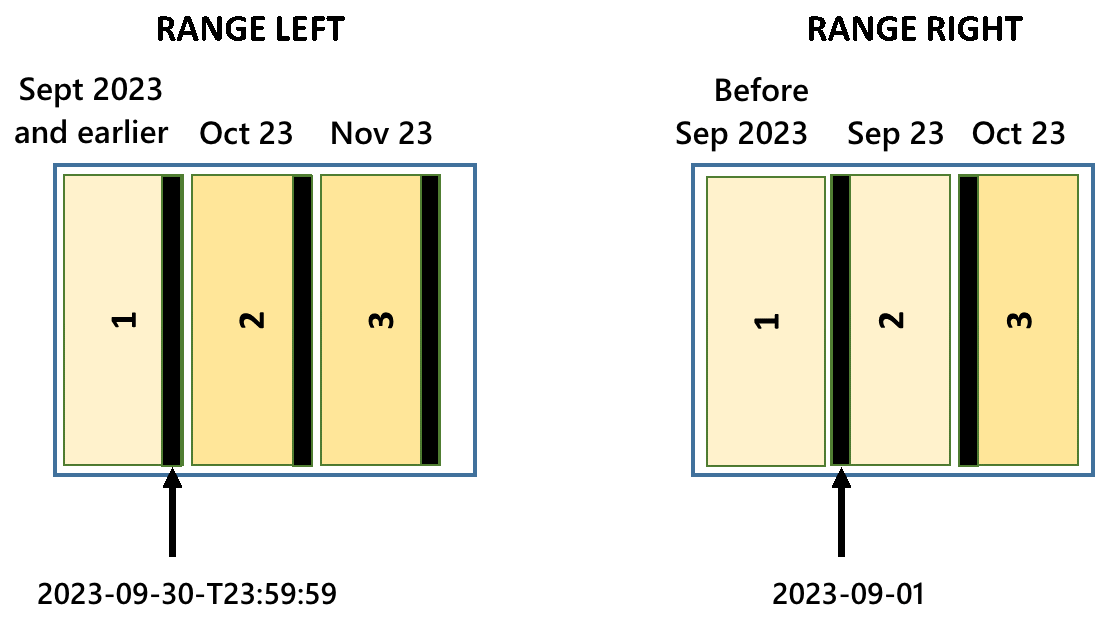
在滑动窗口方案中,始终要删除最低的分区边界。
RANGE LEFT情况:最低分区边界属于分区1,该分区在切换出后为空,因此MERGE RANGE不会导致任何数据移动。RANGE RIGHT情形:最低的分区边界属于分区2,该分区不为空,因为切换操作仅清空分区1。 在这种情况下,会MERGE RANGE引发数据移动,将数据从一个分区2移动到另一个分区1。 为了避免这种数据移动,在滑动窗口场景中,RANGE RIGHT需要具有分区1,而该分区始终为空。 这意味着,如果你使用RANGE RIGHT,则应比RANGE LEFT的情况额外创建并维护一个分区。
结论:使用 RANGE LEFT 滑动分区管理更简单,且避免数据移动。 但是,使用 RANGE RIGHT 定义分区要稍微简单一些,因为无需处理日期和时间检查问题。
使用自定义清理脚本
当你的表没有保留策略,且表分区不可行时,你可以用自定义清理脚本删除历史表中的数据。 这一过程只有在 SYSTEM_VERSIONING = OFF 时才可能实现。 为避免数据不一致,可以在维护窗口(修改数据的工作负载未活跃时)或事务内(有效阻断其他工作负载)进行清理。 此操作需要对当前和历史记录表拥有 CONTROL 权限。
每个时间表的清理逻辑都是一样的,所以你可以通过通用的存储过程自动化。 使用SQL Server 代理或其他工具,将该过程安排为每天运行,遍历你想限制数据历史的每个时序表。
下图展示了如何为单一表组织清理逻辑,以减少对运行工作负载的影响。
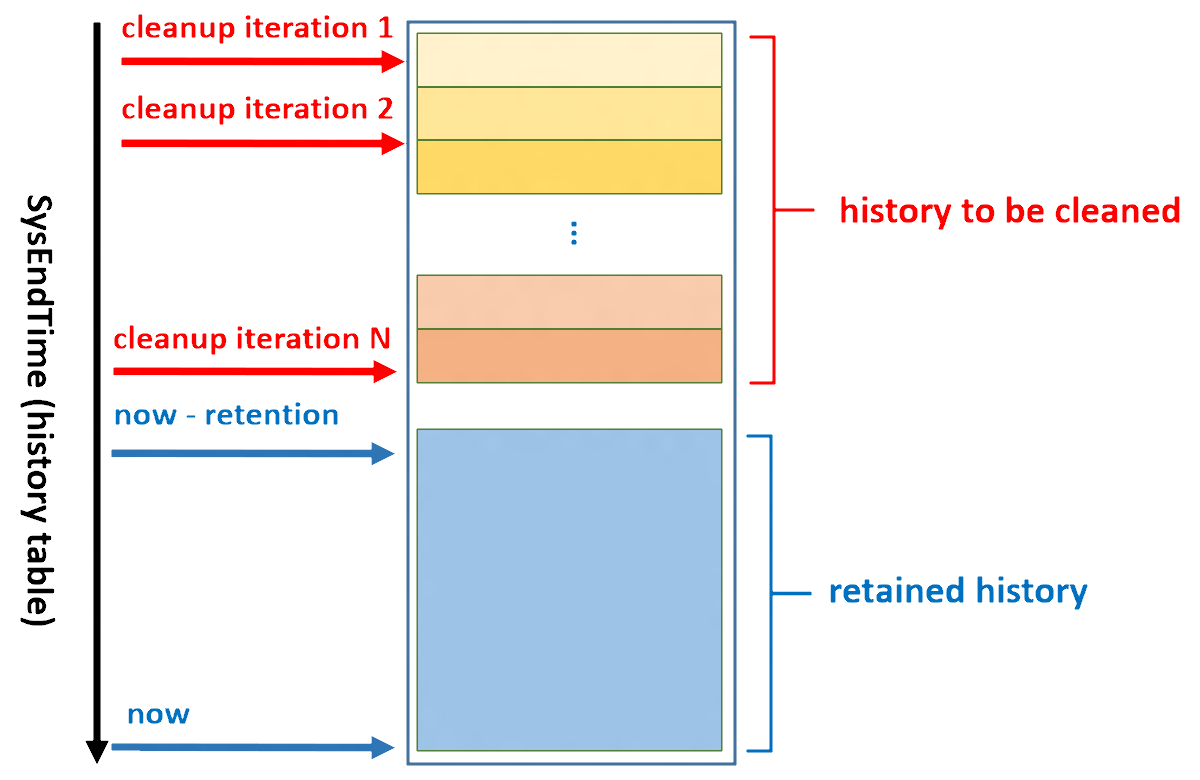
以下是实施该流程的一些高层次指导原则:
将每个时序表中的历史数据分几次小块迭代删除。 从最旧的行开始,依次处理至最新的行。 避免像前面的图所示,在一次交易中删除所有行。 虽然并不存在适用于所有场景的统一批次大小,但在单个事务中删除超过10,000行可能会带来明显的性能损耗。
每次迭代都作为通用存储过程的调用实现,从历史表中移除部分数据。
计算每次调用该过程时,需要在单个临时表中删除的行数。 根据结果和你想要的迭代次数,确定每个过程调用的动态分点。
为单个表设计迭代间隔,以减少访问该时表的应用程序的影响。
以下存储过程删除单个时序表的数据。 它从目录视图中发现历史表和周期结束列,然后在事务中运行三个语句: SET SYSTEM_VERSIONING = OFF、 DELETE FROM <history_table>、 SET SYSTEM_VERSIONING = ON和 。 仔细审查这段代码,并在应用到环境中前进行调整。
在 SQL Server 2016 (13.x) 中,前两个步骤必须在单独的 EXECUTE 语句中运行,否则 SQL Server 将生成类似于以下示例的错误:
Msg 13560, Level 16, State 1, Line XXX
Cannot delete rows from a temporal history table '<database_name>.<history_table_schema_name>.<history_table_name>'.
DROP PROCEDURE IF EXISTS usp_CleanupHistoryData;
GO

CREATE PROCEDURE usp_CleanupHistoryData (
    @temporalTableSchema SYSNAME,
    @temporalTableName SYSNAME,
    @cleanupOlderThanDate DATETIME2
)
AS
DECLARE @disableVersioningScript AS NVARCHAR (MAX) = '';
DECLARE @deleteHistoryDataScript AS NVARCHAR (MAX) = '';
DECLARE @enableVersioningScript AS NVARCHAR (MAX) = '';
DECLARE @historyTableName AS SYSNAME;
DECLARE @historyTableSchema AS SYSNAME;
DECLARE @periodColumnName AS SYSNAME;

/* Generate script to discover history table name and
end of period column for given temporal table name */
EXECUTE sp_executesql N'
    SELECT @hst_tbl_nm = t2.name,
           @hst_sch_nm = s2.name,
           @period_col_nm = c.name
    FROM sys.tables AS t1
         INNER JOIN sys.tables AS t2
             ON t1.history_table_id = t2.object_id
         INNER JOIN sys.schemas AS s1
             ON t1.schema_id = s1.schema_id
         INNER JOIN sys.schemas AS s2
             ON t2.schema_id = s2.schema_id
         INNER JOIN sys.periods AS p
             ON p.object_id = t1.object_id
         INNER JOIN sys.columns AS c
             ON p.end_column_id = c.column_id
            AND c.object_id = t1.object_id
    WHERE t1.name = @tblName
          AND s1.name = @schName',
    N'@tblName sysname,
    @schName sysname,
    @hst_tbl_nm sysname OUTPUT,
    @hst_sch_nm sysname OUTPUT,
    @period_col_nm sysname OUTPUT',
@tblName = @temporalTableName,
@schName = @temporalTableSchema,
@hst_tbl_nm = @historyTableName OUTPUT,
@hst_sch_nm = @historyTableSchema OUTPUT,
@period_col_nm = @periodColumnName OUTPUT;

IF @historyTableName IS NULL
   OR @historyTableSchema IS NULL
   OR @periodColumnName IS NULL
    THROW 50010, 'History table cannot be found. Either specified table is not system-versioned temporal or you have provided incorrect argument values.', 1;

SET @disableVersioningScript = @disableVersioningScript +
    'ALTER TABLE [' + @temporalTableSchema + '].[' + @temporalTableName + ']
    SET (SYSTEM_VERSIONING = OFF)';

SET @deleteHistoryDataScript = @deleteHistoryDataScript +
    ' DELETE FROM [' + @historyTableSchema + '].[' + @historyTableName + ']
    WHERE [' + @periodColumnName + '] < ' + '''' +
    CONVERT (VARCHAR (128), @cleanupOlderThanDate, 126) + '''';

SET @enableVersioningScript = @enableVersioningScript +
    ' ALTER TABLE [' + @temporalTableSchema + '].[' + @temporalTableName + ']
    SET (SYSTEM_VERSIONING = ON (HISTORY_TABLE = [' + @historyTableSchema + '].[' +
    @historyTableName + '], DATA_CONSISTENCY_CHECK = OFF )); ';

BEGIN TRANSACTION;
    EXECUTE (@disableVersioningScript);
    EXECUTE (@deleteHistoryDataScript);
    EXECUTE (@enableVersioningScript);
COMMIT TRANSACTION;