你当前正在访问 Microsoft Azure Global Edition 技术文档网站。 如果需要访问由世纪互联运营的 Microsoft Azure 中国技术文档网站,请访问 https://docs.azure.cn。
此内容适用于:🟩v4.0 (正式版) | 以前的版本:🟦v3.1 (正式版)🟥v3.0 (停用)🟦v2.1
文档智能自定义模型需要少量训练文档才能开始。 如果至少有五个文档,可以开始训练自定义模型。 可以训练自定义模板模型(自定义表单)或自定义神经模型(自定义文档)。 本文档指导你完成训练自定义模型的过程。
自定义模型输入要求
首先,确保训练数据集遵循文档智能的输入要求。
支持以下文件格式。
| 模型 | 图片: JPEG/JPG、PNG、BMP、TIFF、HEIF |
Office: Word(DOCX)、Excel(XLSX)、PowerPoint(PPTX)、HTML |
|
|---|---|---|---|
| 读 | ✔ | ✔ | ✔ |
| 版式 | ✔ | ✔ | ✔ |
| 常规文档 | ✔ | ✔ | |
| 预生成 | ✔ | ✔ | |
| 自定义提取 | ✔ | ✔ | |
| 自定义分类 | ✔ | ✔ | ✔ |
- 照片和扫描:为获得最佳结果,请为每个文档提供一张清晰的照片或高质量的扫描。
- PDF 和 TIFF:对于 PDF 和 TIFF,最多可以处理 2,000 页。 (使用免费层订阅时,只处理前两个页面。
- 文件大小:用于分析文档的文件大小是付费层 (S0) 层的 500 MB,免费层为 4 MB(F0) 层。
- 图像尺寸:尺寸必须介于 50 像素 x 50 像素和 10,000 像素 x 10,000 像素之间。
- 密码锁:如果 PDF 是密码锁定的,则必须在提交之前删除该锁。
- 文本高度:要提取的文本的最小高度是 1024 x 768 像素图像的 12 像素。 此尺寸对应于 150 点/英寸的大约 8 号字文本。
- 自定义模型训练:自定义模板模型的最大训练页数为 500,自定义神经模型为 50,000。
- 自定义提取模型训练:对于模板模型,训练数据的总大小为 50 MB,神经网络模型为 1 GB。
- 自定义分类模型训练:训练数据的总大小为 1 GB,最大为 10,000 页。 对于 2024-11-30(GA),训练数据的总大小为 2 GB,最大为 10,000 页。
- Office 文件类型(DOCX、XLSX、PPTX):最大字符串长度限制为 800 万个字符。
训练数据建议
按照以下提示进一步优化您的数据集以便进行训练:
- 使用基于文本的 PDF 文档,而不是基于图像的文档。 扫描的 PDF 作为图像进行处理。
- 对于包含输入字段的表单,请使用已填写完所有字段的示例。
- 使用每个字段中具有不同值的表单。
- 如果表单图像质量较低,请使用更大的数据集(10-15 个图像)。
上传训练数据
收集一组用于训练的表单或文档后,需要将其上传到Azure blob 存储容器。 如果不知道如何使用容器创建Azure storage帐户,请遵循 Azure 门户的 Azure 存储 快速入门。 可以使用免费定价层 (F0) 试用该服务,稍后升级到生产付费层。
视频:训练自定义模型
- 收集并上传训练数据集后,即可训练自定义模型。 在以下视频中,我们将创建一个项目,并探索成功标记和训练模型的一些基础知识。
在文档智能工作室中创建项目
Document Intelligence Studio 提供和协调完成数据集和训练模型所需的所有 API 调用。
首先导航到 Document Intelligence Studio。 首次使用 Studio 时,需要 初始化订阅、资源组和资源。 然后,按照 自定义项目的先决条件 配置 Studio 以访问训练数据集。
在 Studio 中,选择 “自定义提取模型 ”磁贴,然后选择“ 创建项目 ”按钮。
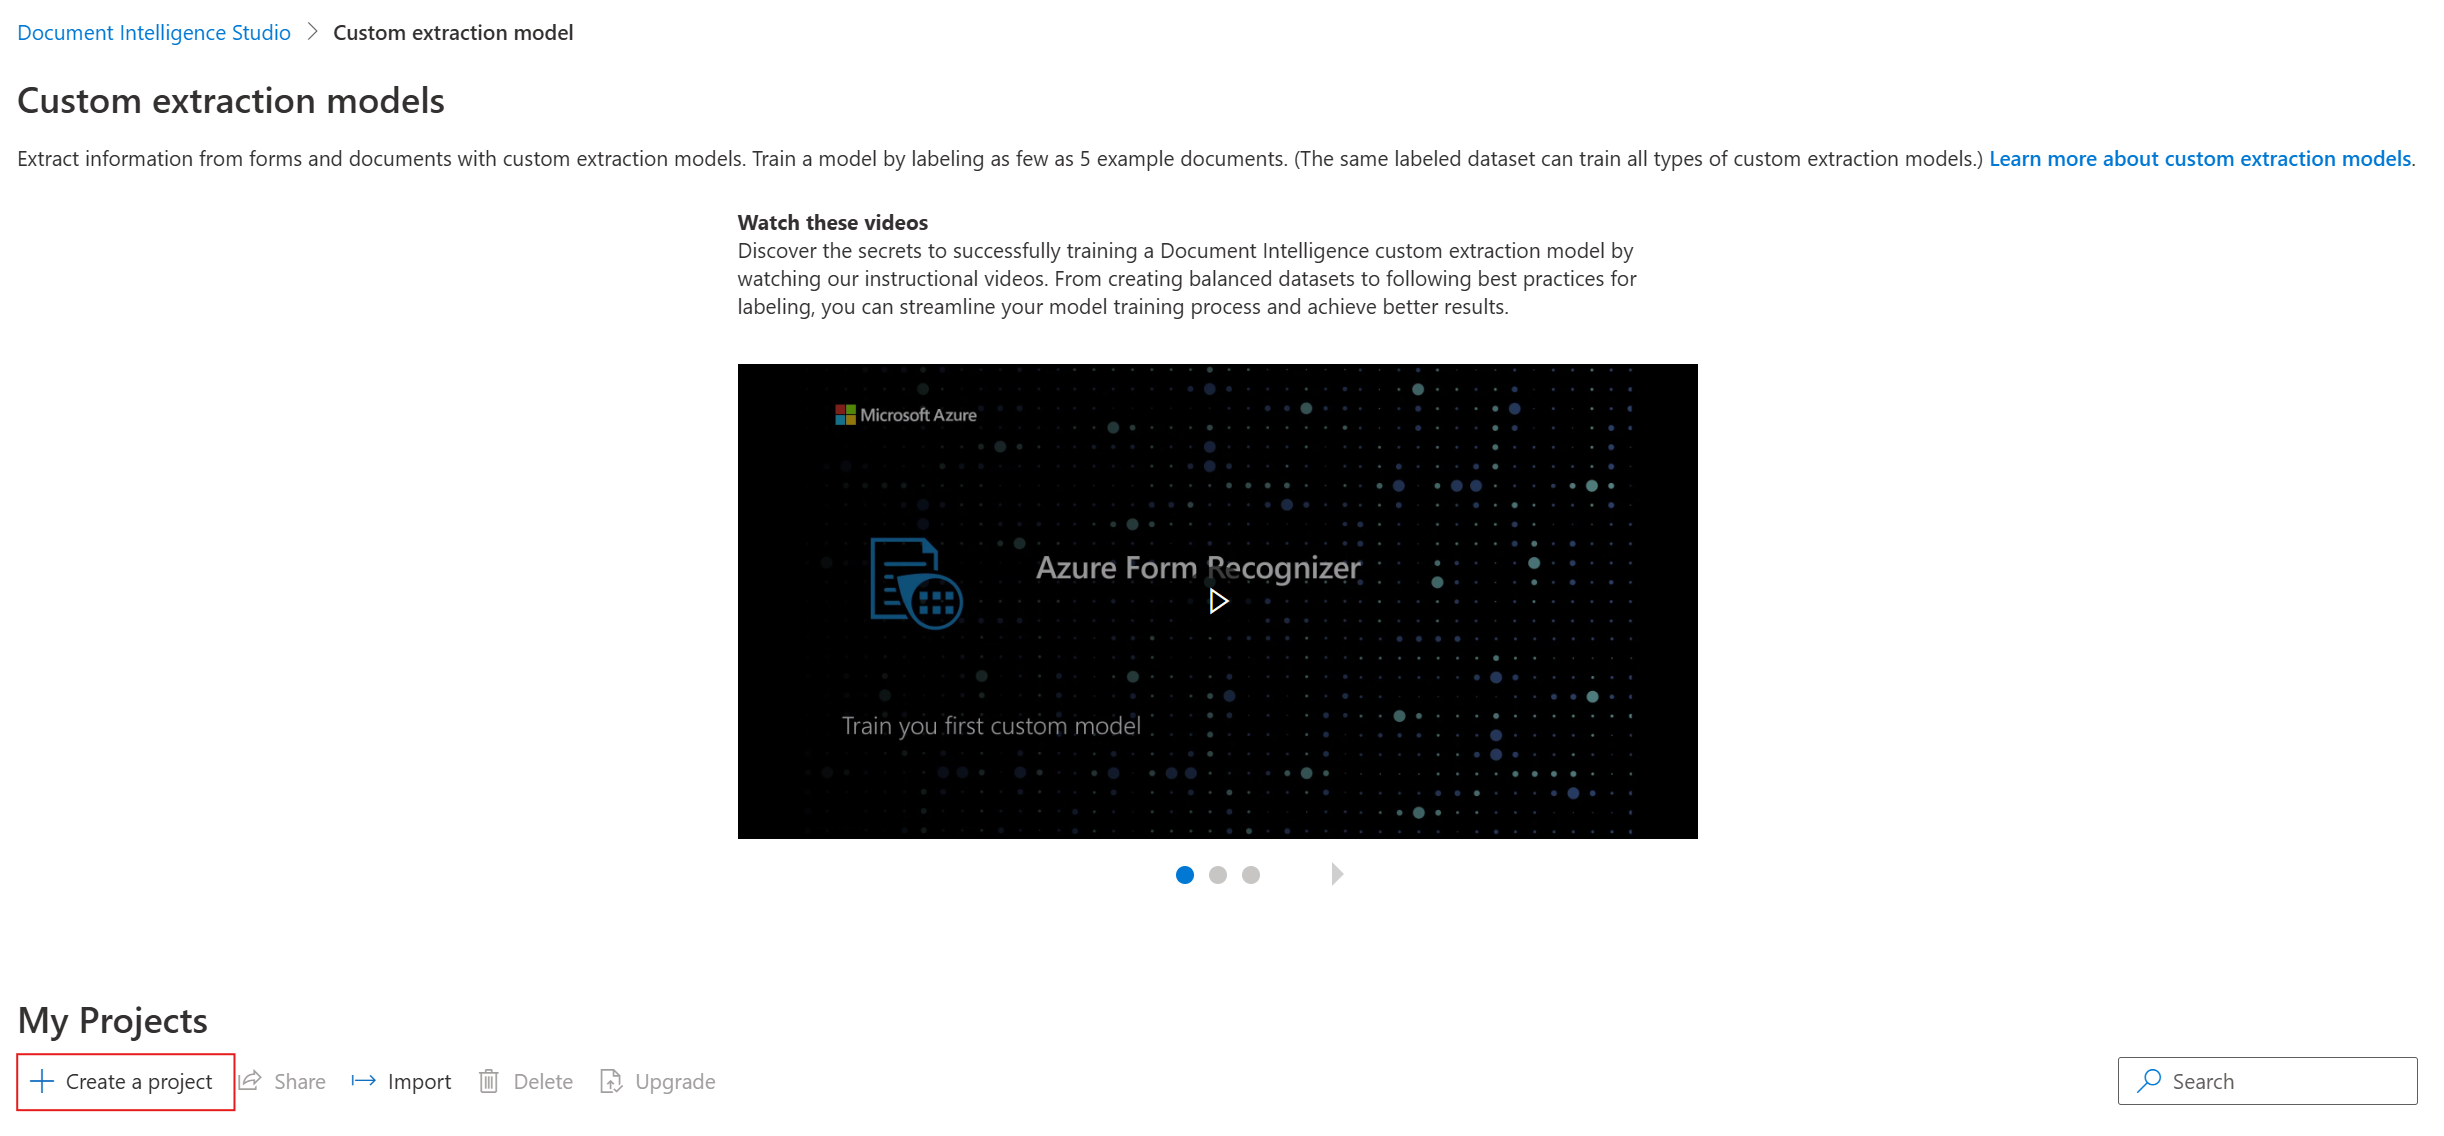
在
create project对话框中,提供项目的名称(可选)说明,然后选择“继续”。在工作流的下一步中,选择或创建文档智能资源,然后再选择继续。
重要
自定义神经模型仅在几个区域中可用。 如果打算训练神经模型,请在其中一个 受支持的区域中选择或创建资源。
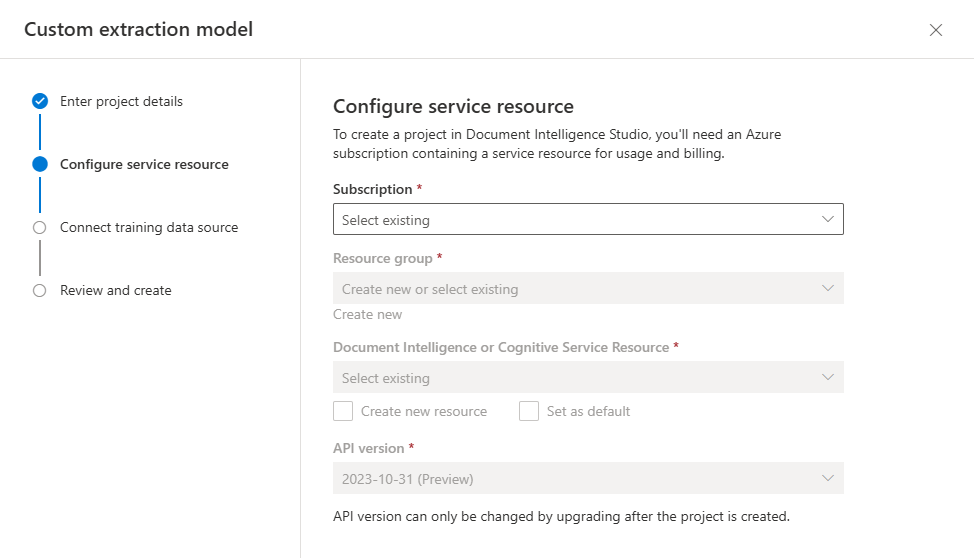
接下来,选择用于上传自定义模型训练数据集的存储帐户。 如果训练文档位于容器的根目录中, 则文件夹路径 应为空。 如果文档位于子文件夹中,请在 “文件夹路径 ”字段中输入容器根目录中的相对路径。 配置存储帐户后,选择“继续”。

最后,查看project设置,然后选择 Create Project创建新的project。 你现在应该位于标记窗口中,可以看到数据集中的文件已列出。
标记数据
在项目中,第一个任务是使用要提取的字段标记数据集。
上传到存储的文件列在屏幕左侧,第一个文件已准备好标记。
通过选择屏幕右上角的加号按钮➕开始标记数据集并创建第一个字段。
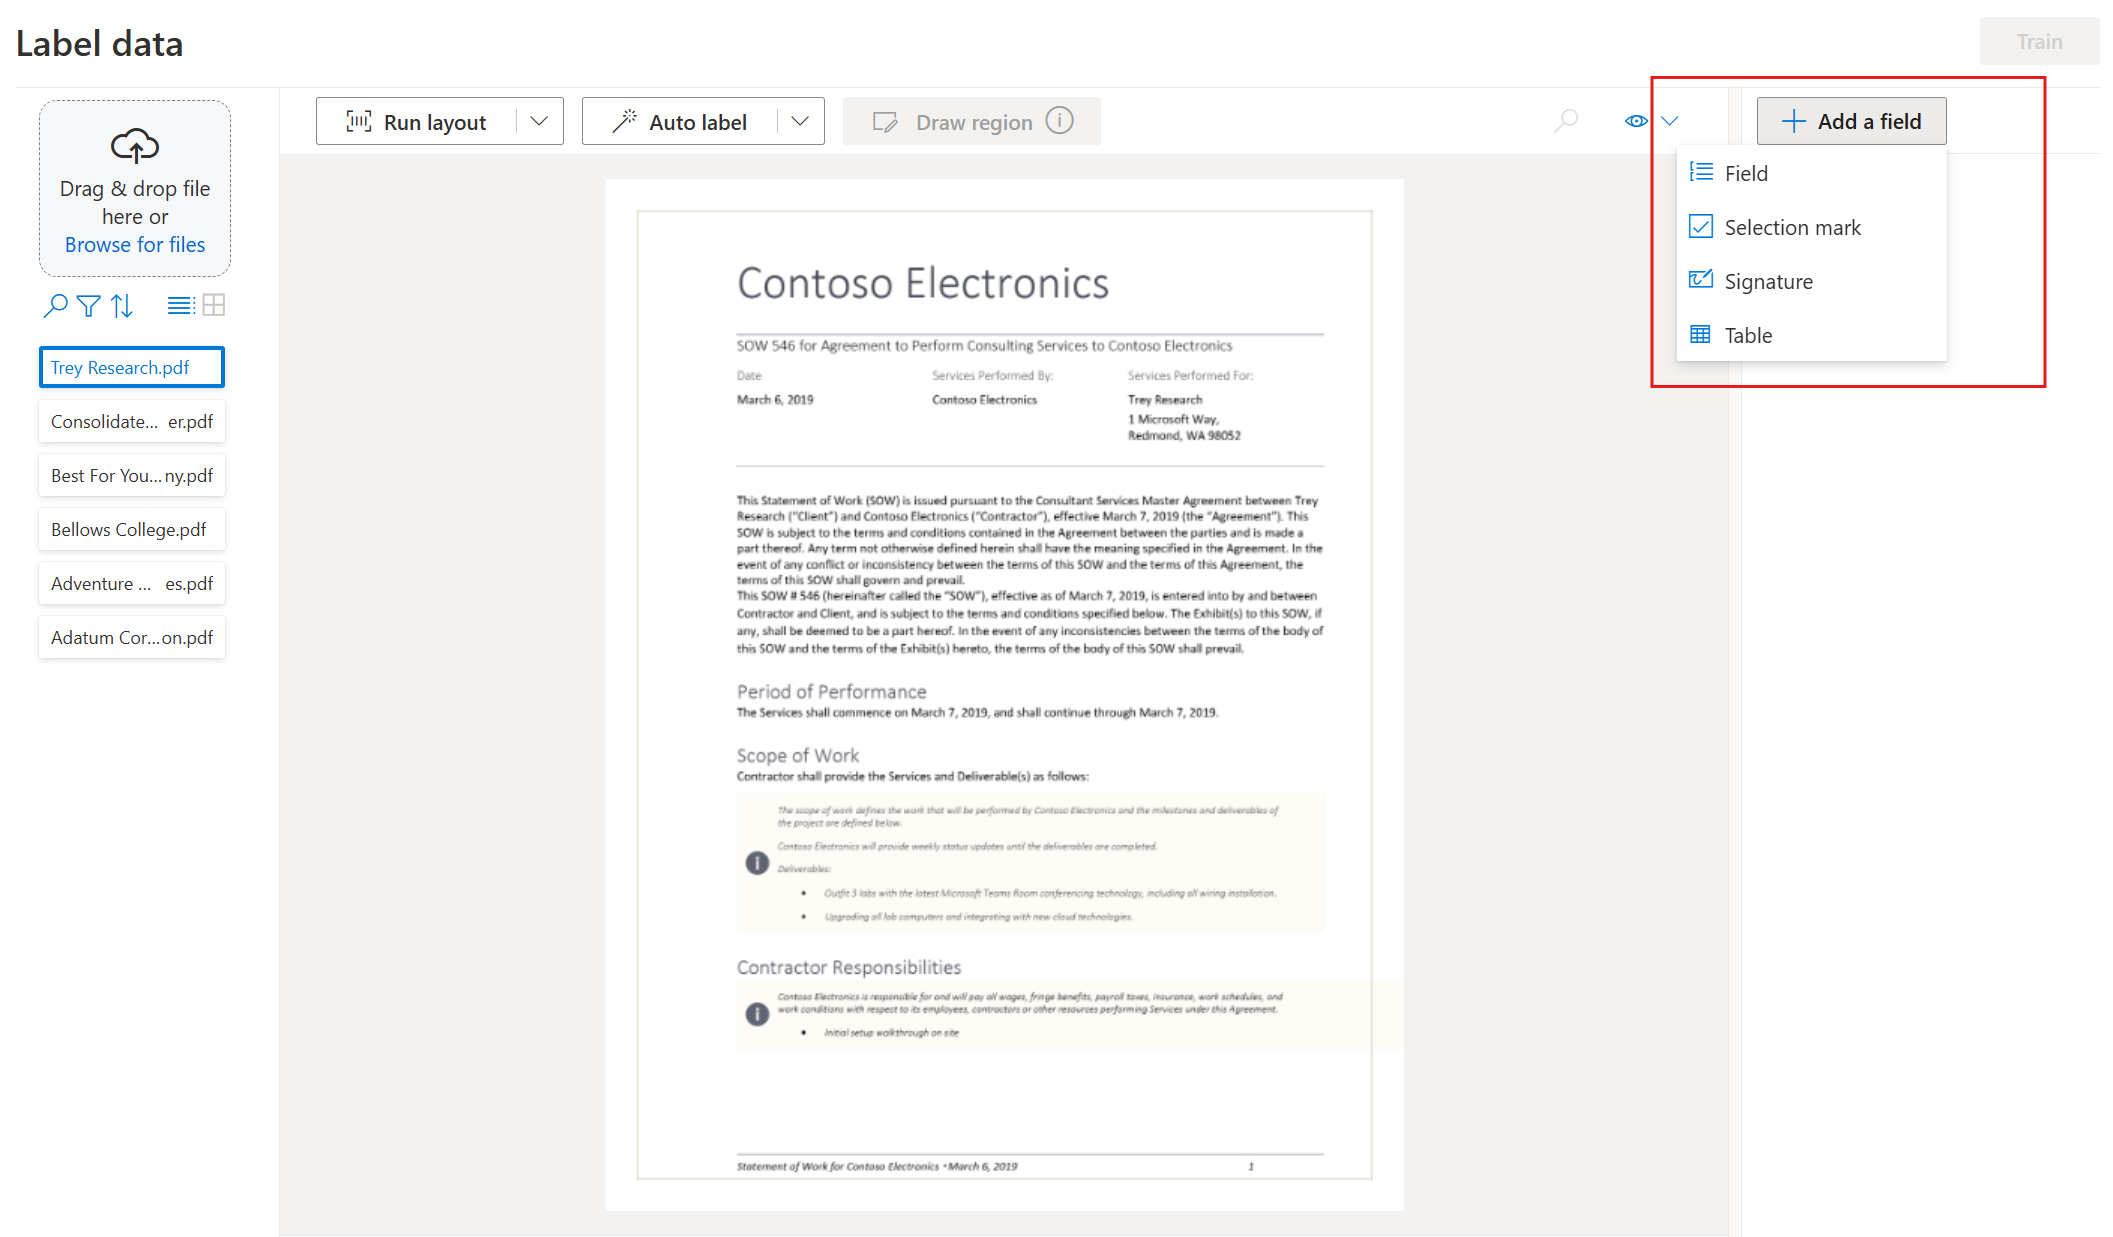
输入字段的名称。
通过选择文档中的单词或单词,为字段赋值。 在右侧导航栏的下拉列表或字段列表中选择字段。 标记的值低于字段列表中的字段名称。
对要为数据集标记的所有字段重复此过程。
通过选择每个文档并选择要标记的文本来标记数据集中的剩余文档。
现在已标记数据集中的所有文档。 .labels.json 和 .ocr.json 文件对应于训练数据集中的每个文档和一个新的 fields.json 文件。 此训练数据集提交以训练模型。
训练模型
标记数据集后,即可训练模型。 选择右上角的训练按钮。
在“训练模型”对话框中提供唯一的模型 ID,并提供说明(可选)。 模型 ID 接受字符串数据类型。
对于生成模式,请选择要训练的模型类型。 详细了解 模型类型和功能。

选择 “训练 ”以启动训练过程。
模板模型在几分钟内训练。 神经模型可能需要长达 30 分钟才能训练。
导航到“模型”菜单,查看训练操作的状态。
测试模型
模型训练完成后,可以通过在模型列表页上选择模型来测试模型。
选择模型,然后在 “测试 ”按钮上选择。
选择
+ Add按钮以选择要测试模型的文件。选择文件后,选择 “分析 ”按钮以测试模型。
模型结果显示在主窗口中,提取的字段列在右侧导航栏中。
通过评估每个字段的结果来验证模型。
右侧导航栏还有示例代码,用于从 API 调用模型和 JSON 结果。
恭喜你掌握了在文档智能工作室中训练自定义模型的技能! 模型可用于 REST API 或 SDK 来分析文档。
适用于:🟩v2.1. 其他版本:v3.0
使用文档智能自定义模型时,可以将自己的训练数据提供给 训练自定义模型 操作,以便模型可以训练到行业特定的表单。 按照本指南了解如何收集和准备数据以有效训练模型。
至少需要五个相同类型的已完成表单。
如果要使用手动标记的训练数据,必须从至少五个相同类型的已完成表单开始。 除了所需的数据集之外,你仍然可以使用未标记的表单。
自定义模型输入要求
首先,确保训练数据集遵循文档智能的输入要求。
支持以下文件格式。
| 模型 | 图片: JPEG/JPG、PNG、BMP、TIFF、HEIF |
Office: Word(DOCX)、Excel(XLSX)、PowerPoint(PPTX)、HTML |
|
|---|---|---|---|
| 读 | ✔ | ✔ | ✔ |
| 版式 | ✔ | ✔ | ✔ |
| 常规文档 | ✔ | ✔ | |
| 预生成 | ✔ | ✔ | |
| 自定义提取 | ✔ | ✔ | |
| 自定义分类 | ✔ | ✔ | ✔ |
- 照片和扫描:为获得最佳结果,请为每个文档提供一张清晰的照片或高质量的扫描。
- PDF 和 TIFF:对于 PDF 和 TIFF,最多可以处理 2,000 页。 (使用免费层订阅时,只处理前两个页面。
- 文件大小:用于分析文档的文件大小是付费层 (S0) 层的 500 MB,免费层为 4 MB(F0) 层。
- 图像尺寸:尺寸必须介于 50 像素 x 50 像素和 10,000 像素 x 10,000 像素之间。
- 密码锁:如果 PDF 是密码锁定的,则必须在提交之前删除该锁。
- 文本高度:要提取的文本的最小高度是 1024 x 768 像素图像的 12 像素。 此尺寸对应于 150 点/英寸的大约 8 号字文本。
- 自定义模型训练:自定义模板模型的最大训练页数为 500,自定义神经模型为 50,000。
- 自定义提取模型训练:对于模板模型,训练数据的总大小为 50 MB,神经网络模型为 1 GB。
- 自定义分类模型训练:训练数据的总大小为 1 GB,最大为 10,000 页。 对于 2024-11-30(GA),训练数据的总大小为 2 GB,最大为 10,000 页。
- Office 文件类型(DOCX、XLSX、PPTX):最大字符串长度限制为 800 万个字符。
训练数据建议
按照以下提示,进一步优化您的数据集以进行训练。
- 使用基于文本的 PDF 文档,而不是基于图像的文档。 扫描的 PDF 作为图像进行处理。
- 对于已完成的表单,请使用填充了所有字段的示例。
- 使用每个字段中具有不同值的表单。
- 对已完成的表单使用更大的数据集(10-15 个图像)。
上传训练数据
收集用于训练的文档集后,需要将其上传到Azure blob 存储容器。 如果您不知道如何使用容器创建 Azure 存储帐户,请参考 Azure 门户的 Azure 存储快速入门指南。 使用标准性能层。
如果要使用手动标记的数据,请上传与您训练文档对应的.labels.json和.ocr.json文件。 可以使用 示例标记工具 (或你自己的 UI)生成这些文件。
在子文件夹中组织数据(可选)
默认情况下, 训练自定义模型 API 仅使用位于存储容器根目录的文档。 但是,如果在 API 调用中指定数据,则可以使用子文件夹中的数据进行训练。 通常, 训练自定义模型 调用的正文采用以下格式,其中 <SAS URL> 容器的共享访问签名 URL 如下:
{
  "source":"<SAS URL>"
}
如果将以下内容添加到请求正文,API 会使用位于子文件夹中的文档进行训练。 该字段是可选的,并将 "prefix" 训练数据集限制为路径以给定字符串开头的文件。 因此,例如,值 "Test"会导致 API 仅查看以单词 Test 开头的文件或文件夹。
{
  "source": "<SAS URL>",
  "sourceFilter": {
    "prefix": "<prefix string>",
    "includeSubFolders": true
  },
  "useLabelFile": false
}
后续步骤
了解如何生成训练数据集后,请按照快速入门来训练自定义文档智能模型并开始在表单上使用。