你当前正在访问 Microsoft Azure Global Edition 技术文档网站。 如果需要访问由世纪互联运营的 Microsoft Azure 中国技术文档网站,请访问 https://docs.azure.cn。
本文对 Azure 中用于实时流处理的各种技术选择进行了比较。
流式处理数据概述
组织通常具有各种数据源,这些数据源同时发出消息、记录或数据。 数据量可以介于几字节到几兆字节(MB)之间。 流式处理数据以连续的增量方式大量产生,可以准实时处理。 此类数据包括公司用于实时分析和查看其业务的各个方面的信息,例如应用程序日志、地理位置更新、事件和传感器读数。
流数据通常具有以下特征:
数据完整性不完善: 源处的临时错误可能会导致数据元素缺失。 流的连续性质可能会导致数据不一致。 因此,流处理和分析系统通常包括用于数据验证的逻辑来缓解这些错误。
连续数据流: 数据流没有开始或结束,因此必须不断收集数据。 例如,只要服务器运行,服务器活动日志就累积。
多种数据格式: 可以采用多种格式(如 JSON、Avro 和 CSV)流式传输数据。 它可能包含各种数据类型,例如字符串、数字、日期和二进制类型。 流处理系统必须处理这些数据变体。
时间敏感数据顺序: 数据流中的单个元素包含时间戳。 数据流本身可能具有时间敏感度,并在特定时间后丢失值。 在某些情况下,需要保留数据处理顺序。
用于实时处理的技术选项
为了帮助你选择正确的技术,本部分概述了 Azure 中的常见选项,从引入到使用。 每个子节都根据它们在流式处理流中的角色突出显示推荐的技术。
高级别流式处理流程
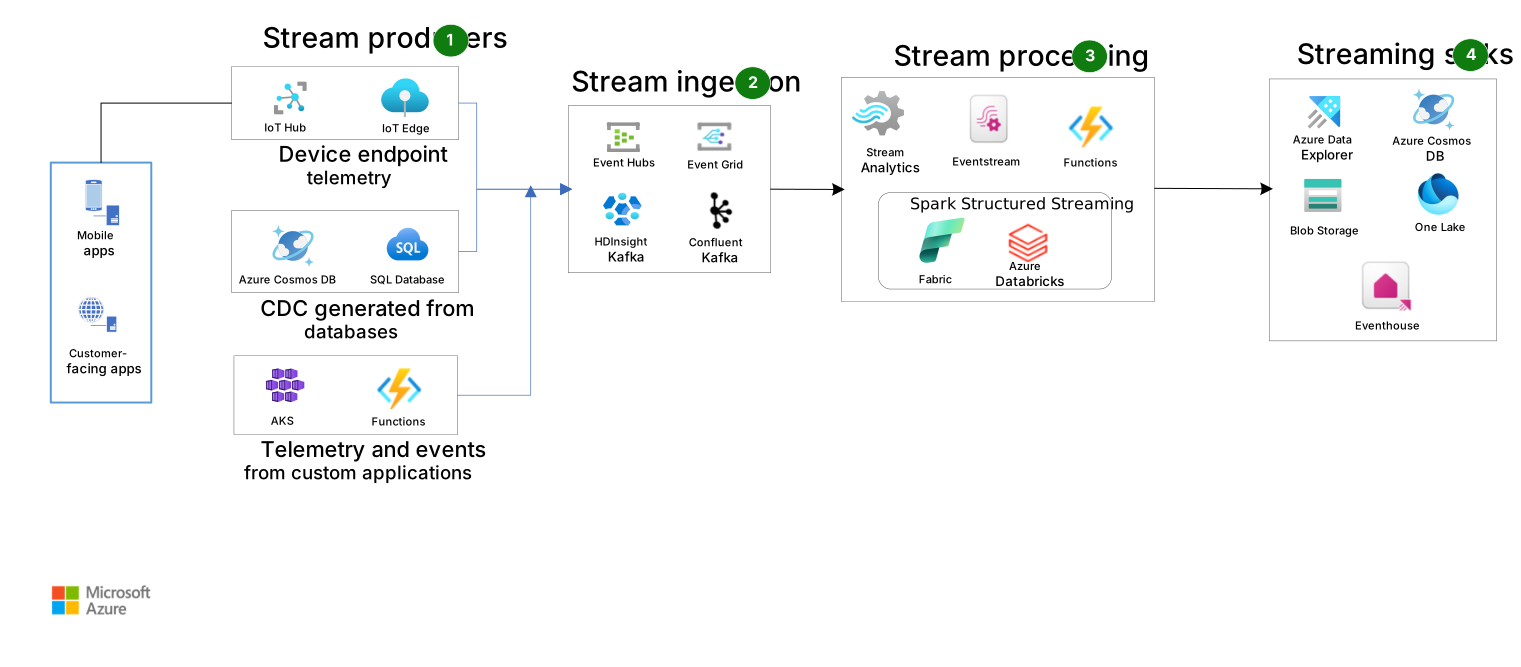
下载此体系结构的 Visio 文件。
流媒体制作人
流生成者生成数据并将其推送到 Azure 引入服务。 它们持续从物联网(IoT)设备、应用程序日志或数据库等源生成数据。
流生成者具有以下优势:
捕获准实时数据。 生成者可以持续从 IoT 设备、用户交互和应用程序日志等源收集数据。 它们将数据流式传输到 Azure 事件中心或 Azure IoT 中心等 Azure 服务。
使用批处理和压缩优化吞吐量。 生成者可以批处理消息并应用压缩,以最大程度地减少传输期间的数据大小。 这些功能可提高效率。
通过错误处理和重试确保可靠的传输。 生成者可以通过自动重试来管理网络中断或代理故障,以确保可靠的数据传输。
通过幂等性保证数据完整性。 可以将生成者配置为 完全支持一次传递,从而防止重复消息,并确保一致的数据流。
组件
IoT 中心引入 IoT 数据。 它提供双向通信、设备身份验证和脱机消息缓冲等功能。 它非常适合管理 IoT 设备及其数据流。
变更数据捕获 (CDC) 生成者包括 Azure 数据库(例如 Azure SQL 数据库和 Azure Cosmos DB)。
若要访问 CDC 数据,可以使用连接器,例如用于 SQL 数据库的 Debezium 或 Azure Cosmos DB 更改源。 这些连接器通常托管在 Azure Functions 或 Azure 应用服务环境中。 如果使用 Microsoft Fabric 事件流功能,则不需要单独的应用程序(如 Debezium)将 CDC 生成者与下游使用者连接。
Debezium 等自定义应用程序也可以作为独立应用程序托管在托管服务上,例如 Azure Kubernetes 服务(AKS)或应用服务环境。 此方法提供更多控制或自定义选项。
常规功能
| 能力 | IoT 中心 | CDC 生成者 | 自定义应用程序 |
|---|---|---|---|
| 设备指标和日志 | 是 | 否 | 否 |
| 托管服务 | 是 | 否 | 否 |
| 可伸缩性 | 是 | 是 | 是 |
流引入
生成者(如 Web 和移动应用程序、IoT 设备和传感器)会持续生成数据。 流处理管道必须有效地引入此数据,以便进行实时和批处理分析。
请考虑下列因素:
数据速度: 确定如何处理来自多个源的高速数据,这些数据通常以格式和大小而异。
可伸缩性: 确保引入层可以在数据量、多样性和速度增加时动态缩放。
数据完整性和可靠性: 防止传输期间数据丢失或重复。
流数据摄取组件
事件中心 是一种实时数据引入服务,可以每秒处理数百万个事件,这使得它非常适合高吞吐量方案。 它可以以低延迟动态缩放和处理大量数据。
事件中心支持分区等功能,用于并行处理和数据保留策略。 它与 Azure 服务(如 Azure 流分析、Fabric、Azure Databricks 和 Azure Functions)集成。 事件中心还与 Apache Kafka 集成,可以在不进行任何代码更改的情况下运行现有的 Kafka 工作负载。
事件网格 是一项完全托管的事件路由服务。 它引入、分发和响应来自各种源的事件,因此非常适合实时的事件驱动体系结构。 它有效地处理事件通知,并与 Azure 服务、自定义应用程序和合作伙伴系统集成。 事件网格在流引入中起着关键作用。
Kafka on Azure HDInsight 是一种托管的 Apache Kafka 服务,用于大规模实时数据引入和处理。 使用此服务从各种源(例如 IoT 设备、应用程序日志和社交媒体源)捕获和存储流数据。 此服务提供对托管基础结构上的 Kafka 配置的额外控制。
Confluent Cloud 上的 Apache Kafka 是一项完全托管的 Apache Kafka 服务,用于实时数据引入。 它与 Azure 集成以简化部署和缩放。 此解决方案包括架构注册表、用于流查询的 ksqlDB 和企业级安全性等功能。 如果使用 Confluent 的连接器和流处理工具扩展生态系统,请使用此选项。
数据流摄取的通用功能
| 能力 | 事件中心 | Kafka on HDInsight | Kafka on Confluent |
|---|---|---|---|
| 消息保留期 | 是 | 是 | 是 |
| 消息大小限制 | 1 MB | 可配置 | 可配置 |
| 托管服务 | 是 | 管理的基础设施即服务 | 是 |
| 自动缩放 | 是 | 是 | 是 |
| 合作伙伴产品/服务 | 否 | 否 | 是 |
| 定价模型 | 基于层 | 按群集小时 | 消耗模型 |
流处理
此步骤涉及实时转换数据、筛选、聚合、扩充或分析引入的数据的过程。
请考虑下列因素:
有状态处理与无状态处理: 确定处理取决于以前看到的数据(有状态)还是独立事件(无状态)。
事件时间处理: 考虑到必须同时处理来自多个源的数据流的情况,尤其是对于后期到达的记录。
窗口: 使用滑动或翻转窗口管理基于时间的聚合和分析。
容错: 确保系统可以从故障中恢复,而不会丢失数据或重新处理错误。
流处理组件
流分析 是一种托管服务,它使用基于 SQL 的查询语言来启用实时分析。 使用此服务执行简单的处理任务,例如筛选、聚合和联接数据流。 它与事件中心、IoT 中心和 Azure Blob 存储无缝集成,用于输入和输出。 流分析非常适合用于低复杂性实时任务,在这些场景中,基于 SQL 的查询和简单的托管解决方案已足够。
Fabric 和 Azure Databricks 等服务支持 Spark 结构化流式处理。 这些服务提供基于 Apache Spark 构建的统一分析平台,可以处理复杂的数据转换、机器学习管道和大数据工作负载。 Spark 流式处理 API 支持与 Delta Lake 的深度集成,以便进行数据版本控制与一致性。
Fabric 事件流 是 Fabric 中的实时数据流功能,它是统一的分析平台。 Eventstreams 支持无缝引入、处理和集成流式处理数据,以便进行实时分析和应用程序。 用户可以以最少的技术专业知识访问事件流。 它提供拖放接口来设置数据管道。
Azure Functions 是用于事件驱动处理的无服务器计算服务。 它适用于轻量级任务,例如基于实时事件转换数据或触发工作流。 Azure 函数设计上是无状态的。 持久函数功能扩展了支持复杂事件协调有状态工作流的功能。
流处理常规功能
| 能力 | 流分析 | Spark 结构化流式处理(Fabric、Azure Databricks) | Fabric 事件流 | Azure Functions |
|---|---|---|---|---|
| 微批处理 | 是 | 是 | 是 | 否 |
| 基于事件的处理 | 否 | 否 | 是 | 是 |
| 有状态处理 | 是 | 是 | 是 | 否 |
| 检查点支持 | 是 | 是 | 是 | 否 |
| 低代码接口 | 是 | 否 | 是 | 否 |
| 定价模型 | 流单元 | 是 | 构造 SKU | 是 |
流式处理接收器
系统处理数据后,它将数据导向合适的去向或 汇集点,以便进行存储、进一步分析或用于实时应用。 这些目标可能包括用于可视化的数据库、数据湖、分析工具或仪表板。
请考虑下列因素:
数据消耗和使用情况: 使用 Power BI 进行实时分析或报告仪表板。 它与 Azure 服务很好地集成,并提供数据流的实时可视化效果。
低延迟要求: 确定系统是否必须针对实时数据流(例如设备指标和应用程序日志)提供分析。 某些应用程序可能还需要超低的读取和写入延迟,这使得它们适用于作分析或实时应用程序。
可扩展性和数据量:评估你的工作负荷在以下方面的需求:摄取海量数据、支持多样化的数据格式,以及实现高效且经济的扩展。
流式处理接收器组件
Azure Data Lake Storage 是一种可缩放、分布式且经济高效的解决方案,用于存储非结构化和半结构化数据。 它支持 PB 级存储和高吞吐量工作负载,用于存储大量流数据。 它还支持快速读写操作,这些操作支持对流数据和实时数据管道进行分析。
Fabric eventhouse 是一个 KQL 数据库,用于实时分析和探索基于事件的数据,例如指标、日志、时序和 IoT 数据。 它支持以低延迟每秒引入数百万个事件。 此功能允许对流式处理数据实现几乎瞬时的访问。 Eventhouse 与 Fabric 生态系统深度集成。 它使用户能够使用 Power BI 等工具立即查询和分析流数据。
Azure Cosmos DB 是一个 NoSQL 数据库,用于低延迟、全局分布式且高度可缩放的数据存储。 它提供高吞吐量,可以处理大量具有一致性能的流式处理数据。
SQL 数据库 是一种完全托管的基于云的关系数据库服务。 它基于 SQL Server 引擎生成。 因此,它提供传统 SQL Server 数据库的功能,其优势是基于云的可伸缩性、可靠性和减少管理开销。
流式处理接收器常规功能
| 能力 | Data Lake Storage | Fabric 活动厅 | Azure Cosmos DB | SQL Database |
|---|---|---|---|---|
| 常规用途对象存储 | 是 | 否 | 否 | 否 |
| 流式处理数据聚合 | 否 | 是 | 否 | 否 |
| JSON 文档的低延迟读取和写入 | 否 | 是 | 是 | 否 |
| Power BI 的结构化数据聚合 | 否 | 是 | 否 | 是 |
| 定价模型 | 每 GB 或 TB | 构造 SKU | 请求单位 | 数据库事务单元(DTU)或 vCore |
贡献者
Microsoft维护本文。 以下参与者撰写了本文。
主要作者:
- Pratima Valavala |首席解决方案架构师
若要查看非公开的领英个人资料,请登录领英。
后续步骤
浏览以下训练模块: