Important
此功能在 Beta 版中。 要使用它,工作区管理员必须从预览页面开启代理内存会话。 请参阅 Manage Azure Databricks 预览版。
代理记忆赋予代理跨对话持续的长期记忆。 Azure Databricks 将内存存储在 Lakebase 中,并帮你管理存储、索引和搜索,这样你的代理就能记住用户偏好、过去的决策和积累的上下文,而无需你操作数据库。
注释
在预览阶段,系统会就用于存储记忆条目的底层 Lakebase 实例向你收费。 智能体记忆本身没有额外费用。 随着预览的推进,定价可能会有所调整。
当你希望智能体执行以下操作时,请使用智能体记忆:
- 在不同对话之间记住用户偏好、事实和决策。
- 根据客服在之前的会谈中学到的内容,个性化回答。
- 在经纪人和项目间分享积累的知识。
- 随着时间的推移提高准确性和效率。
代理内存适用于基于任何框架的代理。 如果想在单次交互中保留短期对话历史,可以使用 智能体会话。
Requirements
- 安装 Python 3.10 或更高版本,以使用 AgentKit SDK。 AgentKit SDK 是 Databricks Python 代理 API 客户端,下面的示例就是用它。 你也可以直接从任何语言调用 REST API,无需 Python 要求。
- 使用
memory_store.put()或memory_store.list(path=...),安装databricks-agentbricks0.6.0及以上版本。
代理内存的工作原理
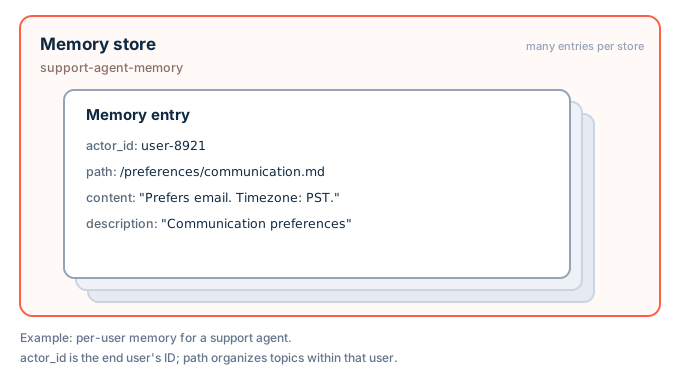
代理内存有两个层级:
- 记忆存储是用于存放代理记忆的工作区级容器。 创建存储库时,系统会自动为底层的 Lakebase 存储预配资源。 你通过商店 ID 来标识商店,创建商店时选择这个 ID。
-
记忆条目是存储库中的一个独立内容项。 每个条目包含一个自由形式文本
content、用于检索的短文description,以及一组用于组织和划分的字段:-
actor_id(必需):内存的归属,如终端用户或其他代理。 -
session_id(可选):该内存所属的会话。 如果要让内存应用于该参与者的各个会话,请将其保留为未设置状态。 -
path(必填):一种类似文件系统的路径,用于组织 Actor 内的条目,例如/preferences/response-style.md。
-
一个条目由 session_id、path 和 actor_id 的组合唯一标识。 同一路径在两个不同会话下,或在某个会话下或不在任何会话下,会包含两个独立的条目。
条目通过以下两种方式进入存储:你的智能体或应用程序直接写入条目,或者记忆管道从会话存储内的对话中提取这些条目。
检索
内存检索有两种方式:
- 参与者的列表条目,可选择通过
session_id、path前缀或确切的path来筛选。 用它来浏览或渲染代理所知的索引。 - 使用自然语言查询搜索某位演员的条目。 搜索结果会返回按相关性评分排名的最相关条目。
任一操作的 session_id 过滤器只返回该会话中保存的条目。 它不会返回会话中未保存的条目。
开始
AgentKit SDK 和 REST API 示例为支持代理设置了代理内存:它们创建内存存储,保存用户的偏好,并在后续对话中取回该偏好。 Agent Bricks CLI 示例将内存存储连接到你用 CLI 构建和部署的代理。 选择最适合你项目的客户。 存储 ID 必须为 3 到 56 个字符,以小写字母开头,以字母或数字结尾,且仅包含小写字母、数字和连字符。
AgentKit SDK
AgentKit SDK 是 Databricks Python 客户端,用于代理 API,分发在包中databricks-agentbricks。 它通过Databricks SDK WorkspaceClient进行认证。
安装 AgentKit SDK:
pip install databricks-agentbricks为你的代理人创建一个记忆存储。
AgentKitClient使用你的WorkspaceClient凭据进行身份验证:from databricks.sdk import WorkspaceClient from databricks_agentkit import AgentKitClient client = AgentKitClient(WorkspaceClient()) memory_store = client.memory_stores.create("support-agent-memory")在智能体了解到关于用户的持久信息后,保存记忆。
actor_id表示记忆的归属,path在该主体下组织记忆,description改进检索:memory_store.add( actor_id="user-123", path="/preferences/communication.md", content="Prefers email over phone. Timezone: PST. Enterprise subscription.", description="User 123 communication preferences", )如果该路径上已存在条目,
add()会因ALREADY_EXISTS而失败。 要创建条目或更新现有条目,使用相同的参数调用memory_store.put()。通过自然语言搜索,在后续对话中调取用户的记忆:
results = memory_store.search(actor_id="user-123", query="communication preferences", limit=10)
REST API
客户端在 /api/2.0/agents/memory-stores 下调用 REST API。 对于Python以外的语言,直接调用它。
使用 Databricks CLI 生成 OAuth 令牌:
databricks auth login --host ${DATABRICKS_HOST}
export DATABRICKS_TOKEN=$(databricks auth token | jq -r .access_token)
为你的代理人创建一个记忆存储:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores?managed_memory_store_id=support-agent-memory" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"description": "Support agent memory"}'
为用户保存一个内存条目。
actor_id表示记忆的归属,path组织记忆,description改进检索:curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \ -d '{"actor_id": "user-123", "path": "/preferences/communication.md", "content": "Prefers email over phone.", "description": "Communication preferences"}'如果该路径中已存在条目,则请求会因
ALREADY_EXISTS(HTTP 409)而失败。 要更新现有条目,可以用路径查找。 查找会返回每次会话的路径条目,所以选择其session_id匹配的那个条目。 其name最后一段是条目 ID:curl -G "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" \ --data-urlencode "actor_id=user-123" --data-urlencode "path=/preferences/communication.md"然后通过ID更新条目内容:
curl -X PATCH "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries/<entry-id>?update_mask=content" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"content": "Prefers email over phone. Timezone: PST."}'
通过自然语言搜索回忆用户的记忆:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries:search" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"actor_id": "user-123", "query": "communication preferences"}'
Agent Bricks
如果你用 Agent Bricks CLI 构建代理,agentbricks init 会在 agent.toml 中声明一个内存存储。
agentbricks deploy 如果存储还不存在,就创建它,并授予部署代理访问该存储的权限。
选择一个路径:
以空配置启动(大多数智能体):部署智能体。
agentbricks deploy创建agentbricks init声明的内存存储。 要部署名为my-agent的代理,请执行以下操作:agentbricks deploy my-agent从存储中已有的记忆开始:先创建存储,添加条目,然后将存储绑定到代理并部署。
要创建一个名为
my-agent-memory的商店,运行以下操作。 输出包含商店ID,这是一个与商店名称分开的生成标识符:agentbricks memory stores create --name my-agent-memory要添加条目,运行以下操作,替换
<store-id>为上一步的商店 ID:agentbricks memory entries create --store <store-id> --actor-id you@example.com \ --path /preferences/style.md --content "Prefers Python and concise answers with code examples."要绑定存储库并部署智能体,请运行以下命令。
agentbricks memory bind在agent.toml中替换店名,并且agentbricks deploy按名称查找现有商店并使用它,而不是创建新的商店:agentbricks memory bind my-agent-memory agentbricks deploy my-agent
--path 是条目在存储中的密钥,而不是你机器上的文件。
--actor-id 是记忆所属的用户。 部署的代理使用已登录用户的邮箱作为行为者 ID,因此每个条目都要预填与代理聊天的用户邮箱。
在 Agent Bricks CLI 中,memory bind 和 agentbricks deploy 均通过其名称来引用存储库。 作用于单个存储的命令(如 memory entries create,)会使用生成的存储ID。
为你的智能体配备记忆工具
让代理决定何时保存和调用内存,将客户端操作包装为工具,并在系统提示符中指示代理何时使用。 根据经过验证的终端用户身份,在受信任的应用程序代码中设置 actor_id。 绝不要让模型自己选择读写谁的内存。
以下示例将 Get Start 中的 AgentKit SDK memory_store 包装为 OpenAI 代理 SDK 的工具。
from agents import Agent, function_tool

def make_memory_tools(memory_store, actor_id: str):
    @function_tool
    def search_memory(query: str) -> str:
        """Search long-term memory for relevant facts about the user."""
        results = memory_store.search(actor_id=actor_id, query=query, limit=10)
        return "\n\n".join(f"{r.memory.path}: {r.memory.content}" for r in results) or "No memory found."

    @function_tool
    def save_memory(path: str, content: str, description: str = "") -> str:
        """Save a durable, long-term memory about the user, replacing any memory at the same path."""
        memory_store.put(actor_id=actor_id, path=path, content=content, description=description or None)
        return f"Saved memory at {path}"

    @function_tool
    def list_memories() -> str:
        """List the paths and descriptions of the user's long-term memories."""
        memories = memory_store.list(actor_id=actor_id)
        return "\n".join(f"{m.path}: {m.description}" if m.description else m.path for m in memories) or "No memory found."

    @function_tool
    def forget_memory(path: str) -> str:
        """Delete the long-term memory at a path, such as when the user asks you to forget it."""
        memories = list(memory_store.list(actor_id=actor_id, path=path))
        for memory in memories:
            memory.delete()
        return f"Forgot memory at {path}" if memories else f"No memory at {path}"

    return [search_memory, save_memory, list_memories, forget_memory]

agent = Agent(
    name="Support agent",
    instructions="Save durable user preferences, recall them when relevant, and forget them when the user asks.",
    tools=make_memory_tools(memory_store, actor_id="user-123"),
)
put() 创建该条目,或替换该路径上已存在的条目内容。 要将内容添加为新行,请传递 append=True。
put() 不是原子的,所以并发写入同一条路径可能会互相覆盖。
list(path=...) 在每个会话中返回该路径的条目,因此 forget_memory 也会删除会话下该路径上保存的任何条目。
同样的模式适用于 Claude Agent SDK 和其他框架:将存储的搜索、放置、列出和删除操作封装为框架的工具类型。
如果你还在同一个记忆存储上运行记忆管道,则该管道可以重写、合并、拆分或删除智能体为其处理的任何角色保存的条目。
分区与安全内存
在存储中,actor_id 用于区分记忆的归属。 每个列表和搜索都限定在单个 actor_id 内,因此请选择与您的智能体需要记住的内容相匹配的策略:
-
每个用户的私有内存: 设置为
actor_id已验证的终端用户身份。 每个用户都有自己的分区,代理只会调用该用户的条目。- 示例: 客服人员会记住一位用户的沟通偏好和过去的工单。
-
组的共享记忆: 将
actor_id设置为你选择的固定键,例如团队、项目或组织 ID。 每个人都读取和写入相同的记忆。- 示例: 团队代理记住公司术语和内部惯例的共享词汇表。
-
按其他内容划分内存:使用你自己的值构建
actor_id,例如租户 ID 或user:project组合值。-
示例: 多租户应用将
actor_id设置为{tenant}:{user},从而使每个客户的用户彼此隔离。
-
示例: 多租户应用将
在应用程序代码中,将 actor_id 设置为来自可信调用方上下文的值:对于按用户划分的内存,使用经验证的终端用户身份;对于共享内存,使用可信的团队或项目密钥。 绝不要让模特自己选择。 如果你的策略依赖于最终用户身份,那么对于未携带该身份的请求,应拒绝处理,而不是回退为使用共享的 actor_id。
Warning
actor_id 它会分离记忆,但不是访问控制。 内存存储是工作空间范围的,因此任何能够访问存储的主体都可以读取和写入跨所有 actor 的所有条目。 商店,而非演员,才是安全边界。 为了严格隔离租户或用户,每个边界创建一个独立的内存存储。
若要让另一个主体(例如智能体的服务主体)使用存储,请通过存储的授予权限操作(AgentKit SDK 中的 memory_store.grant_permission(principal_id))向其授予访问权限。 只有商店的创建者或工作区管理员可以授权访问。 请参阅“管理代理内存和会话存储的权限”,了解权限级别、支持操作及示例。
Limitations
- 智能体记忆仅提供长期记忆。 关于短期对话历史记录,请参见智能体会话。
- 搜索通过通过内容和描述的全文(BM25)和语义匹配,对条目进行相关性排序。 它最多返回100条条目,且不支持分页。
- 门店层面执行访问控制。 针对每个条目和每个参与者的访问控制不可用。
- 商店门禁控制涵盖商店的入口。 任何工作区用户可以列出并获取内存存储,包括它们的ID和描述。
- 创建商店后你不能更改ID。 只有
description可以更新。