将工作负荷从经典计算迁移到无服务器计算。 无服务器计算会自动处理预配、缩放、运行时升级和优化。
大多数经典工作负荷只需进行最少或没有代码更改即可迁移。 本页重点介绍这些工作负载。 某些功能(例如 df.cache,在无服务器)上尚不受支持,但一旦可用,就不需要更改代码。 依赖于 R 或 Scala 笔记本的某些工作负荷需要经典计算,并且无法迁移到无服务器。 有关当前限制的完整列表,请参阅 无服务器计算限制。
使用迁移代理进行迁移
Important
此功能在 Beta 版中。 工作区管理员可以通过选择进入计算代理预览页面来启用该功能。 请参阅 Manage Azure Databricks 预览版。
你可以使用迁移代理将单个笔记本或作业迁移到无服务器计算。 代理会审查工作负载的环境、库、Spark配置、标签和代码,然后将每一项变更作为单独建议提交给你接受或拒绝。 已接受的更改会直接应用到原位置,并且可以回滚。
代理人审核和更改的内容
| Area | 代理的作用 |
|---|---|
| 环境与库 | 将库安装转换成无服务器环境规范,包括 %pip 安装、集群初始化脚本、作业中的集群库以及对私有包索引的引用。 |
| 环境变量 | 将集群环境变量转换为无服务器等效变量,保留工作区秘密引用,省略平台管理值。 |
| 数据与存储访问 | 将与无服务器环境不兼容的路径(如本地磁盘、dbfs:/ 和挂载路径)重写为 Unity Catalog 卷。 当目标不明确时,智能体会自动应用明确的重写并要求你选择一个卷。 |
| Spark 配置 | 对每个 Spark 配置进行分类,注释哪些配置可以安全丢弃,并标记和移除无服务器不支持的配置。 涵盖连接到集群的配置和笔记本内配置两种情况。 |
| 工作负载代码 | 将无服务器不支持的代码重写为兼容的等效程序,如将RDD操作重写为DataFrame操作,并调整代码以适应无服务器模式下的ANSI模式SQL行为。 |
| 标签 | 将自定义集群标签(如成本中心标签)转换为无服务器对应标签。 |
| 表演模式 | 建议基于集群配置的性能模式。 请参阅 “选择性能模式”。 |
要求
建议使用工作区管理员权限以确保完成完整的迁移。 这是因为代理还会检查超出目标工作负载的工作区层级全局初始化脚本。 如果你对工作负载有
CAN MANAGE权限,可能可以迁移,但没有管理员权限,可能会导致库、环境设置或标签丢失。确认你能联系到客服。 在 Genie Code 中输入
/compute。/compute应该会出现在自动补全菜单中。 如果没有显示,工作区管理员必须在你的工作区中启用预览。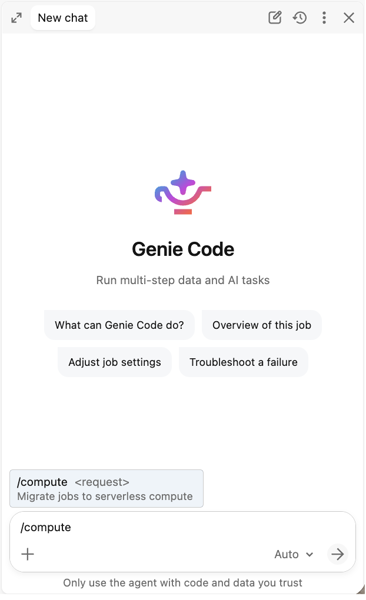
迁移笔记本
- 打开你想迁移的笔记本。
- 打开精灵代码,从
/命令面板运行/compute migrate to serverless。 - 审查经纪人的调查结果。 代理扫描笔记本的环境、库和代码,并针对每个需要更改的项目提出变更建议,比如将库安装迁移到环境规范中,或重写代码单元以实现无服务器运行。
- 接受或拒绝每一项提议的变更。
- 应用你接受的变更。 它们会被写入笔记本中的适当位置。
- 将该笔记本关联到无服务器计算环境并运行,以确认其运行表现是否符合你的预期。 参见 验证迁移工作负载。
迁移工作
- 开你想迁移的职位。
- 打开精灵代码,从
/命令面板运行/compute migrate to serverless。 - 代理会克隆你的作业,然后尝试将克隆出的作业迁移到无服务器环境。
- 审查经纪人的调查结果。 对于多任务作业,代理枚举每个任务及其每个任务集群的配置,并在保持作业的进度的前提下提出变更建议。
- 接受或拒绝迁移表面上的每一项拟议变更:环境和库、Spark配置以及任何必须更改的工作负载代码。
- 应用你接受的变更。 该作业的计算资源已切换为无服务器。
- 在无服务器模式下运行工作并确认结果。 参见 验证迁移工作负载。
- (可选)作为最后一步,智能体会提升迁移后的克隆体。 它会把克隆的配置和笔记本复制回你原来的作业(保持相同的作业ID、排程和权限),然后删除克隆。 如果你跳过提升并保留两个作业,请暂停未运行的那个作业的调度计划,否则同一个触发器会同时触发这两个作业,导致重复写入或其他副作用。
验证迁移的工作负载
代理会提议并应用更改,但不会运行你的工作负载或验证其输出。 务必先在无服务器环境中运行迁移后的工作负载,并在确认结果无误后再依赖它,尤其是那些会写入生产表的工作负载。 如果代理提出的修改看起来不对,拒绝并给我们反馈,以便改进代理。 请参阅 提交产品反馈。
Tip
在验证迁移工作负载时,先以性能优化模式运行。 它启动得比标准模式快,所以确认结果后反馈更快。 在生产环境中运行之前,切换到最适合工作负载的模式。 请参阅 “选择性能模式”。
当代理发现无法安全迁移的内容时,会报告阻塞并默认停止。 你可以明确指示其继续执行并绕过某些兼容性或依赖性阻碍,但这样做就等于接受这样的风险:这些依赖关系、成本归属或运行时行为可能无法沿用到新环境中,并且该工作负载可能会在无服务器环境中运行失败。
回滚迁移变更
代理人施加的变化是可逆的。
对于笔记本,打开并恢复迁移前的版本。 请参阅 Databricks 笔记本中的版本历史记录。
对于某个作业,如果您没有将迁移后的克隆副本提升为正式作业,那么原始作业从未发生变化:仍可像以前一样运行它,然后删除该克隆副本。 如果你是推广了克隆,请从代理在做任何更改前写的备份恢复:
- 在你的工作空间主页打开备份文件夹:
/Workspace/Users/<your-username>/serverless-migration/backups/job-<job-id>/<timestamp>/。 代理程序在迁移过程中显示了此路径。 如果有多个时间戳,选择迁移前不久的那个。 - 打开
job.yaml(其中包含迁移前的作业设置),然后通过POST /api/2.2/jobs/reset请求将这些设置重新应用到同一个作业;该请求会用你提供的设置覆盖该作业的设置。 你也可以把它们粘贴到UI里的作业JSON定义里。 这会使作业返回到经典计算模式。 - 打开
mapping.yaml,列出每个备份文件及其原始路径。 将每个备份文件复制回其原始路径以撤销代码重写。 - 运行该作业,以确认其行为与迁移前一致。
迁移过程中从未删除过这个备份。 代理未修改的任务,如git-sourced、SQL或dbt任务,会被记录在 job.yaml 备份中,但它们的文件不会复制到备份中,因此如有需要,请从真实来源恢复这些任务。
已知的限制
- 以下被报告为阻碍:自定义镜像、机器学习运行时变体、13 之前的 Databricks 运行时版本、无法在无服务器环境中安全忽略的 Spark 配置,以及诸如 eggs、JAR 和 Maven 库等依赖。 出现阻塞项时,智能体会停止,而不是迁移该项。 你既可以自行解决该问题并再次运行迁移,也可以让代理仍然继续迁移,但这样会使该项保持未解决状态,并可能导致工作负载在无服务器环境中失败。
- 代理读取存储在工作区文件或 Unity 目录卷中的初始化脚本。 存储在ABFSS或DBFS中的init脚本无法读取,并被报告为阻断器。
- 代理不会检查所有经典计算属性。 集群日志传递和SSH密钥未被建模,虽然它检测到许多DBFS挂载依赖,但不会枚举或解析每一个挂载。
- 缓存和检查点API、全局临时视图、DBFS挂载管理调用以及Scala或R代码默认是硬阻挡器。 你可以指示代理继续,但未解决的功能保持不变,且在无服务器上可能会失败。
- 拥有超过 10 个可迁移任务的作业目前无法迁移。
- 代理程序每次迁移一个工作负载。 没有全局发现、批量迁移或管理员审批流程。
- 代理会提议更改并应用你接受的,但不会执行你的工作负载或验证输出是否正确。 在依赖其获取生产数据之前,先验证已迁移的工作负载。
- 如果你的工作负载真实来源是Databricks资产包或Git文件夹,代理会对工作区对象进行更改。 将这些更改与你的捆绑包或代码仓库保持一致,以免后续部署覆盖此次迁移。
手动迁移到无服务器
若要将工作负荷从经典计算迁移到无服务器计算,请执行以下步骤:
- 检查先决条件:验证工作区、网络和云存储访问是否符合要求。 请参阅 先决条件。
- 更新代码:进行任何必要的代码和配置更改。 请参阅 “更新代码”。
- 测试工作负载:在切换之前验证兼容性和正确性。 请参阅 “测试工作负荷”。
- 选择性能模式:选择最符合工作负荷要求的性能模式。 请参阅 “选择性能模式”。
- 分阶段迁移:从新的低风险工作负载开始,以增量方式推出无服务器工作负荷。 请参阅 分阶段迁移。
- 监视成本:跟踪无服务器 DBU 消耗并设置警报。 请参阅 “监视成本”。
Prerequisites
在开始迁移之前,可能需要更新工作区中的某些旧配置。
| 先决条件 | Action | 详细信息 |
|---|---|---|
| 启用 Unity Catalog 工作区 | 如有需要,从 Hive Metastore 迁移 | 将Azure Databricks工作区更新到 Unity 目录 |
| 已配置网络 | 用 NCC、专用链接或防火墙规则替换 VPC 对等互连 | 无服务器计算平面网络 |
| 云存储访问 | 将旧数据访问模式替换为 Unity 目录外部位置 | 使用 Unity Catalog 连接到云对象存储 |
确认工作区位于 受支持的区域中。
更新代码
以下部分列出了使工作负载与无服务器兼容的代码和配置更改。
数据存取
无服务器架构不支持旧数据访问模式。 请更新代码以使用 Unity Catalog。
| 经典模式 | 无服务器替代方案 | 详细信息 |
|---|---|---|
DBFS 路径 (dbfs:/...) |
Unity Catalog 卷 | 什么是 Unity Catalog 容量? |
| Hive Metastore 表 | Unity Catalog 表(或 HMS Federation) | 将Azure Databricks工作区更新到 Unity 目录 |
| 存储帐户凭据 | Unity Catalog 的外部位置 | 使用 Unity Catalog 连接到云对象存储 |
| 自定义 JDBC JAR | 湖仓联合体 | 什么是查询联合? |
警告
DBFS 访问在无服务器时受到限制。 在迁移之前更新 Unity 目录卷的所有 dbfs:/ 路径。 有关详细信息,请参阅 迁移存储在 DBFS 中的文件。
示例:替换 DBFS 路径和 Hive 元存储引用
# Classic
df = spark.read.csv("dbfs:/mnt/datalake/data.csv", header=True)
df.write.parquet("dbfs:/mnt/output/results")
df = spark.table("my_database.my_table")

# Serverless
df = spark.read.csv("/Volumes/main/sales/raw_data/data.csv", header=True)
df.write.parquet("/Volumes/main/analytics/output/results")
df = spark.table("main.my_database.my_table")  # three-level namespace
API 和代码
某些 API 和代码模式在无服务器环境中不受支持。 引用此表以查看代码是否需要更新。
| 经典模式 | 无服务器替代方案 | 详细信息 |
|---|---|---|
RDD 接口 (sc.parallelize,rdd.map) |
DataFrame API | 将 Spark Connect 与 Spark 经典版进行比较 |
df.cache()、df.persist() |
删除缓存调用 | 无服务器计算限制 |
spark.sparkContext、sqlContext |
直接使用 spark (SparkSession) |
将 Spark Connect 与 Spark 经典版进行比较 |
Hive 变量 (${var}) |
SQL DECLARE VARIABLE 或 Python f-strings |
DECLARE VARIABLE |
| 不支持的 Spark 配置 | 删除不支持的配置。 无服务器自动优化大多数设置。 | 为无服务器笔记本和作业配置 Spark 属性 |
示例:将 RDD 操作替换为数据帧
from pyspark.sql import functions as F

# sc.parallelize + rdd.map
# Classic:  rdd = sc.parallelize([1, 2, 3]); rdd.map(lambda x: x * 2).collect()
df = spark.createDataFrame([(1,), (2,), (3,)], ["value"])
result = df.select((F.col("value") * 2).alias("value")).collect()

# rdd.flatMap
# Classic:  sc.parallelize(["hello world"]).flatMap(lambda l: l.split(" ")).collect()
df = spark.createDataFrame([("hello world",)], ["line"])
words = df.select(F.explode(F.split("line", " ")).alias("word")).collect()

# rdd.groupByKey
# Classic:  rdd.groupByKey().mapValues(list).collect()
df = spark.createDataFrame([("a", 1), ("b", 2), ("a", 3)], ["key", "value"])
grouped = df.groupBy("key").agg(F.collect_list("value").alias("values")).collect()

# rdd.mapPartitions → applyInPandas
import pandas as pd
def process_group(pdf: pd.DataFrame) -> pd.DataFrame:
    return pd.DataFrame({"total": [pdf["id"].sum()]})
result = (spark.range(100).repartition(4)
    .groupBy(F.spark_partition_id())
    .applyInPandas(process_group, schema="total long").collect())

# sc.textFile → spark.read.text
df = spark.read.text("/Volumes/catalog/schema/volume/file.txt")
示例:替换 SparkContext 和缓存
from pyspark.sql.functions import broadcast

# sc.broadcast → broadcast join
result = main_df.join(broadcast(lookup_df), "key")

# sc.accumulator → DataFrame aggregation
total = df.agg(F.sum("amount")).collect()[0][0]

# sqlContext.sql → spark.sql
result = spark.sql("SELECT * FROM main.db.table")

# df.cache() → remove caching calls
# Materialize expensive intermediate results to Delta as a workaround:
df = spark.read.parquet(path)
result = df.filter("status = 'active'")
expensive_df.write.format("delta").mode("overwrite").saveAsTable("main.scratch.temp")
result = spark.table("main.scratch.temp")
SQL 行为差异
无服务器计算默认启用ANSI模式。 Databricks 运行时在版本 17.0 及以上默认启用 ANSI 模式。 如果你的经典计算运行的是早期版本,某些在那里可成功运行的查询在无服务器环境中会引发运行时错误。
迁移代理会自动调整代码以适应ANSI模式的行为。 如果你手动迁移,请检查以下操作,这些操作最常会改变行为:
| 运算 | 已禁用 ANSI 模式的经典计算资源 | 无服务器计算 |
|---|---|---|
无效的类型转换,例如 CAST('abc' AS INT) |
返回 NULL |
引发 CAST_INVALID_INPUT |
| 整数算术溢出 | 环绕。 例如,2147483647 + 1 返回 -2147483648。 |
引发 ARITHMETIC_OVERFLOW |
| 十进制算术溢出 | 返回 NULL |
引发 NUMERIC_VALUE_OUT_OF_RANGE |
| 除以零 | 返回 NULL |
引发 DIVIDE_BY_ZERO |
| parse_url 中的 URL 格式错误 | 返回 NULL |
提升 INVALID_URL |
要返回 NULL 而非引发错误,只需用其 try_* 等价操作替换该操作,如 try_cast、try_add、try_divide 或 try_parse_url。 Databricks 推荐采用这种方法,而不是禁用 ANSI 模式,因为 ANSI 模式会揭示静默 NULL 模式隐藏的数据质量问题。
要为强制转换、算术和解析选择退出 ANSI 模式,请将 spark.sql.ansi.enabled 设置为 false。 无服务器计算对表插入的隐式cast应用ANSI规则,无论该设置如何,因为 spark.sql.storeAssignmentPolicy 在无服务器计算中无法更改。 有关ANSI行为的完整描述,请参见 Databricks运行时中的ANSI合规。
库和环境
利用基础环境在工作区级别管理库和环境,利用笔记本的无服务器环境在笔记本级别管理。
| 经典模式 | 无服务器替代方案 | 详细信息 |
|---|---|---|
| 初始化脚本 | 无服务器环境 | 配置无服务器环境 |
| 群集范围的库 | 笔记本范围库或环境库 | 配置无服务器环境 |
| Maven/JAR 库 | 用于作业的 JAR 任务支持;用于笔记本的 PyPI | 用于作业的 JAR 任务 |
| Docker 容器 | 适用于库需求的无服务器环境 | 配置无服务器环境 |
在 requirements.txt 中锁定 Python 包,以创建可重现的环境。 请参阅 Specify Python 包版本。
流媒体
无服务器架构支持流式工作负载,但不支持某些类型的触发器。 更新代码以使用支持的触发器。
| Spark 触发器 | 支持 | 备注 |
|---|---|---|
Trigger.AvailableNow() |
是的 | 推荐 |
Trigger.Once() |
是的 | 此功能已弃用。 请改用 Trigger.AvailableNow()。 |
Trigger.ProcessingTime(interval) |
否 | 返回 INFINITE_STREAMING_TRIGGER_NOT_SUPPORTED |
Trigger.Continuous(interval) |
否 | 改用 Lakeflow 管道连续模式 |
默认值(未设置 .trigger()) |
否 | 省略 .trigger() 会默认使用 ProcessingTime("0 seconds"),但这在无服务器环境中不被支持。 始终显式设置 .trigger(availableNow=True) 。 |
对于连续流式数据处理,请在连续模式下迁移到 Spark 声明性管道,或将连续计划作业与 AvailableNow 一起使用。 对于大型源,请设置 maxFilesPerTrigger 或 maxBytesPerTrigger 防止内存不足错误。
示例:修复流触发器
# Classic (not supported on serverless — default trigger is ProcessingTime)
query = df.writeStream.format("delta").outputMode("append").start()

# Serverless (explicit AvailableNow trigger)
query = (df.writeStream.format("delta").outputMode("append")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
query.awaitTermination()

# With OOM prevention for large sources
query = (spark.readStream.format("delta")
    .option("maxFilesPerTrigger", 100)
    .option("maxBytesPerTrigger", "10g")
    .load(input_path)
    .writeStream.format("delta")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
测试工作负荷
- 快速兼容性测试:使用 标准 访问模式和 Databricks Runtime 14.3 或更高版本在经典计算上运行工作负荷。 如果运行成功,工作负载可以迁移到无服务器,而无需进行任何代码更改。
- A/B 比较 (建议用于生产):在经典(控制)和无服务器(试验)上运行相同的工作负荷。 对比输出表格及验证正确性。 反复进行,直到输出匹配。
- 临时配置:可以在测试期间临时设置支持的 Spark 配置。 一旦稳定,请将其删除。
选择性能模式
无服务器作业和管道支持两种性能模式:标准和性能优化。 选择的性能模式取决于工作负荷要求。
| 模式 | 可用性 | 初创企业 | 最适用于 |
|---|---|---|---|
| 标准 | 作业、Lakeflow 管道 | 4-6 分钟 | 成本敏感批处理 |
| 性能优化型 | 笔记本、作业、Lakeflow 管道 | 秒 | 交互式、延迟敏感 |
分阶段迁移
- 新工作负载:在无服务器上启动所有新的笔记本和作业。
- 低风险工作负荷:迁移已在标准访问模式和 Databricks Runtime 14.3 或更高版本上的 PySpark/SQL 工作负荷。
- 复杂工作负荷:迁移需要代码更改的工作负载(RDD 重写、DBFS 更新、触发器修复)。
- 剩余工作负荷:随着功能扩展而定期查看。
监控成本
无服务器计费基于 DBU 消耗,而不是群集运行时间。 在大规模迁移之前,先验证具有代表性工作负荷的成本预期。 有关监视无服务器成本的工具和策略,请参阅 “监视无服务器计算的成本”。
其他资源
- 无服务器计算的最佳做法:无服务器工作负荷的优化提示
- 无服务器计算限制:当前限制和不支持的功能的完整列表
- 配置无服务器环境:管理库和依赖项
- 支持的 Spark 配置:在无服务器环境中可用的 Spark 配置
- Spark Connect 与经典 Spark:无服务器体系结构中的行为差异
- 无服务器网络安全:NCC、专用链接 和防火墙配置
- 无服务器计算发布说明:跟踪随其发布的新功能
- Unity 目录升级指南:从 Hive 元存储迁移到 Unity 目录
还可以参阅以下博客文章了解详细信息:
- 什么是无服务器计算?:无服务器功能和客户结果概述
- 数据工程的演变:无服务器计算如何改变笔记本和 Lakeflow 作业:无服务器如何为 Lakeflow 作业和管道提供支持