来自 sdp-meta 的 项目提供了可根据您维护的元数据生成流水线的工具。
注释
开放源代码 sdp-meta 项目,和 databrickslabs GitHub 账户中的所有项目一样,仅供探索用途。 Azure Databricks 不支持它或为其提供服务级别协议(SLA)。 不要提交 Azure Databricks 支持票证以解决与此项目相关的问题。 请改为提交一个GitHub issue,我们会在时间允许时进行查看。
什么是SDP-Meta?
Lakeflow 管道允许以声明方式指定表,并在管道中生成一个流,该流在源数据发生更改时同时创建该表并使其保持最新状态。 但是,如果你的组织有数百个表,则生成和管理这些管道非常耗时,并可能导致不一致的做法。
sdp-meta 项目是一个以元数据驱动的元编程框架,设计用于配合 Lakeflow 管道工作。 此框架利用一组 JSON 和 YAML 文件中记录的元数据,实现了青铜和白银数据管道的自动化。 运行时,通用流水线读取你的元数据,并动态构建其中描述的流程。 青铜和银的加工可以在独立的管道中运行,也可以在合并的管道中进行。 你生成关于你管道的元数据,而 sdp-meta 则生成你的管道。
将逻辑集中到一个位置(元数据),系统速度更快、可重用且更易于维护。
注释
sdp-meta 项目以前名为 dlt-meta,源自 Azure Databricks 中较早的 Delta Live Tables 功能。
Delta Live Tables 已由 Lakeflow pipelines 取代,sdp-meta 可与 Lakeflow pipelines 配合使用。 如果你正在升级现有 dlt-meta 安装,请查看 sdp-meta 文档中的 迁移指南 。
sdp-meta 的优势
SDP-meta 主要有两个用例:
- 轻松引入和清理大量表。
- 跨多个管道和用户强制实施数据工程标准。
使用元数据驱动方法的好处包括:
- 无需了解 Python 或 SQL 代码即可维护元数据。
- 维护元数据(而不是代码)需要更少的开销,并减少错误。
- 代码由 sdp-meta 生成,保持一致性,且在管道和发布表间的自定义代码较少。
- 可以轻松地将表分组到元数据中的管道中,从而生成最有效地更新数据所需的管道数。
sdp-meta 的工作原理
下图展示了sdp-meta系统的概述:
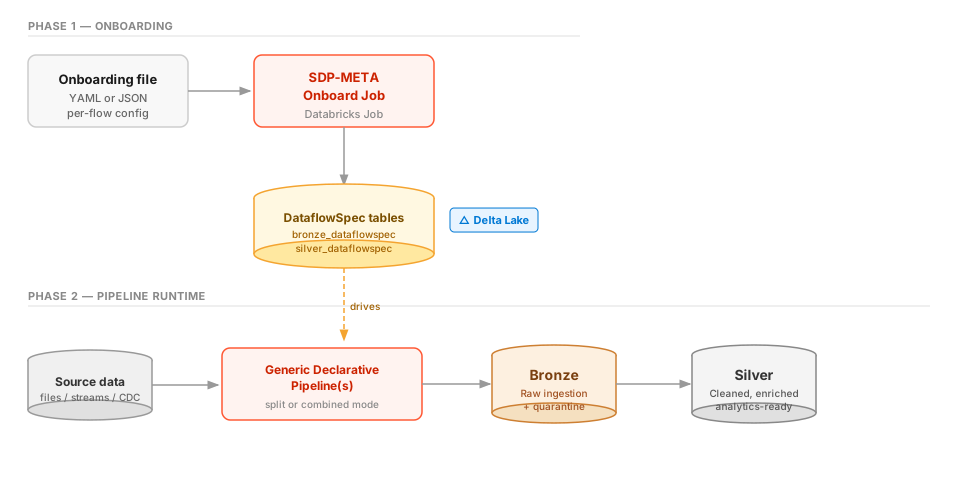
- 你创建元数据文件作为 sdp-meta 的输入,以指定源文件和输出、质量规则以及所需的处理。 这些引导文件可以用 JSON 或 YAML 编写。
- 你负责SDP-Meta的入职工作。 该引擎将引导文件编译成称为 DataflowSpec的数据流规范,并将其存储在Delta表(
bronze_dataflowspec和silver_dataflowspec)中以备后用。 - 运行时,通用流水线读取DataflowSpec并动态构建青铜处理图。 它会读取你的源数据(文件、数据流或 CDC),并应用与质量规则相匹配的相应数据期望规则,生成你的青铜表,并将未通过这些规则的记录隔离出来。
- Silver 处理可以在独立的通用管道中运行,这是声明式自动化捆绑包的默认配置,或者在使用合并模式时在同一管道内运行。 该流水线使用 DataflowSpec 来应用相应的转换并执行其他处理,生成已清理、增强且可直接用于分析的银表。
你需要运行由 sdp-meta 生成的流水线,以便在源数据更新时使输出保持最新。
开始
要使用 sdp-meta,你必须:
- 部署并配置SDP-meta解决方案。
- 为青铜层表和银层表准备元数据。
- 创建作业以导入元数据。
- 使用元数据为数据表构建管道。
sdp-meta项目支持多个部署接口:推荐的捆绑包、交互式CLI、带有浏览器图形界面的Databricks应用、用于AI辅助设置的MCP服务器,以及为具技能感知的AI代理提供便携式代理技能。
GitHub上的sdp-meta文档里有教程,帮助你开始这个过程。 更多信息请参见 GitHub 上的 sdp-meta 入门指南。