重要
此功能目前以公共预览版提供。
AI 运行时为无服务器GPU计算提供两个托管的Python环境。 标准环境包括 cuda。 从环境版本 5 起, torchtorchvision 不再预安装。 Databricks 的 AI 环境预装了 PyTorch、Transformers 以及其他机器学习和深度学习框架。 选择标准环境以完全控制依赖项堆栈,或选择 AI 环境,以便进行随时可用的训练设置。 你可以从任一环境开始,自己安装更多包。
本页要点:
- 选择 标准 环境以完全控制依赖,或选择 Databricks AI 环境以获得现成的机器学习栈。
- 标准包括
cuda。 从环境版本 5 起,torch和torchvision均未预安装。 AI环境还加入了PyTorch、变形金刚等。 - 在笔记本中使用
%uv pip install(环境版本 5 及以上)或%pip install,或者在 CLI 中使用environment.dependencies,安装更多软件包。
应使用什么环境?
AI 运行时提供两个托管Python环境:标准环境和 Databricks AI 环境。
| 环境 | 主要特征 | 何时使用 |
|---|---|---|
| 标准环境 | 极简;包括 cuda。 从 环境版本 5 起, torchtorchvision 不再预安装。 |
你希望完全控制依赖项堆栈,并且希望仅安装所需的内容 |
| Databricks AI 环境 | 预加载了常用的 ML 框架(PyTorch、转换器等) | 你需要一个完整的环境来训练、微调和试验,而无需手动依赖项管理 |
你还可以使用工作区管理员为 AI Runtime 构建的工作区基础环境。 请参阅 构建无服务器 GPU 计算(AI 运行时)。
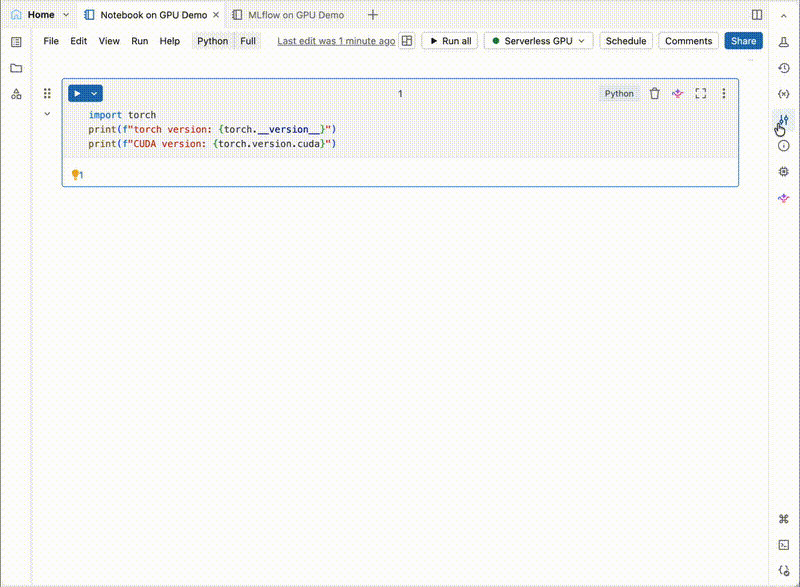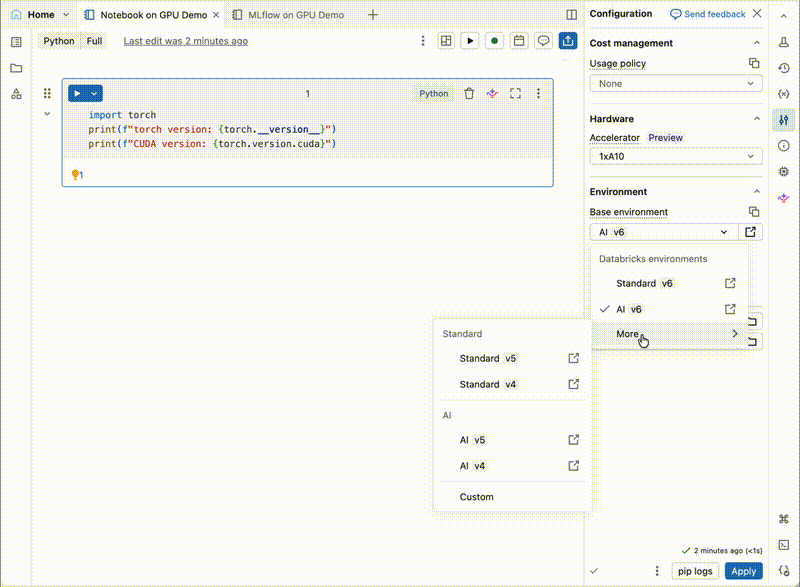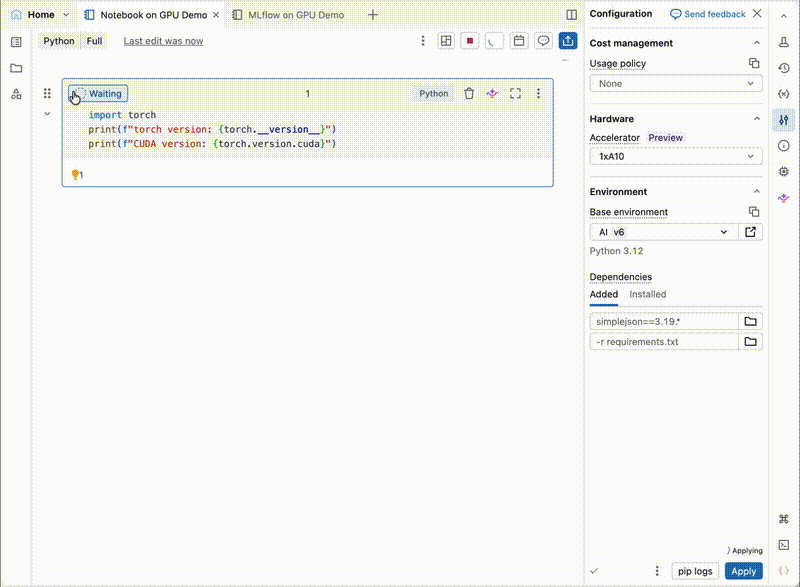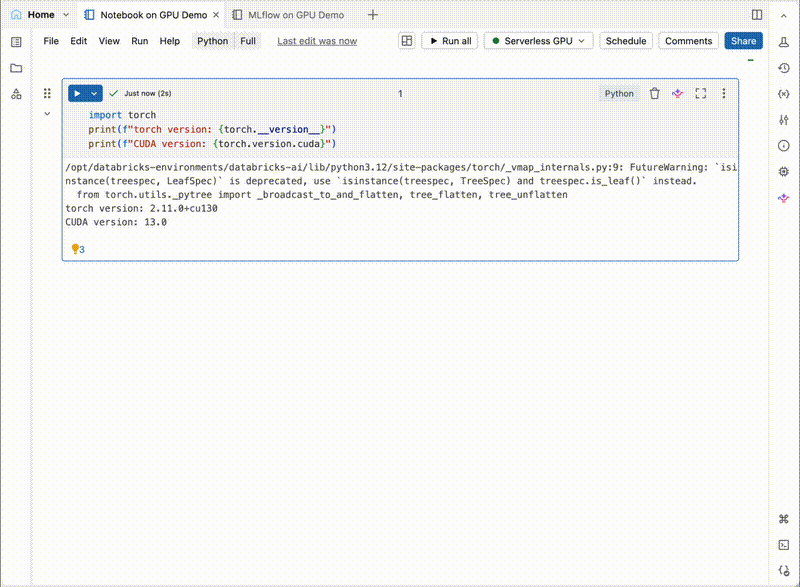
要在笔记本中选择环境,打开 环境 侧面板并选择 一个基础环境:
标准环境(最小环境)
包含仅供 AI 运行时操作所需的包的最小化稳定环境。 环境包含用于支持 GPU 的 cuda。 从环境版本 5 起, torchtorchvision 不再预安装。 使用 %pip install 或 %uv pip install 安装工作负载所需的版本。 有关每个环境版本中安装的包,请参阅以下发行说明。
最适合:希望完全控制其依赖项堆栈的用户,并且希望仅安装所需的内容。
选择方式:在 环境 侧面板中,选择 标准v6 作为基础环境。
有关不同版本中安装的包版本的更多详细信息,请参阅发行说明:
Databricks AI 环境
在环境 4 及更高版本中可用。 AI 环境基于标准环境构建,其中包含特定于 GPU 上的机器学习的常见运行时包和包。 预安装的包包括:
- PyTorch (支持 CUDA)
- Transformer(Hugging Face)
- 以及其他 ML/DL 依赖项
最适合:希望在不需要手动管理依赖项的情况下进行训练、微调和实验的 ML 从业者的完整环境。
选择方式:在 环境 侧面板,选择 AI v6 作为你的基础环境。
有关不同版本中安装的包版本的更多详细信息,请参阅发行说明:
安装额外的软件包
你可以从托管环境或工作空间基础环境开始,然后在其上安装自己的 Python 包。 你如何安装它们取决于你如何连接 AI 运行时。
在笔记本电脑上
使用 %uv pip 在笔记本或训练脚本的顶部安装包;它使用 uv 进行安装,并且比 %pip更快。 固定版本,以确保运行可复现:
%uv pip install "trl==1.1.0"
%uv pip install "transformers==5.5.4"
有关完整的 %uv 和 参考信息(包括各环境版本分别支持哪些内容),请参阅 %pip。
当你用 @distributed 装饰器处理多GPU工作负载时,调用前 .distributed() 安装的包会自动快照并传播到所有分布式进程。 已安装包的总大小不得超过 15 GB。 有关详细信息,请参阅 向笔记本添加依赖项。
使用命令行界面(CLI)时
air CLI使用相同的托管环境。 使用 environment.version 选择一个,然后在工作负载 YAML 的 environment.dependencies 下列出要在其基础上安装的软件包。 CLI会用 UV将它们安装到选定的环境中,这样你就不用自己管理一个独立的虚拟环境:
environment:
  version: '6'
  dependencies:
    - trl==1.1.0
    - transformers==5.5.4
如果要改为从 Databricks AI 环境启动,请将 version 设置为 AI 环境标识符,例如 databricks_ai_v5。 关于完整的依赖格式、支持的安装标志和自定义 Docker 镜像支持,请参见 environment。
工作区基础环境
工作区管理员可以为无服务器 GPU 计算生成 工作区基础环境 ,该环境可通过 “基本环境 ”下拉菜单向工作区中的所有用户提供。 有关详细信息,请参阅构建无服务器 GPU 计算 (AI 运行时)。
要在计划工作负载中使用基础环境,请在作业或捆绑包的 environments 块中通过其标识符引用该环境。 例如,这个声明式自动化捆绑包任务选择了Databricks的AI环境:
resources:
  jobs:
    train:
      tasks:
        - task_key: train
          environment_key: default
      environments:
        - environment_key: default
          spec:
            base_environment: databricks_ai_v6
有关完整的作业示例,请参阅使用 Jobs API 和声明式自动化包进行计划。
环境缓存和自定义模块
何时缓存环境?
AI 运行时会缓存笔记本的环境,所以当你重新打开笔记本时,不需要重新安装包。 详情请参见 “重置环境依赖”。
缓存适用于交互式笔记本。 通过 air CLI 运行或作为作业调度的工作负载不使用该缓存;每次运行都会全新安装其依赖。
作为最佳实践,将包钉到特定版本,这样缓存环境保持有效,运行过程也能保持可复现性。
如何导入自定义模块?
以下步骤展示了如何使用您自己的 Python 模块。
- 把你的代码同步到工作区。 可以将Git仓库克隆到带有 Git文件夹的工作区,或者直接上传文件作为 工作区文件。 团队项目可以把共享代码存到
/Workspace/Shared下面,个人发展时则放在用户文件夹里。 把代码放在Git文件夹里可以保持版本控制。 -
将该文件夹添加到
sys.path中,并在笔记本或训练脚本的开头导入它:
import sys
sys.path.append("/Workspace/Shared/my-project/src")
from my_module import my_function
局限性
AI 运行时不提供以下功能:
- Spark 函数:不能直接导入或使用 PySpark 函数。 AI 运行时是仅限 Python 的环境;Spark 不可用作本地运行时。 但是,Spark Connect 可用于数据加载。 请参阅 在 AI 运行时上加载数据。
- Databricks Runtime ML 库:预安装的包不是 Databricks Runtime ML 的替代项。 Databricks Runtime ML 中提供的某些 ML 库可能不会在 AI 运行时上预安装。
- 专用项目:在某些情况下,AI 运行时支持专用项目。 有关详细信息,请联系你的帐户团队。