Important
此功能在 Beta 版中。 若要使用此功能,工作区管理员必须在 预览 页面启用 高效列更新。 请参阅 Manage Azure Databricks 预览版。
高效列更新(ECU)可让您在 Delta Lake 表中添加列并回填其值,而无需重写未发生更改的列。 使用它来填充现有数据集中的新特征、嵌入和其他派生值。
添加列会更改表结构,而无需重写现有数据。 为该列填充值可能需要重写包含受影响行的数据文件,包括未更改的列。 Efficient Column Updates 通过将更新后的列值写入单独的 Parquet 文件,避免了对这些未更改列的重写。
当您向包含大型负载或嵌入的表中添加少量列时,这尤其有用。 查询继续返回一个逻辑表,将现有数据与更新后的列值结合起来。
下图对比了添加和回填列的过程。 灰色块表示现有列数据,绿色块表示新列数据,红色轮廓表示已重写的数据。
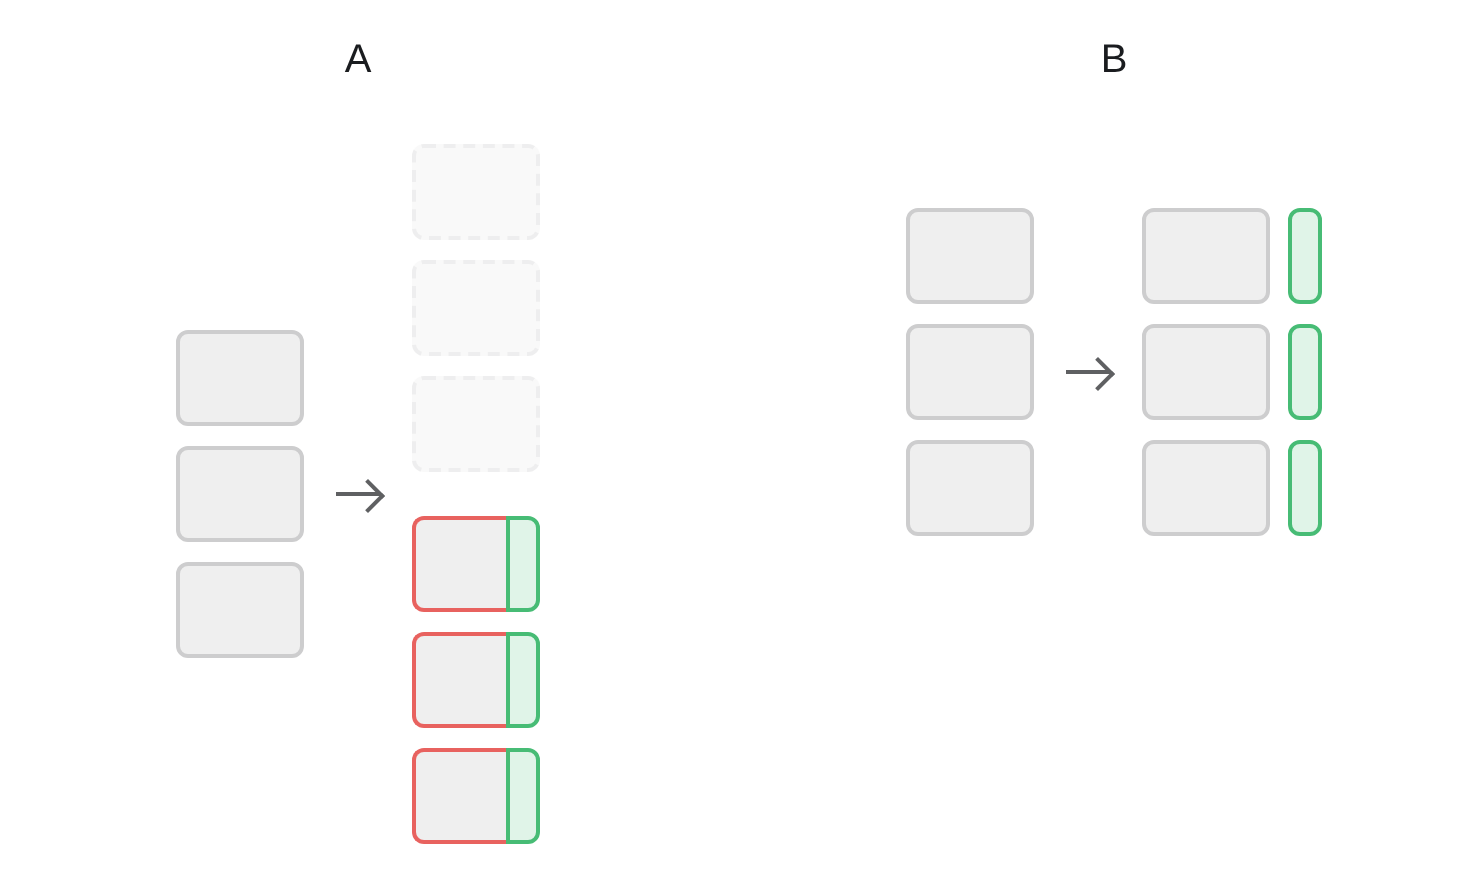
- 答:在没有 ECU 的情况下,回填会用包含未更改列和新列的文件替换原始数据文件(虚线轮廓)。
- B:使用 ECU 时,会保留原始文件,新的列值会写入单独的文件中。
Requirements
- 使用 Databricks 运行时 19 或更高版本,在启用高效列更新的情况下读写表。
- 使用启用 目录提交 的 Unity Catalog 管理的 Delta Lake 表。
- 在表上启用 行跟踪 和 删除向量。
- 在模式(
'delta.columnMapping.mode' = 'id')下使用id。 此模式必须在创建表时设置。 - 在工作区预览页面启用 Beta 版。
启用高效的列更新
当你创建表时,或在满足要求的现有表上,可以启用“高效列更新”。 在启用之前请先查看限制。
要创建启用高效列更新的表,请将 delta.enableColumnUpdates-preview 表属性与所需功能的属性一起设置:
CREATE TABLE documents (
  document_id BIGINT,
  description STRING
)
TBLPROPERTIES (
  'delta.feature.catalogManaged' = 'supported',
  'delta.enableRowTracking' = 'true',
  'delta.enableDeletionVectors' = 'true',
  'delta.columnMapping.mode' = 'id',
  'delta.enableColumnUpdates-preview' = 'true'
);
对于已在模式下使用列映射 id 的现有表,如果尚未启用,请启用目录提交、行跟踪和删除矢量:
ALTER TABLE documents SET TBLPROPERTIES (
  'delta.feature.catalogManaged' = 'supported',
  'delta.enableRowTracking' = 'true',
  'delta.enableDeletionVectors' = 'true'
);
然后启用高效列更新:
ALTER TABLE documents SET TBLPROPERTIES (
  'delta.enableColumnUpdates-preview' = 'true'
);
如果遇到问题,可以回滚到标准更新。
添加并回填列
以下示例使用 documents 一个现有的表,包含一个 document_id 列和一个 description 字符串列。 它会添加一个列,包含每个描述的长度:
ALTER TABLE documents ADD COLUMN text_length INT;

UPDATE documents
SET text_length = LENGTH(description);
添加列后,现有行的 text_length 中会包含 NULL,直到 UPDATE 填充这些值。 高效列更新允许回填在不重写未更改列的情况下写入新的列值。
查询表以检查已填充的值:
SELECT document_id, description, text_length
FROM documents
LIMIT 10;
高效的列更新减少了回填期间重写的数据量。 更新仍会读取输入列并计算新的值。
启用高效列更新并不保证每次 UPDATE 都会使用该功能。 在某些情况下,Azure Databricks 会回退到标准更新,重写受影响的数据文件。 更新仍然成功,结果相同。
回滚到标准更新
如果您在使用高效列更新时遇到问题,请禁用新列更新并整合现有列文件:
停止写入新的列文件:
ALTER TABLE documents SET TBLPROPERTIES (
  'delta.enableColumnUpdates-preview' = 'false'
);
使用 REORG TABLE 重写包含列文件的数据文件:
REORG TABLE documents APPLY (PURGE);
REORG 将最新的列值写入重写的数据文件,创建一个不含列文件的新表版本。 更新后的数值将被保留。 早期的表格版本仍然可以引用列文件。
表功能在表协议中仍然启用,因此读写仍需要 Databricks 运行时 19 或更高版本。
Limitations
- 高效列更新与写入时变更数据馈送(CDF)不兼容。 参见 “旧版变更数据馈送”。
- 高效列更新与 通用格式(UniForm)不兼容。
- 不支持 Apache Iceberg 管理的表。
-
MERGE操作不使用高效列更新。 - 不支持使用
DROP FEATURE移除高效列更新。 Databricks 建议你避免在关键表上启用它。 要停止使用列更新,请参阅“ 回滚到标准更新”。 - 不支持湖流管道。