你当前正在访问 Microsoft Azure Global Edition 技术文档网站。 如果需要访问由世纪互联运营的 Microsoft Azure 中国技术文档网站,请访问 https://docs.azure.cn。
弹性处理(预览版)可为能够容忍较慢响应时间和偶发资源不可用的工作负载提供推理服务,与标准处理相比可享受 50% 的价格折扣。 通过将 service_tier 设置为 flex,为单个响应 API 或聊天补全 API 请求选择弹性处理。
将 Flex 处理用于非交互和低优先级的工作,例如模型评估、数据扩充、文档分析和异步应用程序工作流。 对于延迟敏感或容量敏感的工作负荷,请改用标准处理、优先级处理或预配的吞吐量。
Important
引入 Flex 处理后,仅当所选模型支持 Flex 处理时,才会处理设置为service_tierflex“的请求”。 不支持的模型返回 HTTP 400 invalid_request_error ,不会回退到标准处理。 弹性处理不提供延迟 SLA 或服务 SLA。
先决条件
一份 Azure 订阅。 免费创建一个。
Azure OpenAI 资源,其中包含使用全局标准部署类型部署的受支持模型。
资源终结点和 API 密钥或Microsoft Entra ID凭据。 本文中的示例使用存储在环境变量中的
AZURE_OPENAI_API_KEYAPI 密钥。可以容忍可变延迟和暂时性资源不可用响应的工作负荷。
Python 3.10 或更高版本以及适用于Python示例的 OpenAI Python 包:
pip install --upgrade openai
发送 Flex 请求
在每个应使用 Flex 处理的请求中,将 设置为 。 该值model是Azure模型部署的名称。
Python
以下示例使用响应 API 发送 Flex 请求:
import os

from openai import OpenAI

AZURE_OPENAI_ENDPOINT = "https://YOUR-RESOURCE-NAME.openai.azure.com"

# Create a client with a longer timeout for Flex requests.
openai = OpenAI(
    base_url=f"{AZURE_OPENAI_ENDPOINT}/openai/v1/",
    api_key=os.environ["AZURE_OPENAI_API_KEY"],
    timeout=900.0,
)

# Send a request for Flex processing.
response = openai.responses.create(
    model="YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    input="Analyze these records and summarize the recurring themes.",
    service_tier="flex",
)

print(response.output_text)
print(f"Processed by service tier: {response.service_tier}")
<generated-analysis>
Processed by service tier: flex
响应包含生成的分析和处理请求的服务层。
Reference:Responses API
REST
以下示例将相同的请求直接发送到响应 API:
curl -X POST https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/responses \
  -H "Content-Type: application/json" \
  -H "api-key: $AZURE_OPENAI_API_KEY" \
  -d '{
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
    "service_tier": "flex"
  }'
{
    "service_tier": "flex",
    "status": "completed",
    "output": [<response-output>]
}
若要验证哪个层处理请求,请在成功的响应中检查 service_tier 字段。
选择处理选项
弹性、标准和优先级处理是联机 API 请求的服务层选择。 批处理和预配吞吐量是单独的部署和购买选项。
| 选项 | 如何选择它 | 延迟和可用性 | 成本模型 | 最适用于 |
|---|---|---|---|---|
| 弹性处理 | 将请求级别 service_tier 设置为 flex. |
可变延迟。 当 Flex 容量不可用时,请求可以返回 HTTP 429。 | 与标准令牌费率相比,50% 折扣。 缓存令牌折扣也适用。 | 评估、增强、离线分析以及可容忍延迟的后台工作。 |
| 标准处理 | 将请求级别 service_tier 设置为 default,或使用为部署配置的标准层。 |
适用于通用工作负载的尽力而为型在线处理。 | 标准按令牌付费率。 | 具有可变流量的开发、测试和生产工作负荷。 |
| 优先级处理 | 在部署上配置优先级,或将请求级别 service_tier 设置为 priority。 |
更低且更一致的延迟,并为受支持的模型设定了明确目标。 | 按词元付费价格优先级。 | 无预留容量承诺的延迟敏感联机应用程序。 |
| 批处理 | 将异步批处理作业提交到批处理部署。 | 结果目标是在 24 小时内完成。 没有实时延迟目标。 | 优惠批量费率。 | 不需要立即响应的大型离线作业。 |
| 预配的吞吐量 | 创建预配的部署并购买或预留预配的吞吐量单位(PTU)。 | 具有可预测的吞吐量和延迟的预留容量。 | 按小时 PTU 计费或 Azure 预留。 | 高吞吐量、关键任务型生产工作负载。 |
如果满足以下所有条件,请选择 Flex 处理:
- 工作负荷可以容忍更长和可变的处理时间。
- 相比可预测的延迟,您更看重较低的成本。
- 应用程序可以重试暂时性故障,或将失败的请求路由到标准处理。
- 支持所选的模型和请求上下文。
如果满足以下任一条件,请不要使用 Flex 处理:
- 用户正在等待交互式响应。
- 请求必须在严格的延迟目标内完成。
- 应用程序不能容忍或重试暂时性 HTTP 429 响应。
- 需要保留的处理容量或可预测的吞吐量。
灵活处理具有以下特点:
-
请求级别选择:对于每个应使用 Flex 处理的请求,将
service_tier设置为flex。 - 没有单独的部署: 将标准和 Flex 请求发送到同一全局标准部署,并为每个请求选择层。
- 支持的 API: 使用响应 API 或聊天完成 API。
- 同步响应: 即使工作负荷可能需要更长的时间才能完成,API 调用仍保持同步。 弹性处理与批处理 API 不同。
- 依赖于容量的可用性: 当 Flex 容量不可用时,请求可以返回 HTTP 429。
-
无自动回退到 Standard:如果可以接受标准处理,您的应用程序必须显式重试,并将
service_tier设为default。 - 共享配额: Flex 和 Standard 请求使用分配给 Global Standard 部署的配额。
- 相同的模型输出质量: Flex 使用与标准相同的基础模型。 处理层会更改延迟、可用性和价格,而不是模型质量。
注释
与相应的标准令牌费率相比,弹性输入和输出令牌会收到 50% 折扣。 符合条件的缓存输入令牌还会收到适用的缓存令牌折扣。 有关当前费率,请参阅 Azure OpenAI 定价。
查看支持的模型
弹性处理在启动时具有有限的模型可用性。
gpt-5.6-sol 是第一个受支持的模型。 下表列出了支持的模型。 微软会在支持可用后添加更多模型。
| Model | Version | 部署类型 | 区域可用性 |
|---|---|---|---|
gpt-6.1-sol |
2026-09-29 |
全球标准 | Global Standard 可用的所有 Azure 区域 |
gpt-6-sol |
2026-09-22 |
全球标准 | Global Standard 可用的所有 Azure 区域 |
gpt-6-luna |
2026-09-22 |
全球标准 | Global Standard 可用的所有 Azure 区域 |
gpt-6-astra |
2026-09-03 |
全球标准 | Global Standard 可用的所有 Azure 区域 |
gpt-5.6-sol |
2026-07-09 |
全球标准 | Global Standard 可用的所有 Azure 区域 |
gpt-5.6-luna |
2026-07-09 |
全球标准 | Global Standard 可用的所有 Azure 区域 |
gpt-5.6-terra |
2026-07-09 |
全球标准 | Global Standard 可用的所有 Azure 区域 |
在发送 Flex 请求之前检查此表。 不要假定模型或新模型版本支持 Flex 处理,因为它支持标准或优先级处理。 不支持的模型返回 HTTP 400。 为避免应用程序中断,当标准定价和性能可以接受时,请在应用程序级别实现回退到标准处理。
回退到标准处理
Flex 处理在 Flex 容量不可用时,不会自动将请求路由到标准处理。 如果完成该请求比保留 Flex 定价更重要,请将 设置为 后重试该请求。
以下示例使用完成优先策略。 它会先尝试 Flex 处理;如果收到任何 HTTP 429 响应,则改为使用标准处理重试一次:
import os

from openai import OpenAI, RateLimitError

AZURE_OPENAI_ENDPOINT = "https://YOUR-RESOURCE-NAME.openai.azure.com"

# Create a client with a longer timeout for Flex requests.
openai = OpenAI(
    base_url=f"{AZURE_OPENAI_ENDPOINT}/openai/v1/",
    api_key=os.environ["AZURE_OPENAI_API_KEY"],
    timeout=900.0,
)

request = {
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
}

# Try Flex processing, and fall back to Standard after an HTTP 429 response.
try:
    response = openai.responses.create(**request, service_tier="flex")
except RateLimitError:
    response = openai.responses.create(**request, service_tier="default")

print(response.output_text)
print(f"Processed by service tier: {response.service_tier}")
<generated-analysis>
Processed by service tier: <flex-or-default>
回退到“标准”会改变该请求的定价和性能特征。 仅当工作负荷可以接受标准定价时,才使用此模式。
HTTP 429 响应可以指示不可用的 Flex 容量或配额限制。 由于 Flex 和 Standard 处理共享配额,因此当配额导致原始响应时,标准请求也可能失败。 应用重试限制,并在应用程序中处理第二个 RateLimitError。 当服务返回 Flex 专用的错误标识符时,使用它将回退限定为仅针对容量相关的响应。
对于优先考虑最低成本的工作负载,请先采用指数退避方式重试 Flex 处理,然后再回退到其他处理方式。 对于优先考虑完成时间的工作负载,在首次出现 Flex 容量错误后,回退到 Standard。
参考: RateLimitError
处理 Flex 错误
将永久请求错误与暂时性容量错误区分开来。
| HTTP 状态 | Error | 原因 | 建议的处理 |
|---|---|---|---|
| 400 | invalid_request_error |
所选模型、模型版本、上下文长度、API 或请求配置不支持 Flex 处理。 | 不要在不做任何更改的情况下重试同一请求。 选择受支持的模型或上下文长度,或明确将 service_tier 设置为 default 后重试。 |
| 408 | 请求超时 | 请求未在配置的客户端或服务超时内完成。 弹性请求所需的时间可能比标准请求长。 | 使用更长的客户端超时时间。 采用有界指数退避进行重试。 如果完成时间比 Flex 定价更重要,请使用 Standard 重试。 |
| 429 | 资源不可用或速率受限 | 弹性容量暂时不可用,或者请求超出了适用的速率限制。 灵活容量可被抢占,因此在高峰时段更有可能暂时不可用。 | 如果请求超出速率限制,请通过分配更多配额来增加全局标准部署的速率限制。 Flex 和 Standard 共享此配额。 如果订阅没有足够的配额来容纳大型吞吐量工作负荷,请请求增加配额。 如果 Flex 容量暂时不可用,请采用带抖动的指数退避策略重试,将可容忍延迟的工作负载安排到工作日夜间或周末等非高峰时段,或者在将 设置为 的情况下重试。 如果存在,请保留 Retry-After。 |
| 500、502、503 或 504 | 暂时性服务错误 | 临时服务或网关问题阻止完成。 | 采用有界指数退避进行重试。 不要发送无限数量的重试。 |
| 401 或 403 | 身份验证或授权错误 | 凭据缺失、无效、已过期或无权访问资源。 | 修正凭据或角色分配。 在配置更改之前不要重试。 |
| 404 | 未找到部署 | 部署名称或终结点不正确。 | 验证 model 是否与部署名称匹配,并确认基本 URL 是否指向正确的 Azure OpenAI 资源。 |
注释
因处理能力不可用而被拒绝的 Flex 请求不会被计费。 但是,你可能会注意到可用速率限制容量较少,因为 Flex 和 Standard 请求共享分配给全局标准部署的配额。
对于 HTTP 408、429 和临时性 5xx 响应,采用带随机抖动的指数退避策略。 设置最大重试计数和最大延迟,使失败的请求不会保留在未绑定的重试循环中。
- 当响应包含
Retry-After时,请保留它。 - 否则,请等待带有随机抖动的指数级递增延迟。
- 仅当延迟对该工作负载而言仍可接受时,才重试 Flex。
- 如果重试预算已用尽,并且应用程序允许更高的标准成本,请回退到标准版。
- 如果延迟的 Flex 处理和标准回退都不符合应用程序的要求,则返回显式失败。
不要重复重试相同的不受支持的 Flex 请求。 只有在更改模型、上下文长度、API 配置或服务层后,重试才会成功。
监视使用情况和成本
使用Azure Monitor指标来比较同一部署中的 Flex 和 Standard 流量。 监视请求量、令牌消耗、延迟、故障以及 Flex 请求在应用程序中回退到 Standard 的速率。
登录到 Azure 门户。
转到Azure OpenAI 资源,然后选择“指标”。
添加 Azure OpenAI 请求指标。 还可以添加 Azure OpenAI 延迟、Azure OpenAI 使用情况和错误指标。
添加 ServiceTierRequest 等于
flex的筛选器。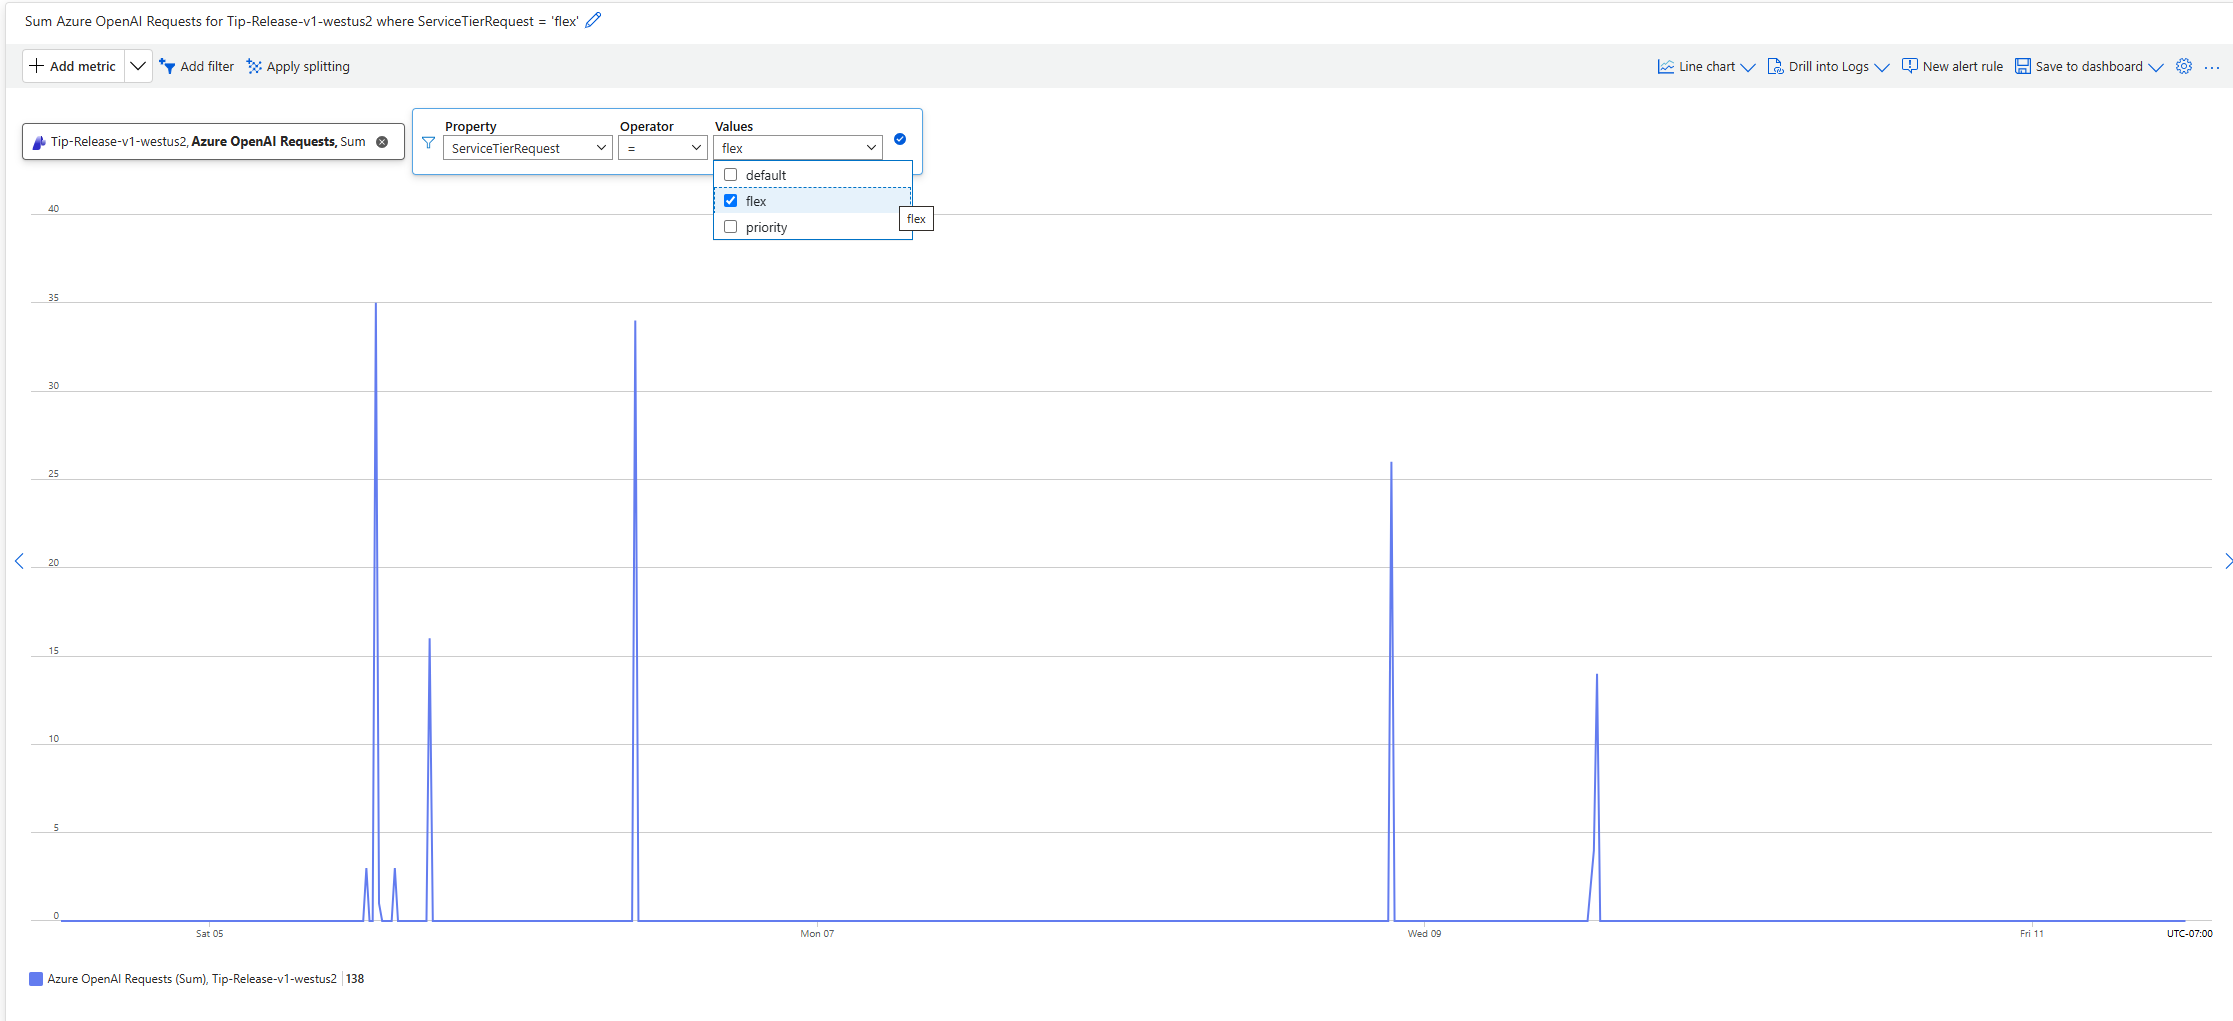
为持续出现的 HTTP 429 响应、错误率上升以及超出工作负载重试预算的延迟创建警报。
跟踪每个工作负荷的以下信号:
| 信号 | 它为何重要 |
|---|---|
| Flex 请求数 | 显示采用情况以及为降低处理成本而路由的流量。 |
| Flex 请求成功率 | 显示 Flex 容量接受和完成请求的频率。 |
| HTTP 429 速率 | 显示弹性容量或部署配额受限时的时间段。 |
| 标准回退次数和比率 | 显示应用程序控制的回退机制带来的可靠性优势和额外成本。 |
| 输入令牌、缓存输入令牌和输出令牌 | 支持成本归因并验证提示缓存的效果。 |
| 端到端延迟 | 帮助确定工作负荷是否仍适合 Flex。 |
HTTP 400 invalid_request_error 计数 |
标识不支持的模型、模型版本、上下文长度或请求配置。 |
有关监视模型部署的详细信息,请参阅 Monitor Azure OpenAI。
弹性使用量按专用弹性计量计费,以便你可以将其与标准使用量区分开来。 使用“成本分析”按资源和部署情况查看 Flex 令牌成本。
- 在Azure门户中,打开成本管理 + 计费>成本分析。
- 将筛选范围缩小到包含该部署的订阅、资源组或 Azure OpenAI 资源。
- 按 计量 分组或筛选,将弹性使用情况与标准使用情况分开。
- 添加计费 标签 筛选器,选择 部署,然后选择部署名称。
- 将 Flex 的成本节省与 Standard 回退成本以及工作负载的完成要求进行比较。
弹性输入和输出令牌的定价为相应的标准费率的 50%。 提示缓存可进一步降低符合缓存条件的输入 Token 成本。 因处理能力不可用而被拒绝的 Flex 请求不会被计费。
应用生产最佳做法
- 设置更长的超时时间。 弹性请求所需的时间可能比标准请求长。 从适用于工作负荷的客户端超时开始,例如 15 分钟,并使用具有代表性的提示进行测试。
- 使用有限重试。 限制重试尝试次数和总运行时间。
- 添加抖动。 将回退延迟随机化,以避免同步重试峰值。
- 明确回退。 将
default设置为service_tier,而不是依赖隐式行为。 - 跟踪处理的层级。 使用延迟、状态、令牌使用情况和成本数据记录响应
service_tier值。 - 分隔交互式流量和后台流量。 除非可以接受可变弹性延迟,否则,请将面向用户的请求保留在标准、优先级或预配吞吐量层级上。
- 控制重复工作。 确保在客户端超时后,应用程序不会多次提交相同的逻辑作业。
- 测试失败路径。 在生产工作流中使用 Flex 处理之前,验证 HTTP 400、408、429 和暂时性 5xx 响应的处理。
- 在升级之前查看模型支持。 替换模型或模型版本不会自动继承 Flex 支持。
使用请求标头替代服务层
x-ms-service-tier当网关、代理或集中式路由层需要选择服务层而不检查或修改请求正文时,请使用请求标头。 标头还可以减少已通过请求标头选择 OpenAI 服务层级的应用程序的迁移更改。
标头接受以下值:
| 标头值 | 请求的处理层 |
|---|---|
flex |
Flex |
priority |
优先级 |
default |
标准 |
auto |
优先级 |
当标头存在且有效时,它优先于 service_tier 请求正文中的值。
| 标头输入 | 请求正文输入 | 行为和输出 |
|---|---|---|
| 省略标头 | 有效service_tier值 |
请求正文会选择层级。 成功响应会在 service_tier 中标明已处理的层级。 |
| 有效的标头值 | 任意值或留空 | 该标头选择所请求的层级。 成功响应会在 service_tier 中标明已处理的层级。 |
| 不支持的标头值 | 任意值或留空 | 请求返回 HTTP 400。 该服务不会回退到请求正文值。 |
此示例通过标头请求 Flex 处理。 标头会覆盖请求正文中 default 的值:
curl -X POST https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/responses \
  -H "Content-Type: application/json" \
  -H "api-key: $AZURE_OPENAI_API_KEY" \
  -H "x-ms-service-tier: flex" \
  -d '{
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
    "service_tier": "default"
  }'
{
    "service_tier": "flex",
    "status": "completed",
    "output": [<response-output>]
}
覆盖标头不提供自动回退机制。 无效的标头值或所选部署不支持的层级会返回 HTTP 400。