了解如何在 ML.NET 中使用预先训练的 ONNX 模型来检测图像中的对象。
从头开始训练对象检测模型需要设置数百万个参数、大量的标记训练数据和大量的计算资源(数百个 GPU 小时)。 使用预先训练的模型,可以快捷方式训练过程。
本教程中,您将学习如何:
- 了解问题
- 了解 ONNX 是什么以及它如何使用 ML.NET
- 了解模型
- 重复使用预先训练的模型
- 使用加载的模型检测对象
先决条件
- Visual Studio 2022 或更高版本。
- Microsoft.ML NuGet 包
- Microsoft.ML.ImageAnalytics NuGet 包
- Microsoft.ML.OnnxTransformer NuGet 包
- Tiny YOLOv2 预训练模型
- Netron (可选)
ONNX 对象检测示例概述
此示例创建一个 .NET Core 控制台应用程序,该应用程序使用预先训练的深度学习 ONNX 模型检测图像中的对象。 可以在 GitHub 上的 dotnet/machinelearning-samples 存储库 中找到此示例的代码。
什么是对象检测?
对象检测是计算机视觉问题。 虽然与图像分类密切相关,但对象检测以更精细的规模执行图像分类。 对象检测同时定位图像中的实体 并 对实体进行分类。 对象检测模型通常使用深度学习和神经网络进行训练。 有关详细信息,请参阅 深度学习与机器学习 。
当图像包含不同类型的多个对象时,请使用对象检测。
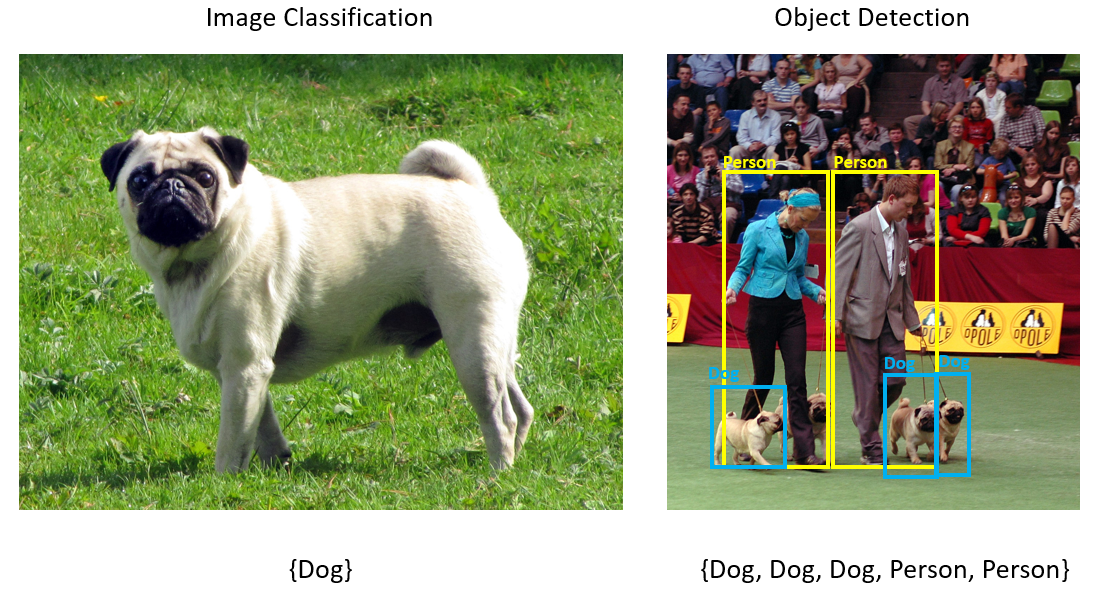
对象检测的一些用例包括:
- 自动驾驶汽车
- 机器人
- 人脸检测
- 工作区安全
- 对象计数
- 活动识别
选择深度学习模型
深度学习是机器学习的一部分。 若要训练深度学习模型,需要大量数据。 数据中的模式由一系列层表示。 数据中的关系编码为包含权重的层之间的连接。 权重越高,关系就越强。 这一系列层和连接统称为人工神经网络。 网络中的层越多,它的“深度”就越深,使其成为深度神经网络。
有不同类型的神经网络,最常见的是多层感知器(MLP)、卷积神经网络(CNN)和循环神经网络(RNN)。 最基本的是 MLP,它将一组输入映射到一组输出。 当数据没有空间或时间组件时,此神经网络是很好的。 CNN 利用卷积层来处理数据中包含的空间信息。 CNN 的一个很好的用例是图像处理来检测图像区域中是否存在特征(例如,图像中心是否有鼻子?)。 最后,RNN 允许将状态或内存的持久性用作输入。 RNN 用于时序分析,其中事件的顺序排序和上下文非常重要。
了解模型
对象检测是图像处理任务。 因此,用于解决此问题的大多数深度学习模型都是 CNN。 本教程中使用的模型是 Tiny YOLOv2 模型,这是 Redmon 和 Farhadi 介绍的 YOLOv2 模型的更紧凑版本:“YOLO9000:更好、更快、更强”。 Tiny YOLOv2 在 Pascal VOC 数据集上训练,由 15 个层组成,可以预测 20 个不同的对象类。 由于 Tiny YOLOv2 是原始 YOLOv2 模型的精简版本,因此在速度和准确性之间进行权衡。 可以使用 Netron 等工具可视化构成模型的不同层。 检查模型将产生构成神经网络的所有层之间的连接的映射,其中每个层将包含层的名称以及相应输入/输出的维度。 用于描述模型的输入和输出的数据结构称为张量。 张量可以被视为一种在 N 维度中存储数据的容器。 对于 Tiny YOLOv2,输入层的名称是 image ,它需要维度 3 x 416 x 416的张量。 输出层的名称是 grid 并生成维度 125 x 13 x 13的输出张量。
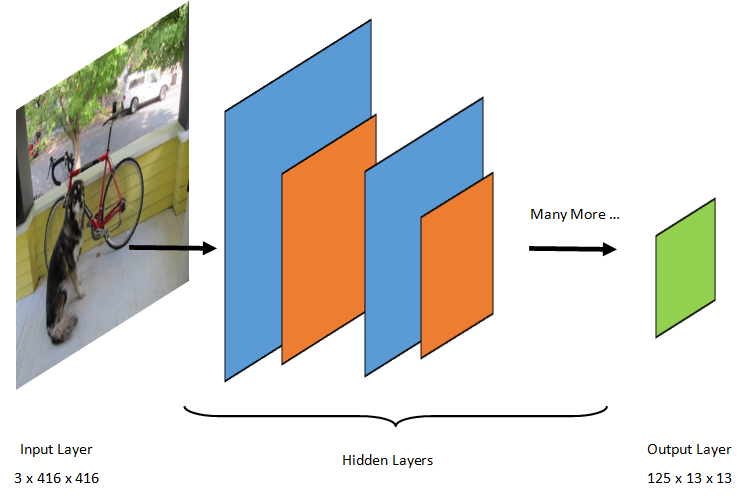
YOLO 模型采用图像 3(RGB) x 416px x 416px。 模型采用此输入,并通过不同的层传递以生成输出。 输出将输入图像划分为 13 x 13 网格,网格中的每个单元格由值组成 125 。
什么是 ONNX 模型?
开放神经网络交换(ONNX)是 AI 模型的开放源代码格式。 ONNX 支持框架之间的互作性。 这意味着可以在许多常用的机器学习框架之一(如 PyTorch)中训练模型,将其转换为 ONNX 格式,并在其他框架(如 ML.NET)中使用 ONNX 模型。 若要了解详细信息,请访问 ONNX 网站。
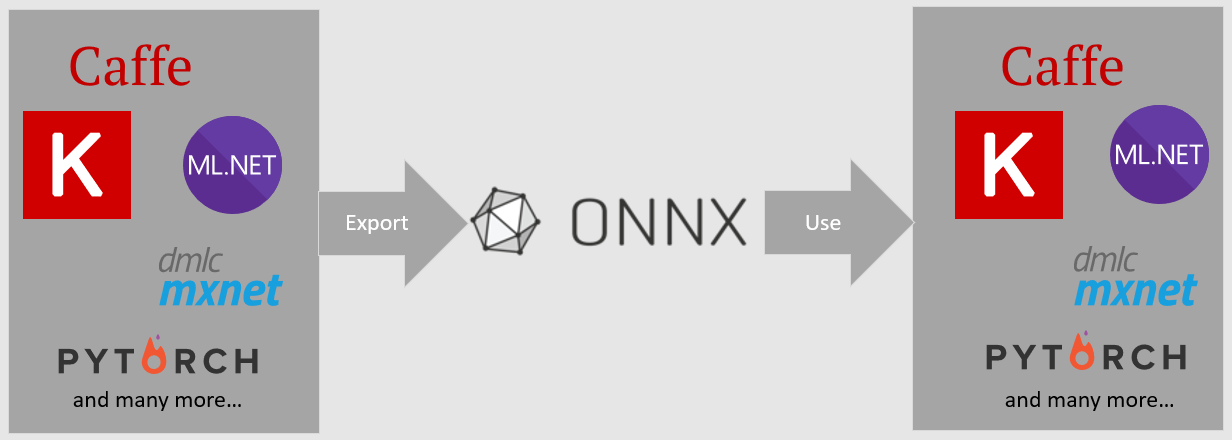
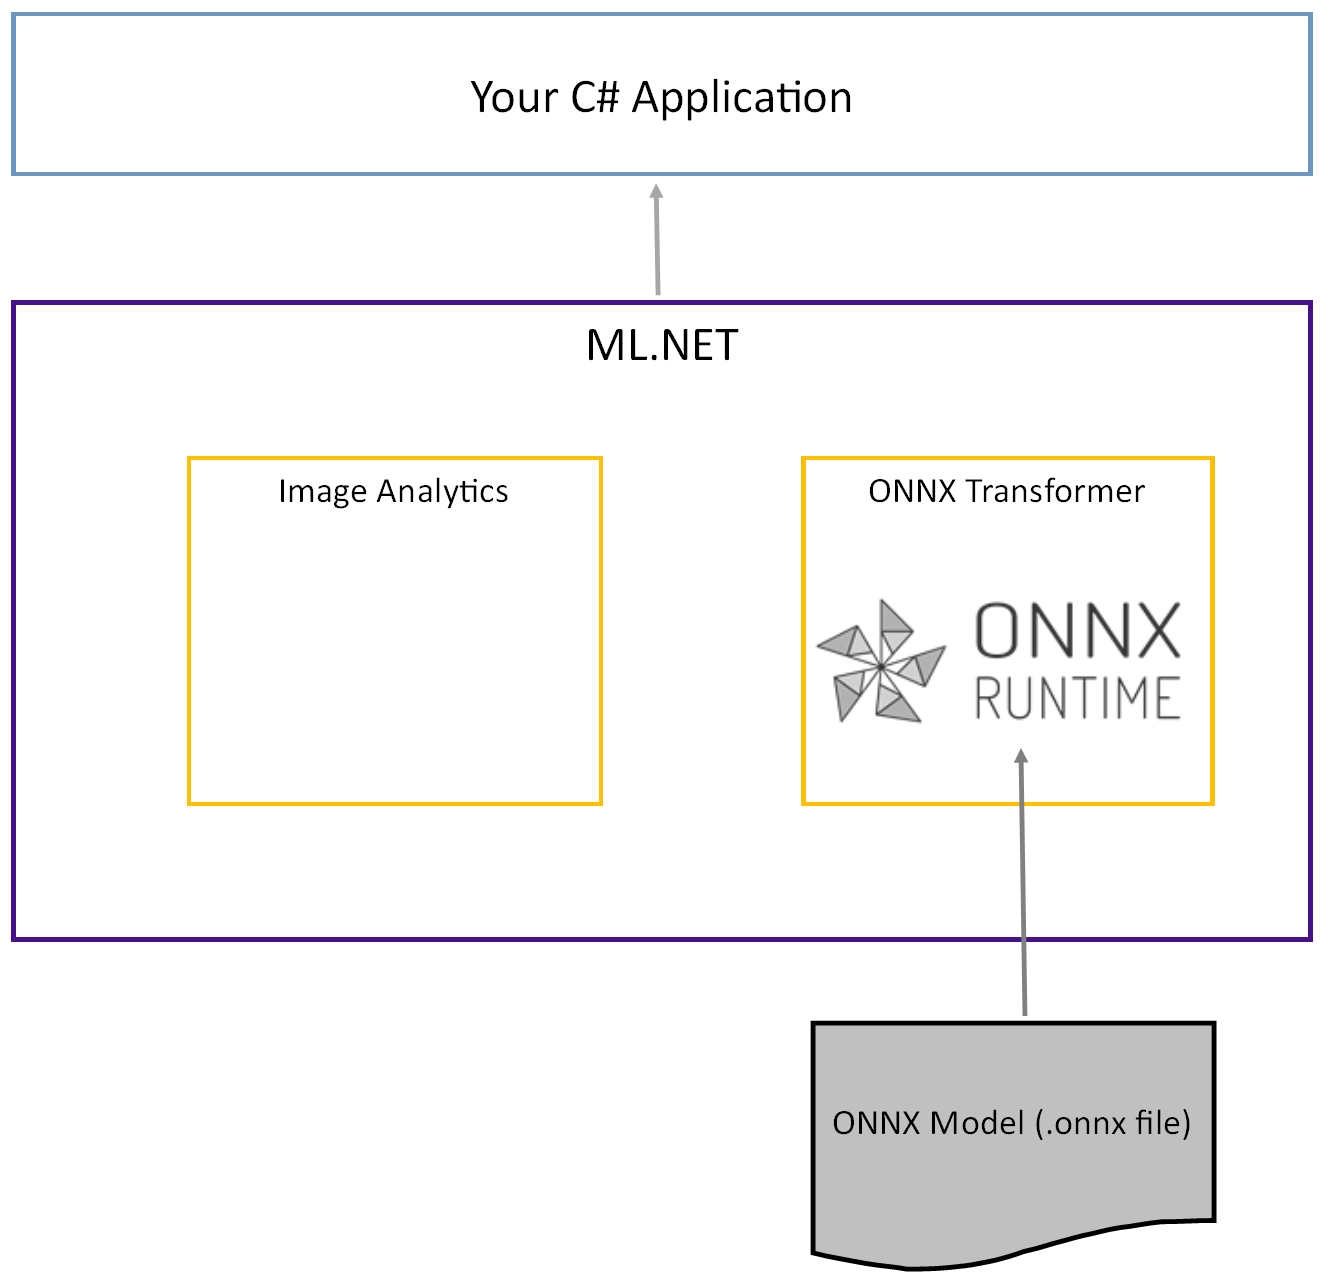
预训练的 Tiny YOLOv2 模型以 ONNX 格式存储,该格式是对模型层及其学习模式的序列化表示。 在 ML.NET 中,与 ONNX 的互操作性是通过 ImageAnalytics 和 OnnxTransformer NuGet 包实现的。 该 ImageAnalytics 包包含一系列转换,用于获取图像并将其编码为数值,这些数值可用作预测或训练管道的输入。 该 OnnxTransformer 包利用 ONNX 运行时加载 ONNX 模型,并使用它根据提供的输入进行预测。
设置 .NET 控制台项目
现在,你已大致了解 ONNX 是什么以及 Tiny YOLOv2 的工作原理,现在可以生成应用程序了。
创建控制台应用程序
创建名为“ObjectDetection”的 C# 控制台应用程序 。 单击“下一步”按钮。
选择 .NET 8 作为要使用的框架。 单击“创建” 按钮。
安装 Microsoft.ML NuGet 包:
注释
此示例使用提到的 NuGet 包的最新稳定版本,除非另有说明。
- 在解决方案资源管理器中,右键单击项目并选择“ 管理 NuGet 包”。
- 选择“nuget.org”作为包源,选择“浏览”选项卡,搜索 Microsoft.ML。
- 选择“ 安装 ”按钮。
- 选择“预览更改”对话框中的“确定”按钮,然后选择“许可接受”对话框中的“我接受”按钮(如果同意列出的程序包的许可条款)。
- 重复这些步骤用于 Microsoft.Windows.Compatibility、Microsoft.ML.ImageAnalytics、Microsoft.ML.OnnxTransformer 和 Microsoft.ML.OnnxRuntime。
准备数据和预先训练的模型
下载 项目资产目录 zip 文件 并解压缩。
将
assets目录复制到 ObjectDetection 项目目录中。 此目录及其子目录包含本教程所需的图像文件(除 Tiny YOLOv2 模型外,后者将在下一步中下载并添加)。从 ONNX 模型动物园下载 Tiny YOLOv2 模型。
将
model.onnx文件复制到 ObjectDetection 项目assets\Model目录中,并将其重命名为TinyYolo2_model.onnx。 此目录包含本教程所需的模型。在解决方案资源管理器中,右键单击资产目录和子目录中的每个文件,然后选择 “属性”。 在 高级 下,将 复制到输出目录 的值更改为 若较新则复制。
创建类并定义路径
打开 Program.cs 文件,并将以下附加 using 指令添加到文件顶部:
using System.Drawing;
using System.Drawing.Drawing2D;
using ObjectDetection.YoloParser;
using ObjectDetection.DataStructures;
using ObjectDetection;
using Microsoft.ML;
接下来,定义各种资产的路径。
首先,在
GetAbsolutePathProgram.cs文件的底部创建方法。string GetAbsolutePath(string relativePath) { FileInfo _dataRoot = new FileInfo(typeof(Program).Assembly.Location); string assemblyFolderPath = _dataRoot.Directory.FullName; string fullPath = Path.Combine(assemblyFolderPath, relativePath); return fullPath; }然后,在
using指令下方创建字段来存储资产的位置。var assetsRelativePath = @"../../../assets"; string assetsPath = GetAbsolutePath(assetsRelativePath); var modelFilePath = Path.Combine(assetsPath, "Model", "TinyYolo2_model.onnx"); var imagesFolder = Path.Combine(assetsPath, "images"); var outputFolder = Path.Combine(assetsPath, "images", "output");
向项目添加新目录以存储输入数据和预测类。
在 解决方案资源管理器中,右键单击项目,然后选择“ 添加新>文件夹”。 当新文件夹出现在解决方案资源管理器中时,将其命名为“DataStructures”。
在新建 的 DataStructures 目录中创建输入数据类。
在 解决方案资源管理器中,右键单击 DataStructures 目录,然后选择“ 添加新>项”。
在“ 添加新项 ”对话框中,选择“ 类 ”并将“ 名称 ”字段更改为 ImageNetData.cs。 然后选择“添加”。
ImageNetData.cs文件将在代码编辑器中打开。 将以下
using指令添加到 ImageNetData.cs顶部:using System.Collections.Generic; using System.IO; using System.Linq; using Microsoft.ML.Data;删除现有类定义,并将该
ImageNetData类的以下代码添加到 ImageNetData.cs 文件中:public class ImageNetData { [LoadColumn(0)] public string ImagePath; [LoadColumn(1)] public string Label; public static IEnumerable<ImageNetData> ReadFromFile(string imageFolder) { return Directory .GetFiles(imageFolder) .Where(filePath => Path.GetExtension(filePath) != ".md") .Select(filePath => new ImageNetData { ImagePath = filePath, Label = Path.GetFileName(filePath) }); } }ImageNetData是输入图像数据类,具有以下 String 字段:-
ImagePath包含存储映像的路径。 -
Label包含文件的名称。
此外,
ImageNetData还包含一种方法ReadFromFile,该方法加载存储在指定路径中的imageFolder多个图像文件,并将其作为对象集合ImageNetData返回。-
在 DataStructures 目录中创建预测类。
在 解决方案资源管理器中,右键单击 DataStructures 目录,然后选择“ 添加新>项”。
在“ 添加新项 ”对话框中,选择“ 类 ”并将“ 名称 ”字段更改为 ImageNetPrediction.cs。 然后选择“添加”。
ImageNetPrediction.cs文件将在代码编辑器中打开。 将以下
using指令添加到 ImageNetPrediction.cs顶部:using Microsoft.ML.Data;删除现有类定义,并将该
ImageNetPrediction类的以下代码添加到 ImageNetPrediction.cs 文件中:public class ImageNetPrediction { [ColumnName("grid")] public float[] PredictedLabels; }ImageNetPrediction是预测数据类,具有以下float[]字段:-
PredictedLabels包含图像中检测到的每个边界框的维度、对象性分数和类概率。
-
初始化变量
MLContext 类是所有 ML.NET作的起点,初始化mlContext会创建一个新的 ML.NET 环境,该环境可在模型创建工作流对象之间共享。 在概念上,它类似于 Entity Framework 中的DBContext。
mlContext通过在字段下方MLContext添加以下行,使用新实例outputFolder初始化变量。
MLContext mlContext = new MLContext();
创建分析器以处理后模型输出
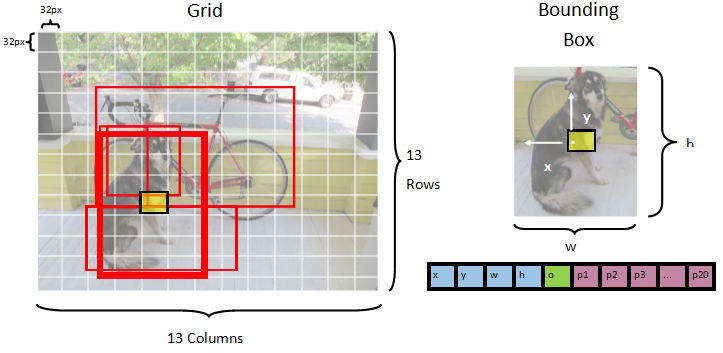
模型将图像细分为 13 x 13 网格,其中每个网格单元都是 32px x 32px。 每个网格单元包含 5 个潜在的对象边界框。 边界框包含 25 个元素:
-
x边界框中心的 x 位置相对于与之关联的网格单元格。 -
y边界框中心相对于其关联的网格单元格的 y 位置。 -
w边界框的宽度。 -
h边界框的高度。 -
o边界框中存在对象的置信度值,也称为对象性分数。 -
p1-p20模型预测的每个 20 个类的类概率。
总共有 25 个元素描述每个边界框,构成每个网格单元中包含的 125 个元素。
预训练的 ONNX 模型生成的输出是一个长度为 21125 的浮点数组,表示具有维度 125 x 13 x 13 的张量的元素。 若要将模型生成的预测转换为张量,需要执行一些后处理工作。 为此,请创建一组类来帮助分析输出。
向项目添加新目录以组织分析程序类集。
- 在 解决方案资源管理器中,右键单击项目,然后选择“ 添加新>文件夹”。 当新文件夹出现在解决方案资源管理器中时,将其命名为“YoloParser”。
创建边界框和尺寸
模型输出的数据包含图像中对象的边界框的坐标和尺寸。 为维度创建基类。
在 解决方案资源管理器中,右键单击 YoloParser 目录,然后选择“ 添加新>项”。
在“ 添加新项 ”对话框中,选择“ 类 ”并将“ 名称 ”字段更改为 DimensionsBase.cs。 然后选择“添加”。
DimensionsBase.cs文件将在代码编辑器中打开。 删除所有
using指令和现有类定义。将
DimensionsBase类的以下代码添加到 DimensionsBase.cs 文件:public class DimensionsBase { public float X { get; set; } public float Y { get; set; } public float Height { get; set; } public float Width { get; set; } }DimensionsBase具有以下float属性:-
X包含对象沿 x 轴的位置。 -
Y包含对象沿 y 轴的位置。 -
Height包含对象的高度。 -
Width包含对象的宽度。
-
接下来,为边界框创建一个类。
在 解决方案资源管理器中,右键单击 YoloParser 目录,然后选择“ 添加新>项”。
在“ 添加新项 ”对话框中,选择“ 类 ”并将“ 名称 ”字段更改为 YoloBoundingBox.cs。 然后选择“添加”。
YoloBoundingBox.cs文件将在代码编辑器中打开。 将以下
using指令添加到 YoloBoundingBox.cs顶部:using System.Drawing;就在现有类定义上方,添加一个新的类定义,名为
BoundingBoxDimensions,它继承自DimensionsBase类,以包含相应边界框的维度。public class BoundingBoxDimensions : DimensionsBase { }删除现有
YoloBoundingBox类定义,并将该YoloBoundingBox类的以下代码添加到 YoloBoundingBox.cs 文件中:public class YoloBoundingBox { public BoundingBoxDimensions Dimensions { get; set; } public string Label { get; set; } public float Confidence { get; set; } public RectangleF Rect { get { return new RectangleF(Dimensions.X, Dimensions.Y, Dimensions.Width, Dimensions.Height); } } public Color BoxColor { get; set; } }YoloBoundingBox具有以下属性:-
Dimensions包含边界框的尺寸。 -
Label包含边界框中检测到的对象类别。 -
Confidence包含类的置信度。 -
Rect包含边界框维度的矩形表示形式。 -
BoxColor包含与用于在图像上绘制的相应类关联的颜色。
-
创建分析程序
现在已创建维度和边界框的类,现在可以创建分析程序了。
在 解决方案资源管理器中,右键单击 YoloParser 目录,然后选择“ 添加新>项”。
在“ 添加新项 ”对话框中,选择“ 类 ”并将“ 名称 ”字段更改为 YoloOutputParser.cs。 然后选择“添加”。
YoloOutputParser.cs文件将在代码编辑器中打开。 将以下
using指令添加到 YoloOutputParser.cs顶部:using System; using System.Collections.Generic; using System.Drawing; using System.Linq;在现有
YoloOutputParser类定义中,添加一个嵌套类,其中包含图像中每个单元格的维度。 在CellDimensions类定义的顶部为继承自DimensionsBase类的YoloOutputParser类添加以下代码。class CellDimensions : DimensionsBase { }在类定义中
YoloOutputParser,添加以下常量和字段。public const int ROW_COUNT = 13; public const int COL_COUNT = 13; public const int CHANNEL_COUNT = 125; public const int BOXES_PER_CELL = 5; public const int BOX_INFO_FEATURE_COUNT = 5; public const int CLASS_COUNT = 20; public const float CELL_WIDTH = 32; public const float CELL_HEIGHT = 32; private int channelStride = ROW_COUNT * COL_COUNT;-
ROW_COUNT是图像划分为网格中的行数。 -
COL_COUNT是图像划分为网格中的列数。 -
CHANNEL_COUNT是网格的一个单元格中包含的值总数。 -
BOXES_PER_CELL是单元格中的包围框数量, -
BOX_INFO_FEATURE_COUNT是框中所包含的特征数(x,y,高度,宽度,置信度)。 -
CLASS_COUNT是每个边界框中所包含的类预测数。 -
CELL_WIDTH是图像网格中一个单元格的宽度。 -
CELL_HEIGHT是图像网格中一个单元格的高度。 -
channelStride是网格中当前单元格的起始位置。
当模型进行预测(也称为评分)时,它会将输入图像划分为单元格大小为
416px x 416px的13 x 13网格。 每个单元格都包含 。32px x 32px在每个单元格中,有 5 个边界框,每个框包含 5 个特征(x、y、宽度、高度、置信度)。 此外,每个边界框都包含每个类的概率,在本例中为 20。 因此,每个单元格包含 125 条信息(5 个特征 + 20 个类概率)。-
为所有 5 个边界框在channelStride下创建锚点列表:
private float[] anchors = new float[]
{
    1.08F, 1.19F, 3.42F, 4.41F, 6.63F, 11.38F, 9.42F, 5.11F, 16.62F, 10.52F
};
定位点是边界框的预定义高度和宽度比率。 模型检测到的大多数对象或类具有类似的比率。 在涉及到创建边界框时,这一点非常有价值。 不预测边界框,而是计算相对于预定义尺寸的偏移量,从而减少预测边界框所需的计算量。 通常,这些定位点比率是根据所使用的数据集计算的。 在这种情况下,由于数据集已知且已预计算值,因此可以硬编码定位点。
接下来,定义模型将预测的标签或类。 此模型预测 20 个类,这是原始 YOLOv2 模型预测的类总数的子集。
在anchors的下方添加你的标签列表。
private string[] labels = new string[]
{
    "aeroplane", "bicycle", "bird", "boat", "bottle",
    "bus", "car", "cat", "chair", "cow",
    "diningtable", "dog", "horse", "motorbike", "person",
    "pottedplant", "sheep", "sofa", "train", "tvmonitor"
};
每个类都有关联的颜色。 在以下位置 labels分配类颜色:
private static Color[] classColors = new Color[]
{
    Color.Khaki,
    Color.Fuchsia,
    Color.Silver,
    Color.RoyalBlue,
    Color.Green,
    Color.DarkOrange,
    Color.Purple,
    Color.Gold,
    Color.Red,
    Color.Aquamarine,
    Color.Lime,
    Color.AliceBlue,
    Color.Sienna,
    Color.Orchid,
    Color.Tan,
    Color.LightPink,
    Color.Yellow,
    Color.HotPink,
    Color.OliveDrab,
    Color.SandyBrown,
    Color.DarkTurquoise
};
创建帮助程序函数
后续处理阶段涉及一系列步骤。 为此,可以使用多种辅助方法。
分析器使用的帮助程序方法包括:
-
Sigmoid应用输出介于 0 和 1 之间的数字的 sigmoid 函数。 -
Softmax将输入向量规范化为概率分布。 -
GetOffset将一维模型输出中的元素映射到张量中的125 x 13 x 13相应位置。 -
ExtractBoundingBoxes使用GetOffset模型输出中的方法提取边界框维度。 -
GetConfidence提取置信度值,该值指示模型检测到对象的方式,并使用Sigmoid函数将其转换为百分比。 -
MapBoundingBoxToCell使用边界框的尺寸,将其映射到图像中的相应单元格。 -
ExtractClasses使用GetOffset该方法从模型输出中提取边界框的类预测,并使用该方法将其转换为概率分布Softmax。 -
GetTopResult从概率最高的预测类列表中选择类。 -
IntersectionOverUnion筛选概率较低的重叠边界框。
在列表 classColors下方为所有帮助程序方法添加代码。
private float Sigmoid(float value)
{
    var k = (float)Math.Exp(value);
    return k / (1.0f + k);
}

private float[] Softmax(float[] values)
{
    var maxVal = values.Max();
    var exp = values.Select(v => Math.Exp(v - maxVal));
    var sumExp = exp.Sum();

    return exp.Select(v => (float)(v / sumExp)).ToArray();
}

private int GetOffset(int x, int y, int channel)
{
    // YOLO outputs a tensor that has a shape of 125x13x13, which
    // WinML flattens into a 1D array.  To access a specific channel
    // for a given (x,y) cell position, we need to calculate an offset
    // into the array
    return (channel * this.channelStride) + (y * COL_COUNT) + x;
}

private BoundingBoxDimensions ExtractBoundingBoxDimensions(float[] modelOutput, int x, int y, int channel)
{
    return new BoundingBoxDimensions
    {
        X = modelOutput[GetOffset(x, y, channel)],
        Y = modelOutput[GetOffset(x, y, channel + 1)],
        Width = modelOutput[GetOffset(x, y, channel + 2)],
        Height = modelOutput[GetOffset(x, y, channel + 3)]
    };
}

private float GetConfidence(float[] modelOutput, int x, int y, int channel)
{
    return Sigmoid(modelOutput[GetOffset(x, y, channel + 4)]);
}

private CellDimensions MapBoundingBoxToCell(int x, int y, int box, BoundingBoxDimensions boxDimensions)
{
    return new CellDimensions
    {
        X = ((float)x + Sigmoid(boxDimensions.X)) * CELL_WIDTH,
        Y = ((float)y + Sigmoid(boxDimensions.Y)) * CELL_HEIGHT,
        Width = (float)Math.Exp(boxDimensions.Width) * CELL_WIDTH * anchors[box * 2],
        Height = (float)Math.Exp(boxDimensions.Height) * CELL_HEIGHT * anchors[box * 2 + 1],
    };
}

public float[] ExtractClasses(float[] modelOutput, int x, int y, int channel)
{
    float[] predictedClasses = new float[CLASS_COUNT];
    int predictedClassOffset = channel + BOX_INFO_FEATURE_COUNT;
    for (int predictedClass = 0; predictedClass < CLASS_COUNT; predictedClass++)
    {
        predictedClasses[predictedClass] = modelOutput[GetOffset(x, y, predictedClass + predictedClassOffset)];
    }
    return Softmax(predictedClasses);
}

private ValueTuple<int, float> GetTopResult(float[] predictedClasses)
{
    return predictedClasses
        .Select((predictedClass, index) => (Index: index, Value: predictedClass))
        .OrderByDescending(result => result.Value)
        .First();
}

private float IntersectionOverUnion(RectangleF boundingBoxA, RectangleF boundingBoxB)
{
    var areaA = boundingBoxA.Width * boundingBoxA.Height;

    if (areaA <= 0)
        return 0;

    var areaB = boundingBoxB.Width * boundingBoxB.Height;

    if (areaB <= 0)
        return 0;

    var minX = Math.Max(boundingBoxA.Left, boundingBoxB.Left);
    var minY = Math.Max(boundingBoxA.Top, boundingBoxB.Top);
    var maxX = Math.Min(boundingBoxA.Right, boundingBoxB.Right);
    var maxY = Math.Min(boundingBoxA.Bottom, boundingBoxB.Bottom);

    var intersectionArea = Math.Max(maxY - minY, 0) * Math.Max(maxX - minX, 0);

    return intersectionArea / (areaA + areaB - intersectionArea);
}
定义所有帮助程序方法后,就可以使用它们来处理模型输出。
在 IntersectionOverUnion 方法下方,创建 ParseOutputs 用于处理模型生成的输出的方法。
public IList<YoloBoundingBox> ParseOutputs(float[] yoloModelOutputs, float threshold = .3F)
{

}
在 ParseOutputs 方法中创建一个列表来存储边界框并定义变量。
var boxes = new List<YoloBoundingBox>();
每个图像被划分为一个网格,由13 x 13个单元格组成。 每个单元格包含五个边界框。 在 boxes 变量下方,添加代码以处理每个单元格中的所有框。
for (int row = 0; row < ROW_COUNT; row++)
{
    for (int column = 0; column < COL_COUNT; column++)
    {
        for (int box = 0; box < BOXES_PER_CELL; box++)
        {

        }
    }
}
在最内部循环中,计算一维模型输出中当前框的起始位置。
var channel = (box * (CLASS_COUNT + BOX_INFO_FEATURE_COUNT));
直接在其下方,使用 ExtractBoundingBoxDimensions 方法获取当前边界框的尺寸。
BoundingBoxDimensions boundingBoxDimensions = ExtractBoundingBoxDimensions(yoloModelOutputs, row, column, channel);
然后,使用GetConfidence 方法来获取当前边界框的置信度。
float confidence = GetConfidence(yoloModelOutputs, row, column, channel);
之后,使用 MapBoundingBoxToCell 该方法将当前边界框映射到正在处理的当前单元格。
CellDimensions mappedBoundingBox = MapBoundingBoxToCell(row, column, box, boundingBoxDimensions);
在进行进一步处理之前,请检查置信度值是否大于提供的阈值。 如果不是,请继续处理下一个边界框。
if (confidence < threshold)
    continue;
否则,请继续处理输出。 下一步是使用 ExtractClasses 该方法获取当前边界框的预测类的概率分布。
float[] predictedClasses = ExtractClasses(yoloModelOutputs, row, column, channel);
然后,使用 GetTopResult 该方法获取当前框概率最高的类的值和索引,并计算其分数。
var (topResultIndex, topResultScore) = GetTopResult(predictedClasses);
var topScore = topResultScore * confidence;
使用topScore再次保留那些超过指定阈值的边界框。
if (topScore < threshold)
    continue;
最后,如果当前边界框超出阈值,请创建新 BoundingBox 对象并将其添加到 boxes 列表中。
boxes.Add(new YoloBoundingBox()
{
    Dimensions = new BoundingBoxDimensions
    {
        X = (mappedBoundingBox.X - mappedBoundingBox.Width / 2),
        Y = (mappedBoundingBox.Y - mappedBoundingBox.Height / 2),
        Width = mappedBoundingBox.Width,
        Height = mappedBoundingBox.Height,
    },
    Confidence = topScore,
    Label = labels[topResultIndex],
    BoxColor = classColors[topResultIndex]
});
处理图像中的所有单元格后,返回 boxes 列表。 在方法中 ParseOutputs 最外部的 for-loop 下面添加以下 return 语句。
return boxes;
筛选重叠框
现在,从模型输出中提取了所有高度自信的边界框,需要执行额外的筛选来删除重叠的图像。 添加方法下面FilterBoundingBoxes调用ParseOutputs的方法:
public IList<YoloBoundingBox> FilterBoundingBoxes(IList<YoloBoundingBox> boxes, int limit, float threshold)
{

}
在 FilterBoundingBoxes 方法中,首先创建一个与检测到的框大小相同的数组,并将所有槽标记为活动或已准备好进行处理。
var activeCount = boxes.Count;
var isActiveBoxes = new bool[boxes.Count];

for (int i = 0; i < isActiveBoxes.Length; i++)
    isActiveBoxes[i] = true;
然后,根据置信度按降序对包含边界框的列表进行排序。
var sortedBoxes = boxes.Select((b, i) => new { Box = b, Index = i })
                    .OrderByDescending(b => b.Box.Confidence)
                    .ToList();
之后,创建一个列表来保存筛选的结果。
var results = new List<YoloBoundingBox>();
通过循环访问每个边界框开始处理每个边界框。
for (int i = 0; i < boxes.Count; i++)
{

}
在这个 for 循环中,检查当前边界框是否可以处理。
if (isActiveBoxes[i])
{

}
如果是,请将边界框添加到结果列表中。 如果结果超出了要提取的框的指定限制,则中断循环。 在 if-statement 中添加以下代码。
var boxA = sortedBoxes[i].Box;
results.Add(boxA);

if (results.Count >= limit)
    break;
否则,请查看相邻边界框。 在框限制检查下方添加以下代码。
for (var j = i + 1; j < boxes.Count; j++)
{

}
与第一个框一样,如果相邻框处于活动状态或已准备好进行处理,请使用 IntersectionOverUnion 该方法检查第一个框和第二个框是否超出指定的阈值。 将以下代码添加到最里面的 for 循环中。
if (isActiveBoxes[j])
{
    var boxB = sortedBoxes[j].Box;

    if (IntersectionOverUnion(boxA.Rect, boxB.Rect) > threshold)
    {
        isActiveBoxes[j] = false;
        activeCount--;

        if (activeCount <= 0)
            break;
    }
}
在检查相邻边界框的最内部 for 循环之外,查看是否还有任何剩余的边界框需要处理。 如果不是,则从外部 for-loop 中解脱出来。
if (activeCount <= 0)
    break;
最后,在方法的最初的 for 循环之外,返回结果:
return results;
太好了! 现在是时候将此代码与模型一起使用进行评分了。
使用模型进行评分
就像后期处理一样,评分步骤也包含几个步骤。 为帮助解决此问题,请将包含评分逻辑的类添加到项目。
在 解决方案资源管理器中,右键单击该项目,然后选择“ 添加新>项”。
在“ 添加新项 ”对话框中,选择“ 类 ”并将“ 名称 ”字段更改为 OnnxModelScorer.cs。 然后选择“添加”。
OnnxModelScorer.cs文件将在代码编辑器中打开。 将以下
using指令添加到 OnnxModelScorer.cs顶部:using System; using System.Collections.Generic; using System.Linq; using Microsoft.ML; using Microsoft.ML.Data; using ObjectDetection.DataStructures; using ObjectDetection.YoloParser;在
OnnxModelScorer类定义中,添加以下变量。private readonly string imagesFolder; private readonly string modelLocation; private readonly MLContext mlContext; private IList<YoloBoundingBox> _boundingBoxes = new List<YoloBoundingBox>();就在下面,为
OnnxModelScorer类创建构造函数,以初始化先前定义的变量。public OnnxModelScorer(string imagesFolder, string modelLocation, MLContext mlContext) { this.imagesFolder = imagesFolder; this.modelLocation = modelLocation; this.mlContext = mlContext; }创建构造函数后,定义几个结构,其中包含与图像和模型设置相关的变量。 创建一个称为
ImageNetSettings包含模型输入所需的高度和宽度的结构。public struct ImageNetSettings { public const int imageHeight = 416; public const int imageWidth = 416; }之后,创建另一个名为
TinyYoloModelSettings包含模型输入和输出层的名称的结构。 若要可视化模型的输入和输出层的名称,可以使用 Netron 等工具。public struct TinyYoloModelSettings { // for checking Tiny yolo2 Model input and output parameter names, //you can use tools like Netron, // which is installed by Visual Studio AI Tools // input tensor name public const string ModelInput = "image"; // output tensor name public const string ModelOutput = "grid"; }接下来,创建用于评分的第一组方法。 在
LoadModel类中创建OnnxModelScorer方法。private ITransformer LoadModel(string modelLocation) { }在
LoadModel方法中,添加以下代码进行日志记录。Console.WriteLine("Read model"); Console.WriteLine($"Model location: {modelLocation}"); Console.WriteLine($"Default parameters: image size=({ImageNetSettings.imageWidth},{ImageNetSettings.imageHeight})");在调用
Fit方法时,ML.NET 管道需要知道要操作的数据架构。 在这种情况下,将使用类似于训练的过程。 但是,由于没有实际训练发生,所以使用空IDataView是可以接受的。 从空列表中为管道创建新的IDataView。var data = mlContext.Data.LoadFromEnumerable(new List<ImageNetData>());在其下方,定义管道。 管道将包含四个转换。
-
LoadImages将图像加载为位图。 -
ResizeImages将图像重新缩放为指定的大小(在本例中为416 x 416)。 -
ExtractPixels将图像的像素表示形式从位图更改为数字向量。 -
ApplyOnnxModel加载 ONNX 模型,并使用它对提供的数据进行评分。
重要
仅应用来自受信任源的模型。 应用来自不受信任来源的模型存在安全风险。
在变量下面的
LoadModel方法中data定义管道。var pipeline = mlContext.Transforms.LoadImages(outputColumnName: "image", imageFolder: "", inputColumnName: nameof(ImageNetData.ImagePath)) .Append(mlContext.Transforms.ResizeImages(outputColumnName: "image", imageWidth: ImageNetSettings.imageWidth, imageHeight: ImageNetSettings.imageHeight, inputColumnName: "image")) .Append(mlContext.Transforms.ExtractPixels(outputColumnName: "image")) .Append(mlContext.Transforms.ApplyOnnxModel(modelFile: modelLocation, outputColumnNames: new[] { TinyYoloModelSettings.ModelOutput }, inputColumnNames: new[] { TinyYoloModelSettings.ModelInput }));现在是时候实例化模型进行评分了。 在
Fit管道上调用该方法,并返回该方法以供进一步处理。var model = pipeline.Fit(data); return model;-
加载模型后,就可以使用它进行预测。 为了方便此过程,请创建一个方法,PredictDataUsingModel该方法下面调用LoadModel。
private IEnumerable<float[]> PredictDataUsingModel(IDataView testData, ITransformer model)
{

}
在 中 PredictDataUsingModel,添加以下代码进行日志记录。
Console.WriteLine($"Images location: {imagesFolder}");
Console.WriteLine("");
Console.WriteLine("=====Identify the objects in the images=====");
Console.WriteLine("");
然后,使用 Transform 该方法对数据进行评分。
IDataView scoredData = model.Transform(testData);
提取预测概率,并返回这些概率以供其他处理。
IEnumerable<float[]> probabilities = scoredData.GetColumn<float[]>(TinyYoloModelSettings.ModelOutput);

return probabilities;
设置这两个步骤后,将它们合并为单个方法。 在方法下方,添加一PredictDataUsingModel个名为 Score 的新方法。
public IEnumerable<float[]> Score(IDataView data)
{
    var model = LoadModel(modelLocation);

    return PredictDataUsingModel(data, model);
}
快到了! 现在是时候把它全部使用了。
检测对象
完成所有设置后,可以检测某些对象。
评分和解析模型输出
在 mlContext 创建变量后,添加 try-catch 语句。
try
{

}
catch (Exception ex)
{
    Console.WriteLine(ex.ToString());
}
在 try 块内部,开始实现对象检测逻辑。 首先,将数据加载到一个 IDataView.
IEnumerable<ImageNetData> images = ImageNetData.ReadFromFile(imagesFolder);
IDataView imageDataView = mlContext.Data.LoadFromEnumerable(images);
然后,创建一个实例 OnnxModelScorer 并将其用于对加载的数据进行评分。
// Create instance of model scorer
var modelScorer = new OnnxModelScorer(imagesFolder, modelFilePath, mlContext);

// Use model to score data
IEnumerable<float[]> probabilities = modelScorer.Score(imageDataView);
现在是时候执行后期处理步骤了。 创建一个实例 YoloOutputParser 并将其用于处理模型输出。
YoloOutputParser parser = new YoloOutputParser();

var boundingBoxes =
    probabilities
    .Select(probability => parser.ParseOutputs(probability))
    .Select(boxes => parser.FilterBoundingBoxes(boxes, 5, .5F));
处理模型输出后,接下来是绘制图像上的边界框。
将预测结果可视化
在模型对图像进行评分并对输出进行处理后,必须在图像上绘制边界框。 为此,请在DrawBoundingBox内添加在方法下方GetAbsolutePath调用的方法。
void DrawBoundingBox(string inputImageLocation, string outputImageLocation, string imageName, IList<YoloBoundingBox> filteredBoundingBoxes)
{

}
首先,加载图像并在方法中 DrawBoundingBox 获取高度和宽度尺寸。
Image image = Image.FromFile(Path.Combine(inputImageLocation, imageName));

var originalImageHeight = image.Height;
var originalImageWidth = image.Width;
然后,创建一个 for-each 循环,用于遍历模型检测到的每个边界框。
foreach (var box in filteredBoundingBoxes)
{

}
在 for-each 循环中,获取边界框的尺寸。
var x = (uint)Math.Max(box.Dimensions.X, 0);
var y = (uint)Math.Max(box.Dimensions.Y, 0);
var width = (uint)Math.Min(originalImageWidth - x, box.Dimensions.Width);
var height = (uint)Math.Min(originalImageHeight - y, box.Dimensions.Height);
由于边界框的尺寸对应于模型输入 416 x 416,因此缩放边界框尺寸以匹配图像的实际大小。
x = (uint)originalImageWidth * x / OnnxModelScorer.ImageNetSettings.imageWidth;
y = (uint)originalImageHeight * y / OnnxModelScorer.ImageNetSettings.imageHeight;
width = (uint)originalImageWidth * width / OnnxModelScorer.ImageNetSettings.imageWidth;
height = (uint)originalImageHeight * height / OnnxModelScorer.ImageNetSettings.imageHeight;
然后,为出现在每个边界框上方的文本定义模板。 文本将包含相应边界框内对象的类以及置信度。
string text = $"{box.Label} ({(box.Confidence * 100).ToString("0")}%)";
若要在图像上绘制,请将其转换为对象 Graphics 。
using (Graphics thumbnailGraphic = Graphics.FromImage(image))
{

}
在代码块中 using ,优化图形 Graphics 的对象设置。
thumbnailGraphic.CompositingQuality = CompositingQuality.HighQuality;
thumbnailGraphic.SmoothingMode = SmoothingMode.HighQuality;
thumbnailGraphic.InterpolationMode = InterpolationMode.HighQualityBicubic;
在下面,设置文本和边界框的字体和颜色选项。
// Define Text Options
Font drawFont = new Font("Arial", 12, FontStyle.Bold);
SizeF size = thumbnailGraphic.MeasureString(text, drawFont);
SolidBrush fontBrush = new SolidBrush(Color.Black);
Point atPoint = new Point((int)x, (int)y - (int)size.Height - 1);

// Define BoundingBox options
Pen pen = new Pen(box.BoxColor, 3.2f);
SolidBrush colorBrush = new SolidBrush(box.BoxColor);
使用 FillRectangle 方法创建并填充一个位于边界框上方的矩形,以容纳文本。 这有助于对比文本并提高可读性。
thumbnailGraphic.FillRectangle(colorBrush, (int)x, (int)(y - size.Height - 1), (int)size.Width, (int)size.Height);
然后,使用 DrawString 和 DrawRectangle 方法在图像上绘制文本和边界框。
thumbnailGraphic.DrawString(text, drawFont, fontBrush, atPoint);

// Draw bounding box on image
thumbnailGraphic.DrawRectangle(pen, x, y, width, height);
在 for-each 循环之外,添加代码以在 <
if (!Directory.Exists(outputImageLocation))
{
    Directory.CreateDirectory(outputImageLocation);
}

image.Save(Path.Combine(outputImageLocation, imageName));
有关应用程序在运行时按预期进行预测的其他反馈,请在LogDetectedObjects文件中添加一个调用DrawBoundingBox的方法,将检测到的对象输出到控制台。
void LogDetectedObjects(string imageName, IList<YoloBoundingBox> boundingBoxes)
{
    Console.WriteLine($".....The objects in the image {imageName} are detected as below....");

    foreach (var box in boundingBoxes)
    {
        Console.WriteLine($"{box.Label} and its Confidence score: {box.Confidence}");
    }

    Console.WriteLine("");
}
现在你有了用于从预测创建视觉反馈的辅助方法,请添加一个 for-loop 来迭代访问每个已评分图像。
for (var i = 0; i < images.Count(); i++)
{

}
在 for 循环内,获取图像文件的名称及其相关的边界框信息。
string imageFileName = images.ElementAt(i).Label;
IList<YoloBoundingBox> detectedObjects = boundingBoxes.ElementAt(i);
下面,使用 DrawBoundingBox 该方法在图像上绘制边界框。
DrawBoundingBox(imagesFolder, outputFolder, imageFileName, detectedObjects);
最后,使用 LogDetectedObjects 该方法将预测输出到控制台。
LogDetectedObjects(imageFileName, detectedObjects);
try-catch 语句后,添加其他逻辑以指示进程已完成运行。
Console.WriteLine("========= End of Process..Hit any Key ========");
就是这样!
Results
执行上述步骤后,运行控制台应用(Ctrl + F5)。 结果应类似于以下输出。 你可能会看到警告或处理消息,但为了清楚起见,这些消息已从以下结果中删除。
=====Identify the objects in the images=====

.....The objects in the image image1.jpg are detected as below....
car and its Confidence score: 0.9697262
car and its Confidence score: 0.6674225
person and its Confidence score: 0.5226039
car and its Confidence score: 0.5224892
car and its Confidence score: 0.4675332

.....The objects in the image image2.jpg are detected as below....
cat and its Confidence score: 0.6461141
cat and its Confidence score: 0.6400049

.....The objects in the image image3.jpg are detected as below....
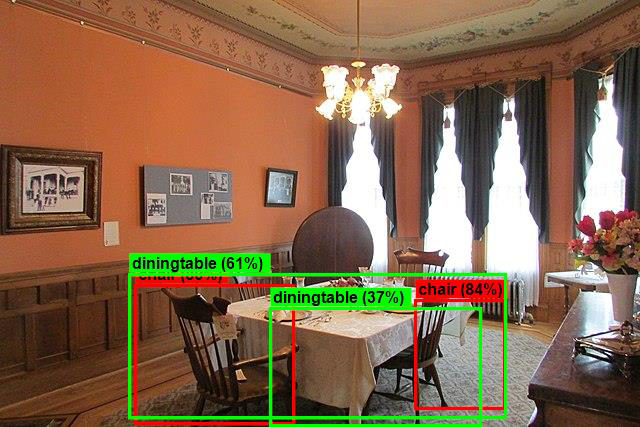
chair and its Confidence score: 0.840578
chair and its Confidence score: 0.796363
diningtable and its Confidence score: 0.6056048
diningtable and its Confidence score: 0.3737402

.....The objects in the image image4.jpg are detected as below....
dog and its Confidence score: 0.7608147
person and its Confidence score: 0.6321323
dog and its Confidence score: 0.5967442
person and its Confidence score: 0.5730394
person and its Confidence score: 0.5551759

========= End of Process..Hit any Key ========
若要查看带有边界框的图像,请导航到 assets/images/output/ 目录。 下面是其中一个已处理图像的示例。
祝贺! 现在,通过在 ML.NET 中重用预先训练的模型,成功生成了用于对象检测的 ONNX 机器学习模型。
可以在 dotnet/machinelearning-samples 存储库中找到本教程的源代码。
在本教程中,你将学习到如何:
- 了解问题
- 了解 ONNX 是什么以及它如何使用 ML.NET
- 了解模型
- 重复使用预先训练的模型
- 使用加载的模型检测对象
查看机器学习示例 GitHub 存储库,浏览扩展的对象检测示例。
